20 ноября Timeweb Cloud начнет серию обновлений безопасности на всей платформе


За первые девять месяцев 2026 года в международном каталоге CVE публиковали в среднем 267 новых записей об уязвимостях в день. Для нашей облачной платформы важно оперативно проверять исправления и устанавливать их на тысячи физических серверов. Поэтому мы меняем сам порядок обновлений, чтобы в будущем часть из них проходила без перерыва для клиентов.

В ближайшие дни обновим платформу. Для нее вышли важные исправления безопасности, которые мы уже протестировали внутри. Обновлять платформу будем в несколько этапов, для этого потребуется перезагрузить серверы.

Пока мы перезагружаем оборудование, размещенные на нем сервисы будут недоступны. Ожидаемый перерыв — от 10 минут до 2 часов:

— Перезагрузка оборудования занимает до 10 минут, при этом клиентские сервисы поднимаются поочередно в течение более длительного времени
— Если после перезагрузки не запустится служба или нарушится работа кластера, это может затронуть сразу несколько связанных сервисов. В таком случае восстановление может занять больше часа.

За 24 часа до каждого этапа мы напишем клиентам, чьи сервисы он затронет. В письме укажем дату и время, чтобы команды успели перенести важные задачи и предупредить пользователей.

Здесь будем рассказывать о важных уязвимостях, которые затрагивают наше облако и пользовательские проекты, и об исправлениях для них. Объясним, что это значит для ваших сервисов, что мы делаем со своей стороны и нужно ли что-то сделать вам.

Мы меняем порядок обновлений, чтобы быстрее устанавливать важные исправления и реже прерывать работу ваших проектов. Инженеры будут контролировать все этапы, мониторить возникающие ошибки и исправлять их вручную.

Команда Timeweb Cloud

https://timeweb.cloud

О прекращении последствий обстоятельств непреодолимой силы


Здравствуйте!
В октябре наши дата-центры подверглись атакам БПЛА. Это обстоятельства непреодолимой силы — мы круглосуточно работали над устранением последствий и обеспечением стабильной работы сервисов.

Сейчас платформа Yandex Cloud работает в штатном режиме, в том числе мы предоставляем вычислительные мощности в запущенных в октябре и ноябре 2026 года зонах доступности.

Последствия обстоятельств непреодолимой силы действовали с 8 октября 2026 года по 18 ноября 2026 года.

Это официальное уведомление о прекращении с 19 ноября 2026 года последствий обстоятельств непреодолимой силы в соответствии с условиями пункта 11.7 Оферты или условиями заключённого с вами договора (в зависимости от способа оформления договорных отношений).

С этого момента все положения Соглашения об уровне обслуживания (SLA) применяются в полном объёме.

Также сообщаем, что тарификация потребления с 1 ноября 2026 года осуществляется в стандартном режиме — в соответствии с ранее предоставленной информацией.

Спасибо за вашу поддержку и понимание,
команда Yandex Cloud

Напоминаем о смене юрлица с 23 ноября


Напоминаем, что с 23 ноября 2026 года мы начнём работать с вашей организацией через новое юрлицо — ООО «Дистрибуция».

Во время перехода доступ к сервисам сохранится. Условия и стоимость тарифа также останутся прежними.

Переход займёт до трёх рабочих дней. В это время изменить реквизиты в кабинете организации не получится, а баланс может отображаться некорректно, в том числе временно уйти в минус. После перехода данные обновятся.

До 23 ноября проверьте и при необходимости пополните баланс, чтобы средств хватило на время миграции и после её завершения.

Если после обновления данных баланс останется отрицательным, организация перейдёт в режим просмотра. Чтобы выйти из него, пополните баланс.
yandex.ru/support/yandex-360/business/purchase/ru/troubleshooting/change-legal-entity

Закрыли доступ к DCImanager


В целях безопасности мы закрыли публичный доступ к панели DCImanager — продукту ISPsystem. Решение связано с обнаруженной в середине октября уязвимостью в другом продукте
компании — VMmanager 6, которую злоумышленники использовали для атак на нескольких хостинг-провайдеров.

Как теперь управлять сервером?
Мы подготовили статью, в которой собрали ответы на основные вопросы об управлении сервером без доступа к DCImanager. Рассказываем, какие функции уже доступны в личном кабинете и как ими пользоваться.

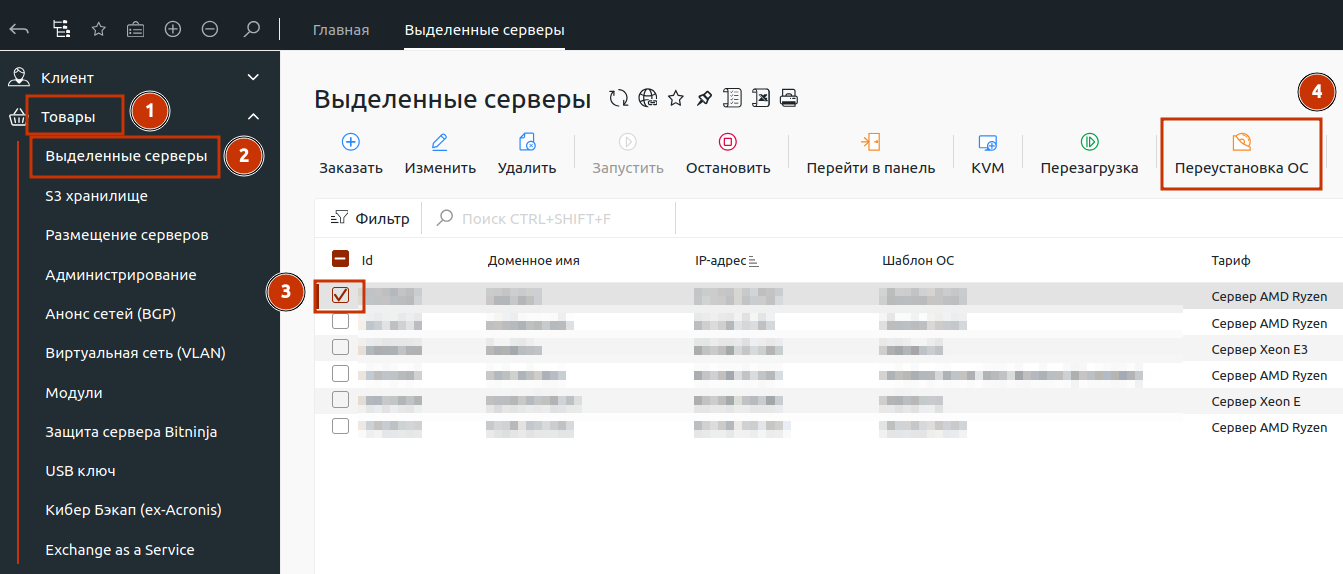
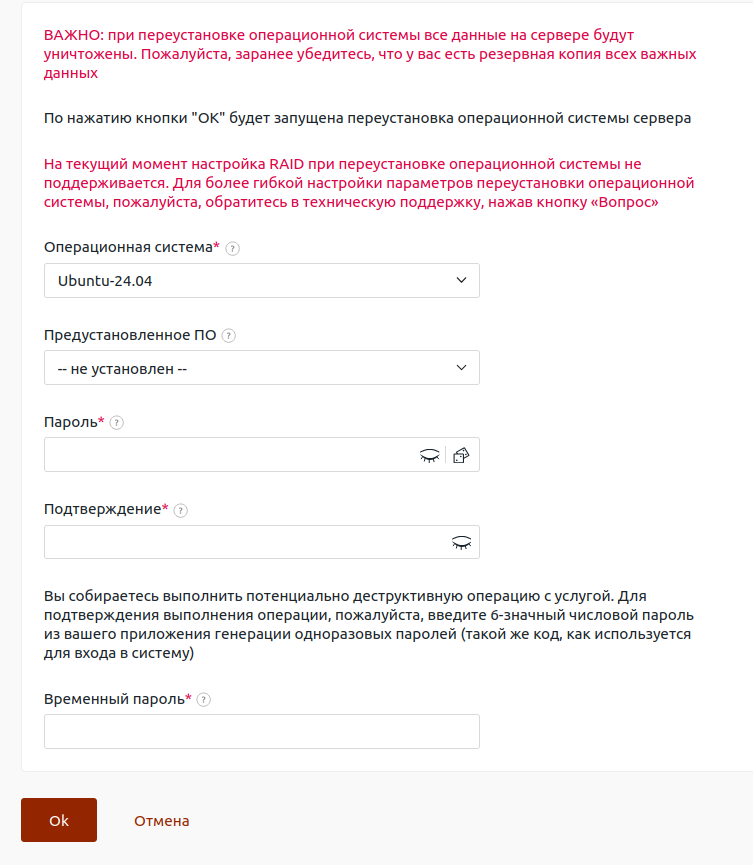
Чтобы переустановить ОС, перейдите в раздел Товары → Выделенные серверы → выберите сервер из списка → нажмите кнопку Переустановка ОС.


Примечание: сейчас настройка RAID при переустановке ОС не поддерживается. Для более гибкой настройки параметров переустановки ОС обратитесь в техническую поддержку: для этого нужно кликнуть по кнопке Вопрос в Личном кабинете.

Выберите нужную операционную систему, предустановленное ПО и введите пароль пользователя root. Подтвердите операцию одноразовым кодом (срок его действия — 30 минут) — его можно получить на почту аккаунта. Если на аккаунте включена 2FA, код необходимо скопировать в приложении-аутентификаторе.


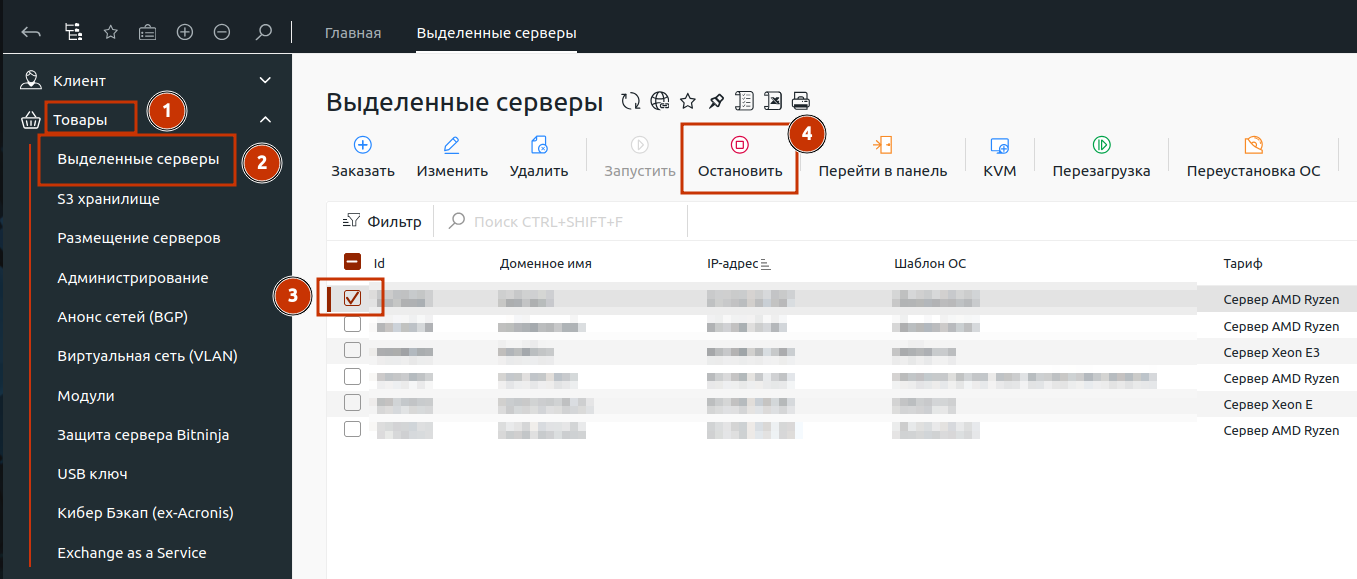
Остановка сервера
Остановка сервера выключает его: работа прекращается, все процессы внутри завершаются. Для остановки перейдите в раздел Товары → Выделенные серверы, выберите нужный сервер и нажмите кнопку Остановить.


Чтобы включить сервер, нажмите кнопку Запустить.

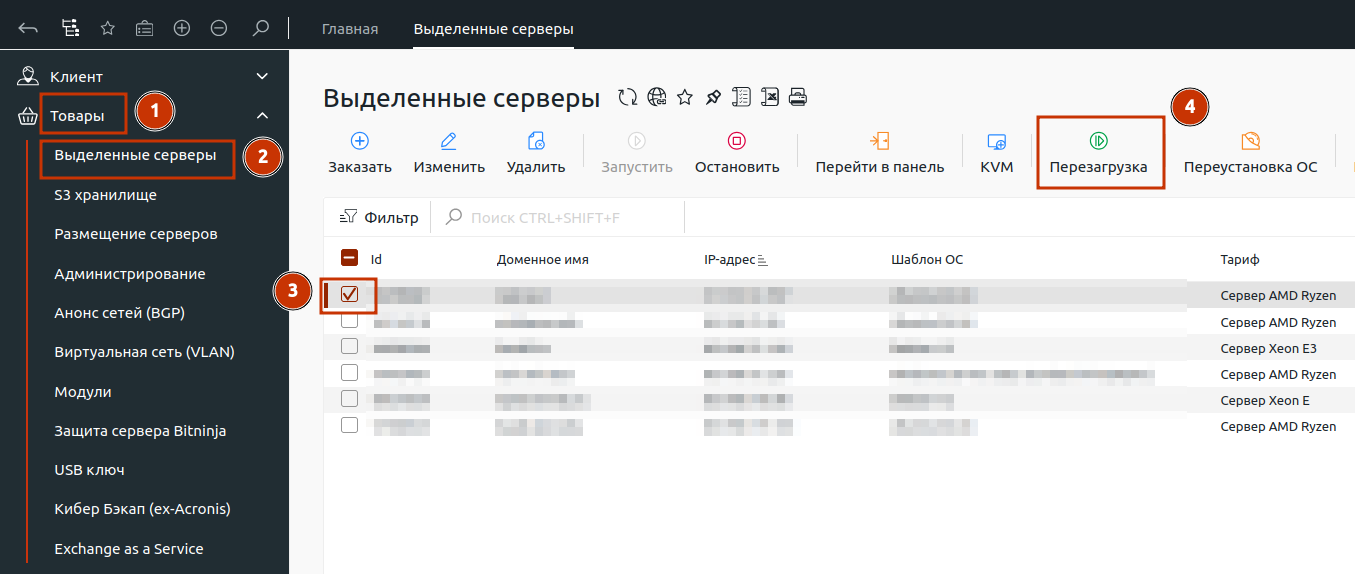
Перезагрузка сервера
Перейдите в в раздел Товары → Выделенные серверы → Выберите сервер → нажмите кнопку Перезагрузка.


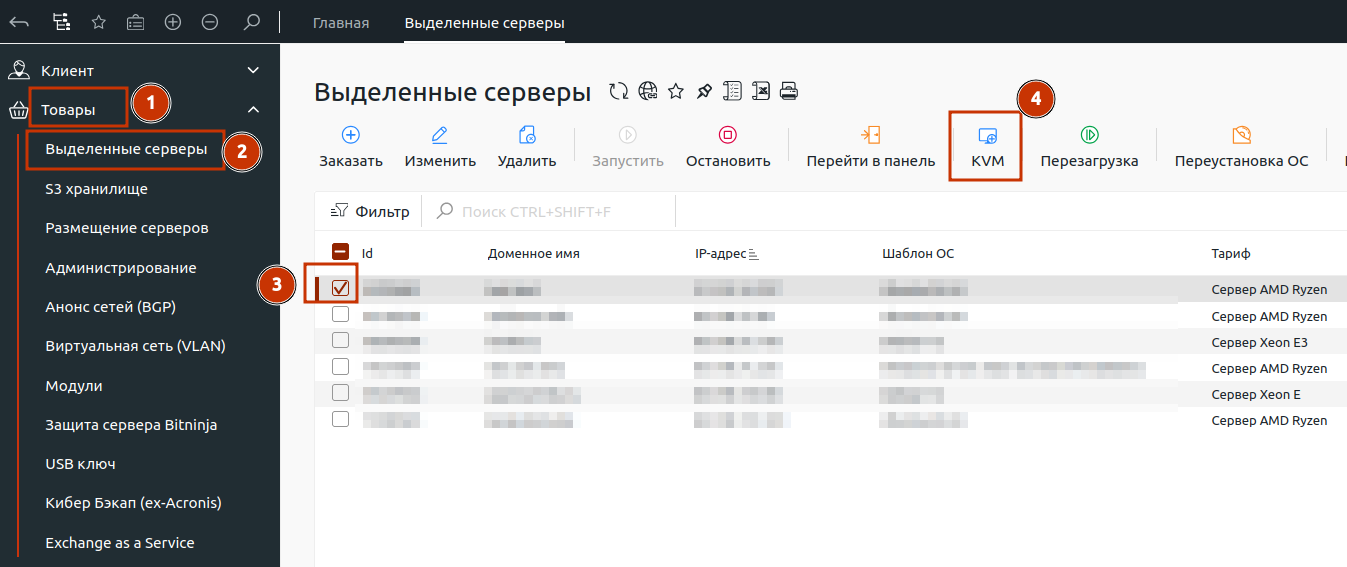
Подключение к серверу по KVM
Если возникли проблемы с доступом по SSH, вы можете заказать консоль KVM в Личном кабинете. Для заказа в разделе Товары → Выделенные серверы → Выберите сервер → нажмите кнопку KVM.

Первые 2 часа использовать KVM можно бесплатно. Если нужно больше времени, стоимость каждого дополнительного часа — 100 руб.

Экстренные обновления безопасности / Emergency security updates


В ПО с открытым исходным кодом, в том числе в nginx, PHP и ядре Linux, обнаружены критические уязвимости.

Речь идет об уязвимостях в стороннем программном обеспечении, которым пользуется весь интернет. Мы начали экстренную установку исправлений на своем оборудовании, чтобы заранее исключить возможность атак на нашу инфраструктуру.

Во время работ возможны короткие перезагрузки узлов и кратковременные перебои в работе сервисов.

Перезагрузка обычно занимает несколько минут. Никаких действий с вашей стороны для этого не требуется. Если ваш сервер не запустился корректно, напишите нам.

Проверьте программное обеспечение на своих серверах
Наши работы закрывают уязвимости на оборудовании SpaceCore. Программное обеспечение внутри вашего виртуального или выделенного сервера обновляете вы сами.

Рекомендуем проверить версии всех компонентов, которые вы используете — веб-сервера, PHP, Node.js, ядра операционной системы и остальных пакетов — и установить актуальные обновления безопасности.

Уязвимости в открытом программном обеспечении сейчас находят и публикуют заметно чаще, чем раньше. Рекомендуем обновлять используемые вами компоненты регулярно, не дожидаясь отдельных уведомлений.

Команда SpaceCore
Emergency security updates
Critical vulnerabilities have been found in open-source software, including nginx, PHP and the Linux kernel.

These are vulnerabilities in third-party software used across the entire internet. We have begun an emergency rollout of patches across our own infrastructure in order to rule out any possibility of attacks in advance.

During this process you may experience short node reboots and brief service interruptions.

A reboot normally takes a few minutes. No action is required on your side for this. If your server has not started up correctly, please contact us.

Please check the software on your own servers
Our work covers the vulnerabilities on SpaceCore infrastructure. The software inside your virtual or dedicated server is managed by you.

We recommend reviewing the versions of every component you use — your web server, PHP, Node.js, the operating system kernel and the rest of your packages — and installing the current security updates.

Vulnerabilities in open-source software are now being found and disclosed noticeably more often than before. We recommend updating the components you use on a regular basis, rather than waiting for a separate notice.

SpaceCore Team

Будет отключена nested-виртуализация из-за соображений безопасности


Уважаемый клиент Интернет Хостинг Центра!

Доводим до вашего сведения, что 18.11.2026 с оборудованием, на котором размещён ваш заказ, будут проводиться внеплановые технические работы. Суммарное время недоступности может составить 15-30 минут.

Во время данных работ будет отключена nested-виртуализация из-за соображений безопасности и найденных уязвимостей в ней.
После отключения вложенной виртуализации нельзя будет запускать внутри VDS:
  • Виртуальные машины: KVM, Proxmox, VirtualBox, VMware, Hyper-V.
  • Android-эмуляторы: BlueStacks, LDPlayer, Android Studio Emulator.
  • WSL2, Docker Desktop и Windows Sandbox на Windows VPS.
  • Контейнерные решения с использованием микро-виртуальных машин: Kata Containers, Firecracker.

Ограничение будет применено ко всей инфраструктуре без возможности индивидуального включения для отдельных VDS.

Чтобы минимизировать последствия, связанные с недоступностью сайтов, данные работы будут произведены в период с 23:30 до 02:00 MSK.

www.ihc.ru

Личный кабинет научился показывать время в вашем часовом поясе


Если вы не в Москве, вам больше не нужно переводить даты в голове. Личный кабинет может показывать все даты и время в вашем часовом поясе: историю платежей, срок оплаты заказа («Оплачен до»), сообщения в поддержку, плановые технические работы и письма от панели.

Как включить. Откройте «Настройки аккаунта» (меню пользователя в правом верхнем углу) и выберите вкладку «Часовой пояс». Новым пользователям пояс определяется автоматически по настройкам браузера, остальным по умолчанию остаётся московский — пока вы не выберете свой.

Что изменилось после выбора пояса:
  • даты и время в кабинете и в письмах показываются в вашем времени; например, пополнение в 16:08 по Москве отобразится как 18:08 для Екатеринбурга;
  • сроки оплаты заказов теперь указываются с точностью до минуты — сразу видно, до какого именно момента оплачен заказ;
  • переход на летнее и зимнее время происходит автоматически, ничего пересохранять не нужно;
  • в списке платежей при наведении на дату можно увидеть московское время, а в нижней части каждой страницы показаны время на сервере и ваше локальное — удобно при обращении в поддержку.
Обратите внимание: бухгалтерские документы (акты, счета на пополнение, сверки) по-прежнему формируются по московскому времени.

Если возникнут вопросы по датам и времени в кабинете — напишите нам в тикет, мы подскажем.
www.ihc.ru

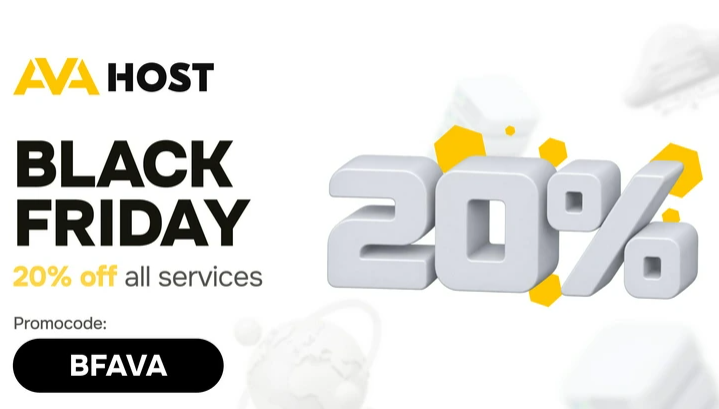
Скидки в Черную пятницу + Большое пополнение запасов VPS Nano! + Розыгрыши призов!


Промокод BFAVA
  • Дает скидку 20% на любой тарифный план до 1 декабря 2026 года.
  • Промокод не подлежит повторному использованию!

Это работает на общем хостинге, VPS и выделенных серверах. Скидка применяется к вашему первому платежу.

Мы также добавили и пополнили запасы 1024 Nano VPS! Да, это правда!
Это небольшой сервер для бота, тестового проекта или микросервиса.
Характеристики:
  • 1 vCPU
  • 512 МБ ОЗУ
  • 20 ГБ NVMe
  • 100 Мбит/
  • с Доступно на 2 или 3 года
  • 11 евро/год / ~12,07 долларов США в год (скидка BFAVA не распространяется на Nano)

Выберите тариф со скидкой 20%
ava.hosting

Закажите Nano VPS — БОЛЬШОЕ ПОПОЛНЕНИЕ ЗАПАСОВ!!! В наличии 1024!
ava.hosting/vps/vps-nano/

Прямая ссылка на VPS Nano:
my.ava.hosting/store/vps/vps-nano
Цена: 11 евро в год / ~12,07 долларов США в год

Внимание: Мы не можем гарантировать наличие еще одной крупной партии товара такого типа, а также не можем гарантировать скорое пополнение запасов VPS Nano. Обратите внимание, что это крупная партия товара, и мы прилагаем значительные усилия для ее пополнения. Порт 25 заблокирован в качестве превентивной меры безопасности. Пожалуйста, ознакомьтесь с нашими правилами и Политикой допустимого использования (AUP).

Тарифные планы хостинга, VPS и выделенных серверов:
Веб-хостинг Shared (cPanel) от 1,99€ в месяц:
ava.hosting/shared/

Тарифные планы VPS
ava.hosting/vps/

Выделенные серверы:
ava.hosting/dedicated-servers/

Промокод BFAVA
  • дает скидку 20% на любой тарифный план до 1 декабря 2026 года.
  • Промокод не подлежит повторному использованию!

Счастливой Чёрной пятницы!

С уважением,
Ava.hosting

Хостинг под ударом: уроки осени 2026


Кибератаки на хостинг-провайдеров, уязвимости систем виртуализации, повреждение данных и масштабные сбои облачных сервисов. За несколько недель российский ИТ-рынок столкнулся с целой серией серьёзных инцидентов. Что произошло, какие угрозы оказались наиболее опасными и какие выводы из этого стоит сделать бизнесу?

Осень 2026 года оказалась непростой для российского рынка хостинга и облачных услуг. В октябре масштабная кибератака затронула провайдеров, использовавших платформу управления виртуализацией VMmanager 6. В начале ноября злоумышленники атаковали инфраструктуру Beget, спустя несколько дней серьёзный инцидент произошёл в облаке ESTT. А 17 ноября пользователи Timeweb Cloud столкнулись с массовой недоступностью сервисов, причиной которой стала уже не кибератака, а техническая проблема при обновлении инфраструктуры.

Эти события различаются по причинам, масштабу и последствиям. Однако вместе они показывают, насколько сложной и взаимозависимой стала современная облачная инфраструктура. Сегодня доступность клиентских сервисов определяется не только исправностью серверов, систем хранения и каналов связи. Не менее важны безопасность управляющих платформ, устойчивость сетевой архитектуры и способность всей системы продолжать работу при отказе отдельных компонентов.

Даже профессионально построенная инфраструктура не застрахована от серьёзных инцидентов. Поэтому всё большее значение приобретает не только защита от возможных угроз, но и готовность к авариям, способность сохранить данные и максимально быстро восстановить работу сервисов.

Октябрь: атака через систему управления виртуализацией
В середине октября серия кибератак затронула инфраструктуру хостинг-провайдеров, использовавших VMmanager 6. Эта платформа предназначена для управления виртуализацией и позволяет операторам создавать виртуальные машины, распределять вычислительные ресурсы, управлять хранилищами и выполнять другие административные операции.

Согласно опубликованному расследованию разработчика платформы, компании ISPsystem, первые признаки подозрительной активности относятся к 12 октября, а наиболее интенсивная волна атак пришлась на 17 октября.

Расследование выявило несколько уязвимостей, в том числе связанных с обработкой HTTP-запросов. Их эксплуатация позволяла злоумышленникам обходить предусмотренные ограничения доступа и получать возможности, недоступные обычным пользователям системы.

Особенно показательной стала история FirstVDS. Компания опубликовала подробный технический разбор инцидента, в котором описала действия атакующих после получения доступа к инфраструктуре виртуализации.

Злоумышленники использовали возможности управляющей системы для взаимодействия с гипервизорами и виртуальными дисками клиентов. При этом потенциально опасные действия могли выполняться за пределами гостевой операционной системы. Сама виртуальная машина могла продолжать работать, а её владелец не обязательно замечал происходящее.

Под угрозой оказывались не только файлы, но и учётные данные, SSH-ключи, токены доступа и конфигурации приложений. Такие сведения особенно ценны для злоумышленников, поскольку могут использоваться для последующего проникновения в другие системы.

Атака продемонстрировала, насколько серьёзными могут быть последствия компрометации платформы управления виртуализацией. Если при взломе отдельного сервера масштаб ущерба обычно ограничен доступными злоумышленнику ресурсами, то получение контроля над управляющей инфраструктурой потенциально ставит под угрозу множество клиентских систем одновременно.

ISPsystem выпустила исправления обнаруженных уязвимостей. Однако устранение технической проблемы не завершает расследование подобного инцидента. Необходимо также проверить, какие действия успели выполнить атакующие, не сохранили ли они доступ к системам и какие данные могли оказаться скомпрометированы.

Ноябрь: кибератаки на Beget и ESTT
В ночь на 2 ноября серьёзной кибератаке подвергся Beget. По официальному сообщению компании, злоумышленники получили доступ к управляющему контуру инфраструктуры и запустили скрипты, предназначенные для уничтожения данных.

Последствия затронули сразу несколько направлений работы провайдера. Возникли проблемы с виртуальным хостингом, отдельными серверными услугами, DNS и другими компонентами сервисной инфраструктуры.

Beget приступил к поэтапному восстановлению, используя сохранившиеся резервные копии и доступные инфраструктурные ресурсы. При этом некоторые серверы оказались повреждены значительно сильнее других, что потребовало отдельных сценариев восстановления.

Компания регулярно публиковала информацию о ходе работ. Одни сервисы удавалось вернуть к работе относительно быстро, восстановление других требовало дополнительных проверок, переноса данных и восстановления взаимосвязанных компонентов инфраструктуры.

8 ноября ESTT столкнулась с серьёзной кибератакой. В результате была нарушена работа кластеров виртуализации и платформы управления облачной инфраструктурой SmartCore, что привело к недоступности части клиентских виртуальных серверов и функций управления ими.

Инженеры ESTT поэтапно возвращали к работе виртуальные машины, восстанавливали их исходные конфигурации, сетевую доступность и работу управляющих компонентов облачной платформы. 13 ноября компания сообщила о завершении восстановления и возвращении облачных сервисов к штатной работе.

При этом выделенные физические серверы клиентов, размещённые в отдельном изолированном контуре, продолжали работать в штатном режиме.

15 ноября Beget столкнулся с новой масштабной атакой, на этот раз направленной на сетевую доступность инфраструктуры. Компания сообщила об интенсивном DDoS-трафике, создавшем дополнительную нагрузку в период восстановления после предыдущего инцидента.

В отличие от проникновения в управляющие системы, DDoS-атака направлена прежде всего на нарушение доступности сервисов за счёт перегрузки каналов связи или ресурсов, обрабатывающих сетевые запросы. По сообщению Beget, новая атака не повлияла на работу уже восстановленных сервисов, однако потребовала дополнительных мер по защите инфраструктуры.

Timeweb Cloud: серьёзный сбой без кибератаки
17 ноября масштабный инцидент произошёл в инфраструктуре Timeweb Cloud. Часть облачных сервисов оказалась недоступна примерно на два часа. По опубликованной компанией хронологии, ограничения продолжались с 13:18 до 15:05 по московскому времени.

При обновлении гипервизоров произошёл сбой в работе сетевой инфраструктуры, в результате которого часть виртуальных серверов потеряла сетевую доступность.

В данном случае речь шла не о кибератаке. Сбой возник в процессе эксплуатации инфраструктуры и проведения технических работ.

Timeweb Cloud опубликовала подробное объяснение произошедшего и сообщила о планируемых изменениях в процедурах обновления. В частности, компания намерена расширить проверки состояния сетевых компонентов, увеличить интервалы между этапами обновления и усовершенствовать механизмы восстановления сетевой связности.

Что изменилось в понимании надёжности
В течение многих лет надёжность дата-центров было принято оценивать прежде всего через инженерную инфраструктуру. Резервирование электропитания, независимые каналы связи, системы охлаждения, физическая безопасность и соответствие определённому уровню Tier стали привычными критериями выбора площадки.

Все эти параметры по-прежнему имеют большое значение. Однако они характеризуют прежде всего устойчивость инженерной среды, в которой работает оборудование.

События осени 2026 года показали, что этого недостаточно для оценки надёжности всей ИТ-инфраструктуры. Даже при исправной работе инженерных систем серьёзный инцидент может произойти на уровне виртуализации, управления облаком, хранения данных или сетевых сервисов.

Причём последствия не всегда ограничиваются одним компонентом. Атака на управляющую платформу способна затронуть множество виртуальных машин и существенно осложнить их восстановление. А проблемы с сетевой связностью могут сделать недоступными даже те серверы, которые продолжают исправно работать.

Поэтому надёжность всё чаще приходится оценивать с точки зрения устойчивости всей архитектуры. Важно не только то, насколько защищены отдельные системы, но и насколько они независимы друг от друга, какие последствия вызовет отказ критичного компонента и какие возможности предусмотрены для восстановления.

Для операторов дата-центров и облачных платформ это означает необходимость развивать не только средства защиты, но и механизмы изоляции, резервирования и восстановления.

Для бизнеса меняются критерии оценки собственной ИТ-инфраструктуры. На первый план выходит вопрос о том, сможет ли компания сохранить данные и продолжить работу, если основной сервис или площадка окажутся недоступны.

Какие выводы стоит сделать бизнесу
Главный практический вывод заключается в необходимости заранее предусмотреть резервные сценарии для критически важных систем. Их сложность зависит от задач компании, допустимого времени простоя и последствий возможной потери данных.

Особое внимание стоит уделить резервному копированию. Критически важные данные не должны зависеть от одной площадки или одного контура управления. Как минимум одну резервную копию, защищённую от изменения или удаления, целесообразно хранить независимо от основной инфраструктуры, чтобы она оставалась доступной даже при серьёзном повреждении облачной платформы.

При этом важно не только регулярно создавать резервные копии, но и проверять возможность восстановления из них. Такая проверка должна включать развёртывание данных в отдельной среде, контроль их целостности и запуск необходимых приложений. Именно практическое восстановление позволяет понять, сколько времени потребуется для возвращения сервиса к работе и какие проблемы могут возникнуть в процессе.

Для сервисов, простой которых напрямую влияет на работу компании, стоит предусмотреть запасной вариант размещения. Это не обязательно полноценная дублирующая инфраструктура с постоянно работающими серверами. В зависимости от задач и бюджета можно использовать резервные виртуальные машины или заранее подготовленные ресурсы на другой площадке, позволяющие при необходимости восстановить сайт, базу данных или корпоративное приложение.

Однако наличие второй площадки само по себе ещё не гарантирует быстрого возвращения к работе. Необходимо заранее предусмотреть доступность актуальных данных, настройки сетевых соединений и порядок переключения. Иначе время, выигранное за счёт резервных ресурсов, может быть потеряно на ручной настройке и восстановлении зависимостей.

Отдельного внимания заслуживает распределение ответственности между компанией и провайдером. В зависимости от выбранной услуги резервное копирование может входить в обязанности оператора или полностью оставаться на стороне клиента. Поэтому важно заранее понимать, какие компоненты инфраструктуры резервируются, кто отвечает за сохранность прикладных данных и какие действия потребуются от собственной ИТ-команды для восстановления сервисов.

Универсальной схемы резервирования не существует. Её выбор зависит от критичности сервисов, допустимого времени простоя и возможных последствий для бизнеса. Для одних задач достаточно резервных копий и возможности развернуть систему на другой VPS, для других необходима заранее подготовленная резервная инфраструктура.

Главный урок этих событий заключается в том, что к возможным авариям необходимо готовиться заранее. Независимые резервные копии, проверенные сценарии восстановления и запасные варианты размещения помогают сохранить критически важные данные и существенно сократить последствия серьёзных инцидентов. Именно от готовности инфраструктуры к восстановлению во многом зависит, насколько быстро бизнес сможет вернуться к нормальной работе.

Мы хотели бы сообщить вам о проведении экстренного технического обслуживания сетевой инфраструктуры


В рамках нашей постоянной работы по повышению качества предоставляемых услуг, мы хотели бы сообщить вам о проведении экстренного технического обслуживания сетевой инфраструктуры. В целях безопасности мы обновим версию программного обеспечения на одном из основных устройств.

КОГДА ЭТОГО МОЖНО ОЖИДАТЬ?
Часовой пояс: CET (UTC+01:00)
18 ноября 2026 г. 21:00 — 19 ноября 2026 г. 02:00
Продолжительность: 5 часов

КАК ЭТО ПОВЛИЯЕТ НА ВАШИ УСЛУГИ?
Эти экстренные работы по техническому обслуживанию запланированы для устранения уязвимостей высокого риска в маршрутизаторах пиринга в глобальной магистральной сети. Помимо пиринга, это может затронуть клиентов, чей трафик проходит между нашими офисами в Гонконге и Сингапуре, а также между нашими офисами в Сингапуре и ЕС (Амстердам, Франкфурт, Лондон). Для защиты нас и наших клиентов мы вынуждены запланировать эти экстренные работы по техническому обслуживанию.

В ходе этих аварийных работ по техническому обслуживанию мы будем вносить изменения в схему управления трафиком, чтобы перенаправить его на другой маршрут, что может привести к временным изменениям задержки, поскольку трафик будет двигаться по другому пути. Таким образом, кратковременная потеря пакетов не будет длиться на протяжении всего периода аварийного обслуживания, а только во время перенаправления трафика на другой маршрут и обратно.

Наши специалисты будут доступны во время и после проведения технического обслуживания, чтобы оперативно помочь вам в решении любых возникших проблем.

Проведение этих технических работ может повлиять на работу сервисов в Гонконге, Сингапуре и странах ЕС (Амстердам, Франкфурт, Лондон).

Будьте уверены, мы сделаем все возможное, чтобы свести время простоя к минимуму. Наши специалисты будут доступны во время и после технического обслуживания, чтобы оперативно помочь вам с любыми возникшими проблемами.