Рейтинг
0.00

FirstVDS Хостинг

14 читателей, 554 топика

Вы уже использовали скидку на VPS?


И чтобы ваши фичи доходили до прода быстрее, ко Дню программиста мы подготовили скидку 25% на выбранный период заказа — 1, 3, 6 и 12 месяцев на новые VDS. Скидка работает на серверы в России, Нидерландах и Казахстане.


Если вы ждали знак — это он. Пора выкатывать проект.
https://firstvds.ru

На старт, внимание, -25% на VDS!


Ко Дню программиста запускаем акцию для всех и поздравляем тех, кто пишет код, выкатывает релизы, поднимает окружения и знает, что без нормальной инфраструктуры далеко не улетишь.

Дарим 2000 сертификатов тем, кто с нами больше года и 25% на новые VDS по промокоду:
MEOWVDS25
Чтобы промокод не сгорел в открытом космосе, успейте активировать его до 29 сентября.

https://firstvds.ru

Оцените новый CLO — дарим 2500 ₽ на баланс


Делимся отличной новостью: команда CLO сегодня запустила обновлённую версию сервиса. Платформа стала мощнее, удобнее и получила новые возможности для автоматизации.
Что изменилось:
  • ускорили сеть с DPDK, обновили OpenStack и OpenSDN
  • переписали бэкенд: сервисы создаются быстрее и работают стабильнее
  • запустили новый Terraform-провайдер
  • улучшили DBaaS: исправили ошибки, повысили производительность
  • добавили новые версии MySQL и PostgreSQL
  • обновили хранилище: без влияния «шумных соседей»
  • запустили новый современный личный кабинет

Мы долго ждали этого обновления и хотим отметить его вместе с вами. Поэтому дарим:
  1. 2500 рублей на баланс CLO для тестирования новой платформы;
  2. до 12% кешбэка за непрерывное использование CLO.
clo.ru/new-clo2

Новости по идентификации доменов .RU, .РФ и .SU


1 сентября уже прошло — что с идентификацией доменов в зонах .RU,.РФ и .SU?
По имеющейся информации: новые правила пока не действуют.

Это связано с тем, что необходимые нормативно-правовые акты не готовы, и регистраторам ещё не предоставлен полноценный доступ к ЕСИА для работы по новым требованиям.

Когда идентификация начнет полноценно работать, пока неизвестно.

Пока порядок не изменился, вы можете управлять доменами в обычном режиме. Рекомендуем продлить домен, если срок его действия истекает в течение 60 дней. Так у вас будет больше времени пройти идентификацию, когда она потребуется.
firstvds.ru/blog/dostupna-testovaya-identifikaciya-domenov-cherez-gosuslugi

Второй онлайн-переезд EVPN/VXLAN-фабрики: как мы переехали из QupraDC в NorthC без остановки сервиса


Меня зовут Рене, я сетевой инженер в FirstVDS. В прошлой статье я рассказывал, как мы переезжали из euNetworks в QupraDC и почему даже маленькую площадку полезно строить как нормальную фабрику, а не как одну большую коробку на всё.

Сначала я не планировал писать отдельную статью про второй переезд. Со стороны всё выглядело слишком похоже: снова Amsterdam, снова EVPN/VXLAN-фабрика, снова временная связность между дата-центрами и постепенный перенос серверов. Казалось, что получится пересказ той же истории другими названиями площадок.

Но повод был уже другим. В мае–июле 2026 года в Qupra DC2 произошла серия отказов системы охлаждения: оборудование уходило в аппаратную защиту от перегрева, а локация получала многочасовую недоступность. Аномальная жара стала триггером, но не единственной причиной нашего переезда: единичный сбой превратился в целый каскад проблем, которые вскрыли инженерные и эксплуатационные просчёты площадки. После этого ждать гарантий или доработок со стороны дата-центра мы не считали надёжным планом. Решение было простым и неприятным: надо переезжать в другой ДЦ. После оценки доступных вариантов, сроков, рисков и возможности сохранить текущую сетевую модель мы выбрали NorthC — в текущих условиях новая площадка полностью отвечала нашим требованиям к надёжности, инженерии и эксплуатации.

Задача была не просто перевезти железо из одной стойки в другую. Нужно было сохранить текущие IP-адреса, не заставлять клиентов менять DNS-настройки и выполнить миграцию с минимальным воздействием на сервисы. Внутренний дедлайн тоже был жёстким: успеть до начала горячего для нас эксплуатационного сезона (нового учебного года). Чем дольше мы оставались на площадке с незакрытым риском охлаждения, тем выше была вероятность получить не контролируемую миграцию, а ещё один инцидент.

Именно в процессе подготовки стало понятно, что это всё-таки отдельная история. В первом переезде у нас не было такого набора ограничений: временный Leaf упёрся в 48 портов, постоянный Leaf пришлось освобождать через перекоммутацию оставшихся серверов, Spine нельзя было просто выключить и увезти, а прямую Leaf-to-Leaf связность после переезда мы решили оставить как аварийный путь.

Ниже — не повтор статьи про euNetworks → QupraDC, а разбор второго переезда: как мы готовили NorthC, как использовали подменный leaf3, как пережили нехватку портов, как перевезли spine1 без потери EVPN-сигнализации и почему временная перемычка между Leaf в итоге стала частью аварийного сценария.

Исходное состояние и план переезда
Перед новым переездом площадка уже была построена как EVPN/VXLAN-фабрика. У нас были Leaf-коммутаторы, Spine, routed host networking для гипервизоров, BGP-анонсы VM-префиксов и внешний транзит, разнесённый по Leaf.

То есть мы уже не начинали с нуля. Это была не временная сеть, которую нужно было сначала переделать, а рабочая фабрика, которую надо было физически перенести из одного дата-центра в другой.

Базовая идея осталась прежней:
  • поставить новый Leaf в NorthC;
  • временно включить его в существующую фабрику;
  • постепенно переносить серверы;
  • сохранить клиентскую адресацию;
  • не останавливать сервис;
  • после завершения миграции вернуть временное оборудование поставщику.

Перед началом переезда сперва нужно было подготовить площадку на стороне поставщика. Это важная часть, потому что без неё вся красивая миграционная схема осталась бы только схемой. Мы запросили:
  • подменное железо на время миграции — L3-коммутатор класса Leaf с 48 портами доступа и 6 портами QSFP28, тот самый будущий leaf3;
  • два L2 40G-канала между QupraDC и NorthC;
  • два L3 100G-канала в Интернет для внешней связности уже из нового дата-центра;
  • management-подключение для управления подменным коммутатором;
  • отдельные management-подключения для постоянных коммутаторов после их физического переезда в NorthC.
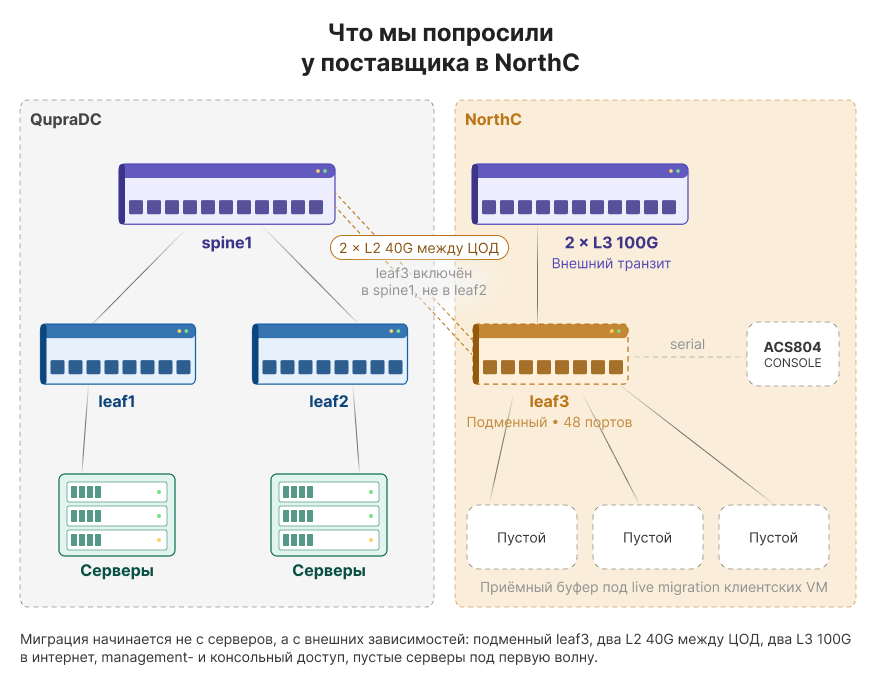


Здесь важно не перепутать назначение каналов. L2 40G между дата-центрами был нужен не для растягивания клиентских VLAN и не для построения большого L2-домена между площадками. Это был временный транспорт, поверх которого мы могли поднять свою IP-связность и включить новый Leaf в существующую фабрику. А два L3 100G-канала в Интернет были нужны для того, чтобы новая площадка получила внешнюю связность до завершения всего физического переезда.

Только после того как поставщик реализовал эти условия, мы начали саму миграцию. В таких работах нельзя сначала перевезти железо, а потом внезапно выяснить, что нет out-of-band управления, не готовы междатацентровые каналы или внешняя связность в новом ЦОД существует только на схеме.

После выполнения требований поставщиком я попросил смонтировать в NorthC несколько новых пустых серверов под живую миграцию клиентских виртуальных машин. Это был приёмный буфер для первой волны: туда можно было переносить VM до того, как в новый дата-центр физически переедет основная масса существующих гипервизоров.

Отдельная бытовая, но важная деталь — первичная настройка подменного коммутатора. Leaf3 приехал без нашей конфигурации, а значит, его сначала нужно было как-то настроить до появления нормального management-доступа через продакшен-сеть. Для этого я использовал наш старый Vertiv Avocent ACS804, который мы заранее сняли из QupraDC. Консольный сервер в таких работах — не роскошь, а страховка от ситуации, когда коробка стоит в другой стране с пустым конфигом, OOBM ещё не настроен, а единственный способ поговорить с ней — serial console.

Задача leaf3 была простой: стать временным Leaf в новой локации и дать нам возможность начать перенос серверов до того, как туда переедет всё основное сетевое оборудование.

Первая волна: leaf3 в NorthC и миграция до упора в порты
Leaf3 физически установили в NorthC и временно включили в существующую фабрику. С точки зрения сети он стал ещё одним Leaf-коммутатором, только расположенным в новом дата-центре.

Как и в прошлой миграции, нам была важна не магия конкретного канала между площадками, а его свойства: нормальная IP-связность underlay, достаточный MTU, стабильность и возможность использовать канал как временный транспорт для overlay. Временная связность нужна была для того, чтобы Leaf в новой локации мог стать участником существующей IP-фабрики.

После включения leaf3 мы начали переносить серверы в NorthC партиями. Модель подключения гипервизоров не менялась: серверы по-прежнему работали в routed-модели, VM-префиксы продолжали анонсироваться через BGP, а достижимость внутри фабрики обеспечивалась через EVPN/VXLAN.

Но быстро проявилось ограничение, которого в первой миграции не было в таком виде: портовая ёмкость.

На временном Leaf было 48 портов доступа. При нашей схеме подключения один такой коммутатор физически не мог принять всю площадку целиком. Портовая ёмкость закончилась раньше, чем закончились серверы.
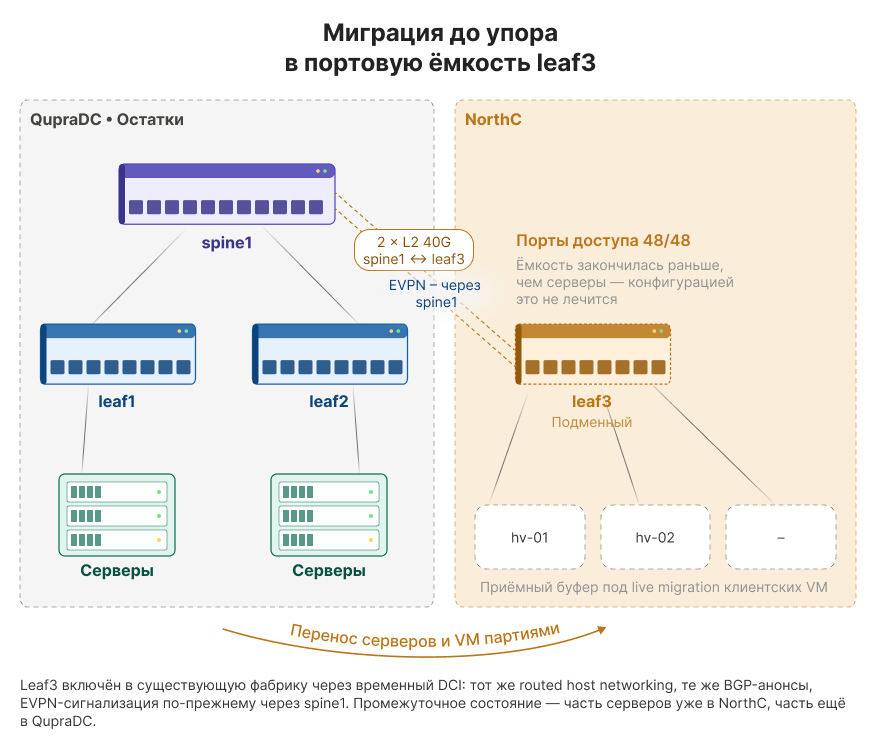

Поэтому мы мигрировали до тех пор, пока на leaf3 не закончились свободные порты. Это было нормальное промежуточное состояние: часть серверов уже работала в NorthC через leaf3, часть оставалась в QupraDC на старых Leaf-коммутаторах, а фабрика продолжала жить как единая система.

В таких миграциях важно не пытаться прыгнуть дальше, чем позволяет физика или бюджет. Если портов не хватает и их нельзя «донастроить» конфигурацией — нужно менять план коммутации.

Освобождаем leaf1 и продолжаем переезд
Чтобы продолжить перенос, нам нужно было получить ещё один Leaf в NorthC. Покупать новый постоянный коммутатор под эту задачу не хотелось, а leaf3 был временным и должен был вернуться поставщику. Поэтому мы пошли другим путём: освободили один из действующих Leaf-коммутаторов.

На тот момент часть серверов ещё оставалась в QupraDC. Мы перекоммутировали оставшиеся подключения так, чтобы освободить leaf1: все порты серверов, которые ещё оставались в старой локации, временно собрали на leaf2. Leaf2 продолжал работать в QupraDC и держал оставшуюся часть нагрузки. Это стало возможным за счёт того, что часть серверов с leaf1 и leaf2 уже переехала в NorthC на leaf3, освободив достаточное количество портов на leaf2, чтобы принять оставшуюся нагрузку.

Это не было целевым отказоустойчивым состоянием. Но для короткого этапа миграции такая схема была приемлема: мы понимали, зачем её делаем, какие у неё ограничения и когда должны из неё выйти.

После освобождения leaf1 мы физически перевезли его в NorthC и включили в фабрику уже в новой локации. В NorthC у нас появились два Leaf-коммутатора: временный leaf3 и постоянный leaf1. Это дало дополнительную портовую ёмкость и позволило завершить перенос оставшейся серверной нагрузки.

В итоге серверная нагрузка переехала в NorthC, но оставалась следующая важная проблема: как перевезти Spine.

Самая неприятная часть: как перевезти Spine и не порвать overlay
Если Leaf-коммутаторы уже находятся в NorthC, а Spine всё ещё остаётся в QupraDC, фабрика продолжает работать за счёт временной междатацентровой связности. Но Spine нельзя просто выключить и перевезти, если Leaf-коммутаторы в новой локации используют его как точку обмена маршрутной и EVPN-информацией.

Проблема была в следующем: если выключить spine1 без подготовки, leaf1 и leaf3 потеряют через него маршруты друг друга. А это уже риск для overlay-сервисов и для клиентского трафика.

Нам нужно было сделать так, чтобы Leaf-коммутаторы в NorthC продолжали видеть loopback-адреса друг друга и обмениваться EVPN-информацией даже в момент, когда spine1 физически выключен и едет из одного дата-центра в другой.

Решение получилось простым и достаточно красивым: мы соединили leaf1 и leaf3 напрямую 100G DAC-кабелем.

Но одного физического кабеля оказалось недостаточно. Нужно было временно построить маленький underlay между этими двумя Leaf-коммутаторами и дать overlay нормальную достижимость.

Для underlay между leaf1 и leaf3 мы использовали ISIS (протокол маршрутизации). Его задача была не заменить всю фабрику, а решить конкретную временную задачу: просигнализировать loopback-адреса Leaf-коммутаторов и обеспечить IP-достижимость, поверх которой можно продолжить работу overlay.

После этого между Leaf-коммутаторами была настроена BGP-сигнализация для EVPN. Иными словами, мы дали leaf1 и leaf3 возможность обмениваться EVPN-информацией напрямую, минуя spine1 на время его физического переезда.

С точки зрения логики это был временный обходной путь:
  • физически leaf1 и leaf3 соединены прямым 100G DAC;
  • underlay-достижимость loopback-адресов обеспечивается через ISIS;
  • overlay продолжает работать через EVPN;
  • Leaf-коммутаторы видят необходимые префиксы друг друга;
  • spine1 можно выключить и перевезти без потери клиентского сервиса.
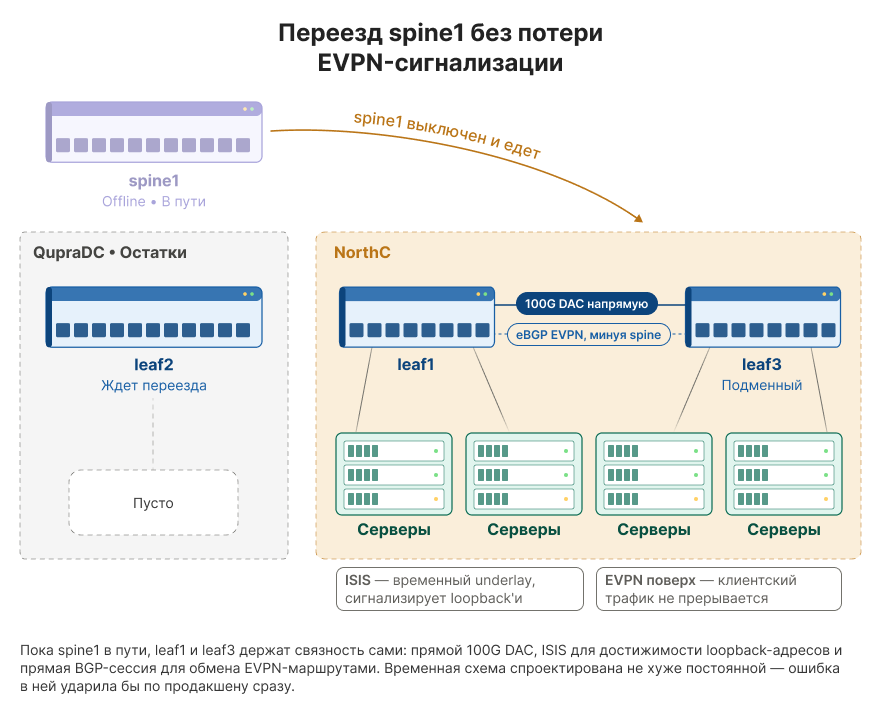

Это как раз тот случай, когда временная схема должна быть спроектирована не хуже постоянной. Она нужна на короткое время, но ошибка в ней может ударить по продакшену сразу.

После проверки прямой связности, ISIS-соседства, loopback reachability и EVPN-обмена мы перевезли spine1 в NorthC. Клиентский трафик при этом не пострадал: Leaf-коммутаторы на новой площадке продолжили видеть друг друга через временную прямую связку.

После переезда Spine мы решили не убирать саму идею прямой Leaf-to-Leaf связности полностью. Временная перемычка показала себя полезной как аварийный сценарий на случай проблем с единственным Spine, поэтому в целевой схеме между постоянными Leaf-коммутаторами мы оставили прямой 100G DAC-линк.

Но оставлять его как равноправный рабочий путь не хотелось. В нормальном состоянии overlay-сигнализация должна идти через Spine, а прямой линк между Leaf должен оставаться резервным вариантом, не превращаясь в скрытую альтернативную магистраль. Поэтому мы сделали два предохранителя: один на уровне overlay, второй на уровне underlay.

На уровне overlay на каждом Leaf в экспортной политике мы добавили трёхкратный AS-PATH prepend с собственной AS — искусственно увеличив длину AS-PATH. EVPN-маршруты, полученные через прямую Leaf-to-Leaf BGP-сессию, становятся менее предпочтительными по AS-PATH. Пока BGP-сигнализация overlay нормально работает через spine1, маршруты через прямую Leaf-to-Leaf сессию не выбираются как основные.

На уровне underlay мы тоже не хотели, чтобы прямой линк случайно стал приоритетным путём при исправном Spine. Поэтому ISIS на этой перемычке был настроен как локальный L1 с выставленным route preference 171. То есть такой underlay-путь заведомо менее предпочтителен, чем любой путь через eBGP в основной фабрике.

В результате прямой 100G DAC между Leaf не нагружает обычный трафик при исправном spine1. Он вступает в работу только тогда, когда ломается основной путь: пропадает нормальная BGP-сигнализация overlay через Spine и вместе с ней основной underlay-путь до loopback-адресов. Получается не постоянный обход Spine, а аварийная страховка от его отказа.

Возвращаем временный Leaf поставщику
После переезда spine1 в NorthC у нас в новой локации оказалось больше сетевого оборудования, чем нужно для целевого состояния. Временный leaf3 выполнил свою задачу: он дал нам возможность начать миграцию, пережить нехватку портов и сохранить управляемость переезда. Но по условиям проекта его нужно было вернуть поставщику.

Leaf3 нельзя было оставлять по принципу «пусть пока постоит». Основная проблема была не только в том, что в схеме оставался временный коммутатор и связанный с ним технический долг. Более критичным фактором были операционные расходы: временное железо быстро превращается в постоянный OPEX и начинает ежемесячно увеличивать стоимость эксплуатации, хотя в целевой архитектуре оно уже не требуется.

Поэтому возврат leaf3 поставщику был не формальностью, а полноценным этапом миграции. К этому моменту в NorthC уже можно было собрать целевую схему на постоянных Leaf-коммутаторах, поэтому мы начали обратную перекоммутацию: переносили серверные подключения с leaf3 на leaf1 и leaf2.

Как мы перекоммутировали серверные линк-и без остановки VM
Отдельно стоит рассказать, как именно мы переключали серверы с временного leaf3 на постоянные leaf1 и leaf2. Со стороны это выглядит как простая физическая перекоммутация: был линк в leaf3, стал линк в leaf1 или leaf2. Но если сделать это грубо, можно получить потери трафика или неочевидную асимметрию маршрутизации.

Мы делали переключение шагающим способом. Сначала административно гасили нужный интерфейс на leaf3. После этого для сервера линк переходил в состояние down, а связанный с ним next-hop исчезал из RIB/FIB. Для исходящего трафика это было ключевым моментом: сервер больше не пытался отправлять пакеты через уже выключенный путь, а оставшийся живой next-hop продолжал использоваться как рабочий путь в ECMP-группе.

После этого физический линк можно было переносить на новый Leaf. Когда порт поднимался уже на leaf1 или leaf2, появлялась новая связность, маршруты возвращались в таблицу, и сервер снова получал несколько рабочих путей. Затем мы переходили к следующему линку. То есть мы не выдёргивали всё сразу, а последовательно убирали из работы один путь, дожидались корректного пересчёта forwarding-состояния и только потом двигались дальше.

С входящим трафиком логика была похожей, но работала через BGP-сигнализацию. Достижимость клиентских виртуальных машин была анонсирована через BGP и два route reflector. Когда один из путей становился недоступен, соответствующая сигнализация пропадала, и путь к пересылке уходил на оставшийся живой next-hop. Поскольку порты гасились непосредственно на коммутаторе, событие link down доходило до сетевого стека сразу, без ожидания долгих таймаутов. После этого обновлялись RIB/FIB, и фабрика переставала использовать нерабочий путь.

В результате физическая перекоммутация серверов не требовала остановки клиентских VM. Мы не переносили риск на уровень виртуальных машин, а управляли им на уровне линков, next-hop'ов и BGP-сигнализации. Каждый шаг был маленьким: погасили один порт, убедились, что трафик ушёл на живой путь, перенесли линк, проверили восстановление связности и только после этого переходили к следующему.

После перекоммутации серверов на leaf1 и leaf2 мы вывели leaf3 из фабрики, проверили, что на нём не осталось клиентской и сервисной нагрузки, и вернули коммутатор поставщику.

В целевом состоянии площадка в NorthC снова осталась на постоянной архитектуре:
  • серверы подключены к leaf1 и leaf2;
  • spine1 находится в новой локации;
  • временный leaf3 выведен из эксплуатации;
  • между постоянными Leaf оставлена прямая 100G-связность как резервный путь для EVPN и underlay-достижимости;
  • клиентская адресация сохранена;
  • overlay/underlay-модель не менялась;
  • миграция выполнена без остановки сервиса.

Что получилось в итоге
Этот переезд был похож на предыдущий только на верхнем уровне: добавить Leaf в новой локации, перенести серверы, перевезти старое оборудование, разобрать временные связи. На практике он оказался интереснее из-за портовой ёмкости и необходимости аккуратно перевезти Spine.

Главное отличие было в том, что нам пришлось мигрировать не просто «из старого ЦОД в новый», а через несколько вынужденных состояний:
  1. Сначала запросить у поставщика подменный Leaf, два L2 40G-канала между дата-центрами, два L3 100G-канала в Интернет и management-доступ.
  2. Дождаться готовности этой базовой инфраструктуры.
  3. Смонтировать несколько пустых серверов под живую миграцию клиентских VM.
  4. Поднять первичный доступ к подменному Leaf через консольный сервер.
  5. Затем включить leaf3 как подменный Leaf в NorthC.
  6. Потом провести миграцию до исчерпания его 48 портов.
  7. Затем освободить leaf1 за счёт временной концентрации оставшейся нагрузки на leaf2.
  8. Далее перенести перенос leaf1 в NorthC и завершить серверную миграцию.
  9. Пробросить прямой 100G DAC между leaf1 и leaf3, ISIS как временный underlay между Leaf-коммутаторами, организовать EVPN-соседство между ними без участия spine1.
  10. Выполнить физический переезд spine1.
  11. Шагающая перекоммутация серверных линков с leaf3 на leaf1 и leaf2 через управляемый link down;
  12. Вернуть leaf3 поставщику.

На бумаге такая последовательность выглядит длинной. В эксплуатации именно это и спасает: каждое состояние можно проверить, отмониторить и откатить или задержаться в нём, если что-то пошло не так.

Мы снова сделали переезд дистанционно из России, используя удалённые руки в дата-центре. Для такой работы критично, чтобы сеть была управляемой фабрикой с понятными ролями устройств, понятной маршрутизацией, понятной телеметрией и доступом к оборудованию вне основной продакшен-сети.

Практические выводы
1. Миграция начинается не с перетыкания серверов, а с подготовки внешних зависимостей. Резервные коммутаторы, междатацентровые каналы, внешняя связность, management-доступ, консольный доступ и пустые серверы под live migration должны быть готовы до начала работ, иначе контролируемый переезд быстро превращается в импровизацию.

2. Временный Leaf — нормальный инструмент миграции, если заранее понимать, когда и как он будет выведен из схемы. Временное оборудование не должно незаметно становиться частью постоянной архитектуры.

2. Портовая ёмкость — это не мелочь. Если у каждого сервера несколько физических подключений, один 48-портовый Leaf очень быстро перестаёт быть достаточным для переезда всей площадки. План миграции должен учитывать не только BGP, EVPN и MTU, но и банальное количество физических портов.

4. Освобождение постоянного оборудования может быть частью плана. Мы не покупали ещё одну коробку только потому, что временный leaf3 упёрся в 48 портов. Вместо этого мы временно сконцентрировали остаток нагрузки на leaf2, освободили leaf1, перевезли его и продолжили миграцию.

5. Spine нельзя считать просто «транспортной коробкой», которую можно выключить в любой момент. Если через него Leaf-коммутаторы получают EVPN-информацию друг о друге, его переезд нужно готовить отдельно. В нашем случае прямой 100G DAC между Leaf, ISIS для underlay и EVPN-сигнализация поверх него позволили перевезти spine1 без удара по клиентскому трафику.

6. Временную аварийную связность иногда имеет смысл оставить, но только если она не становится основным путём. Прямой 100G DAC между Leaf мы оставили как страховку от проблем с единственным Spine, но сделали его менее предпочтительным сразу на двух слоях. В overlay — через eBGP AS-PATH prepend. В underlay — через ISIS с L1 preference 171. В штатном режиме сигнализация и трафик идут через Spine; прямой Leaf-to-Leaf линк нужен только тогда, когда основной путь через Spine перестаёт работать.

7. Хорошая миграция — это не героическое ночное переключение, а цепочка скучных проверяемых шагов. Чем скучнее каждый отдельный шаг, тем выше шанс, что весь переезд пройдёт без аварии.

Итог простой: IP-фабрика снова позволила нам переехать без остановки сервиса. В первый раз она помогла превратить вынужденный переезд в улучшение архитектуры. Во второй — позволила пережить нехватку портов, временный подменный Leaf и физический переезд Spine, не меняя базовую сетевую модель и не заставляя клиентов участвовать в наших приключениях.

Автор статьи: Рене, сетевой инженер FirstVDS
firstvds.ru

Принимаем поздравления с новосельем


Мы завершили перенос инфраструктуры в новый дата-центр NorthC Amsterdam 1. Новая площадка полностью соответствует нашим требованиям по надёжности, уровню инженерной инфраструктуры и качеству эксплуатации.

Надёжность уровня Tier 3
Дата-центр соответствует стандарту Tier 3, что означает резервирование ключевых инженерных систем, включая электропитание, охлаждение и сетевые подключения.

Современная инфраструктура
NorthC Amsterdam 1 принадлежит компании NorthC — крупному оператору дата-центров с сетью площадок в Нидерландах, Германии и Швейцарии.

firstvds.ru/products/vps_vds_netherlands

Август — переезд в новый ДЦ, итоги исследования по DDoS-атакам и много новых рецептов

Решили всеми силами продлить лето. Давайте с нами! Всего-то и нужно: солнце, яркие впечатления и занятия, которые мы обычно планируем на жаркий сезон. Так что если вы не успели поесть арбуза или выбраться на природу, планируйте на сентябрь. Время точно есть!

А пока можно добрать витамина D в ближайшем парке за приятным чтением нашего дайджеста. Собрали отличный урожай за август и спешим им поделиться.


В этом выпуске: итоги совместного исследования о DDoS-атаках, переезд в новый дата-центр в Нидерландах, много свежего ПО для автоустановки на сервер и тысячная статья на Хабре. Читаем и заряжаемся летним настроением если не до снега, то хотя бы до следующего дайджеста.

Статьи и инструкции
Анатомия дата-центра: как устроены ЦОДы изнутри

Чтобы лето было бесконечным, можно переехать в южную страну. А чтобы к бесконечности стремился аптайм, при выборе хостинг-провайдера стоит обращать внимание на дата-центр, в котором размещаются серверы. В статье заглянем внутрь ЦОДа, разберём «по косточкам» его устройство и определимся с параметрами выбора.
firstvds.ru/blog/anatomiya-data-centra-kak-ustroeny-cody-iznutri

Установка Hermes Agent на VPS
Hermes Agent — это умный AI-сервис на вашем сервере. Он самостоятельно подключается к разным LLM, работает с API и интегрируется в любые сценарии — от мессенджеров и приложений до внутренних систем. В статье разберём, как установить его на Ubuntu пошагово и без сложностей.
firstvds.ru/technology/ustanovka-hermes-agent-na-vps

Habr: самое интересное за август
Эта подборка — особенная. В августе в нашем блоге на Хабре вышла тысячная статья!

Всё началось в 2013 году с материала про Хакатон, а сегодня у нас уже 1000 статей. Мы писали про серверы и сети, разработку в Linux и DevOps-практики. Проводили нескучные DIY-эксперименты, готовили гайды для новичков и глубокие разборы для профи, развлекали вас научпопом и заставляли задуматься о вечном. Охватили множество тем и получили кучу ваших комментариев и правок. Спасибо, что вы с нами! В честь этого события собрали немного познавательной статистики — можно посмотреть здесь.
А теперь — лучшие статьи августа. Рассказываем об эволюции Vue, безопасной работе с секретами в Docker, LoRa-ретрансляторах своими руками и SQL-антипаттернах, которые тормозят запросы.
История одного архитектурного круга: реактивность Vue
Куда на самом деле попадает секрет при сборке Docker-образа: разбираем 8 способов
Ретранслятор LoRa своими руками: увеличиваем дальность связи без лишней мощности (Юбилейная!)
Четыре антипаттерна CTE в PostgreSQL: разбираем на EXPLAIN ANALYZE


Ищем авторов для блога на Хабр.
Подготовьте статью на одну из специальных тем или отправьте материал на тему месяца. И если ваша статья подойдёт для блога, вы получите повышенный гонорар. Тема сентября: Сетевые технологии.
firstvds.ru/avtoram

Новости августа
Новые функции и обновление адресов S3


Новые функции
В августовский релиз вошли три функции:
  • Временные ссылки без ограничения срока действия. Теперь вы сами выбираете, сколько будет действовать ссылка — от нескольких минут до месяцев.
  • Правила жизненного цикла в интерфейсе. Можно настроить автоматическое удаление объектов и незавершённых мультипарт-загрузок через нужное количество дней.
  • Мультипарт-загрузки синхронизируются между устройствами. Начали загружать большой файл на одном устройстве — сможете найти и продолжить загрузку на другом.
Обновление адресов
Мы выводим объектное хранилище S3 на выделенные домены второго уровня, чтобы повысить отказоустойчивость, улучшить балансировку и изолировать инфраструктуру. Теперь публичные ссылки на файлы генерируются по новому адресу: вместо s3.firstvds.ru используется firsts3.ru.
Если вы используете публичные ссылки на файлы из нашего S3-хранилища, пожалуйста, обновите адреса до 28 августа — иначе ссылки перестанут работать. Новые домены уже работают, со старых настроен редирект. Вы можете начать обновление уже сейчас — доступ к файлам сохранится.

Доступна тестовая идентификация доменов через Госуслуги
С 1 сентября владельцам доменов в зонах .RU,.РФ и .SU нужно будет проходить идентификацию через Госуслуги. Наш партнёр Webnames уже запустил тестовую возможность для физлиц — можно пройти процедуру заранее и убедиться, что всё работает.
И главное: если срок действия вашего домена заканчивается в ближайшие 60 дней, продлите его сейчас. До 1 сентября это можно сделать без идентификации — и у вас будет целый год, чтобы спокойно разобраться с новыми требованиями.
firstvds.ru/blog/dostupna-testovaya-identifikaciya-domenov-cherez-gosuslugi


Новые рецепты для автоустановки на сервере
Продолжаем пополнять базу наших рецептов. В последний месяц лета добавили сразу три готовых решения:
Docker — платформа для упаковки приложений в контейнеры, чтобы они работали одинаково на любом сервере.
Dockhand — веб-панель для управления Docker-инфраструктурой: запуск, остановка, просмотр логов и метрики. Работать в терминале можно прямо из браузера.
Mattermost — корпоративный мессенджер с открытым исходным кодом. Альтернатива Slack на вашем сервере.
При заказе виртуального сервера выберите нужный рецепт и получите VDS с уже установленным ПО, готовым для работы.


Кто в зоне риска: подводим итоги исследования DDoS-атак
Помните, мы запускали опрос среди клиентов и обещали поделиться результатами? Вместе с DDoS-Guard провели большое исследование: изучили глобальную статистику — более 7,5 млн инцидентов за 3 года, опросили больше 200 клиентов (спасибо всем, кто участвовал!), проанализировали данные наших пользователей. Теперь готовы показать, что получилось.
Главные выводы:
  • за три года число атак выросло с 2,2 до 2,5 млн, их распределённость — на 480%, а сами атаки стали умнее и длиннее;
  • 40% атак приходятся на первые два месяца после запуска проекта;
  • атаки сместились на прикладной уровень, а Pulse Wave стал массовым инструментом.
Подробно о том, кто попадает под удар чаще всего и как защититься — в нашей статье.
firstvds.ru/blog/ddos-ataki-2026-evolyuciya-ugrozy-kto-nakhoditsya-v-zone-riska


Переезд в Нидерландах: финишная прямая
В июле мы объявили о переезде в дата-центр NorthC Amsterdam 1 — площадку уровня Tier III. Причина была серьёзной: охлаждение в старом ЦОДе работало на резервном чиллере без дополнительного питания, и ждать восстановления было небезопасно для ваших проектов.
А спустя некоторое время начался процесс миграции, который идёт полным ходом весь август. Работаем по графику, без сбоев и задержек. К началу сентября планируем уже завершить переезд.
Все работы проводятся с минимальным воздействием на сервисы. IP-адреса сохраняются, DNS-настройки менять не нужно. Статус работы сервисов в реальном времени можно отслеживать здесь, а связаться с поддержкой по любым вопросам — в Личном кабинете.
Ещё немного — и отпразднуем новоселье :)

Вам необходим кофе


Когда проекту перестаёт хватать обычных вычислительных ресурсов, на помощь приходят VDS с GPU.

Они подходят для задач, где важны скорость и производительность: машинное обучение, нейросети, 3D-моделирование, рендеринг, обработка и генерация видео.

Что мы предлагаем:
  • Современные видеокарты. Доступны конфигурации на базе Intel Xeon Scalable и AMD EPYC с видеокартами Nvidia L4, L40S, RTX 5090 и RTX 4090 Turbo.
  • Гибкий формат подключения GPU. Предлагаем два варианта: GPU Passthrough (выделенная физическая видеокарта) или vGPU (виртуальная видеокарта с выделенной долей ресурсов).
  • Посуточная тарификация. Вы платите только за те дни, когда сервер с GPU действительно используется. Можно арендовать сервер на минимальный срок без переплат.

А наш маркетолог порылся в сундуке и достал старый добрый заход:

Дешевле чашки кофе — от 299 ₽/сутки

firstvds.ru/products/vps-vds-gpu

DDoS-атаки 2026: эволюция угрозы. Кто находится в зоне риска?


Раньше считалось, что DDoS-атаки направлены на «крупную рыбу» — корпорации, госкомпании, банки. Но реальность 2026 года говорит о другом: жертвой злоумышленников может стать кто угодно.

За три года число атак выросло с 2,2 до 2,5 млн. Их распределённость увеличилась на 480%. DDoS-атаки стали массовым, доступным и, что самое опасное, «автоматизированным» инструментом.

Киберпреступникам больше не нужно тратить недели на подготовку, чтобы атаковать выбранный объект — теперь они используют суперботнеты и сложные алгоритмы, которые автоматически находят уязвимые для удара места за считанные минуты.

Вместе с DDoS-Guard мы решили разобраться, а есть ли кто-то, кто оказывается в красной зоне риска чаще других? Изменился ли характер атак за последние несколько лет? Для этого мы проанализировали данные клиентов, глобальную статистику атак и опросы владельцев бизнеса. В итоге получили портрет «идеальной» жертвы.

Как мы проводили исследование
Чтобы картина получилась объективной, каждая из компаний изучала данные со своей стороны, а затем мы объединили результаты.

У нас было несколько гипотез. Например, мы предполагали, что основной мишенью для атак служат интернет-магазины, а отсутствие защиты — почти гарантированный способ попасть под атаку в первые же месяцы после запуска проекта. Также нас интересовала связь с сезонностью и географической распределенностью атак, есть ли какие-то закономерности или нет. Эти предположения и легли в основу нашего анализа.

Мы изучили внутреннюю статистику клиентов: подключают ли защиту, как часто обращаются за помощью в поддержку те, кто попал под атаки. Дополнительно опросили больше двухсот наших пользователей — чтобы понять не только масштаб, но и детали, например, как часто они сталкиваются с DDoS-угрозой и как именно их атакуют.

Со своей стороны специалисты из DDoS-Guard предоставили глобальную статистику атак за три года — более 7,5 млн инцидентов. Эти данные охватывают типы атак, отраслевую структуру, географию источников и сезонные колебания.

Затем мы объединили все данные в единое исследование. Временной охват: 2023–2025 годы с экстраполяцией на 2026-й.

Анатомия DDoS-атаки
Для начала разберёмся, что из себя представляет современная DDoS-атака. Тем более, что за последние три года она серьёзно эволюционировала.

Кого атакуют
В 2023 году лидерами по числу атак были сферы «Искусство и досуг» (21%) и «Интернет и телеком» (15,6%), а также «СМИ» (12%).

К 2025 году картина изменилась. Теперь в лидеры вырвались сферы «Интернет и телеком» (24,5%), «Финансы» (15,5%) и «Государство и законодательство» (15%).


Также глобальная статистика DDoS-Guard помогла сделать другие интересные выводы. Количество атак на игровые сервисы в 2025 году выросло на 310% по сравнению с 2024 годом. Цифра, которая заставляет задуматься. Почему гейминг? Наше предположение: игроки вовлечены эмоционально, и даже короткий даунтайм для них катастрофа. Если вы пользуетесь Steam, то наверняка помните октябрь 2025, когда платформа лежала из-за DDoS-атаки. Час простоя — и компания потеряла часть аудитории и понесла огромные убытки.

Прирост атак по отраслям, 2023–2025 гг. (статистика DDoS-Guard)


Также растут атаки на государственные порталы (+249,6%), интернет и телеком (+80,8%) и финансовые сервисы (+45,4%). Здесь причины, вероятнее всего, завязаны в большей степени на политику и экономику.

Что касается бизнес-сектора, картина тоже получается интересная. В 2024 году атаки на бизнес-сектор выросли почти на 63%, а в 2025 — снизились на 2,6%. Правда, радоваться рано, угроза никуда не делась. Да, хакеры сосредоточились на других целях, но и про бизнес не забывают.

Таким образом, статистика DDoS-Guard показывает: в 2025 году внимание хакеров сосредоточилось на телекоме, финансах и госсекторе — это лидеры по количеству атак среди отраслей. Если говорить о динамике, то хакеры стали чаще бить по игровой индустрии и здравоохранению. Бизнес-сектор тоже в списке — даже при небольшом спаде в 2025 году риск для него остаётся высоким.

Согласно данным нашего опроса, почти две трети клиентов (63,85%) сообщили, что их проекты сталкивались с атаками за последний год. А среди пострадавших чаще всего встречались представители IT-услуг и SaaS (37,5%), e-commerce (25%) и игровой индустрии (18,3%).


Вывод: если вы работаете в игровой индустрии, госсекторе, телекоме, финансах, здравохранении или в бизнес-секторе — риск подвергнуться атаке стал заметно выше за последние годы.

Когда атакуют: окно уязвимости
Честно говоря, мы рассчитывали, что сможем отследить хоть какую-то сезонность в DDoS-атаках, и предполагали, что есть месяцы, когда активность хакеров заметно выше. Но наша гипотеза не подтвердилась — атаки происходят круглый год, без пауз.

Единственное, что можно отметить, регулярный небольшой всплеск в январе, который, скорее всего, связан с новогодними праздниками. Периодически наблюдаются всплески летом, но они не привязаны к конкретному месяцу — в 2023 году это был июль, в 2025-м — август.

Любопытно, что в 2023–2025 годах пик подключений защиты приходился на март-апрель. В 2026-м такого не случилось. Почему — только гадаем. Может, весной традиционно запускают новые проекты. А может, просто совпадение. Ясно одно: сезонных передышек не будет.

Гораздо интереснее оказалось проверить связь с «возрастом» проекта. 40% атак приходятся на первые два месяца после запуска сервера. И это логично: ботнеты круглосуточно сканируют интернет в поисках свежих IP-адресов и доменов. Новый сервер автоматически становится целью.

Впрочем, наши данные говорят, что большинство клиентов подключают защиту превентивно: 57% — сразу при покупке сервера, ещё 16% — в течение первых двух месяцев. Судя по опросу, многие из них уже сталкивались с атаками раньше и действуют на опережение.


Вывод: получается, первые два месяца после запуска сервера — время, когда риск атаки максимален. И никаких «тихих» месяцев нет: атаки идут круглый год.

Атаки стали длиннее и умнее
Теперь о том, как именно выглядит современная DDoS-атака. Данные опроса и глобальной статистики рисуют тревожную картину.

Начнём с периодичности. Почти треть пострадавших за год пережили атаки 1–3 раза. Но столько же (32,56%) сталкиваются с ними регулярно, раз в месяц или чаще. А 11,63% живут под постоянным давлением — ежедневно или ежечасно. Для многих это не разовое событие, а хроническая проблема.


Раньше считалось, что DDoS — это краткосрочный удар, чтобы досадить или вынудить заплатить. Но сегодня ситуация складывается иная. Согласно опросу, 31,62% атак длятся более суток, ещё 21,37% — от 1 до 6 часов. И только 15,38% укладываются в промежуток 10–60 минут, который раньше считался «золотой серединой».


Атаки становятся долгими и изматывающими. Это уже не быстрый удар, а затяжной прессинг, который может парализовать бизнес на дни. Для интернет-магазина в сезон распродаж суточный простой — катастрофа. Для облачного сервиса — потеря клиентов, которые не готовы ждать.

Меняется не только длительность, но и сама природа атак. Глобальная статистика DDoS-Guard за три года показывает устойчивое смещение в сторону прикладного уровня.


Общее число атак растёт — с 2,26 млн в 2023 до 2,5 млн в 2025. Но важно другое: L7-атаки растут и в абсолютных цифрах, и в доле (с 80,4% до 83,7%), а L3/L4-атаки, наоборот, снижаются.

Хакеры всё чаще бьют на прикладном уровне — имитируют поведение реальных пользователей, грузят тяжёлые страницы, дёргают API, перегружают базу данных и процессор. Канал при этом может оставаться свободным, а сервер — задыхаться. Такую атаку сложнее заметить и отразить.


И ещё один опасный паттерн, который набирает популярность, — Pulse Wave. Это когда волны вредоносного трафика идут с короткими паузами. Многие системы защиты «успокаиваются» во время паузы, а затем не успевают среагировать на новую волну. Это сбивает с толку автоматику и делает защиту бесполезной.

DDoS-Guard проанализировала более 10 000 атак на крупной точке обмена трафиком — и 27% из них оказались Pulse Wave. Тактика, которая ещё несколько лет назад считалась редкой и сложной, сегодня становится мейнстримом.

География атак
Картина источников атак каждый год примерно одинаковая, но с локальными ротациями.

На первых двух местах всегда Россия и США. США — за счёт огромного количества прокси-серверов, которые используются как промежуточные узлы. Россия — за счёт внутреннего трафика, который пытается обойти геоблокировки.

Следующие места чаще всего занимают страны Латинской Америки (например, Бразилия) и Юго-Восточной Азии (Индонезия). Причина? Огромное количество IoT-устройств с заводскими паролями, которые становятся частью ботнетов.

Также в топе — Китай (особенно Гонконг) и Германия. У первых — бесконечное количество уязвимых устройств, у вторых — высокая плотность телеком-инфраструктуры.


В 2026 году к этому списку добавился Бангладеш — регион с низким уровнем цифровой грамотности и массовым распространением «умных устройств».

За два года распределённость атак выросла на 480%. В 2023 году количество уникальных IP-адресов, задействованных в одной атаке, составило 353 тысячи. В 2025 — уже более 2 миллионов, а в первом квартале 2026 года произошла атака, в рамках которой были зафиксированы уже 3,1 млн уникальных IP-адресов.

Получается, что трафик при этом идёт одновременно из миллионов источников по всему миру. И если ваш проект работает на глобальную аудиторию, рассчитывать на геоблокировку не приходится. Но если работаете только с определенными странами, это вполне рабочий инструмент. Можно отключить трафик из регионов, где у вас нет клиентов, и тем самым снизить риск атак.

Вывод: современные атаки распределённые, и профессиональная фильтрация трафика — основной инструмент защиты. Одной геоблокировки будет недостаточно.

Паттерн современной атаки: краткий вывод
Если обобщить всё, что мы узнали о современных DDoS-атаках, получается следующая картина.

С вероятностью 80% это будет атака на прикладном уровне L7. Скорее всего, она будет распределённой — трафик придёт одновременно из тысяч источников по всему миру. Длиться она может часами, а в каждом третьем случае — сутками и более. При этом атака, скорее всего, будет использовать тактику Pulse Wave: волны трафика с паузами, чтобы сбить с толку автоматические системы защиты.

Для бизнеса это означает, что старые методы защиты — простые фаерволы, скрипты или бесплатные прокси-сервисы — против такой атаки не работают. Нужны профессиональные решения, способные фильтровать L7-трафик, анализировать поведение и держать удар часами без сбоев.


Бизнес наносит ответный удар
После того как мы разобрались с тем, как выглядят современные атаки, посмотрим, как бизнес сталкивается с ними на практике.

Как узнают об атаке
Для 40% опрошенных сигналом стала полная недоступность сайта или сервиса. То есть они узнают о проблеме постфактум — когда она уже случилась. Ещё 23% полагаются на системы мониторинга, которые срабатывают в момент атаки. Остальные замечают аномалии в логах, получают уведомления от хостинг-провайдера или получают информацию от пользователей.


Какие решения используют для защиты
Мы также посмотрели, какие решения использовали наши клиенты до текущего момента. 37,29% респондентов обращались к сторонним сервисам (например, Cloudflare), 33,33% настраивали защиту самостоятельно — фаерволы, скрипты. 25,42% не использовали ничего.

Среди клиентов FirstVDS, которые подключают защиту, часть использует решение от DDoS-Guard. Оно встроено в нашу хостинг-инфраструктуру и доступно как отдельная услуга.

Последствия и восприятие риска
Один из наших вопросов звучал так: к каким последствиям приводили атаки. Почти половина опрошенных (48,62%) пережили полные простои и недоступность сервиса. Для 19,27% атака привела к деградации работоспособности — сайт работал, но с перебоями. 13,76% респондентов сказали, что «не было значительных последствий».


При этом бизнес чувствует ухудшение ситуации: 44,6% опрошенных считают, что риск DDoS-атак для их отрасли вырос по сравнению с прошлым годом. И только 6,2% видят снижение риска.

Интересное. В 2025 году количество обращений в поддержку с упоминанием DDoS сократились на 38%. Прямой связи с подключением защиты мы не проверяли, но тренд любопытный. Атак больше, а обращений за помощью меньше.

Общий вывод по блоку
Две трети опрошенных сталкивались с атаками за последний год. Почти половина из них пережили простои. При этом среди респондентов оказалось много тех, у кого защиты нет, а те, кто её подключает, используют разные решения — от бесплатных сервисов до профессиональных. И многие считают, что риск только растёт.

Кто под прицелом и что делатьТеперь у нас есть достаточно данных, чтобы собрать портрет «идеальной» жертвы.

В зоне повышенного риска — владельцы игровых сервисов, SaaS-платформ, интернет-магазинов, госсектор, телеком и финансовые проекты. Именно эти сферы хакеры атакуют активнее всего, по данным глобальной статистики и опроса.

Риск атаки особенно высок в первые два месяца после запуска проекта — на этот период приходится 40% всех случаев. Вероятнее всего, это будет L7-атака — на прикладном уровне, с имитацией поведения реальных пользователей. И продлится она более суток в каждом третьем случае. Трафик может прийти одновременно из миллионов источников по всему миру и идти волнами.

Что делать, чтобы не стать частью этой статистики:
  • Установить защиту в день запуска сервера. 40% атак случаются в первые два месяца. Ждать некогда.
  • Выбрать решение, которое соответствует современным угрозам. Атаки сместились на прикладной уровень, и инструменты, которые работали раньше, могут не справляться с распределённым L7-трафиком.
  • Настроить мониторинг. Не ждите, пока сайт упадет. Система должна предупреждать об аномалиях до того, как сервис станет недоступен.
  • Не полагаться только на геоблокировку. Она может быть полезна для локального бизнеса, но против глобальных распределённых атак нужна фильтрация трафика на уровне поведения, а не только по географическому признаку.

Атаки становятся умнее, длиннее и распределённее. Они происходят круглый год, без сезонных пауз. Данные исследования подтверждают: даже если одни цели привлекают хакеров больше других, под ударом может оказаться любой проект — независимо от размера и сферы.

Исследование подготовлено на основе совместных данных DDoS-Guard и FirstVDS. В анализе использованы внутренняя статистика FirstVDS, глобальная статистика DDoS-Guard за 2023–2025 годы (более 7,5 млн атак) и результаты опроса 204 владельцев бизнеса, проведённого FirstVDS.

firstvds.ru
ddos-guard.net

Июль — переезд в новый ЦОД, новые рецепты, обзор первого закона об ИИ и туториалы по безопасности на Хабре

Сезон отпусков в самом разгаре: кто-то уехал кормить чаек на побережье, кто-то покоряет горы, кто-то гоняет на эндуро по лесу. А мы… завариваем покрепче кофе, заводим офисный кондиционер и штурмуем гору задач — вовсю организуем переезд в новый дата-центр.


Если вы тоже из тех, кто проводит июль в офисе, давайте держаться вместе. Собрали для вас дайджест с полезными туториалами и актуальными новостями. Разберёмся с рабочими задачами, а там ещё останется куча времени для летних приключений!

Статьи и инструкции
Что такое NVMe SSD и чем он отличается от SATA SSD

При выборе сервера или VDS многие наверняка сталкивались с терминами SATA, SSD, NVMe и M.2. В статье разбираем, что означают эти понятия, сравниваем параметры и сценарии использования и помогаем выбрать накопители под свои задачи.
firstvds.ru/blog/chto-takoe-nvme

Первый закон об ИИ в России: что изменится для разработчиков и пользователей
До недавнего времени в законах не было даже определения ИИ. Теперь этот пробел закрыт: в марте 2026 года Минцифры предложило первый законопроект. Однако после активных обсуждений приняли решение его доработать. В статье разбираем основные тезисы обоих документов и кого коснутся изменения.
firstvds.ru/blog/pervyy-zakon-ob-ii-v-rossii-chto-izmenitsya-dlya-razrabotchikov-i-polzovateley

Как сменить данные администратора домена
С 1 сентября 2026 года в России будет введена обязательная идентификация администраторов доменов в зонах .ru,.рф и .su через портал госуслуг (ЕСИА). Без идентификации управлять доменом, в том числе продлить его, не получится. В статье расскажем, как проверить данные администратора и актуализировать их.
firstvds.ru/technology/kak-izmenit-dannye-administratora-domena-v-zonakh-rusurf

Habr: самое интересное за июль
На Хабре в этот раз сложно, но интересно. Хит месяца — статья о работе модуля LoRa. Загляните в комментарии, там настоящая битва умов: инженеры спорят о физике, кодировании и том, как выжать из LoRa максимум.

Также подготовили три полезных туториала. Расскажем, как строить локальную RAG-систему на базе понятного и полностью локального стека: Go + PostgreSQL + Ollama. А также представим подробное руководство по расследованию инцидентов в Linux в двух частях.


Ищем авторов для блога на Хабр.
Подготовьте статью на одну из специальных тем или отправьте материал на тему месяца. И если ваша статья подойдёт для блога, вы получите повышенный гонорар. Тема августа: DIY или Сделай Сам.
firstvds.ru/avtoram

Новости июля
Меняем ЦОД в Нидерландах

Приняли решение о переезде, поскольку охлаждение в Qupra DC2 всё ещё работает на резервном чиллере без дополнительного питания. Ждать полного восстановления площадки небезопасно для наших клиентов.
Мы сравнили доступные дата-центры в Нидерландах и выбрали NorthC Amsterdam 1 — как самый оптимальный баланс надёжности и скорости миграции. Новая площадка соответствует стандарту Tier III, имеет прямое подключение к AMS-IX (одной из крупнейших точек обмена трафиком в мире).
Переезд спланирован так, чтобы полностью исключить время недоступности серверов или свести его к минимуму — работы будут проходить в ночное время и выходные. Полный переезд займёт 1–1,5 месяца, точный график опубликуем позже и отправим уведомления на почту.
firstvds.ru/blog/pereezzhaem-v-northc-amsterdam-1


Добавили новые рецепты для автоустановки на сервере
Добавили два новых бесплатных рецепта для быстрого развёртывания сервисов на VDS — без ручной настройки.
Open WebUI + Ollama — готовое решение для работы с LLM на своём сервере. Позволяет общаться с LLM через веб-чат, загружать модели, управлять пользователями и правами доступа, подключать внешние API и хранить истории диалогов. Все данные остаются внутри вашей инфраструктуры — запросы не уходят в облачные сервисы.
firstvds.ru/technology/nachalo-raboty-s-open-webui-i-ollama
WordPress — автоматическая установка популярной CMS с готовым окружением: Apache, PHP-FPM, MariaDB, HTTPS и firewall. Подойдёт для запуска блога, корпоративного сайта, лендинга или витрины.
firstvds.ru/technology/nachalo-raboty-s-wordpress


Хорошие новости из Казахстана
В алматинской локации подключили ТТК в качестве второго аплинка наряду с провайдером RETN. Сейчас трафик между ними распределяется равномерно: в случае сбоя у одного из провайдеров сервисы останутся доступными.


Акция «Кешбэк по выходным» подходит к концу
У нас для вас две новости — срочная и приятная.
Срочная: акцию с кешбэком по выходным завершаем досрочно — уже 2 августа. Это значит, что ближайшие выходные (31.07–2.08) — последний шанс пополнить баланс с выгодой до 10%.
firstvds.ru/actions/cashback_weekend