Рейтинг
0.00

Hetzner дата-центры

23 читателя, 286 топиков

Готовый к использованию Kubernetes в облаке Hetzner


Эффективное применение CCM, CSI и экосистемы открытого исходного кода

Почему Kubernetes? Кто его использует и для чего?
Kubernetes — это платформа с открытым исходным кодом, которая автоматизирует развертывание, масштабирование и управление контейнеризированными приложениями. Первоначально разработанная в Google и выпущенная в 2014 году, она стала стандартом де-факто для оркестровки контейнеров. Ее основные преимущества можно суммировать в трех пунктах:
  • Автоматическое масштабирование: во время пиковых нагрузок кластер автоматически запускает дополнительные экземпляры и уменьшает их количество при снижении спроса. Даже такие организации, работающие с большими объемами данных, как CERN, используют Kubernetes для быстрого масштабирования своих систем в ответ на внезапные всплески спроса.
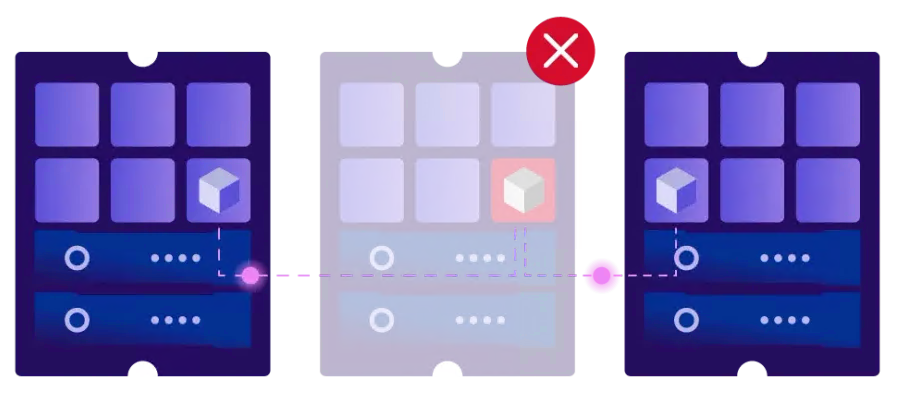
  • Самовосстановление: если выходит из строя контейнер или даже целый узел, Kubernetes автоматически перезапускает затронутые рабочие нагрузки или перемещает их на другие узлы. Приложение остается доступным, и никому не нужно вставать посреди ночи.
  • Последовательная работа: будь то микросервисная архитектура, традиционное веб-приложение или конвейер CI/CD, все использует одни и те же декларативные конфигурации и работает согласованно, независимо от базовой инфраструктуры.
  • Пользователи Kubernetes столь же разнообразны: команды, работающие с SaaS-приложениями или микросервисами, которым необходимо обрабатывать изменяющиеся нагрузки, команды DevOps, стремящиеся автоматизировать развертывание, и организации, желающие объединить несколько приложений на общей инфраструктуре и управлять ими согласованно.

Анализ экосистемы показывает, насколько разнообразны варианты использования Kubernetes в Hetzner Cloud. Самым популярным проектом сообщества по этой теме, получившим 5,7 тыс. звезд, является, что несколько неожиданно, руководство «Кластеры Kubernetes для любителей», а такие инструменты, как hetzner-k3s, явно обещают «готовые к использованию в производственной среде» кластеры. От проектов выходного дня до производственных систем — экосистема охватывает все.

Если вы используете одну виртуальную машину с Docker Compose для небольшой статической конфигурации, Kubernetes вам не обязательно нужен. Он становится интересным, когда начинают иметь значение доступность, масштабируемость и автоматизация. И именно тогда возникает вопрос: как правильно настроить Kubernetes в облаке Hetzner?


Kubernetes в облаке Hetzner: запустите его самостоятельно, не создавая все с нуля.
Запуск Kubernetes в Hetzner Cloud — это осознанный выбор: полный контроль над собственным кластером вместо зависимости от управляемого сервиса. То, что на первый взгляд может показаться большим объемом ручной работы, на самом деле поддерживается хорошо развитой экосистемой. В теме GitHub «hetzner-cloud» в настоящее время перечислены 383 публичных репозитория, и почти все самые популярные из них — это инструменты для Kubernetes. Только terraform-hcloud-kube-hetzner (3,9 тыс. звезд) и hetzner-k3s (3,7 тыс. звезд) имеют в сумме более 7500 звезд.

Основой служат собственные официальные интеграции Hetzner с открытым исходным кодом: Cloud Controller Manager, драйвер CSI, провайдер Terraform и CLI hcloud. Они напрямую сопоставляют ресурсы Kubernetes, такие как узлы, сервисы и тома, с ресурсами Hetzner Cloud. Давайте рассмотрим каждый компонент подробнее.
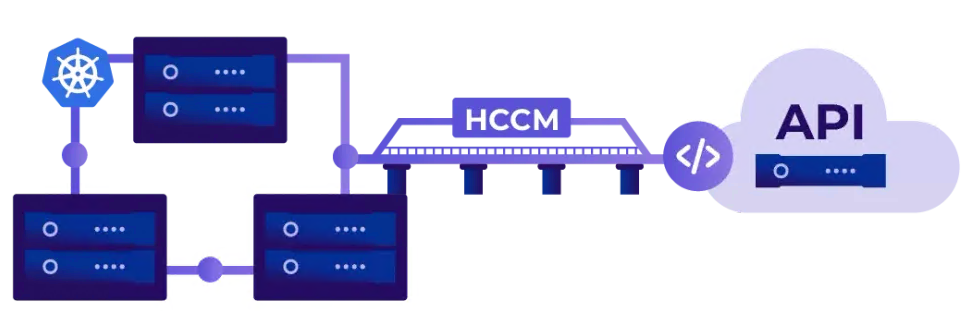


Cloud Controller Manager: мост к API
hcloud -cloud-controller-manager (HCCM) подключает кластер Kubernetes к API Hetzner Cloud и Robot. Он реализует интерфейсы, определенные Kubernetes в пакете k8s.io/cloud-provider — механизм, позволяющий каждому облачному провайдеру интегрировать свою собственную логику в общий набор контроллеров. В HCCM эту работу выполняют четыре контроллера:
  • Контроллер узлов: инициализирует каждый узел Kubernetes и добавляет метаданные, такие как тип экземпляра и идентификатор поставщика. Этот идентификатор соответствует идентификатору сервера в Hetzner Cloud или Robot, с префиксом или – обеспечивая неизменяемую связь между узлом Kubernetes и сервером .hcloud://hrobot://
  • Контроллер жизненного цикла узлов: отслеживает узлы, которые больше не «готовы», проверяет, существует ли связанный с ними сервер или он был выключен, и удаляет объекты узлов, серверы которых больше не существуют.
  • Контроллер маршрутов: Создает маршрут в частной сети для каждого узла, сопоставляя CIDR его пода с его частным IP-адресом. Это позволяет трафику, предназначенному для подов на узле, проходить напрямую через частную сеть, без накладных расходов, связанных с использованием оверлейной сети, такой как VXLAN.
  • Контроллер сервисов: автоматически создает и настраивает балансировщик нагрузки Hetzner Cloud Load Balancer для каждого сервиса Kubernetes соответствующего типа .LoadBalancer.

Последний раунд оптимизаций показывает, насколько активно разрабатывается этот компонент: общий кэш для контроллеров узлов и согласование маршрутов на основе событий вместо периодического согласования сокращают количество запросов к API Hetzner Cloud примерно на 76% при масштабировании и на 94% в стабильном режиме. Изменения в контроллере маршрутов не ограничились HCCM. Они также были напрямую внесены в основной проект Kubernetes в рамках KEP-5237 — пример того, как работа над интеграцией Hetzner приносит пользу основному проекту. Все подробности вы можете найти в нашей статье в блоге «Как мы сократили количество запросов к API в Hetzner Cloud Controller Manager». Все улучшения включены в HCCM версии 1.33 и более поздние версии.


Драйвер CSI: Постоянное хранилище для рабочих нагрузок с сохранением состояния.
Базы данных, очереди сообщений, мониторинг — практически ни один производственный кластер не может обойтись без постоянного хранилища. Официальный csi-драйвер — это драйвер интерфейса контейнерного хранилища для Hetzner Cloud, который поддерживает тома ReadWriteOnce в Kubernetes и других оркестраторах контейнеров.

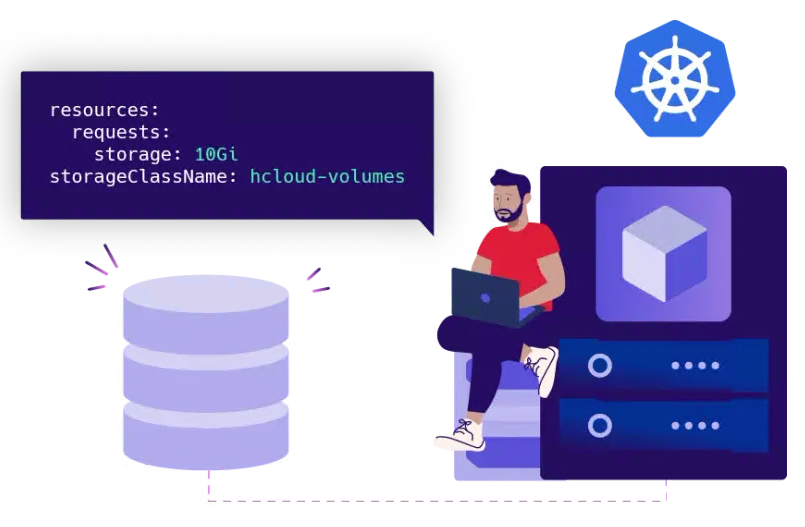
Для пользователей процесс соответствует стандартным рабочим процессам Kubernetes: вы создаете PersistentVolumeClaim, используя StorageClass, и назначаете его поду. Затем Kubernetes автоматически выделяет PersistentVolume через драйвер CSI. Для этого драйвер создает Hetzner Cloud Volume, подключает его к соответствующему узлу и предоставляет хранилище поду .hcloud-volumes
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: csi-pvc
spec:
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 10Gi
  storageClassName: hcloud-volumes


Сетевые технологии и балансировка нагрузки: как происходит обмен трафиком.
Картину дополняют еще два облачных продукта Hetzner:
  • Частные сети позволяют соединять узлы кластера через частную сеть. Способ настройки сети подов внутри кластера зависит от выбранного вами сетевого решения. Один из вариантов — контроллер маршрутов HCCM, который создает маршруты, обеспечивающие доступ к сети подов каждого узла через его частный IP-адрес.
  • Балансировщики нагрузки обеспечивают внешнюю точку входа. Контроллер сервисов HCCM управляет ими автоматически: все, что вам нужно, это экземпляр в вашем кластере, и Kubernetes создаст и настроит соответствующий балансировщик нагрузки Hetzner Cloud. В типичных конфигурациях он принимает трафик из интернета и перенаправляет его по частной сети на контроллер входящего трафика, например, работающий на рабочих узлах .ServiceLoadBalancerTraefik

Экосистема сообщества: четыре способа построения кластера
Вокруг этих официальных компонентов сформировалась удивительно активная общественная экосистема. Следующие проекты заслуживают особого внимания:

terraform-hcloud-kube-hetzner (3,9 тыс. звезд) обещает «оптимизированный и не требующий обслуживания Kubernetes в облаке Hetzner Cloud одной командой». Он объединяет Terraform с k3s, легковесным дистрибутивом Kubernetes.

hetzner-k3s (3,7 тыс. звезд) использует аналогичный подход в качестве автономного интерфейса командной строки. Согласно собственному описанию, он предлагает самый простой и быстрый способ развертывания готовых к использованию кластеров Kubernetes в облаке Hetzner, также с использованием k3s.

В конфигурациях на основе Talos используется другой подход к операционной системе: Talos — это минималистичная ОС с API-интерфейсом, созданная исключительно для Kubernetes. В дополнение к модулю Terraform terraform-hcloud-talos (349 звезд), модуль Kubernetes hcloud-k8s предоставляет подход, используемый в официальном руководстве сообщества для частных кластеров.

cluster-api-provider-hetzner (1,1 тыс. звезд) позволяет декларативно создавать и управлять кластерами Kubernetes в облаке Hetzner и на физических серверах. Проект основан на Kubernetes Cluster API и в первую очередь ориентирован на опытных пользователей, желающих автоматизировать операции с кластерами.

Кроме того, в большинстве этих конфигураций за кулисами работают официальные интеграции Hetzner: провайдер Terraform (728 звезд), hcloud-CLI (1,8 тыс. звезд) — и, конечно же, сами HCCM и драйвер CSI. Обзор других проектов Kubernetes на Hetzner Cloud можно найти в разделе Kubernetes нашего списка awesome-hcloud.

Эталонная архитектура для производственных сред
Как на самом деле выглядит кластер, готовый к использованию в производственной среде? В руководстве сообщества «Частный кластер Kubernetes с использованием Terraform и Talos» представлена ​​архитектура, объединяющая все компоненты:
  • Три узла плоскости управления для обеспечения высокой доступности плоскости управления (etcd, kube-apiserver, kube-scheduler)
  • Рабочие узлы без публичных IP-адресов, распределенные по группам размещения, обеспечивают работу виртуальных машин на различном физическом оборудовании.
  • Частная сеть (например, 10.21.0.0/16) в качестве основы кластера.
  • Исходящая виртуальная машина, выступающая в качестве NAT-шлюза, позволяет частным узлам получать доступ к интернету и обеспечивает SSH-доступ для запуска kubectl и talosctl.
  • Балансировщик нагрузки Hetzner, управляемый Kubernetes, служит точкой входа для ingress-nginx.
  • Longhorn для распределенного постоянного хранения данных и cert-manager для TLS-сертификатов
  • Cluster Autoscaler — это инструмент, который выделяет дополнительные рабочие узлы по мере необходимости.

Для автоматического масштабирования в облаке Hetzner существует официальная интеграция облачного провайдера с Kubernetes Cluster Autoscaler. Она позволяет автоматически выделять дополнительные облачные серверы в качестве рабочих узлов по мере необходимости. Когда они больше не нужны, Autoscaler может их удалить. Это позволяет вашей инфраструктуре адаптироваться к потребностям ваших приложений в ресурсах.

Для еще большей высокой доступности можно распределить рабочие узлы и балансировщики нагрузки по нескольким локациям и добавить резервные виртуальные машины для исходящего трафика. В руководстве пошагово описаны оба варианта.

Какой подход подходит для вашего проекта?
Выбор правильного подхода зависит не столько от размера вашего кластера, сколько от ваших конкретных требований:
  • Быстро разверните работающий кластер: если вы хотите начать работу с минимальными усилиями, hetzner-k3s или terraform-hcloud-kube-hetzner — хороший выбор. Оба позволяют развернуть кластер с официальными интеграциями за короткое время.
  • Инфраструктура как код с максимальным уровнем защиты: конфигурации Terraform на основе Talos особенно хорошо подходят, если вам нужна неизменяемая операционная система, полностью управляемая API, и полностью приватный кластер — как показано в приведенной выше эталонной архитектуре.
  • Полный контроль над каждым компонентом: если вы создаете кластер вручную или с помощью собственных инструментов автоматизации, вы можете установить HCCM и драйвер CSI напрямую и самостоятельно определить все детали — от топологии сети до стратегии хранения данных.
  • Декларативное управление кластерами: Если вы хотите автоматизировать создание, управление и обновление кластеров Kubernetes, поставщик API для кластеров Hetzner предлагает решение, разработанное специально для Kubernetes, как для облачных, так и для физических серверов.

Все четыре подхода основаны на одном принципе: Cloud Controller Manager, драйвер CSI, частные сети и балансировщики нагрузки. Поняв, как эти компоненты взаимодействуют друг с другом, вы сможете принимать обоснованные решения о выборе инструментов и более эффективно устранять неполадки в случае возникновения проблем.

Заключение
Kubernetes в облаке Hetzner сочетает в себе официальные интеграции с открытым исходным кодом и активную экосистему сообщества. HCCM преобразует концепции Kubernetes в облачные ресурсы, драйвер CSI обеспечивает постоянное хранилище, а частные сети и балансировщики нагрузки формируют сетевую основу. Такие проекты, как kube-hetzner, hetzner-k3s и модули Talos, основаны на этих компонентах и ​​позволяют быстро создавать готовые к работе кластеры. Для более подробного изучения вы можете найти исходный код всех этих проектов на GitHub, а также более 350 руководств в сообществе Hetzner — от вашего первого кластера до высокодоступной многолокационной архитектуры.
Важная информация для клиента: требуется обновление прошивки


Мы хотели бы сообщить вам, что твердотельные накопители Micron 5200, установленные в ваших выделенных серверах, могут демонстрировать снижение производительности после длительного использования:

По этой причине для решения этих проблем доступно обновление прошивки от производителя. Поэтому просим вас установить обновление как можно скорее.

Почему необходимо обновление?
Согласно имеющейся информации, скорость чтения и записи SSD-накопителей Micron 5200 может снизиться примерно после 65 000 часов работы. SSD-накопители с меньшим временем работы, как правило, не демонстрируют никаких проблем. Тем не менее, мы рекомендуем выполнить обновление в качестве профилактической меры.

Что вам следует сделать?
Пожалуйста, обновите прошивку до версии D1MU040 через систему восстановления, используя команду «update_crucial_micron». Вы можете использовать программное обеспечение smartctl для проверки установленной прошивки на вашем SSD. Для получения дополнительной информации посетите docs.hetzner.com/robot/dedicated-server/troubleshooting/serial-numbers-and-information-on-defective-hard-drives

Обновление занимает до пяти минут на один диск.
Дополнительно: Мы можем выполнить обновление за вас.
В качестве альтернативы, мы будем рады выполнить обновление в удобное для вас время с понедельника по пятницу с 6:00 до 22:00 (CET).
Если вы хотите, чтобы мы выполнили обновление, пожалуйста, отправьте подтвержденный запрос в службу поддержки через административный интерфейс Robot. Для этого сначала выберите затронутый сервер по адресу robot.hetzner.com/server Затем перейдите на вкладку «Поддержка», выберите категорию «Сервер – Нестабильная работа» в разделе «Техническая поддержка» и предоставьте следующую информацию:

Желаемый период технического обслуживания (время простоя до 60 минут)
Подтверждение того, что вы осведомлены о потенциальном риске потери данных.
Обратите внимание, что мы можем продолжить работу только на основании подтвержденного запроса в службу поддержки. Простого ответа на это письмо недостаточно.

По данным производителя, потеря данных, как правило, не ожидается. Однако мы настоятельно рекомендуем создать полную резервную копию ваших данных перед обновлением прошивки.

Каковы последствия обновления?
После успешной установки, как правило, восстанавливается полная производительность ввода-вывода SSD-накопителей. По заявлению производителя, описанные проблемы с производительностью после этого больше не будут возникать.

Спасибо за вашу поддержку.

С наилучшими пожеланиями,
Hetzner Online

Самостоятельно размещаемая система обмена сообщениями Matrix Messaging с использованием Synapse


Обмен информацией в режиме реального времени — одна из областей, где организации чаще всего в наибольшей степени зависят от внешних поставщиков программного обеспечения как услуги (SaaS). История чатов, вложения файлов, пользовательские каталоги и внутренние беседы могут храниться на инфраструктуре, управляемой Microsoft, Slack, Discord или другой третьей стороной. Для команд, которые хотят больше контролировать место хранения своих коммуникационных данных и работу своей инфраструктуры обмена сообщениями, Matrix предлагает открытую альтернативу.
Synapse — наиболее широко используемая реализация домашнего сервера Matrix. Она предоставляет серверную инфраструктуру для пользователей Matrix, комнат, сообщений, федерации, аутентификации и хранения медиафайлов. Synapse разработан компанией Element и может быть размещен на вашей собственной инфраструктуре. В сочетании с клиентом Matrix, таким как Element, он может предоставить организации полноценную платформу для чата, позволяя при этом общаться с пользователями, размещенными на других серверах Matrix.

Информация о проекте Synapse:
Название: Синапс
URL: element-hq.github.io/synapse/
Лицензия: AGPLv3 или коммерческая лицензия Element.
Протокол: Матрица
Язык программирования: Python/Twisted с компонентами Rust.
Последняя версия: 1.163.0
База данных: рекомендуется PostgreSQL.
Коммерческое предложение: Synapse Pro/Element Server Suite


Домашний сервер для сети Matrix
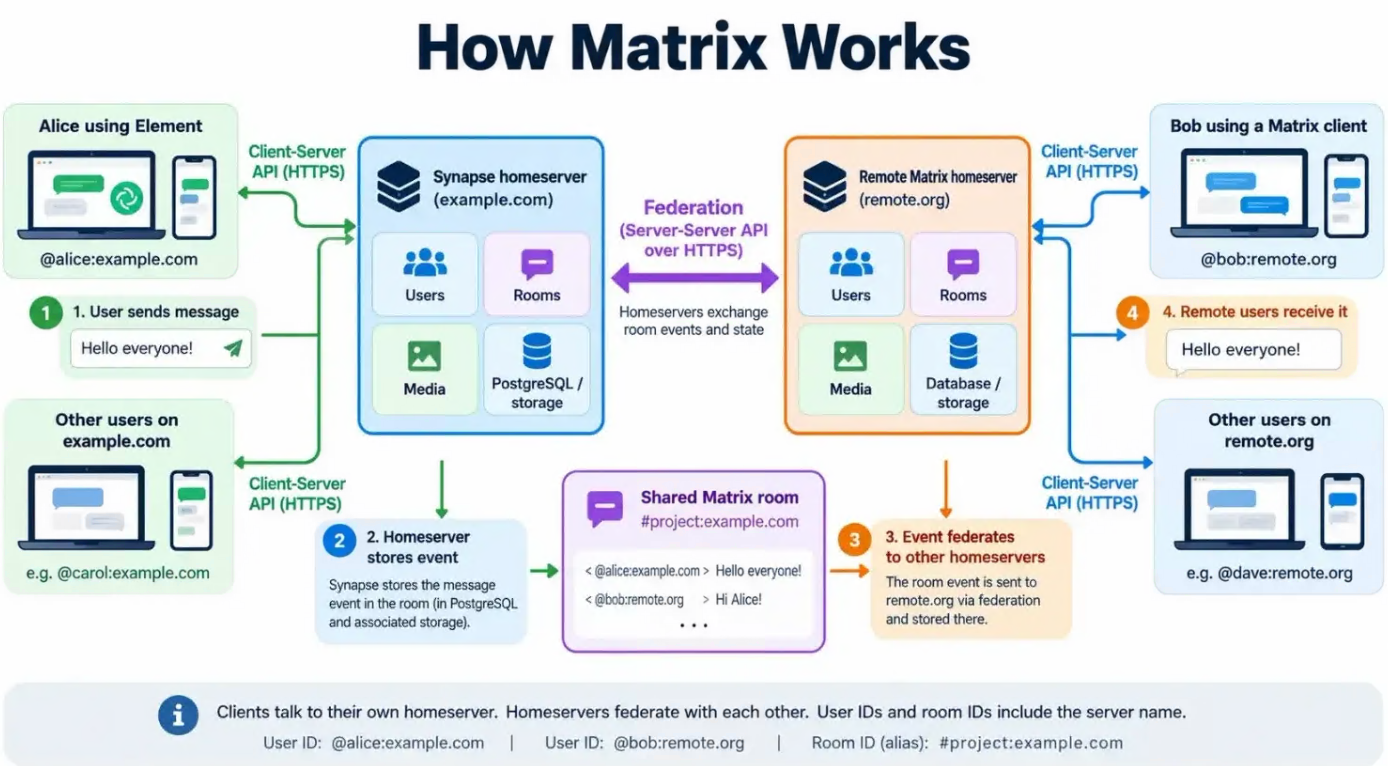
Matrix — это протокол федеративной связи. Вместо того чтобы каждый пользователь принадлежал одному центральному провайдеру, организации могут использовать собственные домашние серверы, продолжая при этом взаимодействовать с пользователями на других серверах.

Synapse реализует эту роль домашнего сервера. Когда пользователь создает учетную запись на сервере Synapse, его идентификатор Matrix ID содержит имя сервера (например, @alice:example.com). Комнаты, пользователи, сообщения, информация о членстве и другие события Matrix затем обрабатываются одним или несколькими домашними серверами, участвующими в беседе.

Для пользователей, самостоятельно размещающих свой сервер, выбор server_name является одним из важнейших решений во время установки. Это значение становится частью идентификаторов пользователей и адресов помещений и не может быть просто изменено позже. Таким образом, компания может использовать example.com в качестве своего идентификатора Matrix, в то время как физически Synapse работает по адресу matrix.example.com.

В Synapse обычно не входит сам интерфейс чата для пользователей. Пользователи подключаются через клиент Matrix, например Element, FluffyChat или другое совместимое приложение. Такое разделение между клиентом и сервером является одним из преимуществ Matrix: пользователи не привязаны к конкретному приложению только потому, что организация выбрала Synapse в качестве своего сервера.

Федерация
Федерация — это то, что отличает Matrix от многих систем чата с самостоятельным размещением. Если федерация включена, пользователи вашего сервера Synapse могут присоединяться к комнатам с пользователями, размещенными на других серверах, а удаленные серверы Matrix могут обмениваться событиями напрямую с вашим сервером.

В концептуальном плане Matrix ближе к электронной почте, чем к традиционной корпоративной платформе для чата. Две организации могут использовать собственную инфраструктуру, не имея учетных записей в одном и том же центральном сервисе.

Однако федерация несколько усложняет настройку сети. Другие серверы Matrix должны знать, как связаться с вашим домашним сервером. По умолчанию это определяется на основе настроенного параметра, но Matrix также поддерживает делегирование через файлы. Это позволяет использовать идентификаторы пользователей, например, в то время как сам Synapse работает под другим именем хоста, например, .server_name.well-known@alice:example.commatrix.example.com

Для частных установок федерацию также можно ограничить или отключить. Компании, которая хочет использовать Matrix только в качестве внутренней коммуникационной платформы, не обязательно предоставлять доступ к своему домашнему серверу более широкой федерации Matrix.

Развертывание и база данных
Synapse можно установить из пакетов, сред Python или контейнеров. Для развертывания в производственной среде на собственном сервере типичная архитектура включает Synapse, PostgreSQL, обратный прокси-сервер, постоянное хранилище медиафайлов и, при необходимости, сервер TURN (Traversal Using Relays around NAT) для надежного голосового и видеосоединения.

Synapse поддерживает SQLite для простых установок, но PostgreSQL следует рассматривать как стандартный выбор для производственных систем. PostgreSQL становится особенно важным по мере роста установки и необходим при масштабировании Synapse с использованием нескольких рабочих процессов.

Обычно перед Synapse устанавливается обратный прокси-сервер, такой как NGINX, Caddy, Apache или HAProxy. Он завершает TLS-соединение и предоставляет доступ к клиенту Matrix и конечным точкам федерации через стандартные порты HTTPS, в то время как сам Synapse прослушивает внутренний порт HTTP.

Для работы с медиаконтентом также требуется планирование. Изображения, видео, голосовые сообщения, документы и другой загруженный контент хранятся отдельно от базы данных PostgreSQL. Поэтому администраторам необходимы резервные копии как базы данных, так и хранилища медиафайлов. Резервного копирования только PostgreSQL недостаточно для полного восстановления.

Аутентификация и управление пользователями
Synapse может управлять собственными пользователями и паролями, но организации часто предпочитают интегрировать его с существующим поставщиком идентификационных данных. В зависимости от среды, Synapse может работать с механизмами аутентификации, такими как OpenID Connect и Security Assertion Markup Language (SAML), позволяя пользователям входить в систему через существующую платформу идентификации.

Настройка регистрации должна быть тщательно продумана. Домашний сервер, доступный из интернета, как правило, не должен разрешать неограниченную регистрацию учетных записей, если это не является преднамеренной частью сервиса. Вместо этого администраторы могут создавать учетные записи самостоятельно, использовать механизмы контролируемой регистрации или полагаться на внешнего поставщика идентификационных данных.

Конфигурация сервера также содержит конфиденциальные данные, такие как секретные ключи регистрации и ключи подписи. К ним следует относиться так же, как и к другим учетным данным инфраструктуры, и включать их в стратегию резервного копирования и управления секретами.


Масштабирование с помощью сотрудников
Для небольших или средних установок Matrix Synapse обычно следует запускать как единый процесс. Официального ограничения по количеству пользователей или событий в секунду не существует, поскольку нагрузка на системы Matrix значительно варьируется: 500 в основном простаивающих пользователей в небольших частных комнатах создают совершенно иную нагрузку, чем 500 пользователей, участвующих в больших объединенных комнатах. Как правило, хорошо сбалансированный единый процесс Synapse с PostgreSQL может без проблем обслуживать несколько сотен активных пользователей, а в системах с примерно 1000 зарегистрированными пользователями может и не быть необходимости вводить дополнительные рабочие процессы, если параллельная обработка и трафик объединения невелики.

Масштабирование рабочих процессов стоит рассмотреть, когда основной процесс Synapse регулярно приближается к 100% одного ядра ЦП, запросы /sync заметно замедляются, очереди федерации начинают отставать или задержка доставки сообщений увеличивается при нормальной пиковой нагрузке. Synapse в основном разделен на специализированные рабочие нагрузки, поэтому первым шагом часто является не создание нескольких идентичных экземпляров, а перенос ресурсоемких функций, таких как синхронизация клиентов, обработка федерации, обработка мультимедиа, фоновые задачи или сохранение событий, на выделенные рабочие процессы. В больших масштабах сохранение событий также может быть распределено по идентификатору комнаты между несколькими рабочими процессами.

Поэтому разумная модель планирования заключается в том, чтобы поддерживать более простую монолитную архитектуру в системах с десятками или несколькими сотнями активных пользователей и отслеживать их состояние перед добавлением сложных компонентов. Как только количество одновременно активных пользователей достигает нескольких сотен, частота запросов исчисляется сотнями в секунду или происходит загрузка ЦП основного процесса, использование рабочих процессов становится все более оправданным. Очень крупные развертывания с тысячами одновременно активных пользователей, как правило, следует проектировать с использованием нескольких рабочих процессов с самого начала. Все рабочие процессы по-прежнему используют общую базу данных PostgreSQL и взаимодействуют через механизмы репликации Synapse, обычно с использованием Redis, поэтому горизонтальное масштабирование Synapse не устраняет необходимость в базе данных соответствующего размера.

Для небольшого выделенного сервера Synapse не требуется особенно мощное оборудование. Домашний сервер для небольшой компании, семьи или сообщества может комфортно начать работу с 2-4 современными ядрами ЦП, 4-8 ГБ оперативной памяти и примерно 100-250 ГБ SSD или NVMe-накопителя, при условии умеренного использования федерации и работы с медиафайлами. Для среднего сервера с несколькими сотнями активных пользователей, большими федеративными комнатами или начальными рабочими процессами лучше подойдет около 6-12 ядер, 32-64 ГБ оперативной памяти и 500 ГБ-1 ТБ NVMe-накопителя. Для крупного сервера с тысячами активных пользователей и несколькими рабочими процессами Synapse разумной отправной точкой являются 16-32 ядра, 64-128 ГБ оперативной памяти и 1-4 ТБ быстрого NVMe-накопителя. Однако в таком масштабе разделение PostgreSQL, рабочих процессов Synapse и хранилища медиафайлов между несколькими системами обычно становится более полезным, чем дальнейшее вертикальное масштабирование одного сервера. Во всех случаях быстрое хранилище на SSD-накопителях важнее больших объемов медленных дисковых накопителей, поскольку производительность PostgreSQL оказывает существенное влияние на быстродействие Synapse.

Безопасность и сквозное шифрование
Matrix поддерживает сквозное шифрование для частных разговоров и комнат. В зашифрованной комнате содержимое сообщений шифруется клиентами до того, как они достигнут Synapse, то есть домашний сервер хранит и пересылает зашифрованные события, а не содержимое сообщений в открытом виде.

Это важное различие при самостоятельном размещении. Использование собственного сервера Synapse дает вам контроль над данными учетной записи, метаданными комнаты, медиафайлами, инфраструктурой и хранением данных, но сквозное шифрование по-прежнему в основном зависит от клиентов Matrix и управления ключами.

Сам домашний сервер по-прежнему имеет критически важное значение с точки зрения безопасности. Администраторам следует обновлять Synapse и PostgreSQL, ограничивать доступ к административным API, защищать механизмы регистрации, использовать HTTPS, создавать резервные копии ключей подписи и избегать прямого доступа к внутренним сервисам через Интернет.

Обзор и перспективы
Synapse — наиболее зрелый вариант для организаций, желающих использовать собственный домашний сервер Matrix. Его главные преимущества — совместимость с экосистемой Matrix, федерация, поддержка сквозного шифрования, развитые функции администрирования и возможность масштабирования от небольшой установки на одном сервере до гораздо более крупных развертываний.

Компромисс заключается в сложности. Серьезная установка включает в себя гораздо больше, чем просто запуск контейнера чата: необходимо учитывать PostgreSQL, DNS, TLS, федерацию, хранилище медиафайлов, резервное копирование, управление идентификацией и, при необходимости, инфраструктуру TURN.

В целом, Synapse отлично подходит для команд, которые хотят контролировать свою коммуникационную инфраструктуру, не создавая при этом еще один изолированный «островок» обмена сообщениями. Для тех, кто самостоятельно управляет вспомогательной инфраструктурой, Matrix и Synapse предлагают привлекательную альтернативу централизованным коммуникационным платформам.

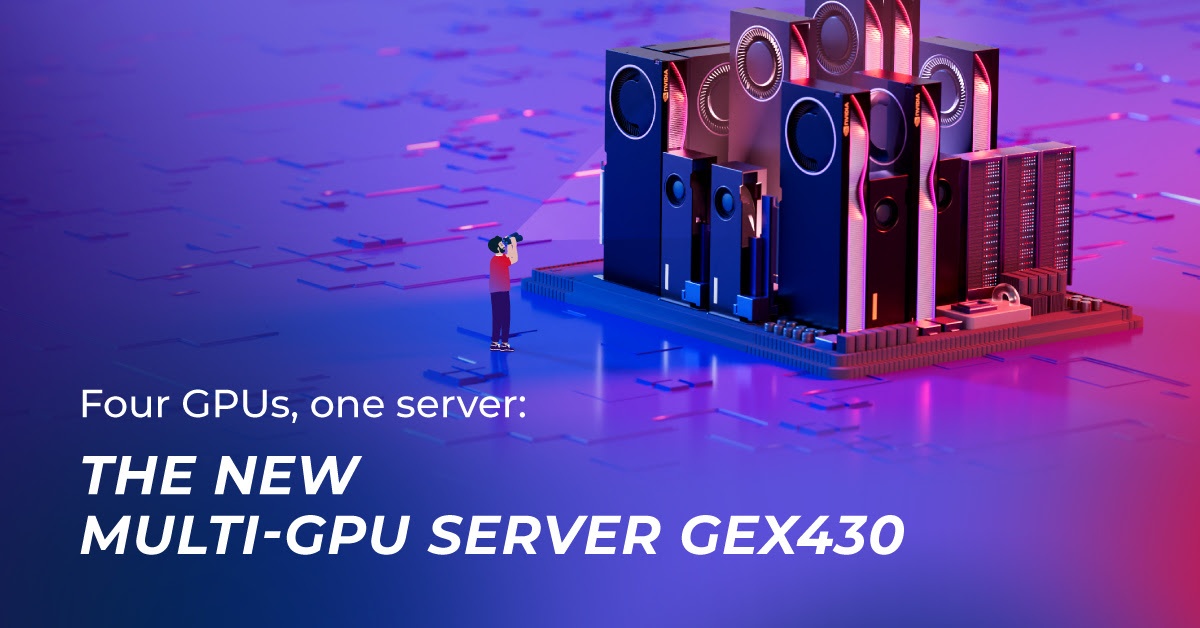
Четыре графических процессора в одном сервере: это новый многопроцессорный сервер Hetzner GEX430


Представляем вашему вниманию ежемесячный обзор интересных новостей и полезных советов от Hetzner! Приятного чтения!

Четыре видеокарты в одном сервере: это новый GEX430
Hetzner представляет GEX430 — свой первый высокопроизводительный сервер с несколькими графическими процессорами. Четыре графических процессора NVIDIA RTX PRO 6000 Blackwell Max-Q с общим объемом 384 ГБ видеопамяти GDDR7 ECC делают его по-настоящему высокопроизводительным сервером для ресурсоемких задач в области искусственного интеллекта. GEX430 обеспечивает мощность, необходимую для профессиональных приложений, таких как обучение ИИ, вывод результатов для больших языковых моделей (LLM), тонкая настройка или ресурсоемкие задачи рендеринга и моделирования.

Благодаря огромному объему графической памяти, он способен запускать большие модели ИИ и обрабатывать множество запросов одновременно. Он идеально подходит для компаний, которые, например, хотят использовать чат-боты с ИИ в службе поддержки клиентов или предоставлять внутренние информационные помощники для большого числа сотрудников.

Четыре высокопроизводительных графических процессора оснащены тензорными ядрами 5-го поколения, ядрами RT 4-го поколения и поддерживают FP4. В GEX430 также установлен процессор Intel Xeon Gold 5412U “Sapphire Rapids” с 24 ядрами и 48 потоками, 128 ГБ регистровой оперативной памяти DDR5 ECC и два быстрых твердотельных накопителя NVMe Datacenter Edition (Gen4) объемом 1,92 ТБ каждый.

Приобретите этот сервер за 3 599,00 евро / 4 199,00 долларов США в месяц, включая IPv4-адрес. Стоимость установки также составляет 3 599,00 евро / 4 199,00 долларов США.
www.hetzner.com/dedicated-rootserver/matrix-gpu/

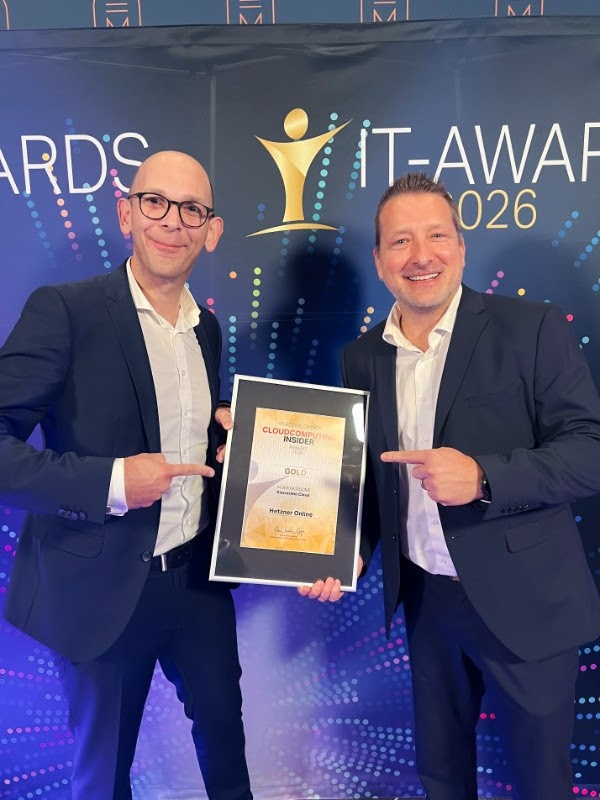
Компания Hetzner получила премию IT Awards 2026 за проект «Суверенное облако»
На церемонии вручения наград IT Awards 2026, организованной Vogel IT-Medien, компания Hetzner впервые получила золотую награду в категории «Суверенное облако». Церемония награждения состоялась 15 октября 2026 года в Аугсбурге, Германия. В этом году читатели различных IT-порталов Vogel IT-Medien отдали в общей сложности 60 000 голосов, выбирая своих предпочтительных IT-провайдеров.


Эта награда подчеркивает, насколько важны для пользователей независимые, безопасные и высокопроизводительные облачные инфраструктуры. Благодаря собственным центрам обработки данных в Нюрнберге, Фалькенштайне и Хельсинки, мы предлагаем европейскую альтернативу для всех, кто ценит защиту данных и цифровой суверенитет.

Мы особенно рады получить эту награду непосредственно от избирателей из ИТ-сообщества. Огромное спасибо всем, кто проголосовал за нас и оказал нам доверие!

Взгляд за кулисы облачной сетевой инфраструктуры Hetzner
Наша сетевая архитектура — результат многолетней разработки и собственных инженерных разработок. Но как на самом деле работает лежащая в её основе технология?

В нашей статье в блоге мы покажем вам ключевые компоненты нашей текущей сетевой инфраструктуры, как она развивалась в прошлом и какое отношение немецкое слово «Flusskrebs» имеет к нашему подходу «сделай сам».

Саммит Хетцнера 2026: Видеообзор
Саммит Hetzner 2026 позади, и мы можем оглянуться назад на этот чрезвычайно успешный день. В нашем видеообзоре мы вернем вас в Фалькенштайн и покажем самые яркие моменты мероприятия. Ощутите особую атмосферу саммита Hetzner 2026: от сессий и экскурсий по дата-центрам до многочисленных личных встреч.

Хотите узнать больше? Ознакомьтесь с нашей статьей в блоге, где вы найдете дополнительную информацию о мероприятии.
www.youtube.com/watch?v=y3d4G1HB9QY

Учебное пособие: Настройка собственного сервера резервного копирования с использованием Minarca и RAID1 на Debian

Хотите самостоятельно управлять резервными копиями и хранить их, не прибегая к внешним облачным сервисам?

В этом руководстве показано, как настроить собственный сервер резервного копирования на Debian, используя программное обеспечение с открытым исходным кодом Minarca и RAID1.

Шаг за шагом вы узнаете, как настроить хранилище, установить Minarca, защитить свой сервер и настроить автоматическое резервное копирование.
community.hetzner.com/tutorials/minarca-backup-server-raid1/

Компания Hetzner представила свой первый многопроцессорный сервер с четырьмя графическими процессорами NVIDIA Blackwell


С моделью GEX430 хостинг-провайдер Hetzner расширяет свой портфель, добавляя свой первый сервер с несколькими графическими процессорами. Новая модель оснащена четырьмя графическими процессорами NVIDIA RTX PRO 6000 Blackwell Max-Q и 384 ГБ графической памяти GDDR7 ECC. Этот высокопроизводительный выделенный сервер специально разработан для предприятий и профессиональных пользователей, которым требуется высокая вычислительная мощность для обучения ИИ, вывода больших языковых моделей (LLM), тонкой настройки, а также для сложных задач рендеринга и моделирования.

Четыре высокопроизводительных графических процессора позволяют запускать особенно ресурсоемкие модели ИИ и работать с несколькими моделями параллельно. Это позволяет компаниям объединять различные приложения ИИ на одном сервере. Например, одна языковая модель может использоваться для поддержки клиентов, другая — для помощи разработчикам в программировании, а третья — для автоматической обработки входящих запросов. Эти задачи могут быть распределены между отдельными графическими процессорами.

Доступная графическая память также играет центральную роль в выполнении задач искусственного интеллекта. Требования к памяти значительно возрастают, особенно при обработке большого объема одновременных запросов. Благодаря общему объему видеопамяти в 384 ГБ, GEX430 предлагает значительные ресурсы для обработки больших языковых моделей и одновременного обслуживания множества пользователей. Это выгодно, например, компаниям, использующим чат-боты с искусственным интеллектом в службе поддержки клиентов или внутренним информационным ассистентам для своих сотрудников.

Особенно когда речь идет о выводе данных в рамках искусственного интеллекта, графическая память так же важна, как и вычислительная мощность. Чем больше запросов обрабатывает модель одновременно, тем больше памяти ей, как правило, требуется. Благодаря четырем графическим процессорам и общему объему видеопамяти в 384 ГБ, GEX430 предлагает достаточный запас для ресурсоемких приложений ИИ. Компании могут использовать его, например, для параллельного запуска нескольких языковых моделей или для предоставления своих услуг ИИ большому количеству одновременно работающих пользователей
говорит Стефан Вайберг, менеджер по продуктам в Hetzner.

Каждая из четырех видеокарт NVIDIA RTX PRO 6000 Blackwell Max-Q оснащена 96 ГБ видеопамяти GDDR7 ECC и поддерживает современные технологии искусственного интеллекта, такие как тензорные ядра пятого поколения, ядра RT четвертого поколения и FP4. Конфигурация видеокарт дополнена процессором Intel Xeon Gold 5412U с 24 ядрами и 48 потоками, 128 ГБ регистрируемой памяти DDR5 ECC и двумя твердотельными накопителями NVMe Datacenter Edition (Gen4) объемом 1,92 ТБ каждый.

Благодаря GEX430 компании могут запускать модели искусственного интеллекта с открытым исходным кодом, такие как GLM, Mistral или Qwen, на выделенном оборудовании в пределах ЕС, не полагаясь на внешние платформы ИИ. При соответствующей настройке конфиденциальная информация, такая как внутренние документы, данные клиентов или исходный код, остается в собственной серверной среде компании. Это создает благоприятные условия для выполнения индивидуальных требований по защите данных и соблюдению нормативных требований. В то же время пользователи сохраняют контроль над используемыми моделями, своими данными и конфигурацией инфраструктуры.

Маршрутизатор Hetzner GEX430 доступен по цене 3 599,00 евро / 4 199,00 долларов США в месяц, включая IPv4-адрес. Единовременная плата за настройку также составляет 3 599,00 евро / 4 199,00 долларов США.

Дополнительную информацию можно найти по адресу www.hetzner.com/dedicated-rootserver/matrix-gpu/

Все цены указаны без НДС.

Важная информация для клиентов: обновление PHP в связи с критическими уязвимостями безопасности CVE-2026-109618 и CVE-2026-109619


Как вы, вероятно, уже слышали из СМИ, в PHP были обнаружены две критические уязвимости. Разработчики PHP выпустили обновления безопасности для устранения этих проблем. Данные обновления призваны предотвратить выполнение злоумышленниками вредоносного кода в затронутых системах при определенных условиях.

Поскольку вы используете выделенный сервер и/или облачный сервер, вы самостоятельно несете ответственность за установку обновлений безопасности. Если вы используете PHP, мы настоятельно рекомендуем как можно скорее установить доступные обновления безопасности на соответствующие системы: www.php.net/archive/2026.php#2026-10-21-5

Кроме того, внимательно следите за своими системами на предмет подозрительной активности и возможных признаков атаки.

Дополнительную информацию и актуальные сведения можно найти на нашем сайте о состоянии сервисов: status.hetzner.com/incident/f4144d55-38c3-48d1-8664-7a3429355cd7

Благодарим вас за сотрудничество.
С уважением,
Hetzner Online

Срочное техническое обслуживание всех основных маршрутизаторов


В настоящее время мы проводим срочное техническое обслуживание всех наших основных маршрутизаторов. Обслуживание проводится поочередно. В ходе этих работ снижается общая избыточность сети. Мы не ожидаем перебоев в работе, но вы можете заметить увеличение задержки.

Это техническое обслуживание обеспечивает долгосрочную безопасность и стабильность нашей инфраструктуры. Благодарим вас за понимание и терпение.

Сетевой стек Hetzner Cloud — история и технический обзор


Эта статья — первая часть серии материалов, посвященных эволюции сетевых стеков, лежащих в основе Hetzner Cloud, и их архитектуры. В этой статье мы рассмотрим проделанную нами разработку и то, как работает текущий сетевой стек на основе Open vSwitch. Хотя сетевой стек для облачных серверов и балансировщиков нагрузки схож, мы сосредоточимся на облачных серверах и хостах виртуализации (хостах виртуальных машин), поскольку они предоставляют больше сервисов и функций.

Для краткости мы исключим из рассмотрения плоскость управления облаком, которая управляет всеми серверами, балансировщиками нагрузки, частными сетями и т.д., и рассмотрим только сетевой стек на хостах.

Как мы работаем
Для работы всех облачных продуктов необходимы универсальные и надежные варианты подключения, чтобы наши клиенты и, возможно, их клиенты могли получать доступ к сервисам, работающим в нашей сети.

В компании Hetzner мы в целом верим в решения, которыми владеем и можем управлять самостоятельно, а также в наличие базовых элементов, на основе которых можно строить дальнейшие проекты. Сеть, и особенно сетевое подключение для наших облачных сервисов, не является исключением.

Хотя технологии за эти годы изменились, мы всегда отдавали предпочтение решениям, где движущиеся части находятся на хостах, а не сложной и замысловатой физической сетевой инфраструктуре. В результате мы разработали систему таким образом, чтобы физическая сеть обеспечивала стабильное IP-соединение с хостами, а хосты предоставляли сетевые функции более высокого уровня. К ним относятся межсетевые экраны, частные сети и вспомогательные инфраструктурные сервисы.

Запуская эти сервисы и сетевые функции на хостах, мы получаем большую свободу и гибкость при проектировании и создании нашего продукта, и не ограничиваемся тем, что предлагают поставщики оборудования. Таким образом, мы обеспечиваем четкое разделение задач между командами и технологиями и можем ограничить зону поражения одним хостом в случае (большинства) ошибок. Это также означает, что мы можем и должны полностью владеть решением и адаптировать его к нашим потребностям, но это и так заложено в нашей ДНК.

Немного истории
Исторически сложилось так, что компания Hetzner использовала различные технологии для обеспечения связи для своих облачных продуктов.

На начальном этапе, в 2011 году, виртуальные серверы Hetzner vServers использовали жесткие диски, нативные мосты Linux и статические маршруты. Они обеспечивали двухстековое подключение со скоростью до 1 Гбит/с на хост. В итоге, с такой конфигурацией работало около 25 000 экземпляров.

Следующая версия продукта была запущена в сентябре 2015 года с гиперконвергентной конфигурацией на базе Ceph. Она перешла на динамическую маршрутизацию через BGP и конфигурацию моста Linux с использованием NAT 1:1 для IPv4 и полностью маршрутизируемых префиксов IPv6. Это обеспечило лучшую мобильность IP-адресов и обслуживание хостов без влияния на клиентов. В 2016 году каналы связи с хостами были модернизированы до 2 x 10 Гбит/с. Эта конфигурация просуществовала до 2018 года и разрослась примерно до 50 000 экземпляров.

Когда Hetzner Cloud был запущен в 2018 году, мы отказались от NAT и перешли на прямую маршрутизацию IPv4. В июле 2019 года мы представили плоскость данных на основе Open vSwitch и добавили поддержку частных облачных сетей на основе инкапсуляции VXLAN. В ноябре 2020 года мы начали миграцию части публичной сети на Open vSwitch, что позволило нам запустить межсетевые экраны с сохранением состояния на основе потоков Open vSwitch, а в марте 2021 года...netfilter

Составные части хоста виртуальной машины
Мы уже выяснили, что важные части сетевого стека работают на виртуальных машинах; но что они должны предоставлять для функционирования облачного сервера?

Для большинства серверов требуется доступ к Интернету, чтобы система и её сервисы были доступны как из дома, так и из-за рубежа. Некоторые серверы используют частные сети (Private Networks), либо вместо общедоступных сетей, либо совместно с ними, которые соединяют серверы, балансировщики нагрузки и, возможно, выделенные серверы через частную виртуальную сеть, доступ к которой имеют только ваши системы. Трафик частной сети инкапсулируется с помощью виртуальной расширяемой локальной сети (VXLAN) и уникального виртуального идентификатора сети (VNI) для каждой частной сети. Сетевой стек хоста гарантирует, что только участники, подключенные к соответствующей частной сети, могут отправлять или получать трафик.

Для управления доступом к вашим сервисам, доступным из Интернета, мы предлагаем функцию облачного брандмауэра. Она позволяет контролировать доступ к определенным портам или протоколам сервера, а также ограничивать трафик, который может покидать сервер. Это должно происходить как можно ближе к серверу, то есть на хосте. Создание централизованных брандмауэров с отслеживанием состояния потребовало бы дополнительного оборудования и сетевых наложений для передачи «чистого» трафика на серверы и значительно усложнило бы задачу обеспечения высокой доступности и централизованного отслеживания соединений.

По умолчанию образы наших облачных серверов настроены на использование протокола динамической конфигурации хостов (DHCP) для динамической настройки IPv4-адресов и маршрутов. Следовательно, нам необходимо предоставить DHCP-сервер, чтобы серверы могли запрашивать конфигурацию IPv4-сети для общедоступных и частных сетевых интерфейсов.

В большинстве образов используется для настройки некоторых частей системы, например, для настройки сети IPv6, запуска DHCP для частных сетевых интерфейсов, подключения облачных томов и т.д. Для выполнения этих задач необходимо запрашивать информацию о локальной системе или конфигурационных параметрах пользователя с нашего сервера метаданных, доступного по адресу. Кроме того, сервер метаданных используется многими интеграциями, включая, помимо прочего, наш драйвер CSI, hc-utils, инструменты дистрибутивов, такие как Flatcar Linux и, или Talos Linux.cloud-initcloud-init 169.254.169.254/cloud-initAfterburnIgnition

Для обеспечения максимальной отказоустойчивости и доступности, DHCP-сервер и сервер метаданных работают локально на каждом хосте виртуальной машины.

Помимо этих сервисов, доступных пользователям, на виртуальных машинах работает множество внутренних служб, которые обеспечивают бесперебойную работу серверов, получение сетевой информацией для настройки подключения, а также отслеживание происходящего нашей системой мониторинга.

Однако в этой статье мы сосредоточимся на сетевом стеке и более подробно рассмотрим его внутреннее устройство.

Открыть vSwitch
Большая часть передачи сетевых данных осуществляется с помощью Open vSwitch, или сокращенно OVS, многоуровневого виртуального коммутатора с открытым исходным кодом. Его протокол передачи данных уже давно включен в ядро ​​Linux, а пакеты для пользовательского пространства/управляющей плоскости доступны для всех основных дистрибутивов Linux.

Это сетевой стек по умолчанию для некоторых сред виртуализации, и многие готовые решения поддерживают OVS. К ним относятся, помимо прочих, Proxmox VE, Open Stack и oVirt. Однако мы не используем ни одну из этих сред, а управляем KVM и всеми сопутствующими компонентами с помощью собственных инструментов.

Open vSwitch — это универсальное сетевое решение, предлагающее множество функций, часть из которых мы используем в наших примерах и для настройки. Оно использует OpenFlow, открытый протокол, созданный для настройки плоскости данных сетевых устройств и определения способа пересылки пакетов. Для каждого направления связи должен существовать поток, определяющий, как должны обрабатываться пакеты и куда их необходимо отправлять.

Это могут быть точные совпадения, например, для связи со шлюзом через ARP, NDP, ICMP и т. д., трафика, предназначенного для других участников частной сети, или подключений к сервису в Интернете.

Открытая оркестрация vSwitch — Flusskrebs
Для обеспечения сетевого подключения наших серверов и балансировщиков нагрузки, а также для настройки любых межсетевых экранов, применяемых к серверу, нам необходимо установить необходимые потоки для Open vSwitch, чтобы обеспечить эти соединения и функции.

Распространенным решением для оркестрации Open vSwitch является проект Open Virtual Network (OVN) control plane, который был запущен одновременно с самим OVS и предназначен для обслуживания парка узлов, работающих под управлением Open vSwitch. Он предоставляет уровень абстракции, где можно настраивать логические маршруты и коммутаторы, которые затем преобразуются в OpenFlow.

Когда Open vSwitch был внедрен в стек Hetzner Cloud, мы решили не идти по этому пути и вместо этого разработали собственное решение под названием Flusskrebs (буквально переводится как «речной краб» или «потоковый краб»). Оно написано на Python, предоставляет REST API, используемый локальной частью нашей плоскости управления облаком, и настраивает потоки, необходимые каждой виртуальной машине или балансировщику нагрузки для корректной работы. Это включает в себя потоки для реализации любых правил брандмауэра, настроенных пользователем или нашим бэкэндом, например, для блокировки исходящего SMTP по умолчанию.

Контроллер также выступает в качестве центрального DHCP-сервера для частных сетевых интерфейсов на каждом хосте.

Сетевой стек хоста виртуальной машины
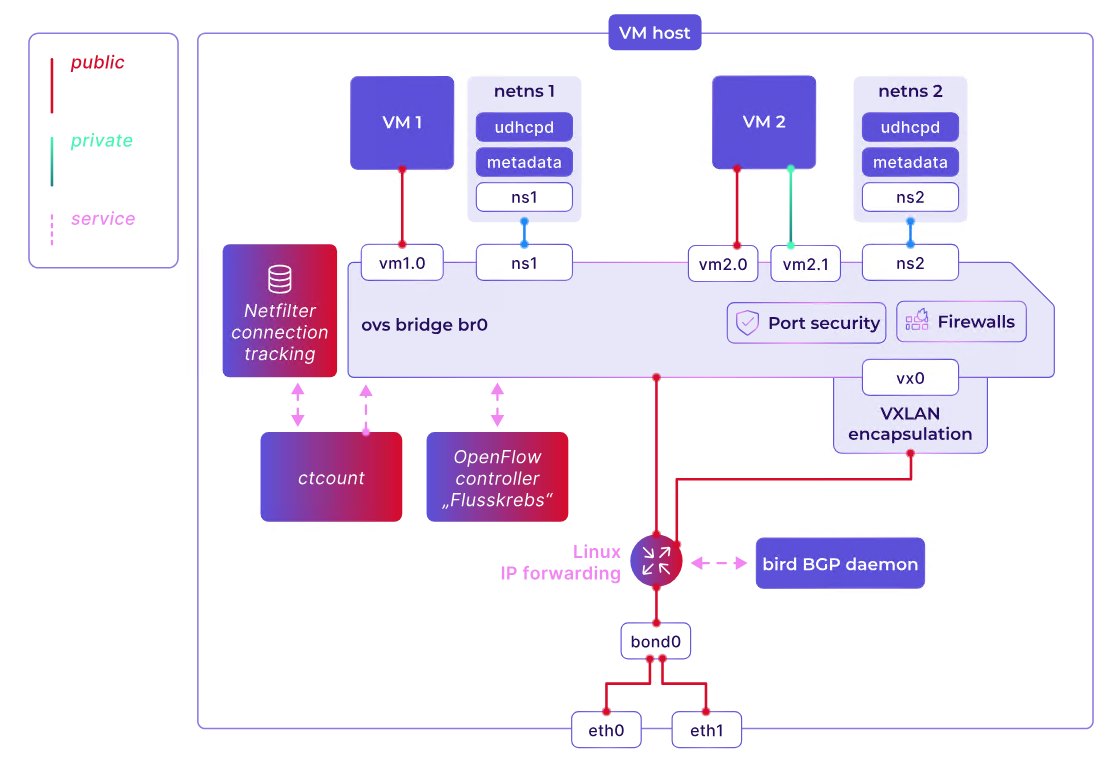
Учитывая общие архитектурные принципы и эти базовые элементы, давайте подробнее рассмотрим сетевой стек нашего хоста виртуальной машины. На следующем рисунке представлен упрощенный обзор внутренней работы сетевого стека хоста виртуальной машины.


Большинство хостов используют два восходящих интерфейса 10 Гбит/с, объединенных в группу агрегации каналов (LAG) или, в Linux, с использованием LACP, подключенных к двум физическим коммутаторам, образующим виртуальное шасси для повышения отказоустойчивости и пропускной способности. Для дальнейшего повышения отказоустойчивости в начале этого года мы начали переход на два маршрутизируемых восходящих канала с использованием BGP, подключенных к двум независимым коммутаторам. Следует отметить, что восходящие интерфейсы не подключены напрямую к мосту OVS, но система Linux осуществляет маршрутизацию между восходящими каналами и OVS. Таким образом, доступность хоста не зависит от OVS, что упрощает установку и обслуживание хоста.bond

Центральный мост Open vSwitch выступает в качестве основного компонента, обеспечивающего сетевое подключение и функции, и все облачные серверы на хосте подключены к нему. Каждый сервер может иметь один публичный сетевой интерфейс, а также до трех частных сетевых интерфейсов. Для отображения потоков, обеспечивающих исходящий трафик с сервера в сеть, используются следующие шаблоны:

# Only process packets with correct source MAC address
table=0, priority=9999, in_port={vm_port_no}, eth_src={mac}, actions=set_field:1->reg0,set_field:{vm_port_no}->reg5,resubmit(,1)
# Only accept packets with an IPv4/IPv6 address associated with the server
table=3, priority=9999, in_port={vm_port_no}, ip_src={ip}, ip, actions=resubmit(,4)
table=3, priority=9999, in_port={vm_port_no}, ipv6_src={ip}/64, ipv6, actions=resubmit(,4)
table=3, priority=9999, in_port={vm_port_no}, arp, arp_op=2, arp_spa={ip}, actions=resubmit(,4)


Входящий трафик к серверу перенаправляется с использованием следующих потоков, по одному для каждого префикса IPv4 или IPv6 соответственно. Сетевой стек хоста идентифицирует себя для виртуальной машины, используя общеизвестный «MAC-адрес виртуального шлюза», который всегда равен .d2:74:7f:6e:37:e3

table=22, priority=9999, in_port={internet_port_no}, ip, ip_dst={ip}, actions=mod_dl_src:d2:74:7f:6e:37:e3,{vm_port_no}
table=22, priority=9999, in_port={internet_port_no}, ipv6, ipv6_dst={ip}/64, actions=mod_dl_src:d2:74:7f:6e:37:e3,{vm_port_no}


Инфраструктурные сервисы, такие как DHCP и серверы метаданных, также подключены к Open vSwitch и работают параллельно с каждым сервером в выделенном пространстве имен Linux для каждого сервера.

Обратите внимание, что DHCP-сервер, показанный на рисунке выше, отвечает только за публичные интерфейсы любого сервера. Как описано выше, контроллер Flusskrebs содержит центральный DHCP-сервер, обрабатывающий все частные сетевые интерфейсы. Процесс подключения к публичному DHCP-серверу также прост:udhcpd

table=1, priority=9999, in_port={vm_port_no}, udp, udp_dst=67, actions={service_port_no}
table=1, priority=9999, in_port={service_port_no}, udp, udp_src=67, actions={vm_port_no}


Наряду с Open vSwitch, для реализации функции межсетевого экрана с сохранением состояния используется отслеживание соединений Linux netfilter. При наличии глобальной общей таблицы отслеживания соединений необходимо предотвратить ее переполнение и обеспечить справедливое использование для всех серверов и клиентов. Это достигается с помощью другого внутреннего проекта, который отслеживает записи отслеживания соединений и устанавливает ограничение в 80 000 активных одновременных соединений на сервер. Если сервер достигает этого лимита, новые соединения не могут быть открыты до тех пор, пока не будет закрыто предыдущее.ctcount

Статус-кво
Эта платформа обработки данных на базе Open vSwitch хорошо нам служила и в основном продолжает служить до сих пор, даже при наличии более миллиона облачных серверов. Однако мы достигли некоторых ограничений и хотели улучшить масштабируемость, отказоустойчивость и гибкость с помощью более специализированного сетевого стека. В течение последних лет наша команда SDN разрабатывала именно такое решение, адаптированное к нашим потребностям, простое в эксплуатации и являющееся прочной основой для новых функций, таких как IPv6 для частных сетей.

В следующей части этой серии мы расскажем о следующих этапах нашего пути, о нашей новейшей полностью самостоятельно разработанной сетевой архитектуре и о том, как она работает. Так что оставайтесь с нами!

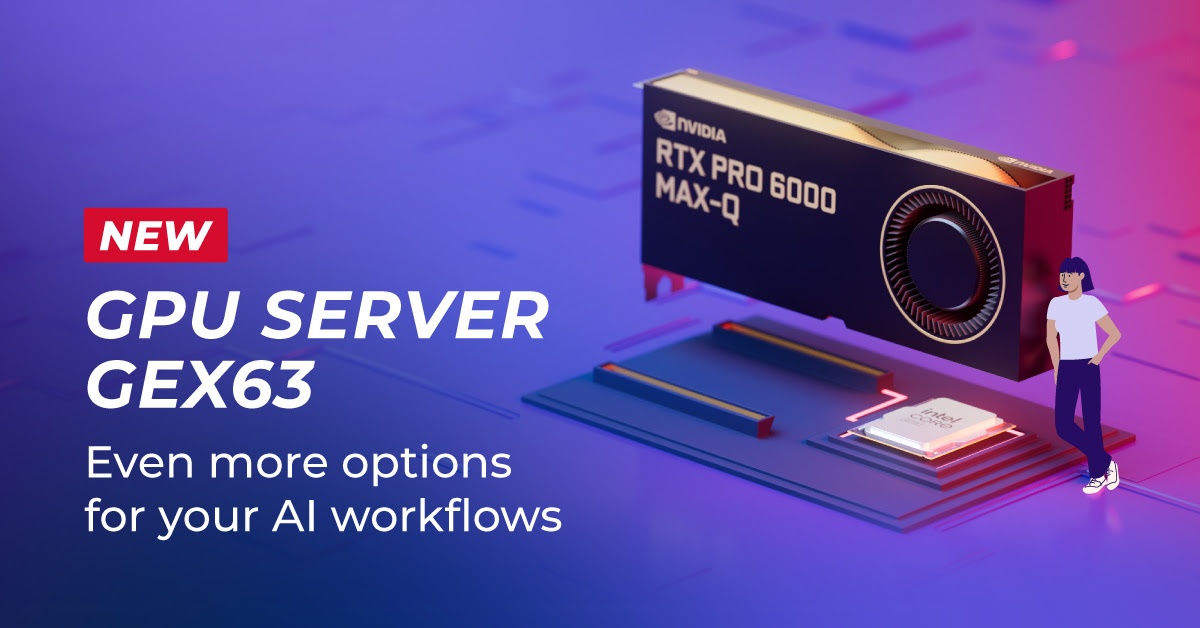
Новый сервер Hetzner GPU GEX63: еще больше возможностей для ваших рабочих процессов в области искусственного интеллекта


Новый сервер GPU GEX63 для профессиональных задач искусственного интеллекта
В новой модели GEX63 компания Hetzner предлагает сервер с графическим процессором NVIDIA RTX PRO 6000 Blackwell Max-Q и 96 ГБ видеопамяти GDDR7 ECC.

Сервер предназначен для профессиональных задач, таких как вывод результатов работы ИИ, тонкая настройка и обучение ИИ, а также подходит для ресурсоемких вычислительных задач в областях рендеринга, моделирования, обработки изображений и речи.

Он оснащен процессором Intel Core Ultra 7 265 «Arrow Lake» с 20 ядрами. Также в комплект входят 128 ГБ оперативной памяти DDR5 UDIMM и два твердотельных накопителя NVMe Datacenter Edition (Gen4) объемом 1,92 ТБ каждый.

Таким образом, GEX63 сочетает в себе высокую производительность графического процессора с оптимизированной для него конфигурацией по привлекательной цене. GEX63 доступен по цене 999,00 евро / 1199,00 долларов США в месяц, включая IPv4-адрес, плюс единовременный сбор за подключение в размере 999,00 евро / 1199,00 долларов США.
www.hetzner.com/dedicated-rootserver/gex63/

НОВЫЙ ОБЛАЧНЫЙ СЕРВЕР. НИЗКАЯ ЦЕНА.
Для расширения ассортимента наших экономичных облачных серверов мы представили сервер CPX02 «Regular Performance» с 1 виртуальным процессором, 1 ГБ оперативной памяти и 20 ГБ хранилища, который теперь доступен в наших европейских центрах обработки данных (FSN1, HEL1 и NBG1), а также в Сингапуре (SIN1).

Этот сервер особенно подходит для приложений с очень низким потреблением ресурсов и минимальными системными требованиями, таких как статические веб-сайты, блоги или простые веб-приложения с одним сервисом.

Облачный сервер CPX02 доступен по цене от 5,99 евро / 7,49 долларов США в месяц.
www.hetzner.com/cloud/regular-performance

НОВАЯ ФУНКЦИЯ ОТПРАВКИ ЭЛЕКТРОННЫХ ПИСЕМ ДЛЯ УПРАВЛЯЕМЫХ ПРОДУКТОВ
В настоящее время мы постепенно обновляем все наши серверы веб-хостинга и управляемые серверы с Debian Bookworm до Debian Trixie. В рамках этого обновления программного обеспечения мы обновляем не только версию Debian, но и другое программное обеспечение, которым мы управляем.

В этом обновлении вам также станет доступна новая функция электронной почты: учетные записи электронной почты будут поддерживать так называемую «дополнительную адресацию» (субадресацию). Это позволит вам использовать субадреса в формате « emailaccount+subaddress@domain.de ». Письма, отправленные на такой субадрес, будут автоматически доставляться в соответствующий почтовый ящик « emailaccount@domain.de ». Например, вы можете использовать отдельные субадреса для рассылок, регистрации или интернет-магазинов, не создавая дополнительных почтовых ящиков.

Важно: если в настоящее время вы используете почтовый ящик для всех писем в подобных сценариях, электронные письма, отправленные на эти подадреса, будут доставляться непосредственно в соответствующий почтовый ящик, а не в почтовый ящик для всех писем. Это произойдет после миграции вашего сервера на Debian Trixie.
docs.hetzner.com/managed/general/softwareupdates/#softwareupdates-2026

HETZNER — ЛУЧШИЙ ПРОВАЙДЕР ВЕБ-ХОСТИНГА ДЛЯ БИЗНЕСА 2026 ГОДА
Восемь провайдеров, четыре недели непрерывного нагрузочного тестирования, более миллиона точек данных: IT-журнал Connect Professional протестировал продукты веб-хостинга известных хостинг-провайдеров на стабильность, веб-сервисы и производительность серверов.

Наш пакет «Webhosting S» занял первое место с оценкой «отлично». Это также самый доступный продукт в тесте: «Хотя цена не играет роли в нашей оценке, всё же примечательно, что самый доступный продукт в сравнении уверенно занял первое место в тесте», — пишет connect professional. Подробный отчет о тестировании на немецком языке можно найти здесь.
www.hetzner.com/webhosting/


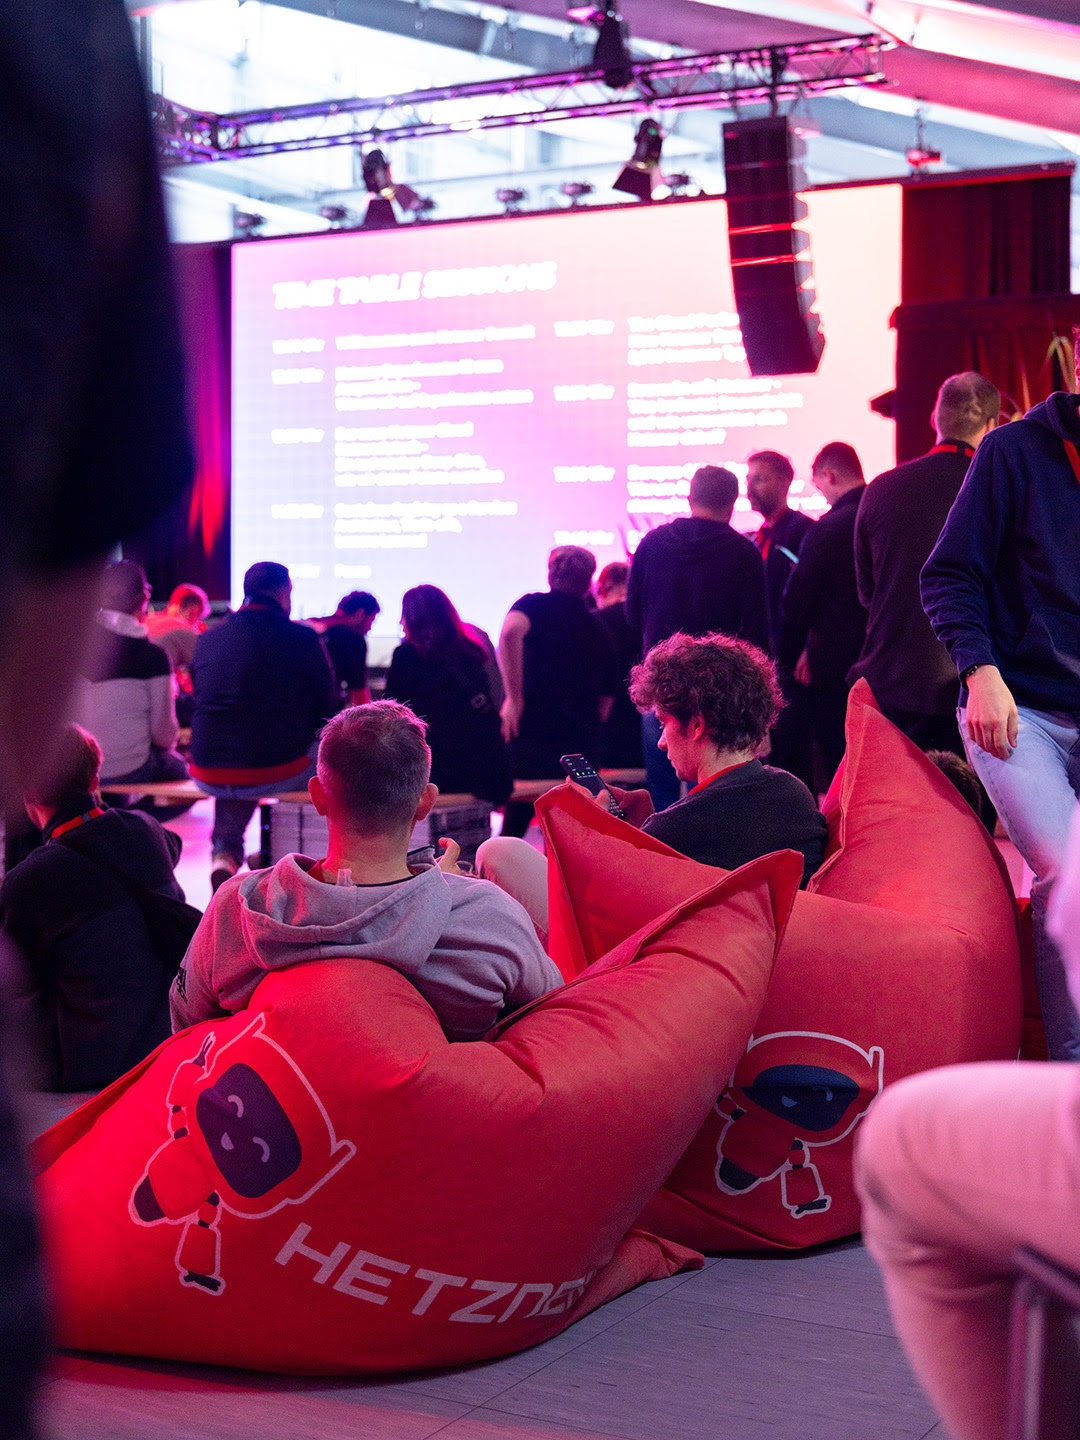
Это был саммит Хетцнера 2026 года.
Технологии, связи и взгляд из-за кулис: 17 сентября 2026 года в нашем крупнейшем центре обработки данных в Фалькенштайне (Германия) состоялся второй саммит Hetzner.

В ходе различных сессий обсуждались актуальные темы из мира Hetzner и технологий. Во время экскурсий по нашим центрам обработки данных и различным экспозициям гости также могли вблизи ознакомиться с нашей инфраструктурой и продукцией.

Этот день был особенно насыщен личными встречами, новыми идеями и множеством интересных разговоров. Большое спасибо всем, кто присутствовал и помог организовать саммит.

Для тех, кто не смог присутствовать лично, мы собрали основные моменты на сайте саммита. Записи презентаций также будут постепенно размещаться там.
www.hetzner.com/hetzner-summit/


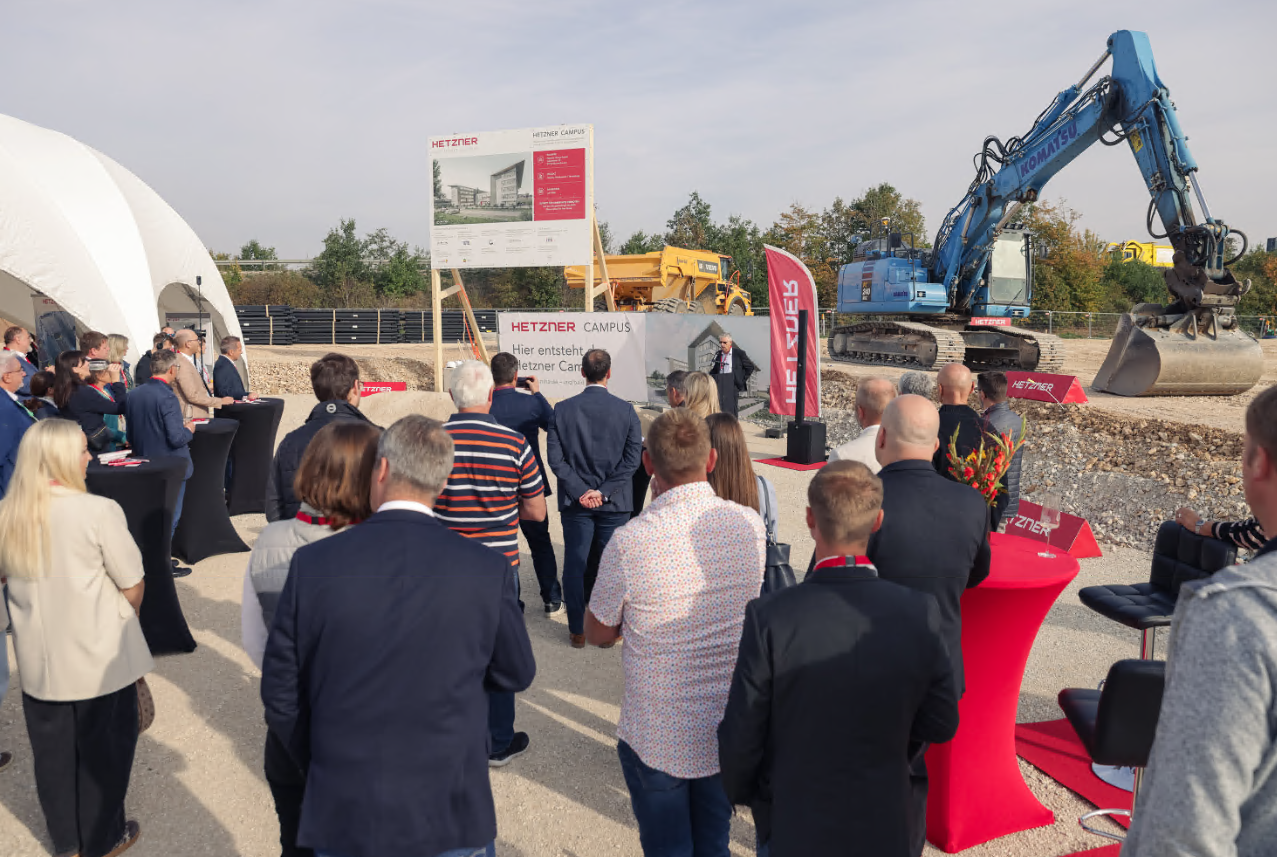
Церемония закладки первого камня нового кампуса Хетцнер.
Для нас это особый момент и важная веха: церемония закладки первого камня нового кампуса Hetzner в Гунценхаузене знаменует начало масштабного проекта.

К началу 2030 года мы построим новую штаб-квартиру, рассчитанную на более чем 500 сотрудников, на территории компании площадью 70 000 квадратных метров.

Таким образом, мы создаём пространство для дальнейшего роста и для множества новых идей, оставаясь при этом тесно связанными с Гунценхаузеном.
www.hetzner.com/pressroom/hetzner-celebrates-groundbreaking-for-new-corporate-headquarters-in-gunzenhausen/

Компания Hetzner отметила начало строительства своей новой корпоративной штаб-квартиры в Гунценхаузене


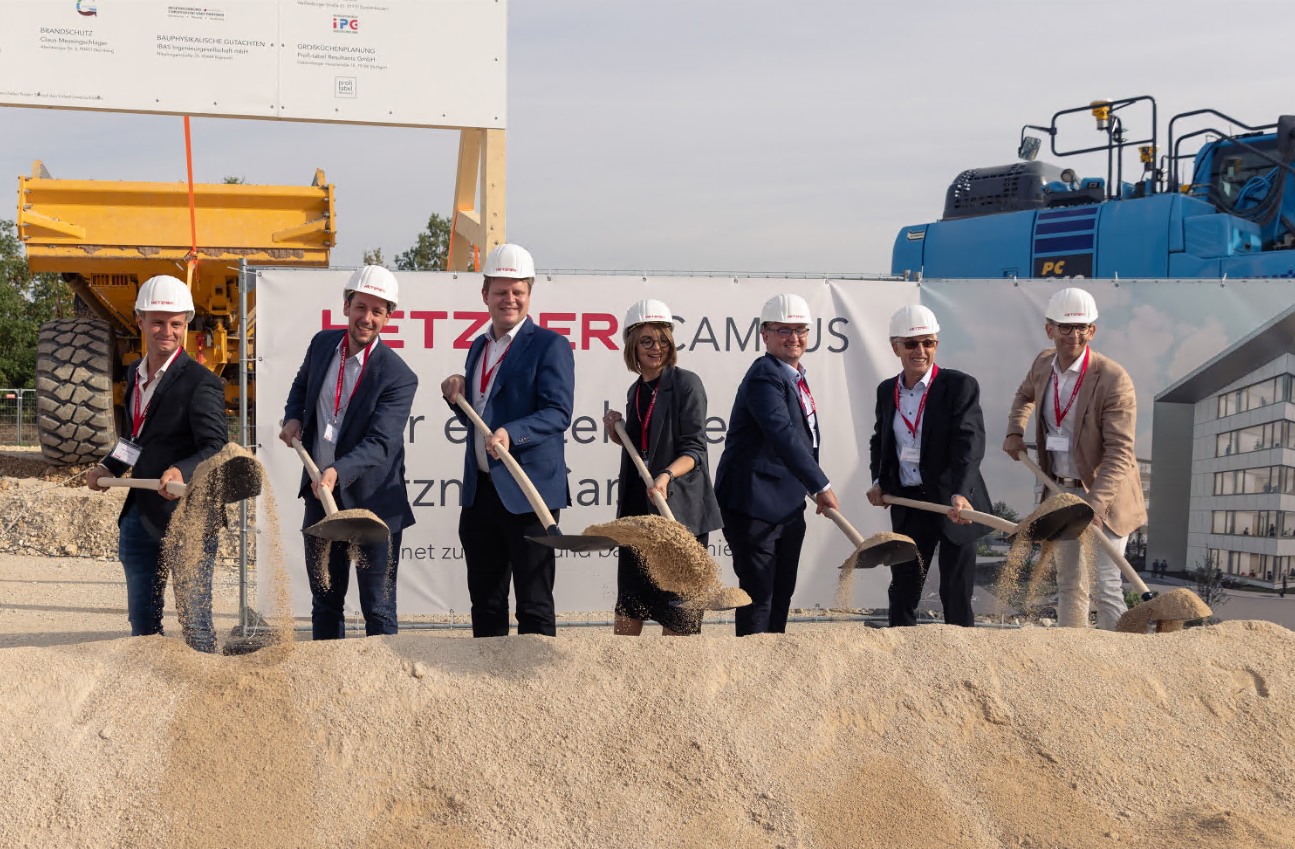
Компания Hetzner Online, поставщик услуг хостинга и облачных решений, основанная в Гунценхаузене в 1997 году, сегодня отметила важную веху в своем дальнейшем развитии: состоялась официальная церемония закладки первого камня, ознаменовавшая начало строительства нового кампуса Hetzner в индустриальном парке Nord в Гунценхаузене, Германия.

Компания Hetzner приветствовала главу районной администрации Маркуса Глезера, мэра Маттиаса Хёрра, представителей городского совета и агентства экономического развития, а также архитекторов, специалистов по планированию и строительные компании, участвующие в проекте, на официальной церемонии закладки первого камня. Гости вместе отметили начало строительного проекта, который компания Hetzner более подробно представила во время мероприятия.

Новый кампус Hetzner будет построен в ближайшие годы на участке земли площадью приблизительно 70 000 квадратных метров. Площадь здания составит 13 500 квадратных метров, и оно рассчитано на размещение более 500 сотрудников.

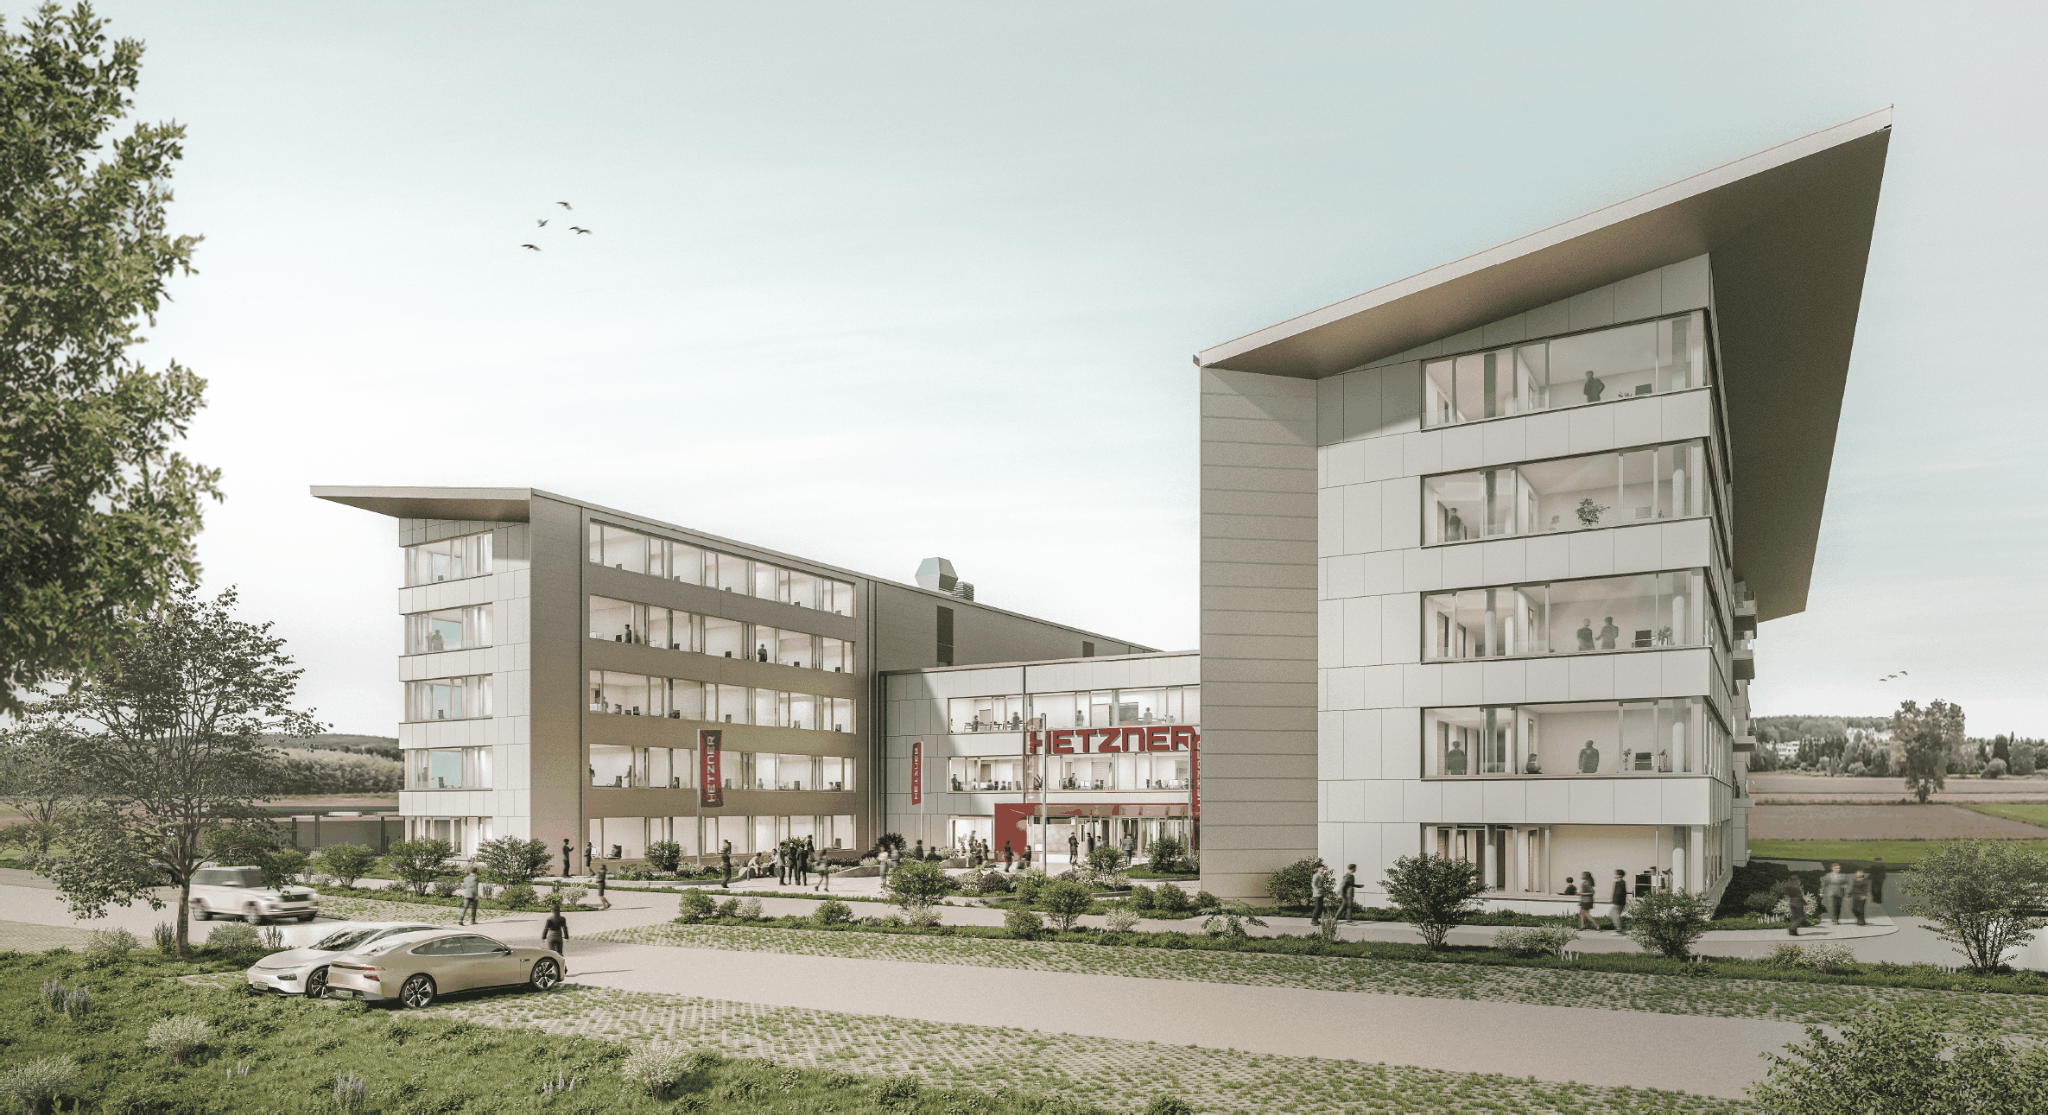
Уникальной особенностью здания является его архитектура: кампус проектируется в форме буквы «H» для компании Hetzner. Первоначально будет полностью застроено одно из крыльев здания. Остальные помещения обеспечат дополнительные мощности для будущего роста компании.

Новый кампус предназначен не только для предоставления дополнительных офисных помещений. Планируется создание многочисленных зон для сотрудничества, взаимодействия и отдыха. К ним относятся несколько центральных мест для встреч в виде так называемых «рынков» с кофейными барами или мини-кухнями и неформальными переговорными зонами, ресторан, терраса на крыше и фитнес-центр. Кроме того, предусмотрено место для присмотра за детьми во время каникул, демонстрационный зал техники Hetzner, игровая комната, учебный зал и кабинет физиотерапии. Четыре гостиничных номера будут доступны сотрудникам из других офисов Hetzner во время их пребывания в Гунценхаузене.

Создавая этот кампус, компания Hetzner формирует дополнительные пространства для дальнейшего роста и современных рабочих мест. В то же время компания подчеркивает свою долгосрочную приверженность Гунценхаузену как деловому центру.

«Создавая новый кампус, мы закладываем основу для дальнейшего роста в ближайшие годы. В то же время, эти инвестиции являются явным подтверждением приверженности Гунценхаузену и нашему долгосрочному развитию в этом регионе», — поясняет Гюнтер Мюллер, генеральный директор Hetzner Online.

Строительные работы на новом кампусе уже начались. «Завершение строительных работ планируется к февралю 2027 года. Непосредственно после этого начнутся работы по возведению несущих конструкций. Открытие нового кампуса Hetzner запланировано на начало 2030 года», — добавляет представитель компании Кристиан Фитц.


Кампус Hetzner — Так будет выглядеть новая штаб-квартира компании (Фото: Wenzel Architekten+Ingenieure)

Изображение на заголовке: Штеффен Грилленбергер (Grillenberger Tief- und Straßenbau GmbH), мэр Матиас Хёрр, окружной администратор Маркус Глезер, Хелен Венцель-Йорг (Wenzel Architects+Engineers), Кристиан Солер Альварадо (Hetzner), Гюнтер Мюллер (Hetzner) и Стефан Конвичкова (Hetzner) провели символическую церемонию закладки фундамента нового предприятия. штаб (слева направо).