Скидки в Черную пятницу + Большое пополнение запасов VPS Nano! + Розыгрыши призов!


Промокод BFAVA
  • Дает скидку 20% на любой тарифный план до 1 декабря 2026 года.
  • Промокод не подлежит повторному использованию!

Это работает на общем хостинге, VPS и выделенных серверах. Скидка применяется к вашему первому платежу.

Мы также добавили и пополнили запасы 1024 Nano VPS! Да, это правда!
Это небольшой сервер для бота, тестового проекта или микросервиса.
Характеристики:
  • 1 vCPU
  • 512 МБ ОЗУ
  • 20 ГБ NVMe
  • 100 Мбит/
  • с Доступно на 2 или 3 года
  • 11 евро/год / ~12,07 долларов США в год (скидка BFAVA не распространяется на Nano)

Выберите тариф со скидкой 20%
ava.hosting

Закажите Nano VPS — БОЛЬШОЕ ПОПОЛНЕНИЕ ЗАПАСОВ!!! В наличии 1024!
ava.hosting/vps/vps-nano/

Прямая ссылка на VPS Nano:
my.ava.hosting/store/vps/vps-nano
Цена: 11 евро в год / ~12,07 долларов США в год

Внимание: Мы не можем гарантировать наличие еще одной крупной партии товара такого типа, а также не можем гарантировать скорое пополнение запасов VPS Nano. Обратите внимание, что это крупная партия товара, и мы прилагаем значительные усилия для ее пополнения. Порт 25 заблокирован в качестве превентивной меры безопасности. Пожалуйста, ознакомьтесь с нашими правилами и Политикой допустимого использования (AUP).

Тарифные планы хостинга, VPS и выделенных серверов:
Веб-хостинг Shared (cPanel) от 1,99€ в месяц:
ava.hosting/shared/

Тарифные планы VPS
ava.hosting/vps/

Выделенные серверы:
ava.hosting/dedicated-servers/

Промокод BFAVA
  • дает скидку 20% на любой тарифный план до 1 декабря 2026 года.
  • Промокод не подлежит повторному использованию!

Счастливой Чёрной пятницы!

С уважением,
Ava.hosting

Хостинг под ударом: уроки осени 2026


Кибератаки на хостинг-провайдеров, уязвимости систем виртуализации, повреждение данных и масштабные сбои облачных сервисов. За несколько недель российский ИТ-рынок столкнулся с целой серией серьёзных инцидентов. Что произошло, какие угрозы оказались наиболее опасными и какие выводы из этого стоит сделать бизнесу?

Осень 2026 года оказалась непростой для российского рынка хостинга и облачных услуг. В октябре масштабная кибератака затронула провайдеров, использовавших платформу управления виртуализацией VMmanager 6. В начале ноября злоумышленники атаковали инфраструктуру Beget, спустя несколько дней серьёзный инцидент произошёл в облаке ESTT. А 17 ноября пользователи Timeweb Cloud столкнулись с массовой недоступностью сервисов, причиной которой стала уже не кибератака, а техническая проблема при обновлении инфраструктуры.

Эти события различаются по причинам, масштабу и последствиям. Однако вместе они показывают, насколько сложной и взаимозависимой стала современная облачная инфраструктура. Сегодня доступность клиентских сервисов определяется не только исправностью серверов, систем хранения и каналов связи. Не менее важны безопасность управляющих платформ, устойчивость сетевой архитектуры и способность всей системы продолжать работу при отказе отдельных компонентов.

Даже профессионально построенная инфраструктура не застрахована от серьёзных инцидентов. Поэтому всё большее значение приобретает не только защита от возможных угроз, но и готовность к авариям, способность сохранить данные и максимально быстро восстановить работу сервисов.

Октябрь: атака через систему управления виртуализацией
В середине октября серия кибератак затронула инфраструктуру хостинг-провайдеров, использовавших VMmanager 6. Эта платформа предназначена для управления виртуализацией и позволяет операторам создавать виртуальные машины, распределять вычислительные ресурсы, управлять хранилищами и выполнять другие административные операции.

Согласно опубликованному расследованию разработчика платформы, компании ISPsystem, первые признаки подозрительной активности относятся к 12 октября, а наиболее интенсивная волна атак пришлась на 17 октября.

Расследование выявило несколько уязвимостей, в том числе связанных с обработкой HTTP-запросов. Их эксплуатация позволяла злоумышленникам обходить предусмотренные ограничения доступа и получать возможности, недоступные обычным пользователям системы.

Особенно показательной стала история FirstVDS. Компания опубликовала подробный технический разбор инцидента, в котором описала действия атакующих после получения доступа к инфраструктуре виртуализации.

Злоумышленники использовали возможности управляющей системы для взаимодействия с гипервизорами и виртуальными дисками клиентов. При этом потенциально опасные действия могли выполняться за пределами гостевой операционной системы. Сама виртуальная машина могла продолжать работать, а её владелец не обязательно замечал происходящее.

Под угрозой оказывались не только файлы, но и учётные данные, SSH-ключи, токены доступа и конфигурации приложений. Такие сведения особенно ценны для злоумышленников, поскольку могут использоваться для последующего проникновения в другие системы.

Атака продемонстрировала, насколько серьёзными могут быть последствия компрометации платформы управления виртуализацией. Если при взломе отдельного сервера масштаб ущерба обычно ограничен доступными злоумышленнику ресурсами, то получение контроля над управляющей инфраструктурой потенциально ставит под угрозу множество клиентских систем одновременно.

ISPsystem выпустила исправления обнаруженных уязвимостей. Однако устранение технической проблемы не завершает расследование подобного инцидента. Необходимо также проверить, какие действия успели выполнить атакующие, не сохранили ли они доступ к системам и какие данные могли оказаться скомпрометированы.

Ноябрь: кибератаки на Beget и ESTT
В ночь на 2 ноября серьёзной кибератаке подвергся Beget. По официальному сообщению компании, злоумышленники получили доступ к управляющему контуру инфраструктуры и запустили скрипты, предназначенные для уничтожения данных.

Последствия затронули сразу несколько направлений работы провайдера. Возникли проблемы с виртуальным хостингом, отдельными серверными услугами, DNS и другими компонентами сервисной инфраструктуры.

Beget приступил к поэтапному восстановлению, используя сохранившиеся резервные копии и доступные инфраструктурные ресурсы. При этом некоторые серверы оказались повреждены значительно сильнее других, что потребовало отдельных сценариев восстановления.

Компания регулярно публиковала информацию о ходе работ. Одни сервисы удавалось вернуть к работе относительно быстро, восстановление других требовало дополнительных проверок, переноса данных и восстановления взаимосвязанных компонентов инфраструктуры.

8 ноября ESTT столкнулась с серьёзной кибератакой. В результате была нарушена работа кластеров виртуализации и платформы управления облачной инфраструктурой SmartCore, что привело к недоступности части клиентских виртуальных серверов и функций управления ими.

Инженеры ESTT поэтапно возвращали к работе виртуальные машины, восстанавливали их исходные конфигурации, сетевую доступность и работу управляющих компонентов облачной платформы. 13 ноября компания сообщила о завершении восстановления и возвращении облачных сервисов к штатной работе.

При этом выделенные физические серверы клиентов, размещённые в отдельном изолированном контуре, продолжали работать в штатном режиме.

15 ноября Beget столкнулся с новой масштабной атакой, на этот раз направленной на сетевую доступность инфраструктуры. Компания сообщила об интенсивном DDoS-трафике, создавшем дополнительную нагрузку в период восстановления после предыдущего инцидента.

В отличие от проникновения в управляющие системы, DDoS-атака направлена прежде всего на нарушение доступности сервисов за счёт перегрузки каналов связи или ресурсов, обрабатывающих сетевые запросы. По сообщению Beget, новая атака не повлияла на работу уже восстановленных сервисов, однако потребовала дополнительных мер по защите инфраструктуры.

Timeweb Cloud: серьёзный сбой без кибератаки
17 ноября масштабный инцидент произошёл в инфраструктуре Timeweb Cloud. Часть облачных сервисов оказалась недоступна примерно на два часа. По опубликованной компанией хронологии, ограничения продолжались с 13:18 до 15:05 по московскому времени.

При обновлении гипервизоров произошёл сбой в работе сетевой инфраструктуры, в результате которого часть виртуальных серверов потеряла сетевую доступность.

В данном случае речь шла не о кибератаке. Сбой возник в процессе эксплуатации инфраструктуры и проведения технических работ.

Timeweb Cloud опубликовала подробное объяснение произошедшего и сообщила о планируемых изменениях в процедурах обновления. В частности, компания намерена расширить проверки состояния сетевых компонентов, увеличить интервалы между этапами обновления и усовершенствовать механизмы восстановления сетевой связности.

Что изменилось в понимании надёжности
В течение многих лет надёжность дата-центров было принято оценивать прежде всего через инженерную инфраструктуру. Резервирование электропитания, независимые каналы связи, системы охлаждения, физическая безопасность и соответствие определённому уровню Tier стали привычными критериями выбора площадки.

Все эти параметры по-прежнему имеют большое значение. Однако они характеризуют прежде всего устойчивость инженерной среды, в которой работает оборудование.

События осени 2026 года показали, что этого недостаточно для оценки надёжности всей ИТ-инфраструктуры. Даже при исправной работе инженерных систем серьёзный инцидент может произойти на уровне виртуализации, управления облаком, хранения данных или сетевых сервисов.

Причём последствия не всегда ограничиваются одним компонентом. Атака на управляющую платформу способна затронуть множество виртуальных машин и существенно осложнить их восстановление. А проблемы с сетевой связностью могут сделать недоступными даже те серверы, которые продолжают исправно работать.

Поэтому надёжность всё чаще приходится оценивать с точки зрения устойчивости всей архитектуры. Важно не только то, насколько защищены отдельные системы, но и насколько они независимы друг от друга, какие последствия вызовет отказ критичного компонента и какие возможности предусмотрены для восстановления.

Для операторов дата-центров и облачных платформ это означает необходимость развивать не только средства защиты, но и механизмы изоляции, резервирования и восстановления.

Для бизнеса меняются критерии оценки собственной ИТ-инфраструктуры. На первый план выходит вопрос о том, сможет ли компания сохранить данные и продолжить работу, если основной сервис или площадка окажутся недоступны.

Какие выводы стоит сделать бизнесу
Главный практический вывод заключается в необходимости заранее предусмотреть резервные сценарии для критически важных систем. Их сложность зависит от задач компании, допустимого времени простоя и последствий возможной потери данных.

Особое внимание стоит уделить резервному копированию. Критически важные данные не должны зависеть от одной площадки или одного контура управления. Как минимум одну резервную копию, защищённую от изменения или удаления, целесообразно хранить независимо от основной инфраструктуры, чтобы она оставалась доступной даже при серьёзном повреждении облачной платформы.

При этом важно не только регулярно создавать резервные копии, но и проверять возможность восстановления из них. Такая проверка должна включать развёртывание данных в отдельной среде, контроль их целостности и запуск необходимых приложений. Именно практическое восстановление позволяет понять, сколько времени потребуется для возвращения сервиса к работе и какие проблемы могут возникнуть в процессе.

Для сервисов, простой которых напрямую влияет на работу компании, стоит предусмотреть запасной вариант размещения. Это не обязательно полноценная дублирующая инфраструктура с постоянно работающими серверами. В зависимости от задач и бюджета можно использовать резервные виртуальные машины или заранее подготовленные ресурсы на другой площадке, позволяющие при необходимости восстановить сайт, базу данных или корпоративное приложение.

Однако наличие второй площадки само по себе ещё не гарантирует быстрого возвращения к работе. Необходимо заранее предусмотреть доступность актуальных данных, настройки сетевых соединений и порядок переключения. Иначе время, выигранное за счёт резервных ресурсов, может быть потеряно на ручной настройке и восстановлении зависимостей.

Отдельного внимания заслуживает распределение ответственности между компанией и провайдером. В зависимости от выбранной услуги резервное копирование может входить в обязанности оператора или полностью оставаться на стороне клиента. Поэтому важно заранее понимать, какие компоненты инфраструктуры резервируются, кто отвечает за сохранность прикладных данных и какие действия потребуются от собственной ИТ-команды для восстановления сервисов.

Универсальной схемы резервирования не существует. Её выбор зависит от критичности сервисов, допустимого времени простоя и возможных последствий для бизнеса. Для одних задач достаточно резервных копий и возможности развернуть систему на другой VPS, для других необходима заранее подготовленная резервная инфраструктура.

Главный урок этих событий заключается в том, что к возможным авариям необходимо готовиться заранее. Независимые резервные копии, проверенные сценарии восстановления и запасные варианты размещения помогают сохранить критически важные данные и существенно сократить последствия серьёзных инцидентов. Именно от готовности инфраструктуры к восстановлению во многом зависит, насколько быстро бизнес сможет вернуться к нормальной работе.
Мы хотели бы сообщить вам о проведении экстренного технического обслуживания сетевой инфраструктуры


В рамках нашей постоянной работы по повышению качества предоставляемых услуг, мы хотели бы сообщить вам о проведении экстренного технического обслуживания сетевой инфраструктуры. В целях безопасности мы обновим версию программного обеспечения на одном из основных устройств.

КОГДА ЭТОГО МОЖНО ОЖИДАТЬ?
Часовой пояс: CET (UTC+01:00)
18 ноября 2026 г. 21:00 — 19 ноября 2026 г. 02:00
Продолжительность: 5 часов

КАК ЭТО ПОВЛИЯЕТ НА ВАШИ УСЛУГИ?
Эти экстренные работы по техническому обслуживанию запланированы для устранения уязвимостей высокого риска в маршрутизаторах пиринга в глобальной магистральной сети. Помимо пиринга, это может затронуть клиентов, чей трафик проходит между нашими офисами в Гонконге и Сингапуре, а также между нашими офисами в Сингапуре и ЕС (Амстердам, Франкфурт, Лондон). Для защиты нас и наших клиентов мы вынуждены запланировать эти экстренные работы по техническому обслуживанию.

В ходе этих аварийных работ по техническому обслуживанию мы будем вносить изменения в схему управления трафиком, чтобы перенаправить его на другой маршрут, что может привести к временным изменениям задержки, поскольку трафик будет двигаться по другому пути. Таким образом, кратковременная потеря пакетов не будет длиться на протяжении всего периода аварийного обслуживания, а только во время перенаправления трафика на другой маршрут и обратно.

Наши специалисты будут доступны во время и после проведения технического обслуживания, чтобы оперативно помочь вам в решении любых возникших проблем.

Проведение этих технических работ может повлиять на работу сервисов в Гонконге, Сингапуре и странах ЕС (Амстердам, Франкфурт, Лондон).

Будьте уверены, мы сделаем все возможное, чтобы свести время простоя к минимуму. Наши специалисты будут доступны во время и после технического обслуживания, чтобы оперативно помочь вам с любыми возникшими проблемами.

Плановое техническое обслуживание: магистральные маршрутизаторы в Амстердаме и Франкфурте


Что мы будем делать
Мы обновим прошивку нескольких магистральных маршрутизаторов в Амстердаме и Франкфурте, чтобы обеспечить стабильность, безопасность и готовность нашей инфраструктуры к будущим вызовам.

Влияние
Мы не ожидаем каких-либо перебоев в работе сервиса. Поскольку наша магистральная сеть полностью резервирована, все системы останутся доступными. Однако во время технического обслуживания вы можете заметить неболькое увеличение задержки.
Если вы заметите что-либо необычное, пожалуйста, свяжитесь с нашей службой поддержки по адресу support@worldstream.com

Чёрная пятница OVH 2026: выделенные серверы со скидкой до 20% у ABCD.HOST


У OVH стартовала Black Friday, и мы уже добавили все акционные конфигурации к себе.

Что внутри:
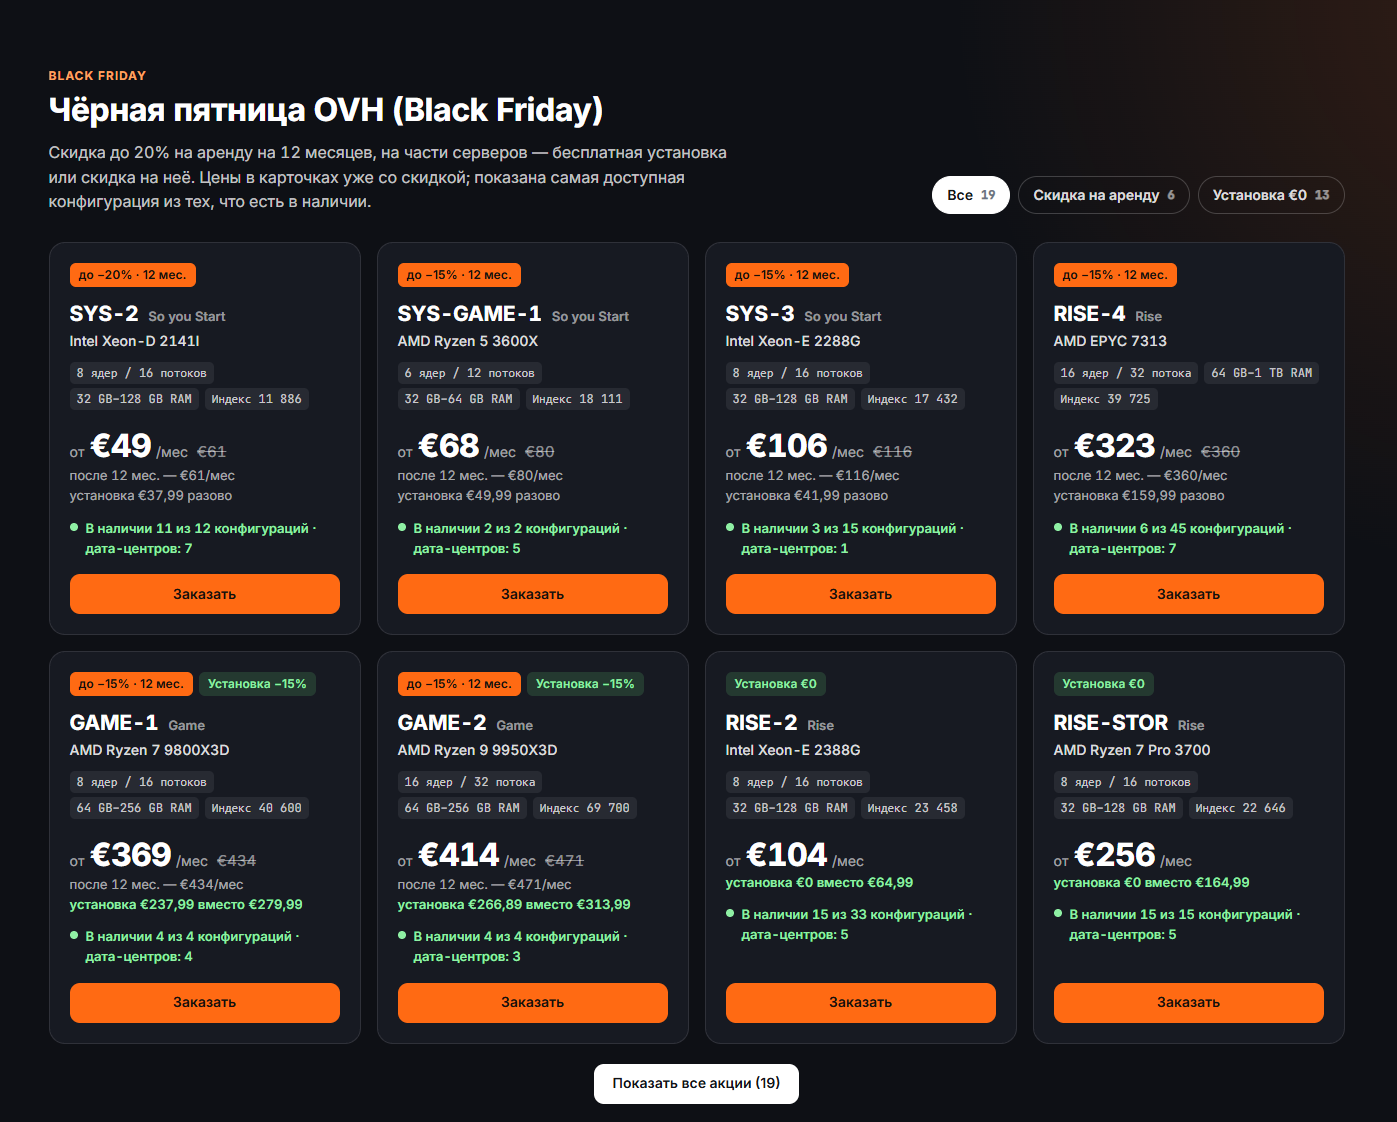
  • скидка до −20% на аренду на 12 месяцев (SYS-2 от €49/мес);
  • −15% на SYS-GAME-1, SYS-3, RISE-4, GAME-1 и GAME-2 (на GAME ещё и установка −15%);
  • бесплатная установка на RISE-2, RISE-STOR, Advance-5 и всю линейку Scale.

Цены на сайте уже со скидкой и обновляются автоматически, наличие видно сразу по дата-центрам. Если нужная конфигурация закончилась, её можно скопировать в один клик и встать в очередь: как только сервер появится, мы его активируем. А если он не появится за 3 дня, деньги вернутся на баланс.

Акция действует до 1 декабря.

Выбрать и заказать: abcd.host/ovh-dedicated-servers

Чтобы ускорить активацию, заранее пополняйте баланс в личном кабинете.

Спасибо, что остаётесь с нами!
ABCD.HOST

Возможный инцидент в сфере безопасности 14 ноября 2026 года


Статус: Расследование продолжается.
Следующее обновление: ежедневно в 14:00 по центральноевропейскому времени.

Обновление — 17.11.2026, 13:45 CET
Расследование, проводимое сторонней компанией по цифровой криминалистике, продвигается — мы предоставим дополнительные подробности, как и обещали.
Несанкционированный доступ произошел в период с 13 ноября 2026 г., 15:29 CET, по 14 ноября 2026 г., 11:28 CET. В это время часть нашей внутренней инфраструктуры была доступна неавторизованной третьей стороне.
Доступ был прерван; работа Contabo продолжается в обычном режиме.
На данный момент нет никаких признаков утечки персональных данных.
Наши предыдущие рекомендации по мерам предосторожности остаются в силе.

Первая публикация — 16.11.2026, 21:00 по центральноевропейскому времени.
Краткое содержание
Мы обнаружили несанкционированный доступ к нашим системам и в настоящее время расследуем его масштабы и последствия. Работа Contabo продолжается в обычном режиме, но мы рекомендуем вам принять меры предосторожности, как указано ниже.

В субботу, 14 ноября 2026 года, мы обнаружили несанкционированный доступ. Доступ был остановлен, мы немедленно приступили к мерам по локализации инцидента, заменили затронутые учетные данные и начали расследование с привлечением внешних специалистов по реагированию на инциденты.

После выявления инцидента компания Contabo предприняла следующие шаги:
  • Сбросьте все пароли VNC и заблокируйте известные пути доступа.
  • Повернутые внутренние учетные данные доступа
  • Внедрены дополнительные меры целенаправленного мониторинга с применением дополнительных методов криминалистической экспертизы.
На данный момент у нас нет никаких признаков утечки персональных данных.

В качестве меры предосторожности мы предлагаем следующие общие рекомендации:
  • Проводить расследование и мониторинг подозрительной активности.
  • Проверьте учетные данные и права доступа.
  • Всегда меняйте пароли по умолчанию.
  • Включите многофакторную аутентификацию
  • Будьте бдительны в отношении фишинга: не переходите по ссылкам в неожиданных сообщениях.
Просим вашего понимания, поскольку в настоящее время мы, возможно, не сможем ответить на индивидуальные запросы, касающиеся этого инцидента. Для обеспечения последовательной, надежной и своевременной связи мы ежедневно, в 14:00 по центральноевропейскому времени, публикуем все подтвержденные новые данные и соответствующие события на этой странице, посвященной инциденту.

OVH представляет Olala mini 7A1B


OVH — первая семейная LLM. Первый представитель этой семьи, Olala mini 7A1B, — компактная модель, построенная на новой архитектуре.

Olala: инновационная модель с гибридным вниманием
Olala mini основана на архитектуре с 7 миллиардами параметров (7B), из которых 1 миллиард активируется в каждом слое и распределяется между 256 экспертами, с гибридным вниманием на основе Differential-TPA и Mamba-3, в формате BF16. При каждом запросе задействуется лишь часть модели, что делает её быстрее и менее требовательной к памяти. Прямое следствие: модель работает на GPU с объёмом памяти не менее 8 ГБ, достигает 160 токенов в секунду на RTX A4500 и даже без GPU, на обычном процессоре, — 50 токенов в секунду. На сегодняшний день её контекстное окно составляет 32 000 токенов. Olala mini будет доступна с открытым исходным кодом на Hugging Face под лицензией Apache 2.0.

Обучена при поддержке европейских государственных структур и уже работает в Qwant
Olala mini была обучена на трёх европейских суперкомпьютерах общего пользования — Jupiter, MeluXina и Jean Zay, оснащённых GPU GH200, A100 и H100. Эта поддержка, эквивалентная 7 млн евро в расчётных часах, сыграла решающую роль, и OVH выражает благодарность государственным органам. Государственная инициатива оказалась успешной во многих отношениях: она позволила сформировать выдающуюся команду в области искусственного интеллекта и привела к созданию агентного подразделения OVH — OVHai LLM. Olala mini публикуется вместе с весами, базовой предобученной моделью, техническим отчётом и документацией о соответствии AI Act. Qwant уже внедрила её в функцию мгновенных ответов, добившись значительных улучшений: ответы стали на 20 % быстрее, а эксплуатационные расходы сократились втрое по сравнению с ранее использовавшейся моделью.

На пути к v1.1, а затем и v2.0
Ожидаемая к концу года версия 1.1 увеличит контекстное окно до 128 000 токенов и улучшит способности модели к математическим рассуждениям. С выходом версии 2.0 OVHai LLM намерена разработать специализированные модели для трёх направлений. Во-первых, агентные решения для бизнеса: в перспективе Olala будет обеспечивать работу OVHai Workspace, для зашифрованной версии которого потребуются модели, способные работать локально, непосредственно на рабочем компьютере. Во-вторых, облачный DevOps — с вариантами, адаптированными для разработчиков, архитекторов и команд эксплуатации, обеспечивающих непрерывность работы сервисов 24 часа в сутки. В-третьих, кибербезопасность — как в оборонительном, так и в наступательном аспектах. Olala v2.0 будет насчитывать более 100 миллиардов параметров.

Статус восстановления на 17 ноября


Мы продолжаем восстанавливать управление доменами и сообщаем, что открыли возможность подачи заявок на продление доменов в зонах .RU,.РФ и .SU.

Автоматическое продление временно недоступно, поэтому для продления доменов необходимо самостоятельно подать заявку.

Как это сделать:
  • Перейдите в раздел «Домены и поддомены cp.beget.com/domains панели управления.
  • Нажмите кнопку «Продлить домен» напротив нужного домена.

Мы обработаем поступившие заявки и продлим указанные в них домены. Если домен вам больше не нужен, никаких действий не требуется.

Средства за продления доменов по заявкам будут списаны позже: после завершения работ по восстановлению биллинга.

///

Коротко: Завершаются работы по восстановлению виртуального хостинга. Восстанавливаем облачную инфраструктуру — в облаке снова доступно создание VPS в Санкт-Петербурге, настройка сети и S3-хранилище. В панели управления хостингом заработали разделы «Управление услугами» и «Сервисы».

1. Виртуальный хостинг
Фокус на восстановлении работоспособности проектов клиентов.
Обращений по-прежнему много, но мы закрываем больше обращений, чем получаем новых. Мы обязательно отреагируем на вопросы, на это нужно время. Создать новый аккаунт виртуального хостинга пока нельзя. Если вашему сайту не хватает места или ресурсов, вы можете изменить квоту в рамках тарифа или сменить тариф. cp.beget.com/services

2. Панель управления
Восстановлены разделы «Управление услугами» cp.beget.com/services и «Сервисы» cp.beget.com/cloudservices (Redis, Memcached, Sphinx, Tarantool и другие).

3. Облако

Что сейчас в приоритете
Ответить на обращения пользователей и устранить оставшиеся проблемы.

Планы на ближайшее время
  • завершить работы по восстановлению виртуального хостинга;
  • запустить площадки для создания VPS в Москве и Казахстане;
  • восстановить полноценную работу с доменами;
  • запустить облачные базы данных;
  • запустить раздел Терминал в панели управления.

Спасибо за вашу поддержку и терпение.