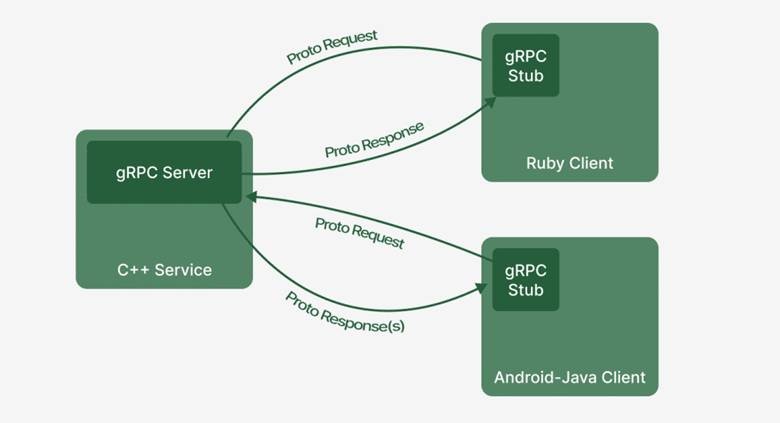
Отреверсили проприетарный gRPC и выложили в опенсорс 100% совместимый аналог их сервера, потом CLI


А вы тоже организуете общение между микросервисами по HTTP/1.1 + JSON? Так вот, адекватные люди на хайлоаде давно так не делают.

Как это выглядит в классическом REST: какой-нибудь сервис заказов стучится в сервис оплаты и отдаёт JSON-файлик: {«user_id»: 123, «amount»: 1000}. Принимающий сервис этот текст читает, парсит, валидирует, переводит в машинный код…

JSON сделан для людей. Человеку удобно читать JSON, потому что это текст. Но серверу для обработки текста приходится тратить драгоценные такты процессора на поиск и разбиение. Ещё классический HTTP тащит за собой гигантские заголовки с метаданными. Часто они весят больше, чем сама полезная нагрузка. Ещё если вы передаете число 123456789, в JSON оно займёт 9 байт (по байту на символ), а в бинарном виде — всего 4 байта.

Гугл ещё в 90-х это посчитал. Они со своими масштабами столкнулись с проблемами за 10 лет до того, как с ними столкнулся весь остальной мир. Для DNS-а в Гугле сделали внутреннюю систему Borg-NS. Они пытались сделать предка gRPC, чтобы решить две фундаментальные проблемы. Во-первых, зоопарк технологий. Когда у тебя тысячи микросервисов — одни на Java, другие на C++, третьи на Python, четвёртые на Go (ладно, этих тогда точно не было) — им нужен единый язык общения. Нужно было запилить стандарт: описали спецификацию интерфейса в одном независимом стиле — и система сама сгенерировала готовый сетевой код для всех нужных языков.

А во-вторых — это как раз производительность обмена.

Поэтому сейчас используется gRPC. И вот когда началась какая-то там по счёту волна санкций, внезапно выяснилось, что в России нет поддержки серверов gRPC.

Не было, пока не появился наш клиент EasyP. Передаю слово Эдгару Сипки — Founder EasyP & Sipki Tech. Он расскажет, зачем и как это сделали.

Зачем это обычным людям?
99% наших пользователей — это бэкендеры, которые строят микросервисы. Бэкенд общается с бэкендом. Да, связывать бэкенд с фронтом, например, с мобилой, тоже можно, это не проблема, но это просто не стандарт рынка. В России, да и вообще во всём мире, я знаю буквально только одну компанию — Uber, кто реально сидел с gRPC на мобилках.

Первый запрос — стандартизация. Объёмы, как у Гугла, есть не у всех, а вот зоопарк — точно у всех. Можно использовать OpenAPI, а можно gRPC. Big Tech (американские Google, Amazon, Microsoft или наши Ozon, WB и Сбер) ещё и экономят на железе. В рамках их гигантских архитектур работают тысячи микросервисов, и в секунду происходят сотни тысяч таких внутренних вызовов.

Чтобы стал понятен масштаб: представьте, что вы открываете приложение, чтобы заказать такси или купить кроссовки. Вы нажимаете всего одну кнопку «Заказать», но под капотом этот единственный клик порождает каскад из 50−100 микросервисных вызовов. Сервис авторизации проверяет токен, сервис геопозиции ищет водителя, биллинг проверяет карту, сервис рекомендаций обновляет вашу ленту, антифрод анализирует паттерн поведения, а пуш-сервис готовит уведомление. И все они общаются между собой. Если на каждом таком шаге сервер будет тратить миллисекунды на открытие новых соединений и парсинг текстовых JSON-ов со скобочками, то на 10 тысяч пользовательских запросов в секунду вы немного охренеете. Гонять тяжёлые текстовые данные со всеми массивными HTTP-заголовками и постоянно их парсить обходится для серверов дорого.

gRPC работает поверх HTTP/2 и использует бинарную сериализацию: данные передаются не как текст, а как архив. HTTP/2 умеет мультиплексировать запросы, он не открывает новое соединение для каждого чиха, а гоняет сотни параллельных запросов по одной уже открытой «трубе». Во-вторых, данные пакуются в бинарный формат. Сервер-отправитель не пишет ключи типа «user_id», он отправляет только числовые теги и сами значения. Сервер-получатель не занимается парсингом текста, он просто считывает смещения в памяти процессора. Это работает куда быстрее.

В итоге это раза в 2−3 дешевле по пропускной способности сети и нагрузке на процессоры. То есть gRPC реально очень сильно экономит деньги на железе (мы говорим про миллионы долларов на закупку и обслуживание серверов), но этот эффект в полной мере ощущается только при огромных объёмах.

Ну и де-факто этот протокол сильно защищённее, там есть ещё ряд бонусов.

Но есть нюанс: с этим протоколом исторически было очень неудобно работать
Когда вы пишете обычный REST-сервер, вам надо как-то объяснить команде одного микросервиса, как работать с микросервисом другой команды. Нужна документация. Если вы когда-нибудь работали с OpenAPI (или Swagger) для REST, то Protobuf (язык описания интерфейсов для gRPC) — это альтернатива OpenAPI, которая просто родилась фактически за 10−15 лет до него.

Protobuf — это строгий контракт. В нём чётко написано: поле номер один — это ID юзера, тип — целое число (int32 user_id = 1;), поле номер два — сумма платежа.

Но в самом ванильном Protobuf нет встроенного линтера! Каждый разработчик мог описать сервисы так, как он захотел. В итоге рождалась классическая катастрофа распределённых систем: разработчики одного микросервиса поменяли контракт и никому об этом не сказали.

Представьте вполне реальную ситуацию на проде: команда сервиса оплаты решает изменить тип поля или удалить поле user_id и молча выкатывает обновление. Или, например, джун в сервисе корзины решает, что сумму заказа лучше передавать не в виде строки «100.50», а в виде целого числа (в копейках — 10050), и меняет это в своём коде. А сервис заказов всё ещё шлёт старый формат. Сервис оплаты получает неожиданный тип данных, не может его прочитать, выкидывает ошибку, и всё падает в рантайме. Платежи не проходят, бизнес теряет миллионы рублей в минуту, а дежурные инженеры в панике ищут, где именно сломалась цепочка из десятков микросервисов.

Чтобы как-то впихнуть эту стихийную разработку в рамки и защититься от таких ошибок, в мире появилось четыре конкурирующих инструмента: один от Uber, один от индусов, один от канадцев и один ещё от кого-то. В итоге в какой-то момент канадский стартап сказал всем остальным троим: «А давайте мы вас всех купим? Давайте вы все станете мной?»

И все стали ими, переложили наработки в единый продукт Buf Build, получили 93 миллиона долларов инвестиций и заняли нишу.

А потом наступает 2023 год
Архитектура российского ИТ-рынка начинает сильно меняться.

У меня это выглядело так: мне надо через пару дней выступать в Сколково на конференции HighLoad с темой работы с gRPC. Доклад о том, насколько этот протокол важен и ценен для бизнеса. Все мои примеры архитектуры и пайплайнов в докладе были построены на Buf Build. Доклад приняли. А потом Buf Build выпускает заявление:

— До свидания. Мы в России блокируем доступ к своим сервисам!

Куратор моего доклада был сотрудником Yadro — это наш гигант, производящий серверное оборудование и железо для ЦОДов. Он был там кластер-лидом, и у него как раз стояла острая рабочая задача в рамках компании: решить проблему того, что инфраструктура Buf перестала собираться в России. Он говорит мне: «Эдгар, а ты сможешь сделать так, чтобы Buf Build заработал в России?»

Ну, потому что невозможно же делать доклад о продукте, который не работает, кому это надо? Я говорю: «Ну, окей, я подумаю».

Я сел и ровно за один месяц просто зареверс-инжинирил их серверную инфраструктуру. Она у них проприетарная, не open source. Я буквально стучался по их API и по крупицам формировал понимание (это было ещё даже до появления мощных нейросетей), как именно это говно у них устроено и почему оно так работает.

Разобравшись в логике, я с нуля создал эмулятор их сервера. В итоге их собственная CLI и кусок клиентской части продукта завелись с моим сервером так, как будто он для них родной.

Всё заработало.

Мы повозились, отладили процессы, показали это решение прямо на конференции, все кайфанули. А потом мы сели и такие: «А зачем нам делать поддержку инструмента, который нас забанил?» Мы по факту сделали костыль. Зачем нам поддерживать чужую экосистему? Давайте сделаем прям свою полноценную замену?

Первыми, кто взял мой сервер, были как раз Yadro и Positive Technologies. В каком-то общем чате инфраструктурщиков ребята написали: «Так и так, кто-то же должен был столкнуться с блокировкой Buf, как решаете?» Им кинули запись моего доклада. Они взяли оттуда продукт, стали активно юзать у себя на больших объёмах, и в итоге столкнулись там с очень специфическими багами.

Чувак, который отвечал за развёртку этой инфраструктуры в Позитиве, искал создателя, то есть меня. Через кого-то ему передали контакт, он мне написал, я ему ответил. А потом я случайно смотрю в Телеграме в общую группу нашего ЖК в Петербурге, и мы такие: «А ты что тут делаешь?» Оказалось, живём буквально в соседних парадных! В тот же вечер мы собрались с кальяном, поштормили и начали делать с ним прям аналог — нашу собственную CLI-ку.

Полноценный dev-tool для разрабов, чтобы им было просто и безопасно работать с Protobuf'ом. Наш продукт — EasyP.

Мы сделали то, зачем крупные энтерпрайзы изначально шли к Buf'у — железобетонную стандартизацию. Используя наш продукт, микросервисная команда получает проверяемый манифест API с понятной документацией, быстрый протокол gRPC под капотом и строгий линтер поверх всего этого.

Как это работает на практике?
Во-первых, наш инструмент — это строгий контролёр. Он заставляет тебя писать контракты по единым правилам компании, чтобы код никуда не вылез за рамки стайлгайдов.

Во-вторых — это пакетный менеджер. Раньше, чтобы сервис уведомлений на Python узнал о новых ручках сервиса заказов на Go, разрабам приходилось руками копировать .proto-файлы или городить костыли с Git-сабмодулями. Мы же сделали элегантный механизм: ты просто указываешь нужную версию контракта, EasyP сам скачивает зависимости из реджистри и фиксирует их в easyp.lock. Дальше ты пишешь easyp generate, и мы внутри изолированных Docker-контейнеров (или через Wasm) сами компилируем нужный код. Больше никакой боли с фразами «а у меня локально всё собиралось» — у всех разработчиков всё генерируется абсолютно идентично.

Но самое главное: на уровне CI/CD (при автоматической сборке кода) наш инструмент проверяет обратную совместимость. Он прямо на этапе пулл-реквеста проанализирует изменения и защитит от фатальных ошибок. Если разраб сервиса заказов случайно удалит поле, а сервис уведомлений всё ещё завязан на него, линтер просто заблокирует деплой и скажет: «Стоп, ты ломаешь обратную совместимость. Все клиенты твоего микросервиса упадут, если ты сейчас замержишь эту ветку».

Ну и наконец — интеграция с IDE. Специально для OpenIDE с поддержкой Go прямо из коробки мы разработали плагин EasyP, который уже сейчас доступен в маркетплейсе для установки. Пишешь в .proto строку import «orders/v1/order.proto» — и IDE сразу знает, откуда эта зависимость тянется по твоему easyp-конфигу. Никаких красных «unresolved import»: работает переход к определению и автокомплит по чужим контрактам, будто они лежат локально. Заодно плагин подтягивает в редактор правила и стандарты EasyP — те самые, по которым потом бьёт линтер на CI.

В 2025 мы выяснили, что стали монополистами в России
Да, продукт нишевый, инфраструктурный, но монопольный. Сервера полностью наши, CLI-ка написана нами. Мы Git-native, то есть никакие корпоративные контракты не улетают на чужие облачные сервера, всё крутится внутри контура компаний. Плюс мы полностью open source под лицензией Apache 2.0.

Долгое время мы специально сохраняли обратную совместимость с CLI-кой от канадского Buf'а, чтобы российским компаниям было легко переезжать. Но этим летом мы выкатим мощную энтерпрайзную версию, зарелизим версию 1.0 (потому что мы всё ещё числимся в бете уже 3 года) и планируем отсечь старое легаси, отказавшись от прямой совместимости с их синтаксисом. Но чтобы никого не бросать, мы сделаем изящную механику: девопсу достаточно будет вызвать одну команду нашей CLI-ки, и она автоматически прочитает старый конфиг Buf'а, переведёт его в наши концепции и бесшовно сгенерирует родной конфиг EasyP.

Что мы делаем в H3LLO
У нас были высокие требования к инфраструктуре. Собственно, пошли смотреть облака по рынку, их там ровно три, подходящих два. В H3LLO написал в поддержку, типа, у меня нет проблем, есть идея. И они связались!

Короче, мы получили мощность на развитие проекта, поддержку от облака с крупными корпоратами и сейчас делаем совместные проекты.

Зачем нам облако, если всё можно On-Prem? Ну, надо было разместить реестр схем. Это облачный репозиторий, где хранятся, версионируются и документируются все Protobuf-файлы компании. Туда можно в любой момент загружать новые версии API-контрактов и скачивать актуальные схемы. Обычно это сервер в корпоративной сети, но у нас ещё работает малый бизнес, поэтому это для него.

P.S. А, и кстати, вот ссылка на комьюнити t.me/easyptech
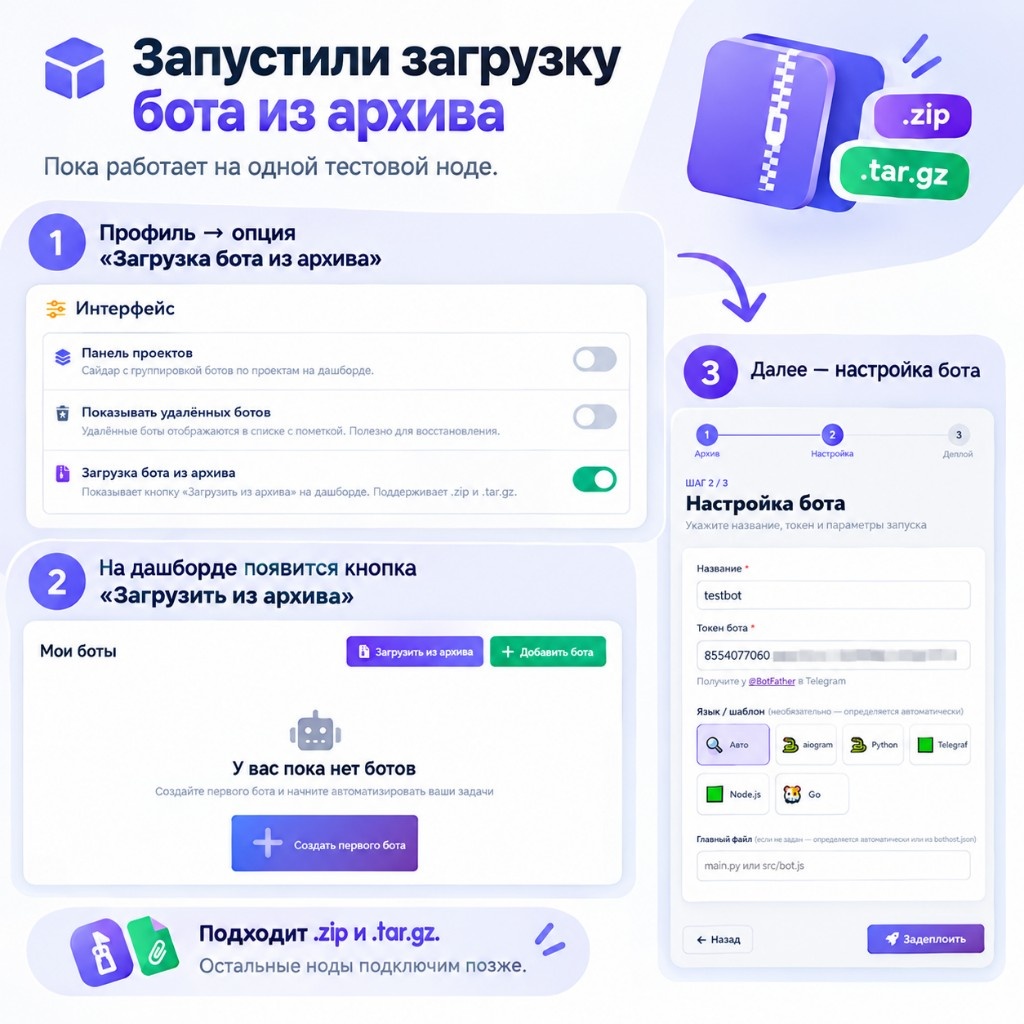
Теперь на Bothost доступен деплой бота из архива

Если репозитория нет или код лежит только на компьютере, бота можно задеплоить файлом: упакуйте проект в .zip или .tar.gz и загрузите его через дашборд. Сборка и запуск такие же, как при деплое из Git: Docker-образ, контейнер, логи.


Bothost: деплой бота из архива →

M1Cloud становится частью Selectel – одного из крупнейших облачных провайдеров России


Сервис-провайдер M1Cloud (ООО «Стек Групп») и крупнейший независимый провайдер ИT-инфраструктуры в России Selectel закрыли сделку по приобретению 100% доли M1Cloud. Общая сумма сделки составит не более 2,6 млрд рублей.

Сделка является частью стратегии развития Selectel по укреплению позиций на облачном рынке и расширит возможности заказчиков M1Cloud за счет комплексного портфеля решений и глубокой экспертизы Selectel. При этом продукты и привычные сервисы продолжат работать в обычном режиме, условия предоставления услуг сохранятся без изменений.

M1Cloud предоставляет приватные облачные решения на базе партнерских дата-центров в Москве. Более 15 лет компания специализируется на высоконадежной виртуальной ИТ-инфраструктуре с высоким уровнем отказоустойчивости. Решения M1Cloud используют более 170 представителей среднего и крупного бизнеса. Прогнозная выручка M1Cloud за 2026 год – 1,5 млрд рублей.

Приобретение облачного провайдера M1Cloud – это последовательный шаг в усилении роли Selectel на облачном рынке. Selectel сочетает органический рост с точечными приобретениями. Решения о покупке принимаются при уверенности, что они создают дополнительную ценность для акционеров и способствуют развитию бизнеса в долгосрочной перспективе. Ключевые компетенции M1Cloud сосредоточены в оказании услуг по созданию и поддержке приватных облачных решений. Сделка усиливает наше присутствие в этом сегменте и дополняет существующую экспертизу компании. Нашим приоритетом остается сохранение высокого качества сервиса и предоставление гарантий надежности для клиентов Selectel и M1Cloud
подчеркнул Олег Любимов, генеральный директор Selectel.

Стратегическое объединение с Selectel открывает нашим клиентам и партнерам принципиально новые горизонты и дает возможность получать более комплексные решения. Это позволит бизнесу быстрее реализовывать амбициозные проекты, используя синергию лучших практик обеих компаний
отметил Евгений Горохов, исполнительный директор M1Cloud.

Выручка Selectel за 6 месяцев 2026 года достигла 10,2 млрд рублей, показав рост на 14% год к году. Рентабельность по скорр. EBITDA составила 53%. Клиентская база Selectel расширилась до 44,5 тыс. на конец первого полугодия 2026 года.

Рег.решения: доля тематических доменов выросла до 60% на фоне развития нейропоиска


Развитие искусственного интеллекта меняет подход российского бизнеса к выбору домена для запуска сайта: предприниматели всё чаще регистрируют адреса в тематических доменных зонах, чтобы быть понятными для ИИ-алгоритмов.

С начала 2026 года регистрации в тематических зонах заметно выросли: .tech прибавила 60%, .space — 54%, .site — 30%, .pro — 24%, .online — 13%. Ключевая причина изменений — в ИИ-алгоритмах поисковых систем: предприниматели стали чаще выбирать доменную зону не по географии, а по смыслу бизнес-проекта.

Тематическая доменная зона сегодня выполняет ту же роль, что и понятное название компании: домен сразу сообщает и пользователю, и ИИ-алгоритмам, чем занимается компания. По мнению экспертов, тренд говорит и о росте цифровой зрелости малого и среднего бизнеса: предприниматели воспринимают домен не как обязательную галочку, а как инструмент бренда.

«Для бизнеса важнее узнаваемость зоны, наличие свободного имени и то, насколько адрес соответствует самому проекту. Для технологического проекта естественно выглядит .tech, для профессиональных услуг — .pro, а .online или .site подходят практически любому бизнесу. В итоге выбор становится шире, а сама доменная зона всё чаще работает как часть позиционирования проекта», — отмечает Ася Вартазарьян, линейный руководитель отдела аналитики группы Рунити (объединяет Руцентр, Рег.ру, Рег.облако, SpaceWeb и другие ИТ-компании).

В условиях, когда искусственный интеллект решает, какой сайт включить в ответ пользователю, тематический домен помогает бизнесу сразу обозначить свою нишу и повысить шансы попасть в число рекомендованных. Российский рынок пока находится на стадии формирования спроса. Многие предприниматели пока выбирают классическое SEO, рассматривая GEO (Generative Engine Optimization, продвижение в ответах нейросетей), как следующий шаг.
www.reg.ru/solutions/product/seo
www.reg.ru/solutions/product/geo

«Главная цель предпринимателей — заявки и их рост, а не просто трафик или позиции сайта в поисковой выдаче. Тематический домен становится тем самым первым сигналом для нейросети, который в будущем помогает бизнесу привлечь клиентов. 70% наших пользователей приходят с готовыми сайтами, которые хотят доработать, а 30% — это новые сайты. И тем, и другим мы помогаем выстроить стратегию, где домен работает не просто как адрес, а как часть воронки», — комментирует Владислав Иванов, коммуникационный директор Рег.решений, сервиса для предпринимателей от Рег.ру.

Национальные доменные зоны при этом не сдают позиций: за январь–август 2026 года .ru прибавила 8% — почти до 750 тысяч регистраций,.рф — 20%, до 95 тысяч. Тематические зоны растут вместе с рынком, но опережают его: они забирают регистрации, где бизнесу важно не просто быть в сети, а сразу обозначить сферу деятельности, особенно если подходящее имя в .ru уже занято.

Новая зона доступности uz-1b в Ташкенте


В Ташкенте появилась третья зона доступности — uz-1b на отдельной площадке.
Регион uz-1 стал мультизональным: к действующему сегменту uz-1a добавился uz-1b. Вместе с uz-2 в Ташкенте теперь три зоны доступности, а всего в Servercore — пять зон в трех странах.
Подробнее о безопасности и отказоустойчивости
servercore.com/ru/solutions/security/

Единая сеть внутри региона
Облачные серверы и PaaS-сервисы в сегментах uz-1a и uz-1b связаны единой сетью с задержкой менее 1 мс. Это позволяет строить кластеры, растянутые между зонами, без заметной потери производительности.

Растянутые кластеры между сегментами
В мультизональном пуле uz-1 узлы кластера баз данных или Managed Kubernetes можно разместить сразу в двух сегментах — uz-1a и uz-1b. Отказ одной площадки не останавливает кластер целиком: балансировщик распределяет трафик между инстансами в обеих зонах.

Больше вариантов для критичных сервисов
Инфраструктуру можно распределить между сегментами пула uz-1, между пулами uz-1 и uz-2 или между облаком и собственной площадкой — связность обеспечивает глобальный роутер (L3VPN). Уровень резервирования вы выбираете сами: от одной зоны до географически разнесенных площадок.

Только новое оборудование
На старте в uz-1b доступны только новые конфигурации на AMD EPYC 9554 и AMD EPYC 9754 с памятью DDR5. Переезд в новую зону — это одновременно апгрейд железа.

Отказоустойчивость не включается сама
При простом переезде в новую зону она не появляется автоматически. Чтобы ее получить, нужно разнести экземпляры приложения между сегментами, настроить балансировку, репликацию данных и переключение при сбоях. Мы помогаем с архитектурой и бесплатно переносим инфраструктуру.

Облако по чертежу: как собрать инфраструктуру под проект

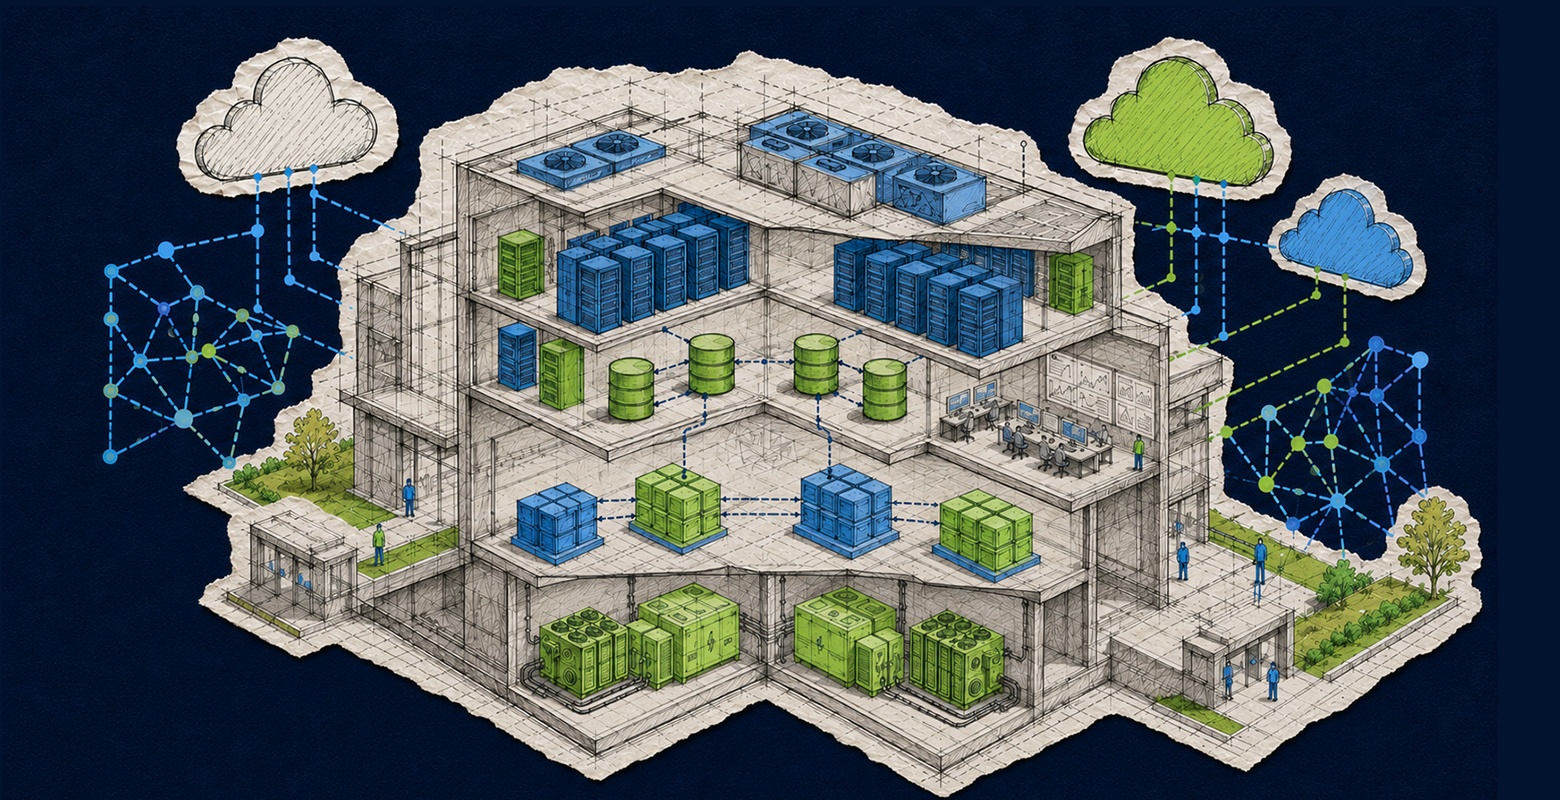
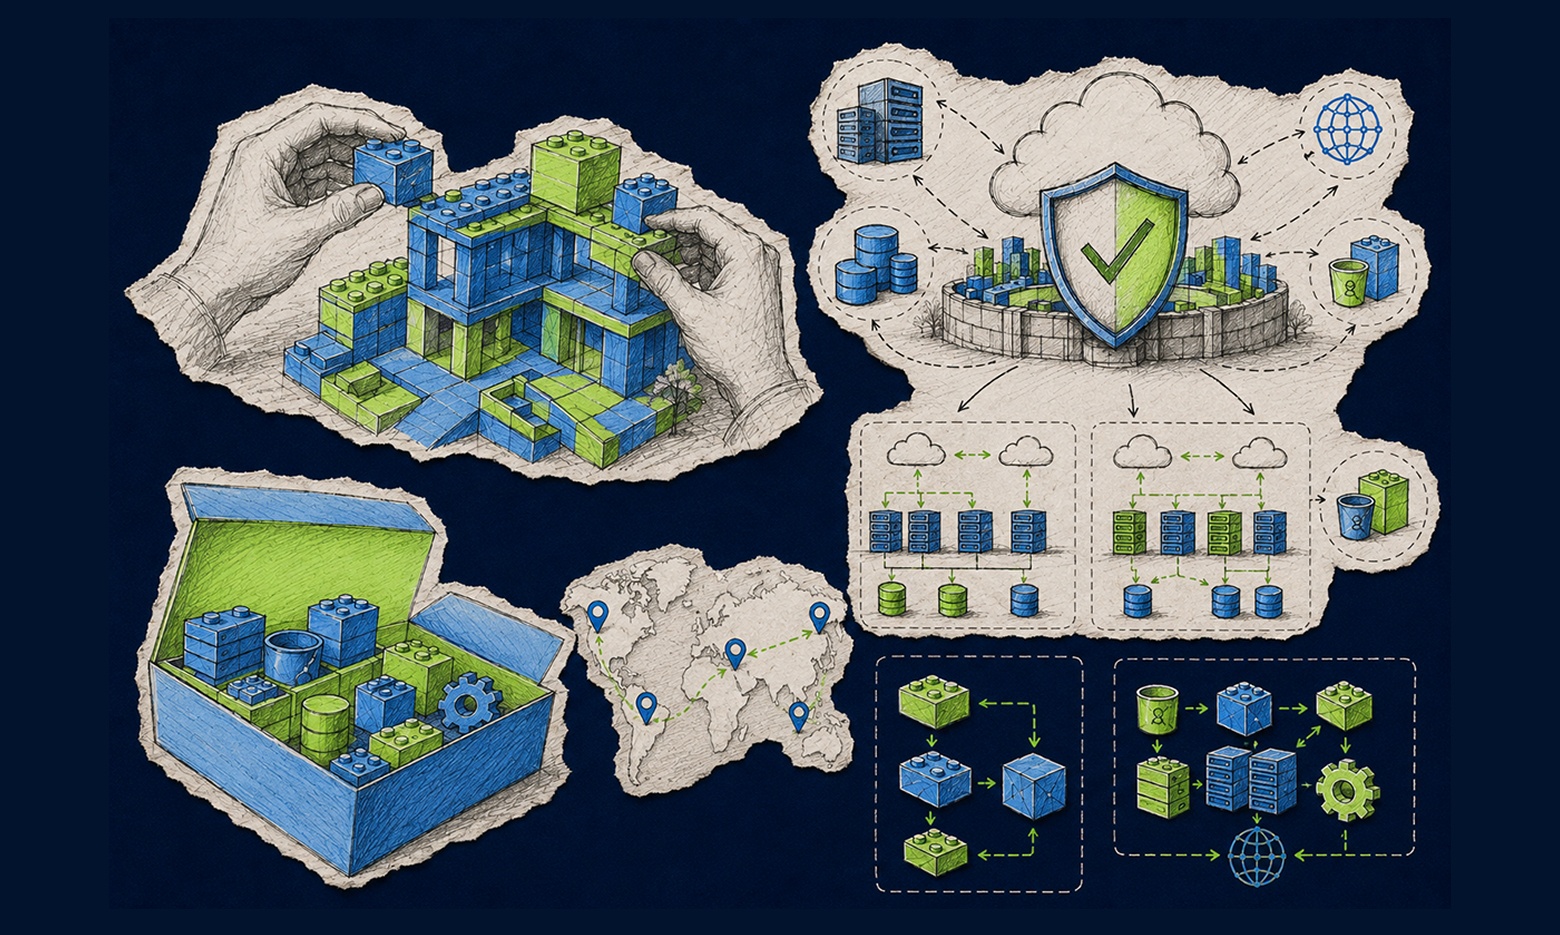
IT‑инфраструктура подобна зданию: в её фундаменте — вычислительные мощности, а выше — надстройки, включающие внутренние коммуникации, инженерные системы, резервные механизмы. И каждому проекту — свой дом. Кому‑то достаточного небольшого домика на одном виртуальном сервере, а для кого‑то приходится возводить целую девятиэтажку с распределёнными сервисами и оркестрацией.

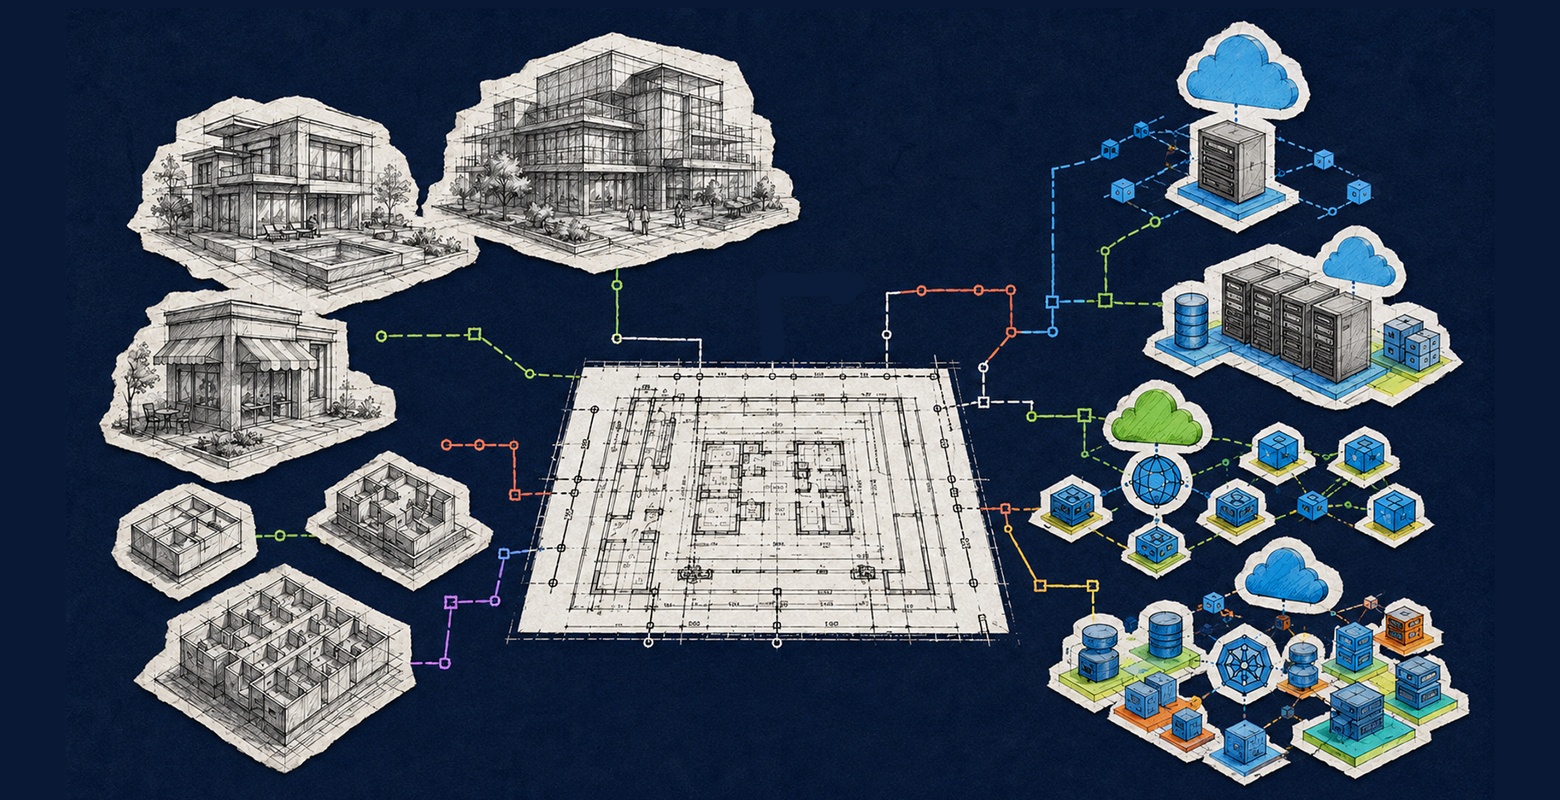
И если в разработке проекта дома будущему владельцу помогает архитектурное бюро, то при создании облачной инфраструктуры клиент получает от провайдера набор компонентов, из которых сможет собрать систему под своё приложение и, при необходимости, менять её по мере роста бизнеса. Эти компоненты, подобно блокам Lego, совместимы и позволяют собирать комбинации под какие угодно задачи.

Фундамент: с каких сервисов начинается инфраструктура


Что ж, для начала разберём по кирпичику фундамент и посмотрим, какие важные элементы инфраструктуры могут в него входить.

Вычислительные мощности — основа любого проекта. Обычно в этой роли выступают VPS (виртуальные частные серверы). На них можно разместить сайт, приложение, систему управления содержимым, сервис автоматизации или другие компоненты. Наша облачная платформа включает VPS/VDS, объектное хранилище S3, Managed Kubernetes, облачные базы данных и CDN — сеть доставки контента.

Надо сказать, что простой проект с небольшой нагрузкой и минималистичной структурой может нормально работать и на одном VPS: в этом случае приложение и базу данных размещают вместе, а файлы хранят на локальном диске. Это хорошее решение для небольшого бизнеса: запустить продукт без сложной архитектуры и затрат на ненужные пока сервисы, а если позже проект подрастёт или появится бюджет на масштабирование — тогда уже докупить компоненты и расшириться.

Объектное хранилище S3. Оно подходит для файлов, медиаконтента, а также резервных копий. Мы храним объекты в трёх экземплярах на независимых серверах в разных стойках, и для S3 заявлена доступность 99,98%.

База данных. В зависимости от проекта её можно разместить на одном VPS с приложением или вынести в DBaaS (Database as a Service, управляемую облачную БД) — тогда часть инфраструктурной работы перейдёт на сторону провайдера.

CDN. Позволяет отдавать кешируемый контент с географически распределённых узлов, тем самым снижая число запросов к основному серверу.

Managed Kubernetes — управляемая система оркестрации контейнеров. Нужна для проектов с контейнерной архитектурой.

Как CTO выбирают облако
Совсем универсального чек‑листа по выбору облака для СТО не существует — просто потому, что архитектура интернет‑магазина, внутренней корпоративной системы, SaaS‑платформы и вычислительного продукта очень разные. Но всё же несколько критериев повторяются почти всегда, ниже поговорим о каждом из них.
  • Доступность. Для кого‑то день недоступности сайта приемлем, а для кого‑то — катастрофа. Например, у нас есть клиент — крупный интернет‑магазин, для которого даже один час простоя может обернуться убытками в миллионы рублей. Так что СТО важно понимать как приемлемый для бизнеса уровень доступности и смотреть на SLA провайдера и прописанные в договоре условия компенсации при сбоях в его зоне ответственности.
  • Поддержка. Автоматизация — это, конечно, хорошо, но ещё лучше, если рядом будут и специалисты, которые могут помочь. Причём речь не просто о канале связи — поддержка должна быстро и компетентно реагировать и нести ответственность за свою работу.
  • Выбор сервисов. CTO обращают внимание на готовые решения для различных задач. Даже если прямо сейчас они неактуальны — могут понадобиться в ходе развития проекта, когда потребуется масштабирование или изменятся потребности.
  • Опыт других пользователей. Документация, отзывы, профессиональные сообщества и наличие кейсов — тоже важные критерии при выборе облачного провайдера.
  • Стоимость. Сравнивать нужно не просто цену виртуального процессора или гигабайта памяти в отрыве от всего остального — в инфраструктурном бюджете обязательно учитывают также затраты времени инженеров на обслуживание баз данных, резервное копирование, обновления и другие операции.

Почему типовой проект — это не универсальное решение


Казалось бы, инфраструктуру можно проектировать в зависимости от типа заказчика: вот архитектура для интернет‑магазина, вот — для SaaS, вот — для высоконагруженной системы… Но не всё так просто.

Систему делят на функциональные компоненты: серверную часть, базы данных, балансировку, кеширование, хранение файлов и другие уровни. Вместо универсального чертежа — несколько комбинаций компонентов. И вдобавок ко всему — понятный интерфейс, чтобы пользователь мог сам настроить проект под свои требования. Такой подход сейчас лучше, чем шаблонные проекты под каждый тип бизнеса, ведь продукты и бизнес‑задачи у клиентов разные.

Давайте теперь рассмотрим, как бизнес подбирает наиболее оптимальную архитектуру с учётом особенностей проекта.

Автоматизация на VPS
В Beget для таких проектов есть готовое решение с n8n и платформой автоматизации рабочих процессов. Пользователь получает сервер с уже предустановленным ПО, а дальше собирает сценарии интеграции разных сервисов. Надо сказать, что само приложение остаётся в зоне ответственности клиента. Например, обновлять n8n пользователь должен самостоятельно. Перед обновлением мы рекомендуем проверить резервную копию или сделать снимок сервера.

У нас был случай: в программу грантов Beget пришёл стартап, предоставляющий клиентам серверы вместе с личными кабинетами. Стартап в один клик создаёт серверы в панели для клиентов и пользуется встроенной функцией создания образов для быстрой интеграции нужного набора ПО и настроек — и выполняет за пару часов работу, которая в других условиях заняла бы несколько дней. Это ускорение позволяет стартапу быстро расти: на пике у проекта было более 800 VPS одновременно.

Архитектура интернет‑магазина
Для интернет‑магазина нужны иные компоненты: VPS с предустановленной CMS → база данных (на том же VPS, в DBaaS или отдельном VPS с предустановленной БД) → S3 → CDN.

Изображения товаров и резервные копии можно хранить в S3, а статический контент — раздавать через CDN. В таком варианте отдельные части системы масштабируются независимо: рост объёма файлов не требует увеличения диска основного сервера, а рост числа запросов к статическим ресурсам не означает пропорциональный рост нагрузки на приложение.

Это, кстати, только одна из возможных схем архитектуры для интернет‑магазина, но не единственная.

Если SaaS и высокая нагрузка
Для растущего SaaS‑проекта подойдёт комбинация: VPS или Kubernetes + DBaaS + S3 + CDN.

Изначально приложение может работать на нескольких VPS, но если команда переходит к контейнерам, а количество сервисов увеличивается, уже требуется оркестрация — и вычислительный слой стоит перенести в Managed Kubernetes. У нас есть два варианта: для разработки и тестирования — с одна управляющей нодой, а для рабочей среды — с тремя master‑нодами. Во втором случае состояние управляющего контура реплицируется, и при выходе одной ноды управление кластером продолжает работать.

Когда в проекте тысячи виртуальных машин
Для некоторых задач важно большое количество отдельных машин. Один из наших клиентов (извините, но NDA, так что без названия) использует около 2000 VPS. Такая конфигурация подходит продуктам, где отдельные экземпляры собственного решения запускаются для большого количества клиентов или вычислительных задач. В подобной архитектуре множество VPS можно дополнять DBaaS и Kubernetes.

Вот, кстати, живой пример того, что размер инфраструктуры не зависит от типа проекта: молодая компания с вычислительным продуктом потребляет больше облачных ресурсов, чем зрелый интернет‑магазин.

Как инфраструктура растёт вместе с бизнесом


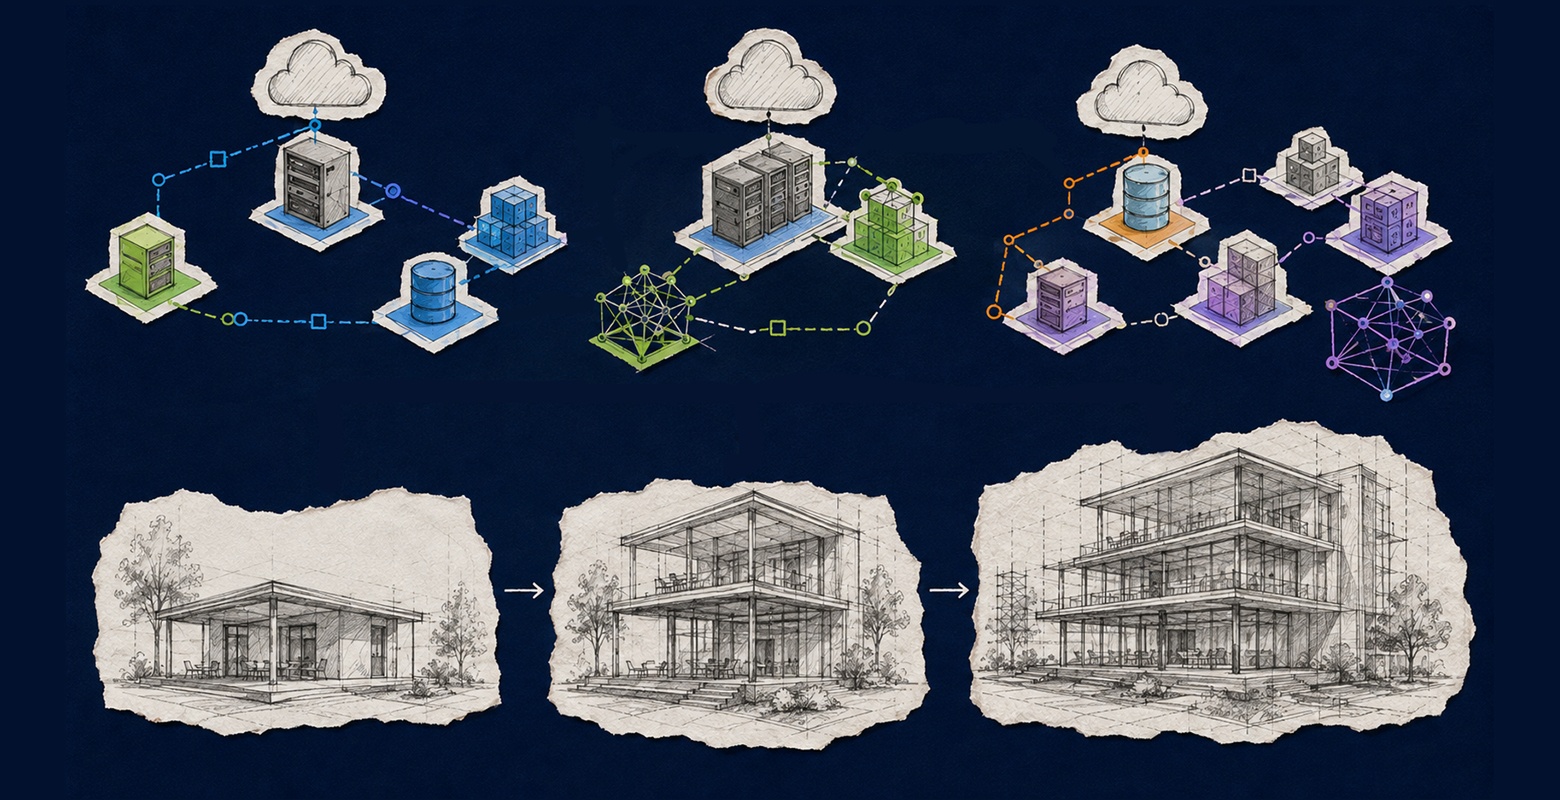
В начале проекта главная задача — быстро запустить работающий продукт, поэтому клиенты обычно стартуют со схемы VPS → приложение + база данных. Если представить, что проект — дом, то такая схема — фундамент. С ростом нагрузки «дому» нужно надстраивать «этажи»: добавлять процессорные ядра, оперативную память или диск.

На следующем этапе компоненты разделяют: VPS → приложение, DBaaS → база данных, S3 → файлы и резервные данные, CDN → доставка контента. Если одного экземпляра приложения становится недостаточно, прибегают и к горизонтальному масштабированию: запускают несколько вычислительных узлов, а нагрузку распределяют между ними.

При контейнерной архитектуре следующим уровнем часто становится Kubernetes. Но это не всегда так: если два или три VPS с отдельной БД закрывают задачу, добавление оркестратора может лишь усложнить эксплуатацию.

За что отвечает провайдер и как мы обеспечиваем отказоустойчивость


Клиенты приходят к нам как с новыми проектами, так и с уже работающей инфраструктурой. В первом случае облако становится стартовой площадкой, архитектуру строят с нуля. Второй причиной миграции может быть несоответствие предыдущей платформы ожиданиям клиента — например, стоимости, удобства работы, доступности поддержки или каких‑то других аспектов.

На экономику проекта серьёзно влияет исходная инфраструктура. Если компания переносит собственное оборудование в облако, меняется структура капитальных расходов — часто бывает, что облачное решение будет обходиться дешевле сервера на своём железе и персонала для его обслуживания. Если проект уже работал у другого облачного провайдера, при переходе возможна экономия за счёт других, более выгодных тарифов, изменения архитектуры, сокращения количества ручных операций, а также в снижении времени простоя, если бизнес чувствителен даже к коротким периодам недоступности проекта. К слову, перенос инфраструктуры вовсе не всегда сопровождается радикальным изменением архитектуры: виртуальные серверы, базы данных и хранилища могут остаться концептуально теми же.

Модель облака подразумевает разделение ответственности. На стороне провайдера — развёртывание серверной инфраструктуры, настройка сети сервиса, обновления программного обеспечения, резервное копирование и восстановление данных, мониторинг и инфраструктурная безопасность. Клиент же, в свою очередь, проектирует приложение и определяет, как компоненты будут связаны между собой. Так же с Kubernetes: провайдер предоставляет доступ к control plane и инфраструктурной части сервиса, следит за её работоспособностью, но решения о количестве экземпляров приложения, взаимодействии микросервисов и сценариях восстановления — за разработчиками.

Также в нашей зоне ответственности:
  • Доступность. В нашем SLA для VPS она закреплена на уровне 99,98% времени в год, за исключением планового обслуживания. И столько же — для DBaaS.
  • Резервные копии. Для VPS мы автоматически создаём раз в несколько дней и храним на отдельных серверах в другом дата‑центре. S3 — с тройной репликацией: три копии объекта размещаются на независимых серверах в разных стойках. Пользователь может восстановить как сервер, так и отдельные файлы.
  • Сеть доставки контента. Сейчас у нас 200 точек присутствия CDN на пяти континентах, они обеспечивают глобальный охват — тяжёлый контент сайта или приложения загружается одинаково быстро в любой точке мира. Серверы кешируют файлы к себе, сокращая физическое расстояние до конечного пользователя.
  • Защита от DDoS‑атак. VPS защищены на сетевом и транспортном уровнях L3/L4;
  • Отказоустойчивость. Облачные базы данных размещены в ЦОД уровня Tier III. В Kubernetes три master‑ноды позволяют сохранить управление кластером при отказе одной из них.

Как видите, технических возможностей платформы достаточно, чтобы построить систему без многих очевидных точек отказа. Но нельзя забывать, что конечный результат зависит также и от архитектуры клиента. Например, можно иметь три master‑ноды Kubernetes — и при этом запустить критичное приложение в одном экземпляре. Или хранить данные в надёжной облачной базе, но написать приложение, которое прекращает работу при коротком сетевом сбое. Или использовать автоматические резервные копии, но не проверить процедуру восстановления до реального инцидента.

Так что провайдер отвечает за заявленную им доступность и работу собственных инфраструктурных сервисов, а команда проекта — за правильное использование этих возможностей. Пользователь должен сам решить, насколько критично его приложение, какие показатели времени восстановления нужны, сколько копий данных и какую стоимость дополнительной отказоустойчивости бизнес готов оплачивать.

Заключение. Облако — это конструктор, а не готовое здание


Самая важная особенность облачной инфраструктуры в том, что проект — это живая система, которая открыта к изменениям. По этой причине мы не даём пользователям универсальных советов в духе «подключите пять сервисов — и получите отказоустойчивую инфраструктуру». Требования невозможно стандартизировать. Если сегодня бизнесу достаточно одного VPS, это ещё не значит, что завтра ему не придётся переезжать в DBaaS, из‑за того что база данных стала слишком важной и её не стоит оставлять рядом с приложением. Вырос объём файлов? Возможно, пора переходить на S3. Увеличилась аудитория? Стоит задуматься о подключении CDN. Кому‑то станет нужен Kubernetes, потому что в приложении появились контейнеры и выросло число экземпляров, а кому‑то Kubernetes вообще никогда не потребуется.

В этом и заключается логика нашего облачного конструктора: начать с маленького «домика» — минимально необходимой инфраструктуры, а новые «этажи»‑компоненты добавлять уже по мере усложнения требований, под бизнес‑задачи или технические изменения.

beget.com/ru/cloud

Посещение ММТС-9 с 18 по 20 сентября 2026 года


Уважаемый клиент!

В связи с проведением выборов, на объекте ММТС-9 вводится мораторий на проведение работ в технических залах объекта в период с 00:00 18.09.2026 до 23:59 20.09.2026 г.

Настоятельно не рекомендуем планировать работы, которые могут повлиять на функционирование оборудования.

В случае возникновения аварийных ситуаций, пожалуйста, создавайте тикет с подробным описанием произошедшего и указанием того, как именно данная авария влияет на работу вашего оборудования.

Благодарим за понимание.

С уважением,
Технический отдел

Вы уже использовали скидку на VPS?


И чтобы ваши фичи доходили до прода быстрее, ко Дню программиста мы подготовили скидку 25% на выбранный период заказа — 1, 3, 6 и 12 месяцев на новые VDS. Скидка работает на серверы в России, Нидерландах и Казахстане.


Если вы ждали знак — это он. Пора выкатывать проект.
https://firstvds.ru