Апдейт по восстановлению Beget


Виртуальный хостинг
На текущий момент запущено 35% серверов. Работы по запуску остальных серверов продолжаются. Каждый сервер проверяется вручную, поэтому сайты возвращаются в работу постепенно.

Выделенные серверы без нашего администрирования
Все серверы запущены и доступны. Если с вашим сервером что-то не так, напишите в комментариях к этому посту.

Выделенные серверы под нашим администрированием
На текущий момент запущено 15%. Работы по восстановлению остальных серверов продолжаются.

Домены и DNS
Домены работают. Для доменов под нашим управлением, направленных на DNS-серверы Beget, его DNS-записями можно управлять здесь: domains.beget.ru

Бэкапы
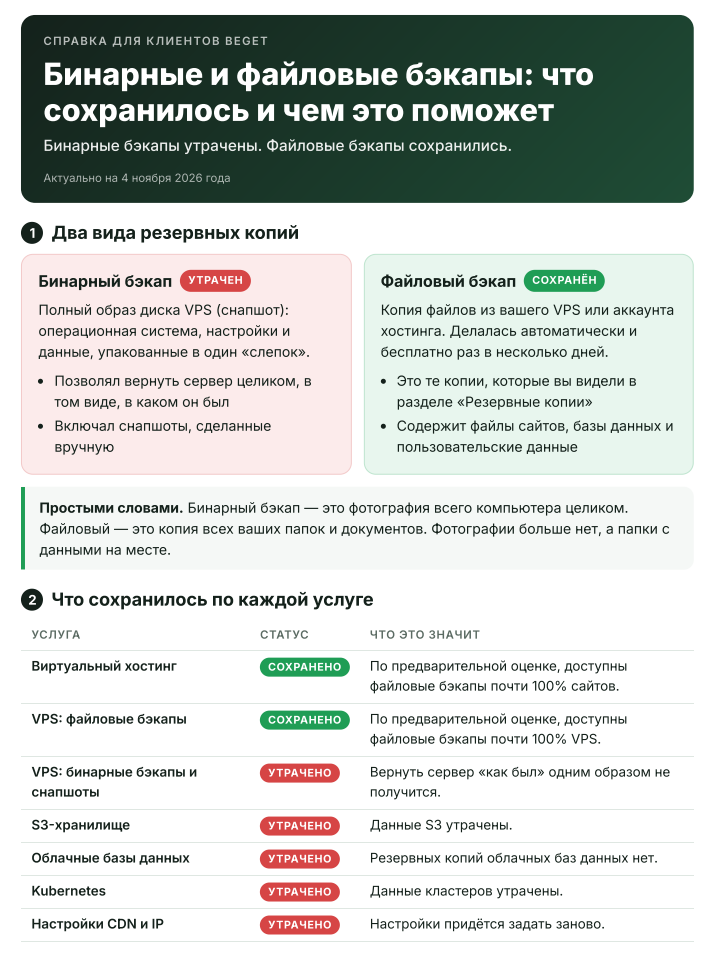
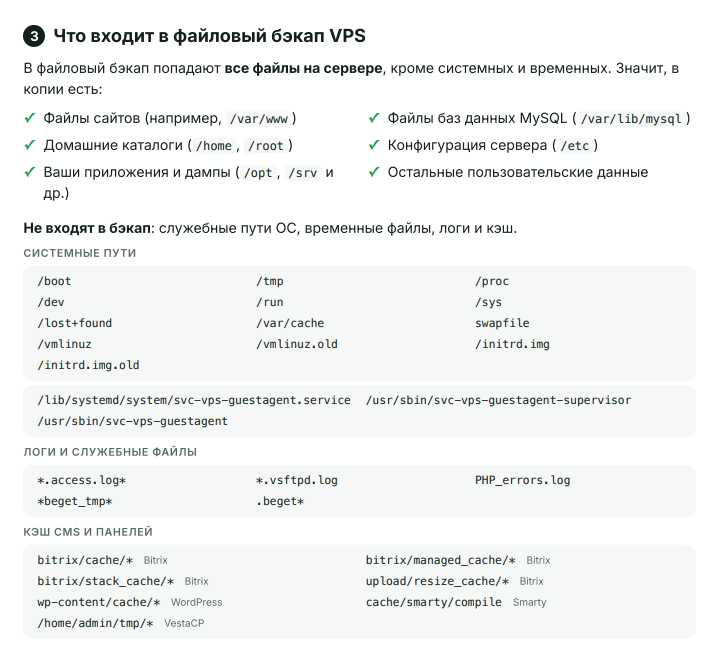
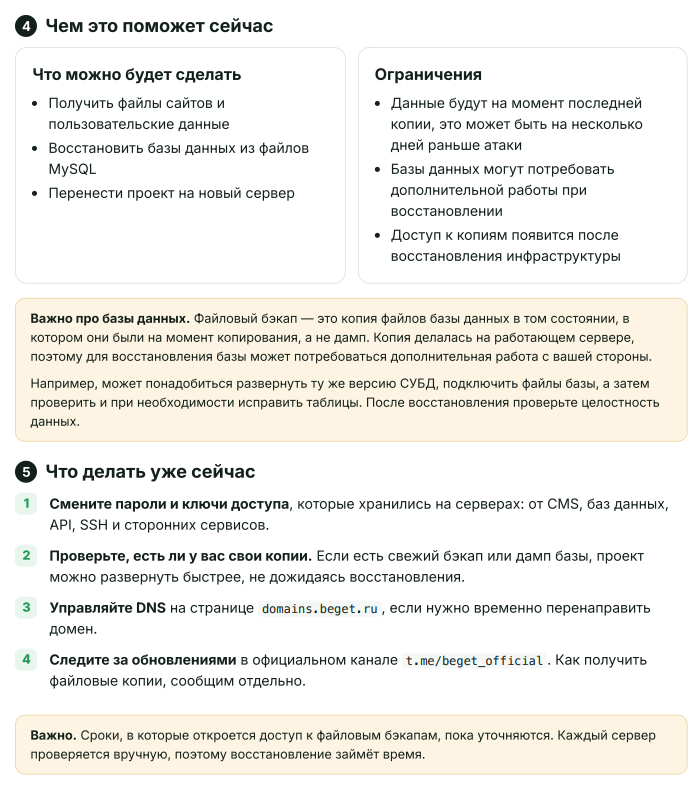
Ведутся работы по восстановлению инфраструктуры резервного копирования. Порядок получения копий опубликуем отдельным постом. Чем отличаются бинарные и файловые бэкапы, объясняем в справке

Панель управления
Ведутся работы по запуску панели управления. Сейчас в приоритете запуск серверов, сайтов и восстановление бэкапов. О запуске панели сообщим отдельно.

Спасибо за терпение. Мы продолжаем восстанавливать сервисы.


У нас произошёл крупный инцидент


15:43, 02.11.2026 Обновление информации по инциденту и восстановлению работы сервисов Beget
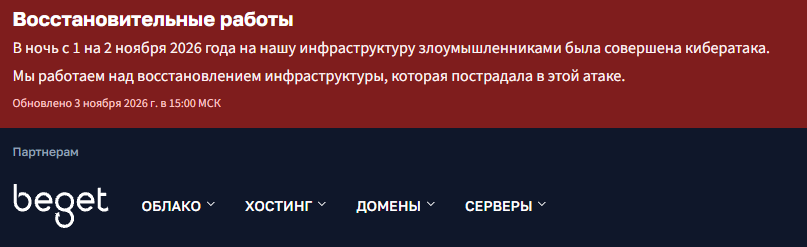
В ночь на 2 ноября 2026 года наша инфраструктура подверглась массированной кибератаке, в результате которой была нарушена работа ряда сервисов.

Официальное уведомление об обстоятельствах непреодолимой силы
Настоящим ООО «Бегет» уведомляет клиентов о возникновении обстоятельств, которые обладают признаками непреодолимой силы (форс-мажора) в соответствии с пунктом 3 статьи 401 Гражданского кодекса РФ и положениями действующих договоров.

Масштабная атака на инфраструктуру компании и вызванные ею последствия временно препятствуют надлежащему исполнению части наших обязательств по предоставлению услуг. Настоящее сообщение является официальным уведомлением о возникновении указанных обстоятельств и их влиянии на исполнение договорных обязательств.

Текущий статус восстановления
На данный момент нам уже удалось восстановить работу выделенных серверов без нашего администрирования.
Что происходит сейчас:
  • NS-серверы. Восстановление их работы — наш главный приоритет. Ориентировочный срок — ближайшие 4–5 часов.
  • Почтовая система. Параллельно ведём работы по восстановлению её работоспособности.
  • Резервные копии.
На данный момент нам доступны файловые резервные копии подавляющего большинства ресурсов виртуального хостинга и облачной инфраструктуры. Мы продолжаем работу по восстановлению данных, однако из-за значительных объёмов этот процесс потребует длительного времени.
Наши специалисты непрерывно работают над восстановлением инфраструктуры и делают всё возможное, чтобы как можно скорее вернуть сервисы к полноценной работе.
При этом мы продолжаем оценивать масштаб последствий атаки, поэтому пока не можем назвать точные сроки полного восстановления всех сервисов.
Мы понимаем, насколько критична доступность наших услуг для ваших проектов, и прикладываем все усилия для скорейшего восстановления работы.
Будем информировать вас по мере поступления новых подтверждённых данных.
Спасибо за терпение, понимание и поддержку.

8:23, 02.11.2026 Апдейт по инциденту
Мы продолжаем детальный разбор ситуации.
Проблема носит комплексный характер и затрагивает все уровни архитектуры.
В данный момент инженеры выполняют ручную настройку инфраструктуры непосредственно в дата‑центрах.
Для решения задачи задействованы все необходимые ресурсы — команды работают в усиленном режиме.
Следующий апдейт опубликуем сразу после получения подтверждённой и точной информации.

6:03, 02.11.2026 Статус инцидента: восстановительные работы и расследование
На данный момент наша команда ведёт восстановительные работы и детальное расследование инцидента.
Следующий апдейт — в 08:00 по МСК.

4:05, 02.11.2026
У нас произошёл крупный инцидент. Задействованы все ресурсы, разбираемся в причинах и делаем всё возможное, чтобы восстановить стабильность.
Следующий апдейт — в 6:00.
Спасибо за понимание.

Разбор текущей ситуации


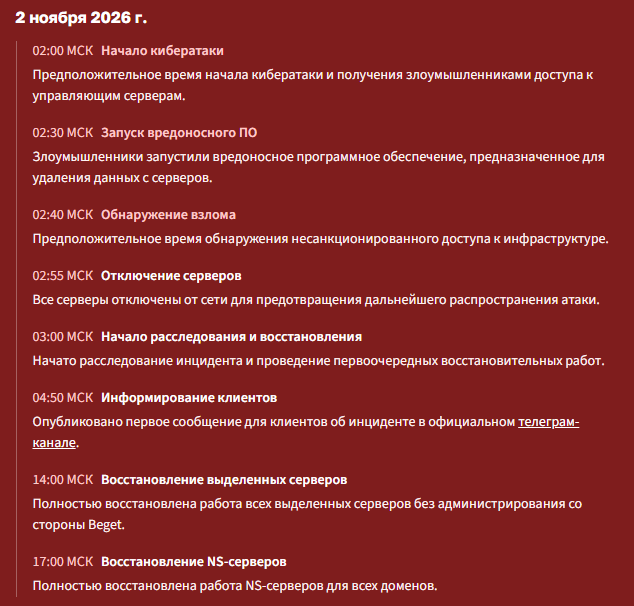
В ночь с 1 на 2 ноября 2026 года на нашу инфраструктуру была совершена кибератака с получением доступа к управляющему контуру всей архитектуры и последующим запуском обнуляющих скриптов.

На текущий момент мы не можем раскрыть все детали происходящего, в том числе в целях последующего безопасного запуска инфраструктуры.

Восстановление инфраструктуры, которая пострадала в этой атаке, продолжается.

Что уже сделано:
  • Восстановление dedicated‑серверов под собственным администрированием пользователей. Данный сервис был восстановлен 2.11 ориентировочно в 14:00.
  • Восстановление DNS‑серверов. Доступен функционал смены DNS‑записей (A, MX, TXT) в зонах ru/рф/su — можно перенаправить домены на другие адреса. Это применимо для доменов, зарегистрированных в Beget и направленных на DNS‑сервера Beget. Над управлением международными доменами ведётся работа.
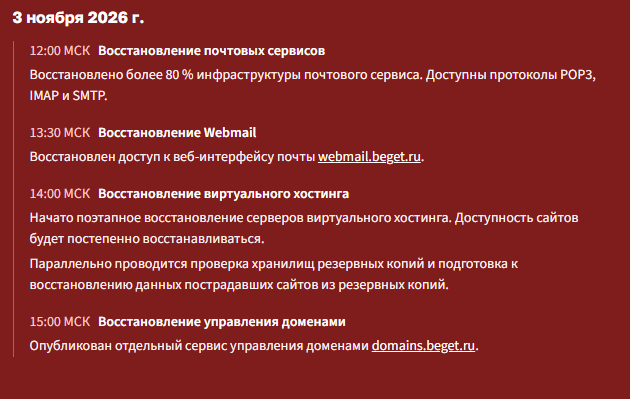
  • Восстановление 80 % инфраструктуры почтового сервиса. Ожидаем полный вывод его в полноценную эксплуатацию в течение 10 часов.
  • Домены. Мы договорились с КЦ (Координационный центр сети Интернет) о том, чтобы домены в зонах .ru/.рф/.su у которых заканчивается срок делегирования, не были разделегированы и продолжили работать. По международным доменам продолжается работа.

Напоминаем, что приоритетное продление домена возможно даже после окончания его регистрации.

Общее состояние инфраструктуры Beget на данный момент:
Бэкапы и резервные копии.
Файловые бэкапы всего хостинга и облачной инфраструктуры сохранены, но без восстановления работы нашей инфраструктуры нет возможности предоставить к ним доступ прямо сейчас. Это связано с необходимостью ручной проверки каждого сервера на наличие скрытых уязвимостей и вредоносных скриптов. К сожалению, просто включить серверы без их тщательной проверки невозможно.

К сожалению, бинарные бэкапы VPS полностью утеряны. Остаётся возможность восстановления данных из файловых бэкапов.

Выделенные серверы.
Все серверы без нашего администрирования введены в работу. На серверах под нашим администрированием большая часть данных также сохранилась, продолжается проверка и ввод серверов в работу.

Хостинговые серверы.
По предварительной оценке, восстановлению подлежат почти 100 % сайтов, размещавшихся на виртуальном хостинге. Мы приступили к восстановлению работы хостинговых серверов. Запуск виртуального хостинга также требует скрупулёзной проверки серверов, и на это также требуется значительное время.

Облачная инфраструктура.
В облачной инфраструктуре (VPS, S3 и Kubernetes) все данные были утрачены. Сохранены файловые бэкапы VPS. Настройки CDN, IP утрачены. Мы не сдаёмся и продолжаем поиск способов восстановить эти данные.

Доменные имена.
Ваши доменные имена в безопасности. Мы уже работаем над восстановлением управления доменами. Вы уже сейчас можете управлять DNS‑записями доменов.

Панель управления.
В течение 24 часов мы предоставим ограниченный интерфейс для управления частью услуг.

Конкретные сроки восстановления всех сервисов сейчас уточняются.
Это займёт существенное время, так как требуется ручная проверка более 1000 серверов.

По тем данным, которые сейчас есть, мы видим, что на серверах, где были данные пользователей, не было попыток скачать или изменить данные. Мы рекомендуем сменить все пароли, ключи доступа и другие учётные данные, которые могли храниться на серверах.

Все сотрудники Beget работают в кризисном режиме. Отдел DevOps работает круглосуточно и будет работать в таком графике до окончания работ по инциденту.

Мы знаем, что вы на нас рассчитываете, и прикладываем максимум усилий.
Мы понимаем, что в текущей ситуации вам бы хотелось иметь больше информации и контроля, однако мы не можем делиться информацией, которая на данном этапе ещё может повредить проведению расследования.

Спасибо за ваше понимание.

По мере появления достоверной информации мы будем её публиковать.


Срочное техническое обслуживание всех основных маршрутизаторов


В настоящее время мы проводим срочное техническое обслуживание всех наших основных маршрутизаторов. Обслуживание проводится поочередно. В ходе этих работ снижается общая избыточность сети. Мы не ожидаем перебоев в работе, но вы можете заметить увеличение задержки.

Это техническое обслуживание обеспечивает долгосрочную безопасность и стабильность нашей инфраструктуры. Благодарим вас за понимание и терпение.

Как и почему мы проектировали последнее коммерческое облако России и от какого буллшита избавились по ходу


Меня часто спрашивают:
— Почему к вам, а не к гигантам?

Ответ простой:
— Мы не охреневшие.

Сначала я хотел рассказать про нашу сеть хранения, которая быстрее, чем скорость записи на RAID 0, про удивительное конкурентное преимущество «Трезвая поддержка», про 400G‑линки на каждом хосте, про изоляцию сетей и топологию Dragonfly+ с full mesh на уровне зон доступности. Но всё‑таки я решил: самое главное, что мы не охреневшие.

Это главная штука, которую мы решили для себя со старта.

А теперь расскажу, что же мы последовательно делали и что запускаем.
Это прототип нашего облака, сейчас ЦОД выглядит чуть иначе
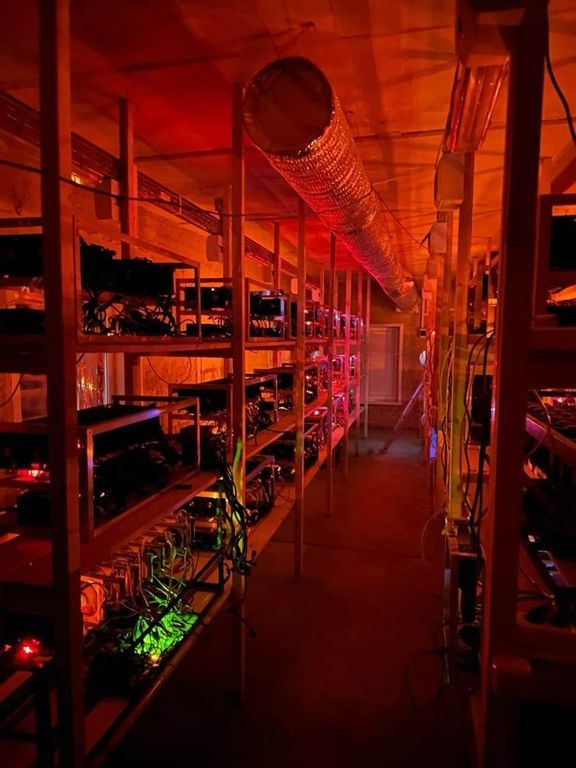
Вот примерно так одна из площадок выглядит
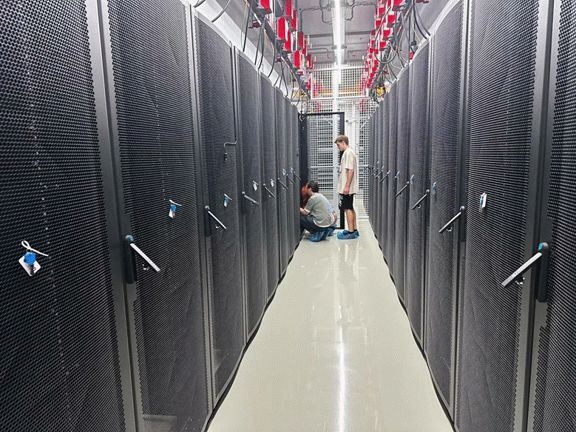

Площадки и зоны доступности
Основные площадки — это три наших локации в Москве в пределах МКАДа (часть вообще внутри Садового) с новым типом инфраструктуры — когда снаружи непонятно, что это ЦОД, и инфра не собирается в маленький плотный кубик в очевидном месте.

Плюс два московских дата‑центра: IXcellerate North (Север) и IXcellerate South (Юг). По мере готовности двух наших площадок мы мигрируем из IXcellerate в них. Сами точки присутствия мы тоже хитро организовали. Заводить 50 разных операторов в своё свежеоборудованное здание — неприкольно. Поэтому у нас понятный транзитный процесс, который мы скоро завершим: остаётся бордер для стыковки с внешними сетями и пара серваков для резерва внутренней инфры в одной точке, такой же бордер и пара серваков в другой.

И между ними обеими, а также между основной точкой, где всё развёрнуто, проложена хорошая оптическая связь независимыми маршрутами.

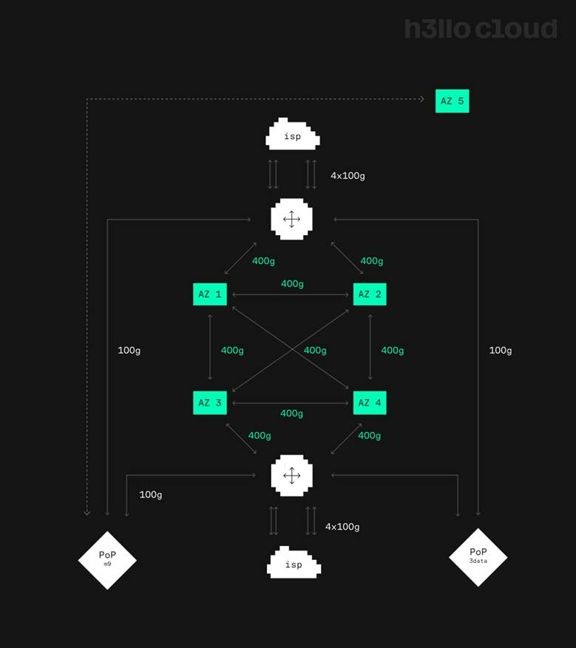
Итого у нас получается 5 зон доступности (по 2 внутри IXcellerate/новых и одна на самой первой локации), будет 6. Зоны доступности — это полностью изолированные инфраструктуры: свои непересекающиеся сетевые железки, свои отдельные энерговводы, своё охлаждение, свои источники бесперебойного питания. Полностью. Выход из строя оборудования в одной зоне доступности никак не должен затронуть другую.

Кроме того, у нас есть ЦОД в Александрове, где развёрнуты AZ с воздушным и жидкостным охлаждением, включая иммерсионное. Это отдельные зоны, потому что там разные системы охлаждения и разные физические помещения. Топим мы только старое и десктопное железо, потому что найти серверное оборудование, сертифицированное под иммерсионное охлаждение, практически нереально. Там мы не ставим коммерческих клиентов облака.

Также у нас была точка присутствия в дата‑центре 3data, из‑за которой нас называли перекупами, и, что очень важно, на М9 — главном телекоммуникационном узле в России. Здесь мы можем быстро сделать физический линк с кем угодно, организовать прямой коннект для клиентов, затащить любого оператора, которого нет в основных ЦОДах (хотя там есть практически все). Фактически это наш третий Meet‑Me Room.

Сейчас мы подключаемся к точке обмена трафиком MSK‑IX. Зачем? Это даёт невероятную гибкость: мы можем пириться с кем угодно, как угодно, очень быстро и легко. Можно дать трафик на пользователей любого провайдера напрямую, не поднимаясь на вышестоящих операторов. Это как ещё один Meet‑Me Room, но уже виртуальный.

Связь
Между ключевыми площадками (обоими IXcellerate, М9, 3Data и офисом) мы взяли тёмное волокно, которое нам любезно предоставил «Мастертел», и засветили его на 400 Гбит/с. Про новое — деталей не будет, простите, мы решили поменьше открывать варежку про такие вещи, но уровень тот же.

В будущем планируем расширять ёмкость с помощью DWDM.

Связь с Александровом пока реализована через 10-гигабитный интернет от Ростелекома и 10-гигабитный L2 VPN‑канал до М9. Суммарной пропускной способности в 20 Гбит/с для этой площадки более чем достаточно. Работаем над строительством оптических трасс, но это небыстрая история.

Для сравнения: пиковый трафик всего Cloud.ru, по словам их бывшего сетевого инженера, не превышал 40 Гбит/с. У нас восемь внешних аплинков по 100 Гбит/с.

В каждом из ключевых ЦОДов ядро сети вынесено в отдельный независимый по питанию и инфраструктуре модуль — Meet‑Me Room. У нас прямо трассы с кросс‑панелями: всё красиво разведено. В каждом MMR у нас по четыре линка от разных провайдеров (два основных, два резервных). Мы специально проверяли, чтобы их трассы физически не пересекались и не приходили в один и тот же маршрутизатор.

Суммарная ёмкость каналов — 800 Гбит/с. Это мегаоверкилл, но такой запас — это фундамент для нашего собственного сервиса анти‑DDoS. Мы сейчас внедряем его на базе коммерческой версии одного open‑source‑решения, и, скорее всего, на старте он будет встроенным и бесплатным для всех клиентов.

Вся эта сложная система из AZ, MMR и ЦОДов построена по топологии Dragonfly+. Если упрощать, то каждая AZ и каждый MMR — это независимая группа узлов. В группе серверов — классический Клоз (Node‑Leaf‑Spine). Между всеми группами — full mesh. Это даёт потрясающую отказоустойчивость.

Представим себе худший сценарий: в одном из ЦОДов IXcellerate полностью выходит из строя MMR. Это значит, что все четыре внешних аплинка в этом ЦОДе отваливаются. Что произойдёт? Ничего критичного. Во‑первых, каждая зона доступности в этом упавшем ЦОДе напрямую связана с зонами доступности в другом ЦОДе через те самые 400-гигабитные каналы. Трафик просто пойдёт через бордер второго ЦОДа. Система спроектирована так, чтобы пережить отказ любого компонента.

Железо
Одно‑ и двухюнитовые серверы HPE 11-го поколения. На борту у них:
  • Процессоры Intel Xeon 5-го поколения.
  • По 2 терабайта оперативной памяти DDR5.
  • NVMe для операционной системы и как сверхбыстрые локальные диски для кластерных баз данных (когда у вас кластерная СУБД, ей не нужен сетевой диск, а локальный NVMe даёт сумасшедшую скорость) и SSD для объединения в storage‑сеть.
  • Опционально — GPU. Сейчас это в основном NVIDIA, уже наладили закупку B300 для задач инференса и нашей будущей дата‑платформы. GPU мы продаём не поминутно, а с долгосрочным коммитом — минимум на год.

Следующая закупка — это либо HPE 12-го, либо Dell 17-го поколения. Там уже Xeon 6-го поколения.

В сервере стоят две сетевые карты по два порта 100G. Каждая карта подключена к двум разным ToR’ам (лифам). Лифы, в свою очередь, соединены с двумя спайнами. Отказ любого кабеля или коммутатора не приводит к потере связности. Ну и, конечно, в каждой стойке — два независимых ввода питания. Сети задублированы на всех уровнях. При этом нам доступна вся полоса в 400G.

Каждый хост соединяется с тремя независимыми сетями:
  • Управление железом (iLO/MGT): отдельная полностью изолированная сеть для управления физическими устройствами.
  • OOB: ещё одна физически изолированная сеть с линками 2×25G для управляющих команд, обновлений, метрик и внутреннего доступа хостов. Даже если основная фабрика ляжет, то доступ к хостам останется.
  • Основная фабрика: 400G‑сеть для Control Plane и Data Plane. Через Control Plane общаются наши кластеры. Сервисы управления говорят кластеру нагрузок, какие именно ресурсы должны быть и в каком состоянии (да, кубер оперирует понятием «желаемое состояние»). Это отдельный сегмент. Data Plane (SDN + SDS) — это второй отдельный сегмент 400G‑фабрики для трафика клиентских виртуальных машин и сетевых дисков.

Приоритеты трафика разграничиваются через QoS. Сами сети изолируются либо физически, либо через VRF без route‑leaking. Помимо Data Plane и Control Plane, есть ещё четыре служебных сегмента, но о них — как‑нибудь отдельно.

Доступность
Мы делаем гиперскейлер. Гиперскейлер — это про доступность и отказоустойчивость. В нашем случае — на уровне виртуальной машины. Под ней может ломаться что угодно, но если она может быстро и бесшовно мигрировать с сервера на сервер — это норм. Сейчас наша цель — обеспечивать SLA на уровне 99,5%.

К концу года мы целимся в SLA 99,99% для двух виртуальных машин, запущенных в разных зонах доступности, и 99,97% — для одной виртуальной машины или любого другого сервиса. Для дата‑центра уровня TIER-3 — это 99,982% доступности. Наши 99,99% для разнесённых виртуалок — это уже выше. А стоят они в двух сертифицированных TIER-3-ЦОДах и одном несертифицированном.

Выше TIER-3 не прыгнуть. Плюс доступность там считается без учёта времени простоя сети, то есть просто по включению. Ну, точнее, можно поискать Tier-4, но оно того обычно не стоит.

У нас доступность считается с сетью. И это доступность сервисов ВМ, а не пинг до гипервизора. Чтобы ваш сервис упал всего на несколько минут в год, даунтаймы ЦОДа, даунтаймы интернет‑провайдера и даунтаймы самого сервера должны совпасть в одном временном окне. Но так не бывает. Даже надёжный сервер Hewlett‑Packard 12-го поколения в первый год эксплуатации требует около четырёх часов регламентного простоя, плюс его нужно перезагружать для апдейтов.

В облаке таких проблем нет.

Вероятно, мы нарушим это обещание. Такое случается при авариях или идиотских проблемах. Сейчас, на период обкатки в продакшене, уровни гарантий для публичного облака выглядят у нас так:
  • Если доступность между 99,5 и 99% — 10% скидки.
  • Если доступность 95–99%, то 15% скидки.
  • Ниже 95% — 30% скидки.

Убедившись, что с этим справляемся, мы перейдём к более жёстким SLA:
  • Если доступность между 99,97 и 99% — 10% скидки.
  • Если доступность 95–99%, то 30% скидки.
  • Ниже 95% — расчётный период бесплатно.

Для приватных инсталляций возможны ещё более жёсткие гарантии, обсуждаемые в индивидуальном порядке.

По БПЛА‑форсмажорам пока не отвечу, мы в переговорах со страховщиками.

Как же мы достигаем такой надёжности? За счёт правильной физической архитектуры и живой миграции. В этом и есть смысл облаков — воткнуть сервисы в две разные зоны доступности и получить надёжность выше, чем у любого физического ЦОДа. Потому что упасть может что угодно: отдельный сервер, стойка, вся автономная зона, ЦОД или даже целый регион. Наша задача — минимизировать вероятность такого события и его последствий.

Софт
А теперь самое интересное — софт. Мы не используем OpenStack, CloudStack, китайский Z‑Stack или модный Cozy (как мы его прозвали, «козий стек»). Наша платформа — полностью собственная разработка. Почему? Потому что мы всё это попробовали и поняли, что лучше не надо. Если вы нас читаете, то видели часть этих экспериментов.

Любой фреймворк — это компромисс. Ты получаешь что‑то «из коробки», но быстро упираешься в его ограничения. Например, в нижележащей системе есть нужная тебе функция, а API фреймворка её ещё не поддерживает. И ты ничего не можешь с этим сделать. Мы прошли этот путь на раннем этапе беты, когда использовали гибрид из Cozy Stack и наших сервисов, и в итоге приняли решение выпилить его полностью и написать всё с нуля.

Ещё одна важная причина — сертификация. Ни один OpenStack никогда не пройдёт серьёзную сертификацию ФСТЭК или 152-ФЗ УЗ-1.

А собственная разработка может. Мы сейчас как раз этим и занимаемся. Конечно, есть нюанс: при каждом обновлении системы сертификат ФСТЭК нужно получать заново, а это дорого — услуги испытательной лаборатории стоят порядка 400+ тысяч рублей за раз. Как показывает опыт, многие коллеги получают его один раз на какую‑то версию, вывешивают на сайт, а в продакшене крутится уже совсем другое. Мы же для приватных инсталляций будем поддерживать сертифицированные версии, потому что нашли более правильный путь беспрерывной сертификации изменений.

В основе — Kubernetes. Причём мы используем его не только для управляющего контура (control plane), но и для оркестрации всей клиентской нагрузки, включая виртуальные машины. Когда мы накидывали архитектуру с собственным оркестратором, то в какой‑то момент посмотрели на результат и поняли: «Так вот же он, Кубер!» Зачем изобретать велосипед, если есть прекрасный стек технологий, который отлично с ним интегрируется: kubevirt — для виртуализации KVM, Linstor — для SDS, и не без боли — Kube‑OVN — для SDN.

Правда, это не навсегда. Для публичного облака мы уже видим пределы Kubernetes по масштабу и перепиливаем отдельные компоненты. Сейчас переходим на мультикластерную систему.

Для виртуализации мы выбрали самый нативный и стандартный для Linux‑мира стек: KVM — в качестве гипервизора и QEMU — для эмуляции аппаратного обеспечения. Это компоненты, встроенные прямо в ядро Linux. Некоторые конкуренты используют Xen или VMware, но сегодня KVM — это де‑факто стандарт индустрии, и изобретать тут что‑то своё просто не имеет смысла.

Хранение
Вычисления и хранилище находятся на одних и тех же физических серверах. За хранение отвечает система Linstor с DRBD под капотом. Это гиперконвергентная архитектура.

Работает это так: все SSD‑диски на сервере отдаются JBOD. Да, вы не ослышались: JBOD, который не даёт никакой отказоустойчивости, но обеспечивает максимальную производительность. Мы превращаем диски в одну большую быструю «мясорубку». Linstor поверх этого массива нарезает тома для виртуальных машин (с помощью LVM‑thin).

Надёжность обеспечивает DRBD. В тот момент, когда Linstor создаёт том на одном сервере, он тут же создаёт и его полную синхронную реплику на другом, который находится в другом домене отказа, и опционально — в другой зоне доступности. Наше хранилище знает топологию облака и понимает, что реплицироваться нужно в соседнюю геоточку.

Если один сервер (или все его диски разом) выходит из строя, то система мгновенно переключается на работу со второй репликой. Пользователь даже не заметит этого. Репликация синхронная, но за это приходится платить оверхедом. Вообще DRBD поддерживает три схемы репликации: Protocol A — полностью асинхронная, Protocol B — синхронная in‑memory (операция считается выполненной при записи на primary‑диске и при записи в память на ноде с secondary‑диском) и Protocol C — полностью синхронная.

Оверлейные сети
На заре нашего проекта, в бете, всё было просто: каждая виртуалка получала белый IP‑адрес. Это было щедро, но небезопасно: никакой изоляции между клиентами на сетевом уровне. Естественно, нас это не устраивало.

Мы выбрали Kube‑OVN для создания программно‑определяемой сети (SDN). Решение отличное, но очень непростое в настройке. Наш сетевик пытался расспросить всех, до кого только мог дотянуться (а в списке были ведущие архитекторы крупных российских клаудов), а они лишь пожимали плечами. Помню, я потратил два дня на траблшутинг проблемы, почему пакеты не ходят из VPC во внешний мир при правильно настроенном (прямо по инструкции) шлюзе. Пришлось обвесить всё tcpdump'ом и на уровне каждого пакета отслеживать его путь.

Проблема оказалась в связке конфигурации VPC и NAT Gateway — виртуального маршрутизатора, который стоит на границе VPC и Интернета. Пакеты извне на него приходили, он их отправлял внутрь VPC, адресат их получал, а вот ответные пакеты обратно не уходили. И хоть ты тресни! Оказалось, что вещь, которую в документации преподносили как опцию — статические маршруты, — на самом деле является обязательным компонентом. Без прописанных вручную маршрутов к этому NAT Gateway ничего не работало. Мы победили эту проблему.

Следом мы научили систему анонсировать белые IP‑адреса клиентов по BGP. Дефолтный способ работы (ARP) нам не нравится, потому что это L2, а в нашем масштабе он был бы ещё и растянутым, что есть конкретный антипаттерн. Буквально до текущей версии Kube‑OVN не умел корректно анонсировать /32 специфики по BGP и хотел слать целые подсети. Сейчас всё работает как надо. Когда NAT Gateway получает IP‑адрес, с ноды, где он запущен, улетает анонс маршрута /32 нашему пограничному маршрутизатору с помощью BGP‑спикеров. В результате IP становится доступен из всего мира.

Сейчас в арсенале сетей у вас есть:
  • Неограниченное количество VPC и подсетей.
  • SNAT: все машины внутри VPC могут выходить в интернет через один общий белый IP.
  • DNAT: можно пробрасывать трафик с внешнего IP на разные машины и порты внутри VPC по гибким правилам.
  • FIP: можно привязать IP к хосту в формате 1:1.
  • Static Routes: можно задать любые статичные маршруты внутри VPC между подсетями.
  • Policy‑based Routes: то же самое, что и static, но с более гибкой настройкой по условиям.
  • Security Groups (читай: файрвол), правила которых применяются на уровне шлюза или отдельного хоста. Тоже без ограничений.

Для оптимизации производительности мы применяем продвинутые приёмчики, среди которых — Mellanox ASAP для аппаратного ускорения и eBPF‑bypass для трафика между ресурсами на одной ноде.

По умолчанию мы создаём рабочую конфигурацию: VPC, сабнет, NAT Gateway с белым IP, SNAT‑rule и Static Route. Всё работает «из коробки». Но мы даём пользователям и тонкие настройки. Правда, тут есть нюанс: если вы не понимаете, что делаете, то появляется миллион способов выстрелить себе в ногу. Поэтому наш совет: если не уверены, то используйте дефолтные настройки.

S3, IAM, биллинг и бэкапы
Мы даём S3-совместимый API для объектного хранилища, чтобы клиенты могли легко перенести свои приложения с Amazon AWS, просто сменив эндпоинт.

Сейчас для скорости мы развернули его на базе Ceph и RADOS Gateway. Но, честно говоря, RADOS Gateway — это так себе решение. Оно начинает деградировать при большом количестве объектов и упирается в производительность одного Ceph‑кластера. Поэтому мы уже пишем собственный API‑шлюз. Он будет работать с группой независимых Ceph‑кластеров, распределяя нагрузку и данные между ними. Этот шлюз будет взаимодействовать с RADOS, который, в отличие от RADOS Gateway, как раз хорош. Это позволит нам масштабироваться практически бесконечно и проще управлять репликацией между автономными зонами.

Сервис управления пользователями и правами доступа (IAM) мы писали с нуля, вдохновляясь архитектурой AWS. Нас интересовало, как они обрабатывают более миллиарда запросов в секунду. Чтобы не перегружать основной сервис, существует легковесный Authentication Runtime Service. Он кэширует необходимые данные и выполняет быструю проверку прав доступа для каждого API‑вызова, будь то чтение объекта из S3 или создание виртуальной машины.

Ключевой принцип безопасности, который мы заложили: API‑ключ можно увидеть только один раз при создании. Дальше он не подлежит чтению, его можно только проверить. Никто, даже мы, не сможет его восстановить. Потерял — перевыпускай новый. Это не шутка. Умный учится на чужих ошибках. Перевыпустить ключ — дело двух кликов.

Биллинг — целая пачка микросервисов, которая должна работать строго консистентно и идемпотентно. Идемпотентность означает, что случайный повторный запрос на списание не спишет деньги дважды. Система должна корректно обрабатывать пополнения через платёжные шлюзы, не допуская фрода, и, конечно же, автоматически останавливать ресурсы пользователя при нулевом балансе. Да, на старте у нас была забавная ситуация, когда ресурсы при нулевом балансе не прибивались. Тем, кто нашёл эту дыру, мы разрешили пользоваться ею до исправления). Багбаунти, кстати, пока нет (хотя коллеги и бета‑тестеры уже накидали пару раз в панамку), про неё думаем.

Бэкапы реализованы через снапшоты. Linstor, используя LVM‑thin, умеет делать мгновенные снимки дисковых томов. Эти снапшоты мы выгружаем в наше S3-совместимое объектное хранилище. Снапшоты, кстати, тоже есть — можно зафиксировать состояние диска в моменте и разворачивать из него виртуалки сколько угодно.

Важно, что хранилище для бэкапов работает на совершенно других, выделенных серверах. Кроме того, у нас есть партнёрство с «Киберпротектом» (это, если что, бывший Acronis, который разделился на Acroni~1 и Acroni~2 с момента начала санкций) для защищённых резервных копий в отдельном хранилище. Прямо под капотом их нет, но по запросу мы их включим.

А для самых параноидальных клиентов мы рассматриваем внедрение ленточных хранилищ. Звучит как анахронизм, но на самом деле — очень крутая штука. У ленты есть одно убойное преимущество — её нельзя заразить шифровальщиком. В смысле можно, но нельзя. Лента надёжна.

Поддержка
Помните историю про «Ваша виртуалка на согласовании» из одного энтерпрайзного облака, когда это должно решаться одной кнопкой в личном кабинете? А вот у кого‑то она до сих пор на согласовании. У кого‑то поломался биллинг, и, когда его починили, заблокировали треть пользователей разом без предупреждения. А у людей — праздники. Как им срочно пополнять баланс? И ответ один: «Не нравится — идите на...» Где‑то надо смотреть 40-минутный вебинар, чтобы разобраться, как поднять простенький сайт…

Мы другие.

Мы небольшая команда инженеров, которая строит продукт для таких же инженеров. Мы — это вы.

И хотим и дальше так делать.

Мы, конечно, накосячим по дороге, и не раз. Но мы быстро всё исправим. И услышим вас. И даже если не будем делать то, чего вы просите, то ответим.

Сейчас мы небольшого размера — сотни серверов. Это топовое современное железо, которое производительнее «среднего по рынку» в несколько раз. Так что по мощности мы соответствуем среднестатистическому облачному провайдеру. Какого размера мы хотим быть? Просто передам привет Селектелу, МТСу и Сберу.


Друзья, мы пришли на этот рынок всерьёз и надолго.

h3llo.cloud
Свободные выделенные серверы Hetzner: EPYC 256 GB за 277 €, Ryzen 9 от 89 €/мес — до 3 раз дешевле новых


С 15 июня Hetzner поднял цены на новые выделенные серверы в 2–4 раза. У нас освободились серверы, заказанные до повышения, поэтому сдаём их до 3 раз дешевле, чем сейчас стоят сопоставимые новые у самого Hetzner. Все — в дата-центрах Hetzner в Германии (DE) и Финляндии (FI), установка бесплатная.

Для больших проектов: виртуализация, базы данных, CI, нагруженные сервисы

  • AMD EPYC 7502P · 256 GB DDR4 ECC · 4×3.84 TB NVMe — DE
    32 ядра / 64 потока · 1 Gbps безлимит · установка 0 €
    277 €/мес (≈ 25 980 ₽) · у Hetzner AX162-2 с 256 GB — 842 €/мес + 419 € установка
  • AMD EPYC 7502P · 192 GB DDR4 ECC · 4×1.92 TB NVMe — FI
    32 ядра / 64 потока · 1 Gbps безлимит · установка 0 €
    265 €/мес (≈ 24 860 ₽) · у Hetzner AX102-2 с 192 GB — 547 €/мес + 274 € установка
  • AMD Ryzen 9 5950X · 128 GB DDR4 ECC · 2×3.84 TB NVMe — FI
    16 ядер / 32 потока, до 4.9 GHz · 1 Gbps безлимит · установка 0 €
    146 €/мес (≈ 13 690 ₽) · у Hetzner AX102-1 со 128 GB — 257 €/мес + 129 € установка

Для сайтов, парсеров, игровых и рабочих серверов

  • AMD Ryzen 9 3900 · 128 GB DDR4 ECC · 2×1.92 TB NVMe — DE, FI
    12 ядер / 24 потока, до 4.3 GHz · 1 Gbps безлимит · установка 0 €
    99 €/мес (≈ 9 280 ₽) · самый дешёвый новый со 128 GB у Hetzner — 257 €/мес + 129 € установка
  • AMD Ryzen 9 3900 · 64 GB DDR4 ECC · 2×1 TB NVMe — DE, FI
    12 ядер / 24 потока, до 4.3 GHz · 1 Gbps безлимит · установка 0 €
    89 €/мес (≈ 8 350 ₽) · у Hetzner AX42-1 (8 ядер, 64 GB, 2×512 GB) — 97 €/мес + 49 € установка

Для бэкапов, архивов и медиа

  • AMD Ryzen 5 3600 · 64 GB DDR4 ECC · 2×16 TB SATA (Software-RAID) — DE
    6 ядер / 12 потоков, до 4.2 GHz · 1 Gbps безлимит · установка 0 €
    74 €/мес (≈ 6 940 ₽) · у Hetzner SX65-2 с 2×16 TB — 82 €/мес + 39 € установка

Цены Hetzner — по официальному прайсу на новые заказы с 15.06.2026, без НДС и без IPv4. Новые серверы Hetzner построены на более свежем поколении процессоров и DDR5, но по памяти и дискам наши конфигурации такие же или больше, а стоят в разы дешевле и без платы за установку.


Условия
  • сервер выдаём в течение часа после оплаты;
  • цена фиксирована;

Серверы в единичном количестве: EPYC 256, EPYC 192 и 5950X — по одному, Ryzen 9 3900 128 GB — 4 шт., Ryzen 9 3900 64 GB — 5 шт., Ryzen 5 3600 2×16 TB — 2 шт. Новых по такой цене не будет в ближайшее время, Hetzner больше не продаёт эти конфигурации по старому прайсу.

Заказать: abcd.host/dedicated
Вопросы и подбор под задачу: Telegram · sales@abcd.host

Спасибо, что остаётесь с нами!
ABCD.HOST

Последние горячие серверы в Германии и Финляндии: Ryzen 9 от 89 €, EPYC 256 GB за 277 €, 7950X3D за 199 €


Коллеги, у нас остались последние освободившиеся выделенные серверы в дата-центрах Hetzner в Германии и Финляндии. Это машины, которые мы взяли до повышения цен, поэтому сдаём их по старым ценам и без платы за установку. Ryzen 9 и EPYC из этого списка сейчас обходятся в 2–3 раза дешевле, чем такое же железо у самого Hetzner. Когда эти серверы разберут, по таким ценам их больше не будет.

Конфигурации

AMD EPYC 7502P, 256 GB — 277 €/мес (≈ 25 040 ₽)
  • 32 ядра / 64 потока, до 3.4 GHz
  • 256 GB DDR4 ECC
  • 4 × 3.84 TB NVMe SSD (15.36 TB)
  • 1 Gbps, трафик без ограничений
  • Германия, установка 0 €
Для Proxmox и виртуализации, десятков VPS и контейнеров, тяжёлых баз данных, быстрого хранилища на NVMe.

AMD Ryzen 9 3900, 128 GB — 99 €/мес (≈ 8 950 ₽)
  • 12 ядер / 24 потока, до 4.3 GHz
  • 128 GB DDR4 ECC
  • 2 × 1.92 TB NVMe SSD
  • 1 Gbps, трафик без ограничений
  • Финляндия, установка 0 €
AMD Ryzen 9 3900, 64 GB — 89 €/мес (≈ 8 040 ₽)
  • 12 ядер / 24 потока, до 4.3 GHz
  • 64 GB DDR4 ECC
  • 2 × 1 TB NVMe SSD
  • 1 Gbps, трафик без ограничений
  • Германия или Финляндия, установка 0 €
Оба Ryzen 9 3900 подходят для сайтов и интернет-магазинов, парсеров и ботов, игровых серверов, VPN, небольших кластеров виртуальных машин. Если выбираете между ними, я бы взял вариант за 99 €: за 10 € разницы получаете вдвое больше памяти и почти вдвое больше NVMe.

AMD Ryzen 9 7950X3D, 128 GB DDR5 — 199 €/мес (≈ 17 990 ₽)
  • 16 ядер / 32 потока, до 5.7 GHz, 3D V-Cache
  • 128 GB DDR5 ECC
  • 2 × 1.92 TB NVMe SSD Gen4
  • 1 Gbps, трафик без ограничений
  • Германия, установка 0 €
Самая быстрая конфигурация в списке. Высокая частота на ядро и большой кэш хорошо показывают себя на игровых серверах (Minecraft, Rust, CS2), высоконагруженных сайтах, базах данных и сборках.

Сколько это стоит у Hetzner сейчас

Цены Hetzner на 26 октября 2026, без НДС: с их сайта и по текущим лотам аукциона Server Auction.
  • EPYC 7502P, 256 GB: у нас 277 €, у Hetzner около 790 €, почти в 3 раза дороже
  • Ryzen 9 3900, 128 GB: у нас 99 €, на аукционе Hetzner от 199,70 €, в 2 раза дороже
  • Ryzen 9 3900, 64 GB: у нас 89 €, на аукционе Hetzner от 178,70 €, в 2 раза дороже
  • Ryzen 9 7950X3D, 128 GB DDR5: у нас 199 € и установка 0 €, у Hetzner (AX102) 259 € плюс 129 € за установку
Откуда 790 € за EPYC: на аукционе Hetzner EPYC 7502P сейчас есть только со 128 GB и NVMe на 960 GB, от 337,70 €/мес, и это уже дороже нашего сервера. Чтобы получить 256 GB и 4 × 3.84 TB NVMe, по прайсу опций Hetzner добавится 72 € за память и по 96 € за каждый диск.

Для Ryzen 9 3900 на 128 GB ближайший новый сервер Hetzner со 128 GB ECC (AX102) стоит 259 € плюс 129 € за установку, в 2,6 раза дороже.

По 7950X3D первый месяц у нас почти вдвое дешевле (199 € против 388 €), за год экономия около 850 €.
Серверов осталось буквально несколько штук, это последние машины по старым ценам. Горячие предложения у нас обычно разбирают за несколько дней, поэтому если сервер нужен, лучше занять его сейчас.

Почему через нас

  • Установка 0 € на все конфигурации из поста, сервер обычно выдаём в течение пары часов после оплаты.
  • Оплата в рублях, долларах или евро: карты Visa, MasterCard, МИР, ЮMoney, криптовалюта. Для компаний безналичный расчёт со счётом и актом.
  • Поддержка на русском в Telegram, поможем с установкой ОС и первичной настройкой.
Посмотреть конфигурации и заказать: abcd.host/dedicated (раздел «Горячие предложения»)

Вопросы, резерв сервера, уточнить локацию: Telegram @ABCDSupportBot или sales@abcd.host

Спасибо, что остаётесь с нами!
ABCD.HOST

Уязвимости в PHP. Для устаревших версий выпущены сборки с исправлениями


Ранее мы сообщали в письме о двух критических уязвимостях в ядре PHP — CVE-2026-109618 и CVE-2026-109619.

Также ранее выпустили патчи к актуальным версиям PHP: 8.2.35-1781
  • 8.3.36-1781
  • 8.4.27-1781
  • 8.5.12-1781

Сообщаем, что, кроме этого, выпустили сборки, которые исправляют уязвимости в устаревших версиях PHP:
  • 5.4.45-1794
  • 5.5.38-1794
  • 5.6.40-1786
  • 7.0.33-1786
  • 7.1.33-1786
  • 7.2.34-1786
  • 7.3.33-1786
  • 7.4.33-1782
  • 8.0.30-1782
  • 8.1.34-1782

Выпустили «нативные» PHP с поддержкой модуля лимитирования для Alma 9/10:
  • 8.0.30-8.el9.alma.1.857351
  • 8.3.36-1.el10.857351

Через панель ispmanager
  • Для установки обновленных версий PHP через панель, выполните следующие шаги:
  • Перейдите в раздел Конфигурация ПО
  • Выберите пункт Обновить
  • Выберите пункт Обновить список доступного ПО, а затем пункт Обновить ПО
  • Нажмите Обновить
  • Дождитесь окончания обновления и перейдите в раздел Службы
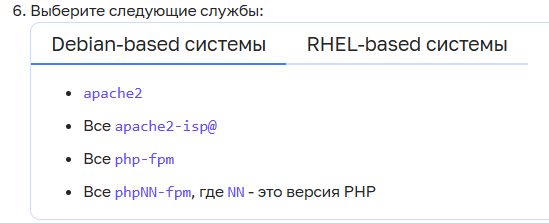
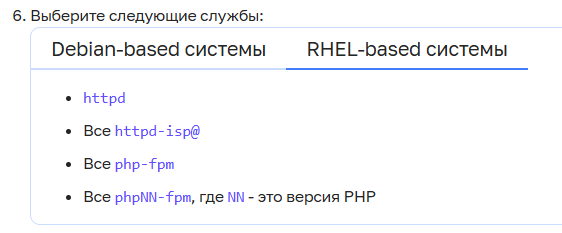
Выберите следующие службы:


  • Перезапустите службы, нажав на Перезапустить службу в меню над списком.
Фактические версии PHP и их значение в панели могут отличаться сразу после обновления — чтобы устранить несоответствие, перезагрузите сервер или перезапустите панель:
/usr/local/mgr5/sbin/mgrctl -m ispmgr -R

Вручную через пакетный менеджер
Обновить PHP можно вручную через системный пакетный менеджер:
Debian-based системы
Обновите все пакеты isp-php, выполнив команды:
apt update
apt install --only-upgrade $(dpkg-query -W -f='${Package}\n' 'isp-php*' php 2>/dev/null)

Перезапустите службы Apache и PHP-FPM, выполнив команды:
systemctl restart apache2 'apache2-isp@*' 
systemctl restart 'php*fpm*'


RHEL-based системы
Обновите все пакеты isp-php, выполнив команды:
dnf clean metadata
dnf update 'isp-php*' php

Перезапустите службы Apache и PHP-FPM, выполнив команды:
systemctl restart httpd 'httpd-isp@*'
systemctl restart 'php*fpm*'

Новые горячие серверы в Германии и Финляндии: i5-13500 со 128 GB за 109 €, Ryzen 9 за 95 €, 7950X3D за 199 €, от 69 €


Коллеги, обновление по горячим серверам. За неделю разобрали EPYC 7502P на 256 GB и Ryzen 9 3900 на 128 GB, а Ryzen 9 3900 на 64 GB остался только в Финляндии. Зато освободились две новые конфигурации на Intel Core i5-13500: со 128 GB памяти за 109 € и с третьим NVMe на 1 TB за 90 €. Сейчас в наличии 7 конфигураций в дата-центрах Hetzner в Германии и Финляндии, от 69 € в месяц, установка 0 €. Ryzen 9 3900 у нас больше чем вдвое дешевле, чем такой же сервер на аукционе Hetzner, а 7950X3D на 60 € в месяц дешевле нового AX102 и без 129 € за установку.

Новое в наличии

Intel Core i5-13500, 128 GB — 109 €/мес (≈ 9 800 ₽)
  • 14 ядер / 20 потоков (6 производительных + 8 энергоэффективных), до 4.8 GHz
  • 128 GB DDR4
  • 2 × 512 GB NVMe SSD Gen4
  • 1 Gbps, трафик без ограничений
  • Финляндия, установка 0 €
Самый доступный сервер со 128 GB в нашем списке. Памяти хватит на Proxmox с несколькими виртуальными машинами, десятки Docker-контейнеров, базы данных и кэши в оперативке.

Intel Core i5-13500, 64 GB, три NVMe — 90 €/мес (≈ 8 090 ₽)
  • 14 ядер / 20 потоков, до 4.8 GHz
  • 64 GB DDR4
  • 2 × 512 GB NVMe SSD Gen4 + 1 TB NVMe SSD
  • 1 Gbps, трафик без ограничений
  • Германия, установка 0 €
Систему можно поставить на два NVMe в RAID 1, а данные держать на отдельном быстром диске на 1 TB: удобно для баз данных, сайтов с большим объёмом файлов, CI с кэшем сборок.

Остаются в наличии

AMD Ryzen 9 7950X3D, 128 GB DDR5 — 199 €/мес (≈ 17 900 ₽)
  • 16 ядер / 32 потока, до 5.7 GHz, 3D V-Cache
  • 128 GB DDR5 ECC
  • 2 × 1.92 TB NVMe SSD Gen4
  • 1 Gbps, трафик без ограничений
  • Германия, установка 0 €

AMD Ryzen 9 3900, 64 GB — 95 €/мес (≈ 8 540 ₽)
  • 12 ядер / 24 потока, до 4.3 GHz
  • 64 GB DDR4 ECC
  • 2 × 1 TB NVMe SSD
  • 1 Gbps, трафик без ограничений
  • Финляндия, установка 0 €

Intel Core i5-13500, 64 GB — от 85 €/мес
  • 14 ядер / 20 потоков, до 4.8 GHz
  • 64 GB DDR4, встроенная графика Intel UHD 770
  • 1 Gbps, трафик без ограничений, установка 0 €
Два варианта:
  • 85 €/мес (≈ 7 640 ₽): 2 × 512 GB NVMe SSD Gen4, Германия или Финляндия
  • 90 €/мес (≈ 8 090 ₽): 2 × 512 GB NVMe SSD Gen4 + 2 × 1 TB SATA SSD, Германия

AMD Ryzen 5 3600, 64 GB — 69 €/мес (≈ 6 200 ₽)
  • 6 ядер / 12 потоков, до 4.2 GHz
  • 64 GB DDR4
  • 2 × 512 GB NVMe SSD
  • 1 Gbps, трафик без ограничений
  • Германия или Финляндия, установка 0 €

Что я бы взял под задачу

  • Игровые серверы (Minecraft, Rust, CS2), тяжёлые сайты, сборки: 7950X3D, у него самая высокая частота на ядро и большой кэш.
  • Виртуализация и много контейнеров: i5-13500 со 128 GB за 109 €. Если важна память с ECC, Ryzen 9 3900.
  • База данных на отдельном быстром диске: i5-13500 с третьим NVMe за 90 €.
  • Бэкапы, медиа, файлы: i5-13500 с 2 × 1 TB SATA SSD, тоже за 90 €.
  • Plex и Jellyfin: любой i5-13500, встроенная графика с Quick Sync перекодирует видео, почти не нагружая ядра.
  • VPN, прокси, боты, тестовые стенды: Ryzen 5 3600 за 69 €.

Сколько это стоит у Hetzner сейчас

Цены Hetzner на 2 ноября 2026, без НДС: с их сайта и по текущим лотам аукциона Server Auction.
  • Ryzen 9 3900, 64 GB: у нас 95 €, на аукционе Hetzner (64 GB ECC, 2 TB NVMe) от 202,70 €, больше чем в 2 раза дороже
  • Ryzen 9 7950X3D, 128 GB DDR5: у нас 199 € и установка 0 €, у Hetzner (AX102) 259 € плюс 129 € за установку
По 7950X3D первый месяц у нас почти вдвое дешевле (199 € против 388 €), дальше 60 € экономии каждый месяц, за год около 850 €.
Горячие серверы у нас разбирают за несколько дней: EPYC и Ryzen 9 на 128 GB с прошлой недели уже ушли. Если сервер нужен, лучше занять его сейчас, резерв можно оформить в Telegram.

Почему через нас

  • Установка 0 € на все конфигурации из поста, сервер обычно выдаём в течение пары часов после оплаты.
  • Не нужны иностранная карта и аккаунт у Hetzner: сервер оформляем мы, вы платите нам.
  • Оплата в рублях, долларах или евро: карты Visa, MasterCard, МИР, ЮMoney, криптовалюта. Для компаний безналичный расчёт со счётом и актом.
  • Поддержка на русском в Telegram, поможем с установкой ОС и первичной настройкой.
Посмотреть конфигурации и заказать: abcd.host/dedicated (раздел «Горячие предложения»)

Вопросы, резерв сервера, уточнить локацию: Telegram @ABCDSupportBot или sales@abcd.host

Спасибо, что остаётесь с нами!
ABCD.HOST

Уязвимость в WordPress с оценкой 8,1

Здравствуйте, уважаемые пользователи.


В WordPress обнаружили уязвимость CVE-2026-119977, которой была присвоена высокая оценка опасности — 8.1.
Ошибка связана с механизмом обновления ядра WordPress.

Во время установки обновлений система сначала распаковывает файлы во временный каталог. Среди этих временных файлов находится и установщик WordPress, который при определённых настройках оказывается доступен извне. Благодаря этому злоумышленники могут даже без учётной записи выполнить произвольный PHP-код на сервере и получить контроль над сайтом.

Уязвимость затронула абсолютно все версии WordPress с 4.7 по 7.1.3.

Для уязвимости разработчики подготовили исправления в 25 выпусках. В зависимости от установленной ветки администраторам сайтов следует перейти на новые исправленные версии — 7.1.4, 7.0.8, 6.9.11, 6.8.12. Версии 4.6 и более ранние уже не получают обновлений, поэтому владельцам таких сайтов придётся перейти на поддерживаемую версию.

Также рекомендуется запретить веб-доступ к каталогу wp-content/upgrade/ на уровне веб-сервера.

Если Вам будет нужна помощь с обновлением, то обратитесь в нашу круглосуточную техподдержку из личного кабинета.

Также напоминаем, что заказать тарифы WordPress у нас Вы можете на странице hostiman.ru/wordpress-hosting.