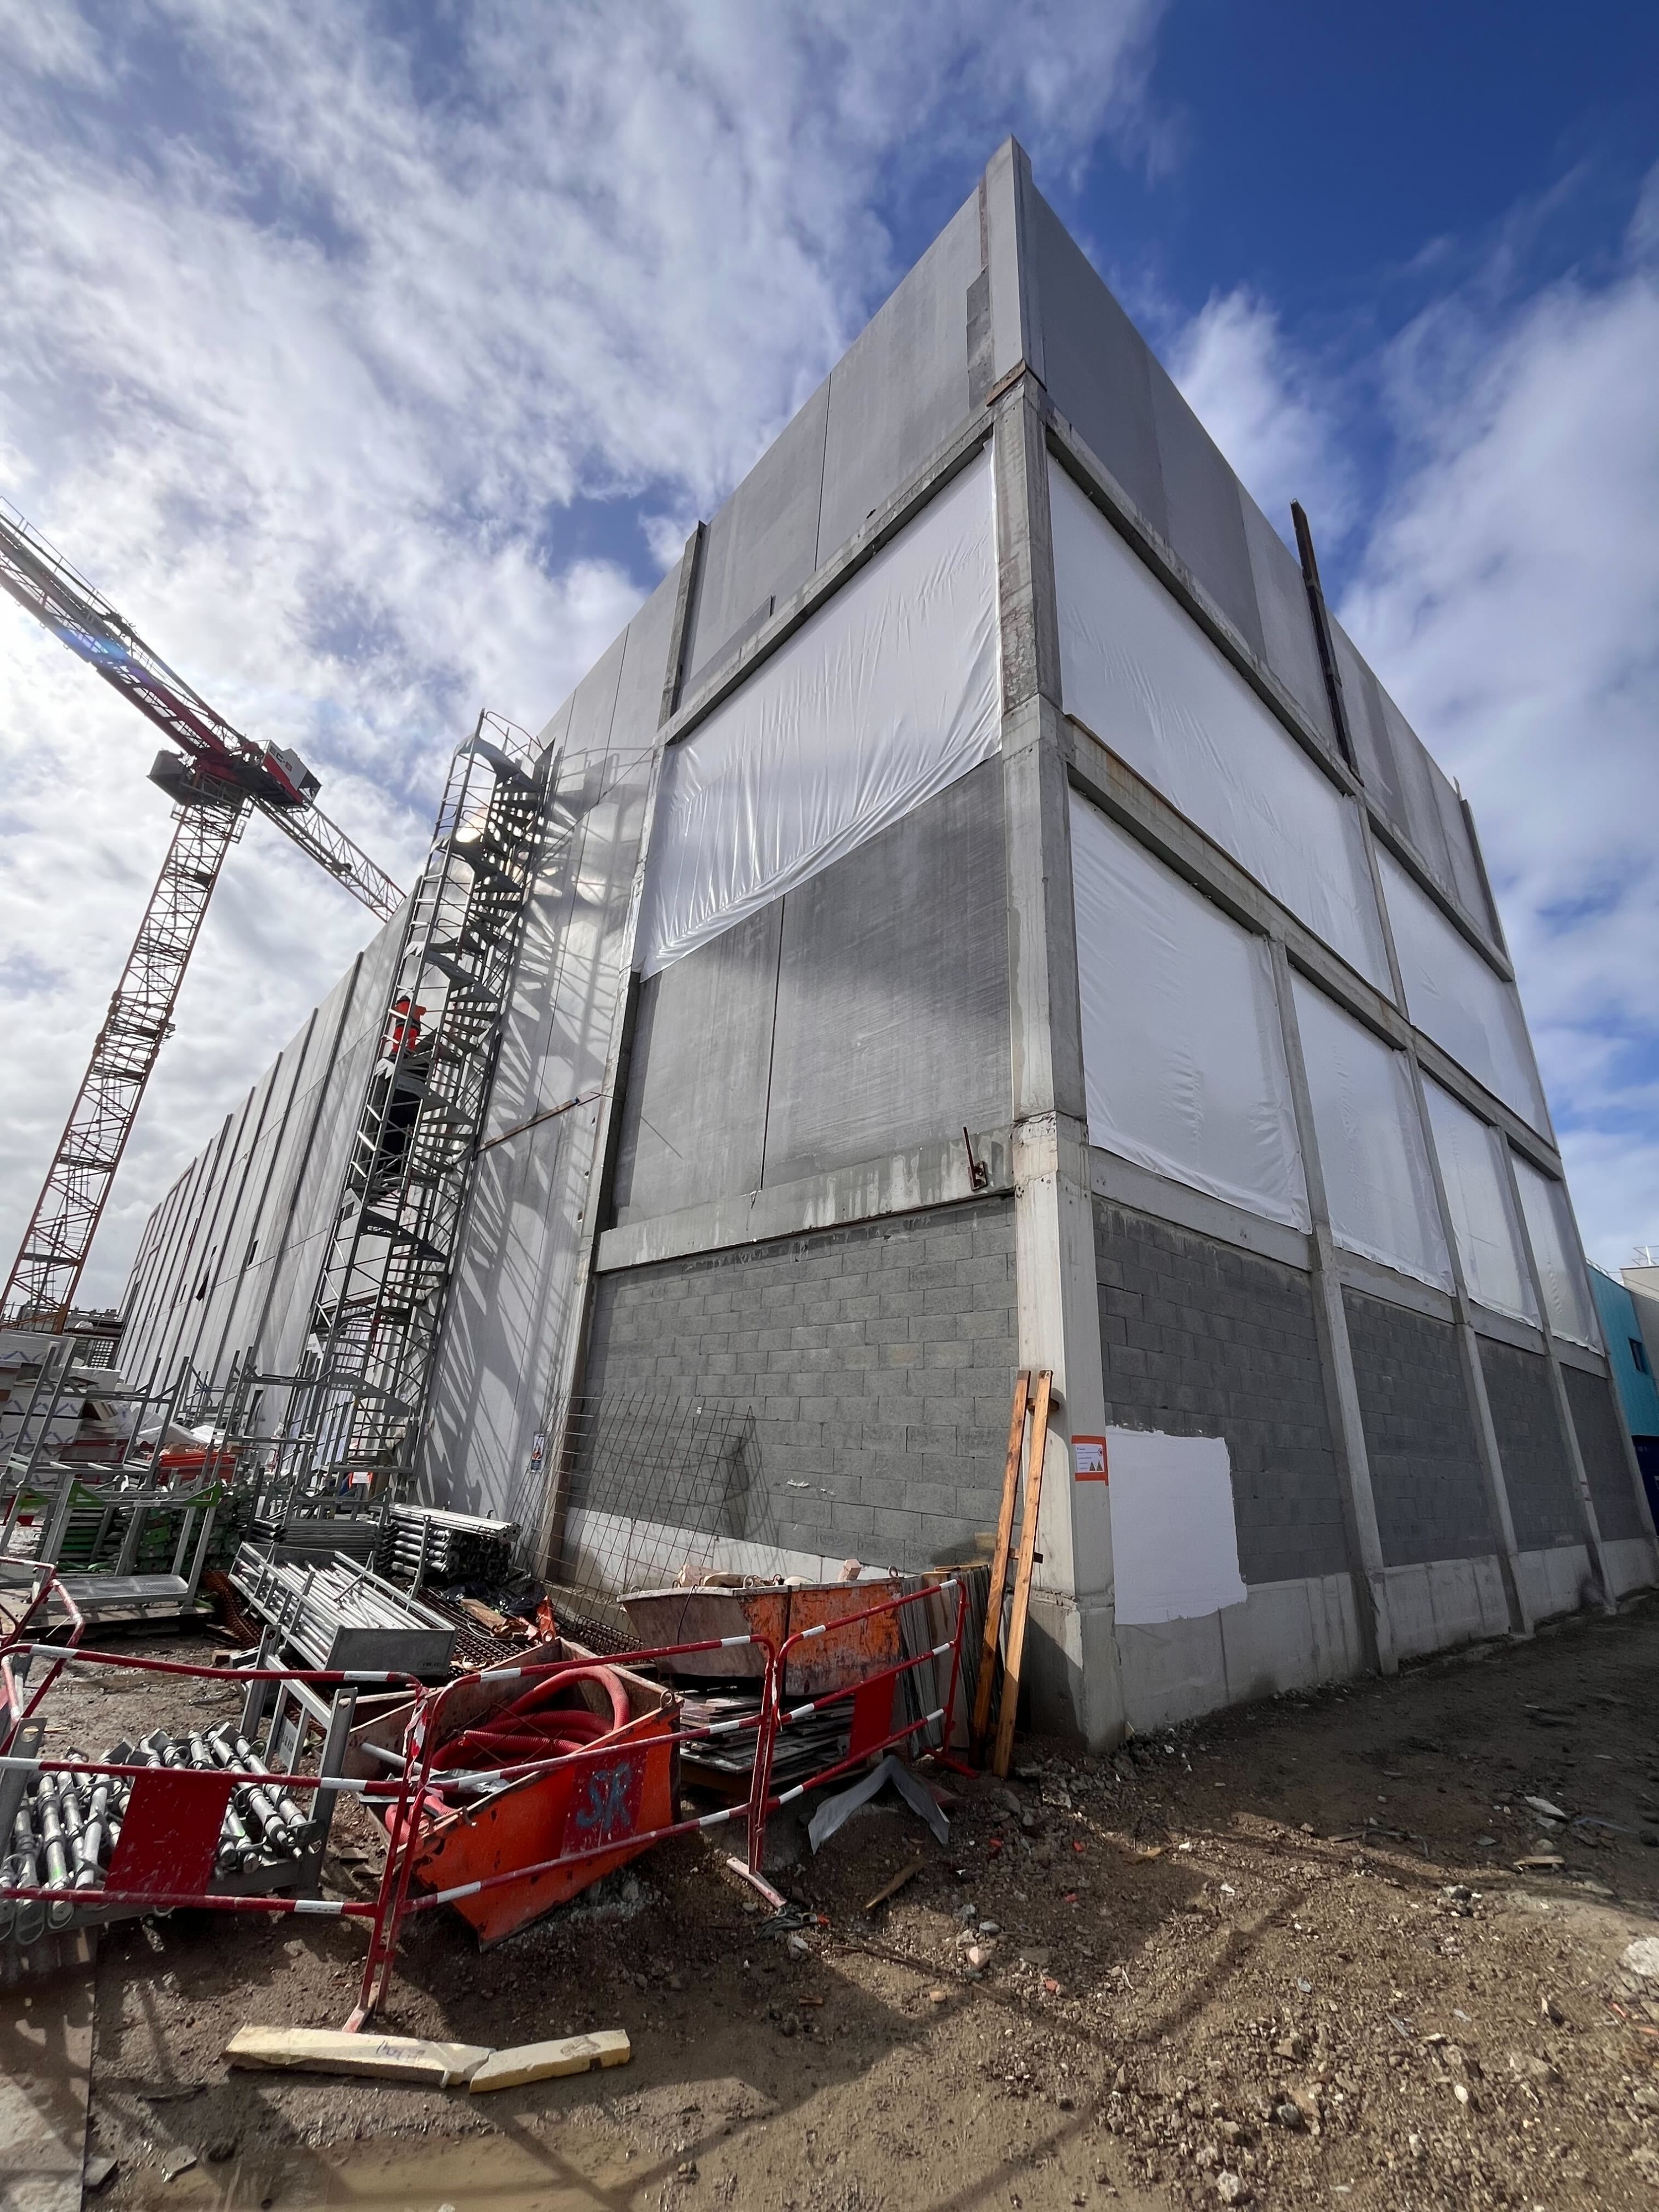
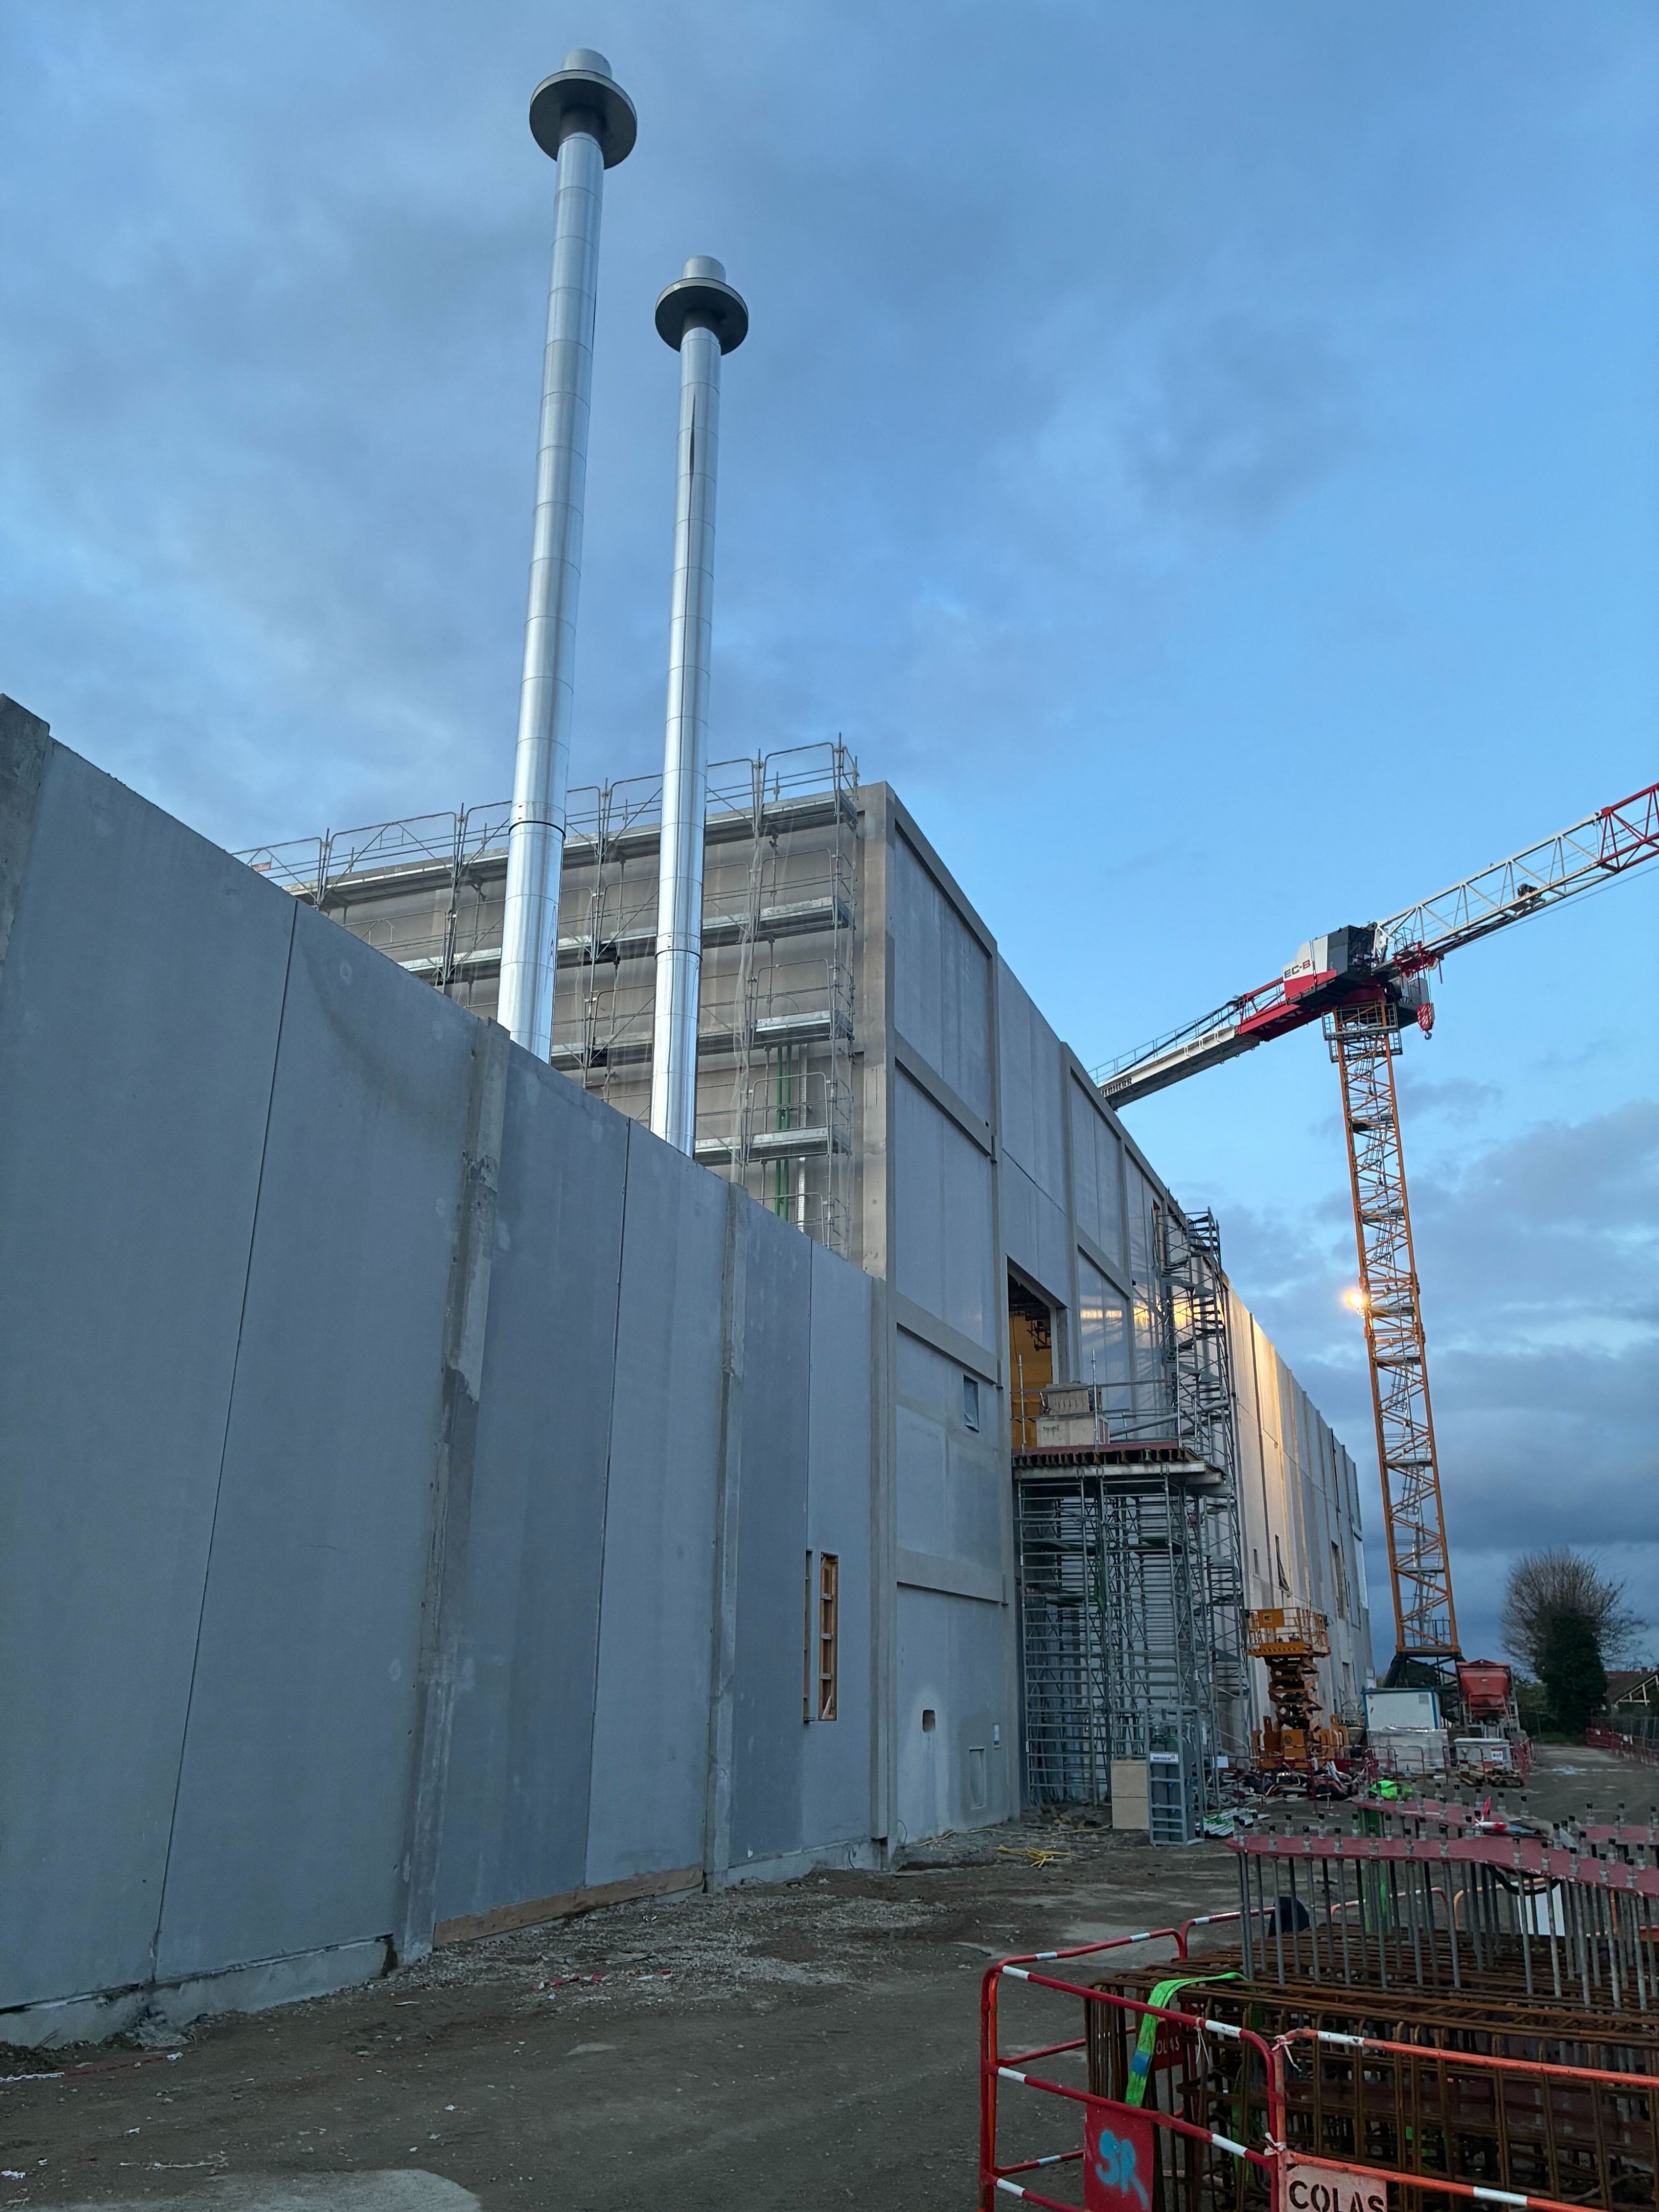
Расширение на 7,1 МВт для DC3 в Витри-сюр-Сен

Расширение на 7,1 МВт для DC3 в Витри-сюр-Сен, нашего исторического флагманского дата-центра. Первый в длинной серии, основанный на совершенно новом концепте, придуманном 2 года назад с моими командами, изначально DLC, высокой плотности и масштабируемый по требованию.


Что выбрать для сервера, EPYC или Ryzen?


Клиенты хостинга условно делятся на две группы. Одни приходят с готовым техническим заданием, знают, какой процессор им нужен и почему. Другие только начинают свой путь и смотрят на витрину с легким недоумением. У второй группы часто возникает один и тот же вопрос. Почему две конфигурации с похожей оперативной памятью, дисками и сетью отличаются по цене примерно на 5000 рублей в месяц, и единственное видимое различие там — процессор.

Например, рассмотрим пример из нашей линейки. Ryzen 9950X с его 16 ядрами, частотой до 5,7 ГГц по спецификации производителя и TDP 170 Вт обойдётся в 18 480 рублей в месяц (221 760 рублей в год). Рядом расположился EPYC 9354 с 32 ядрами, частотой до 3,8 ГГц и TDP 280 Вт за 23 760 рублей в месяц (285 120 рублей в год). У первого частота выше почти в полтора раза, а цена при этом ниже. У второго вдвое больше ядер и серверная архитектура. По одной лишь таблице характеристик невозможно сказать, какой из них «быстрее», т. к. ответ зависит от задач, которые на нем будут выполнять.

Нам стало интересно посмотреть на это не в формате «теоретически EPYC лучше для серверов, потому что он серверный». Хотелось получить цифры с обеих машин в идентичных условиях. Мы прогнали обе ноды через одинаковый набор из 25 тестов. Туда вошли синтетика на центральный процессор, OpenSSL, STREAM по памяти, fio по дискам, pgbench, Redis, nginx, multi-tenant сценарий с десятью параллельными нагрузками и 30-минутный термальный стресс. Дальше по разделам разберем, где Ryzen реально впереди, где он проигрывает, и в каких случаях разница в 5 с лишним тысяч рублей в месяц окупается.

Конфигурация тестовых машин
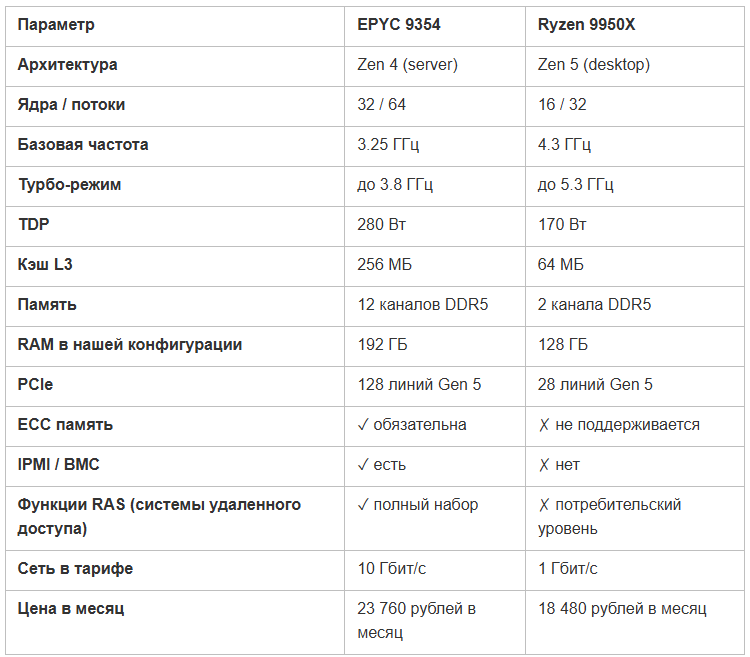
Перед тем как переходить к результатам тестирования, нужно зафиксировать, что именно сравнивается. Два сервера разной архитектуры, и почти все различия в дальнейших тестах объясняются именно тем, что записано в таблице ниже.


По первым двум строкам уже понятно, что мы увидим в тестах. Микроархитектура Zen 5 у Ryzen 9950X новее, IPC и частоты выше, поэтому в однопоточных задачах он впереди. В многопоточных всё решает количество ядер, а тут их 32 против 16. Там, где нагрузка упирается в память, играют роль 12 каналов DDR5 против 2.

Дисковая подсистема в сравнении не участвует. На двух стендах стояли накопители NVMe разной ёмкости и поколений, поэтому результаты fio между машинами некорректны. Все цифры в статье относятся к процессору и памяти.

На стенде с Ryzen 9950X одновременная многопоточность (SMT, Simultaneous Multithreading) недоступна на уровне платформы. Контроллер процессора возвращает статус not supported, и процессор работает в режиме 16 потоков на 16 ядрах. Это не временная настройка для тестов, а штатная конфигурация, в которой сервер передаётся клиенту. Условия обслуживания запрещают любые изменения в BIOS, поэтому ситуация для всех арендаторов будет одинаковой. У EPYC многопоточность включена, что даёт 64 потока на 32 ядрах. Этот момент важно держать в голове при чтении многопоточных тестов ниже, поскольку цифры Ryzen в них отражают именно ту производительность, которую получит реальный клиент, а не теоретический потолок процессора в лабораторных условиях.

Где Ryzen быстрее и почему
В сравнении двух процессоров есть сценарии, где Ryzen 9950X показывает результат лучше. Посмотрим, на каких именно тестах это произошло и насколько эти цифры переносятся на реальную нагрузку в продуктовой среде.

Однопоточная производительность
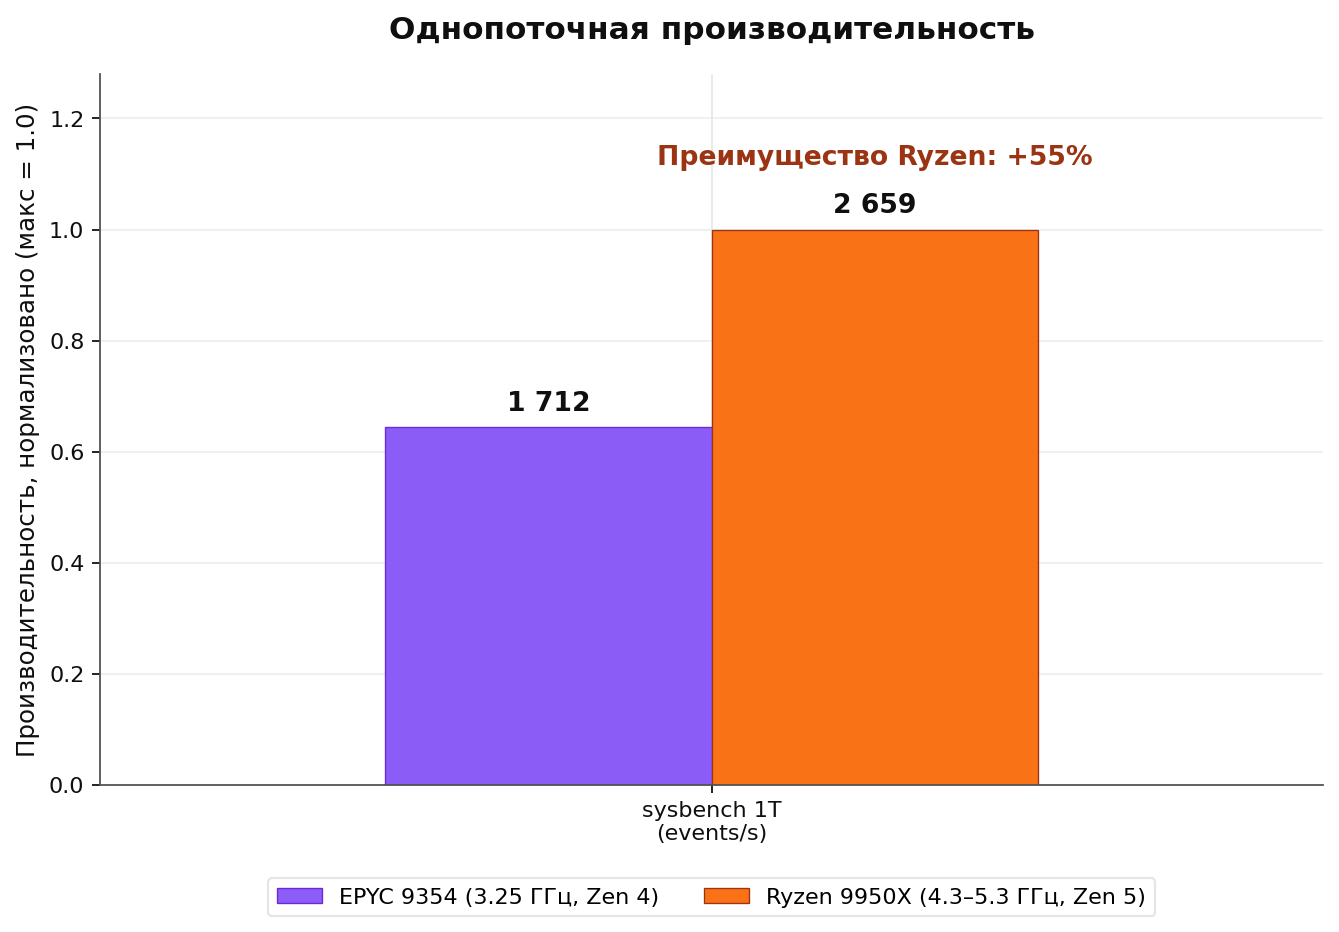
Тест Sysbench в один поток показывает, насколько быстро одно ядро успевает прокрутить заданный набор операций. Ничего постороннего в работу не вмешивается, нет ни конкуренции за память, ни блокировок.


Разрыв Ryzen относительно EPYC составляет около 55%. Объясняется он сочетанием двух факторов: частоты и поколения архитектуры. У Ryzen 9950X базовая частота 4,3 ГГц, тогда как у EPYC она 3,25 ГГц. К этому добавляется архитектура Zen 5 с заметно подросшим количеством инструкций, выполняемых за такт (IPC), относительно Zen 4.

Понять, где эта разница имеет значение на практике, несложно. Она даёт о себе знать в любой задаче, где узким местом становится один поток. Самый частый случай — это Node.js до того момента, как процессы разведены через кластер. Сюда же относятся скрипты на командной оболочке Bash, обработка данных на языке программирования Python без распараллеливания, а также компиляция небольших модулей, где параллелизм просто негде взять. На подобных сценариях разница в 55% будет хорошо ощущаться.

nginx и Redis, потолок процессора без сетевых ограничений
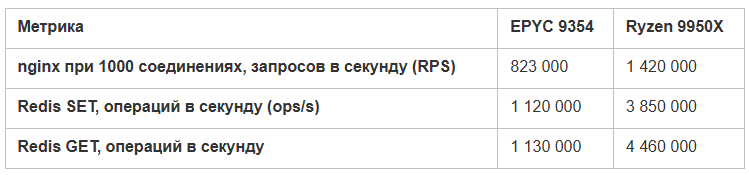
Приведённые ниже цифры требуют небольшого предварительного пояснения. Они показывают теоретический максимум процессора при идеальных условиях, без участия физической сети, и в реальной эксплуатации картина будет совсем другой. Подробно про это ниже, но сразу зафиксируем рамку, чтобы абсолютные значения никого не вводили в заблуждение.


Разрыв в пользу Ryzen на веб-сервере nginx составил около 72%, на операции записи Redis SET почти в три раза, а на операции чтения Redis GET почти в четыре. Выглядит внушительно. Тут стоит остановиться и проговорить, что именно эти цифры измеряют, а что нет.

Оба теста проводились по петле обратной связи (loopback, адрес 127.0.0.1), т. е. клиент и сервер живут на одном хосте, а пакет не уходит в сетевой стек дальше виртуального интерфейса. Таким образом измеряется верхний потолок самого приложения и процессора, насколько быстро nginx или хранилище данных Redis способны принять и отдать ответ при полном отсутствии сетевых задержек.

В реальной нагрузке картина выглядит иначе. В продуктовой среде Redis и nginx обслуживают клиентов по сети, что накладывает физические ограничения. В нашем тарифе Ryzen 9950X идёт с сетью 1 гигабит в секунду, а у EPYC 9354 в той же позиции стоит сеть 10 гигабит. Если перевести в более привычные единицы, 1 гигабит в секунду даёт около 125 мегабайт пропускной способности в секунду, и из этого еще нужно вычесть накладные расходы на заголовки протокола передачи данных (TCP), заголовки протокола передачи гипертекста (HTTP) и сам запрос. Фактический потолок окажется где-то в 2–3 раза ниже теоретического.

Размер ответа в этом сценарии становится определяющим. На крошечных ответах в 100 байт Ryzen может приблизиться к loopback-цифре, поскольку сеть в 1 Гбит/с такие запросы пропускает в большом количестве. На типичных ответах HTTP размером 1–10 килобайт потолок по сети будет в районе 12–125 тысяч запросов в секунду, и здесь Ryzen упрётся в сеть задолго до того, как упрётся в процессор. У EPYC сетевой потолок выше в десять раз.

Это вовсе не означает, что loopback-цифры бесполезны. Они показывают реальную производительность центрального процессора (CPU) на этой задаче, и если завтра поставить ту же машину в сеть 10 Гбит/с, потолок самого процессора останется прежним. Просто эти цифры отвечают на вопрос «сколько способен выжать процессор», а не на вопрос «сколько запросов реально дойдёт до клиентов».

Картина складывается следующая. Однопоточные задачи и тесты без сетевого упора — это действительно сильная сторона Ryzen, и тут он быстрее по вполне объяснимым причинам. Дальше в статье речь пойдёт о сценариях, где картина меняется. Это многопоточная нагрузка, упор в память и длительная работа под высокой температурой.

Где EPYC показывает себя лучше
В предыдущем разделе мы разобрали сценарии, в которых Ryzen 9950X выходит вперёд. Теперь же перейдём к тестам, где картина выглядит иначе. Перед тем как переходить к цифрам, стоит напомнить одну важную деталь конфигурации. На стенде с Ryzen одновременная многопоточность (SMT) недоступна на уровне платформы, и центральный процессор (CPU) видит 16 потоков на 16 ядрах вместо потенциальных 32. У EPYC многопоточность включена, что даёт 64 потока на 32 ядрах. На некоторые из тестов ниже это влияет напрямую, и цифры Ryzen в них отражают реальный результат для конечного клиента, а не лабораторный максимум.

Пропускная способность памяти, тест STREAM
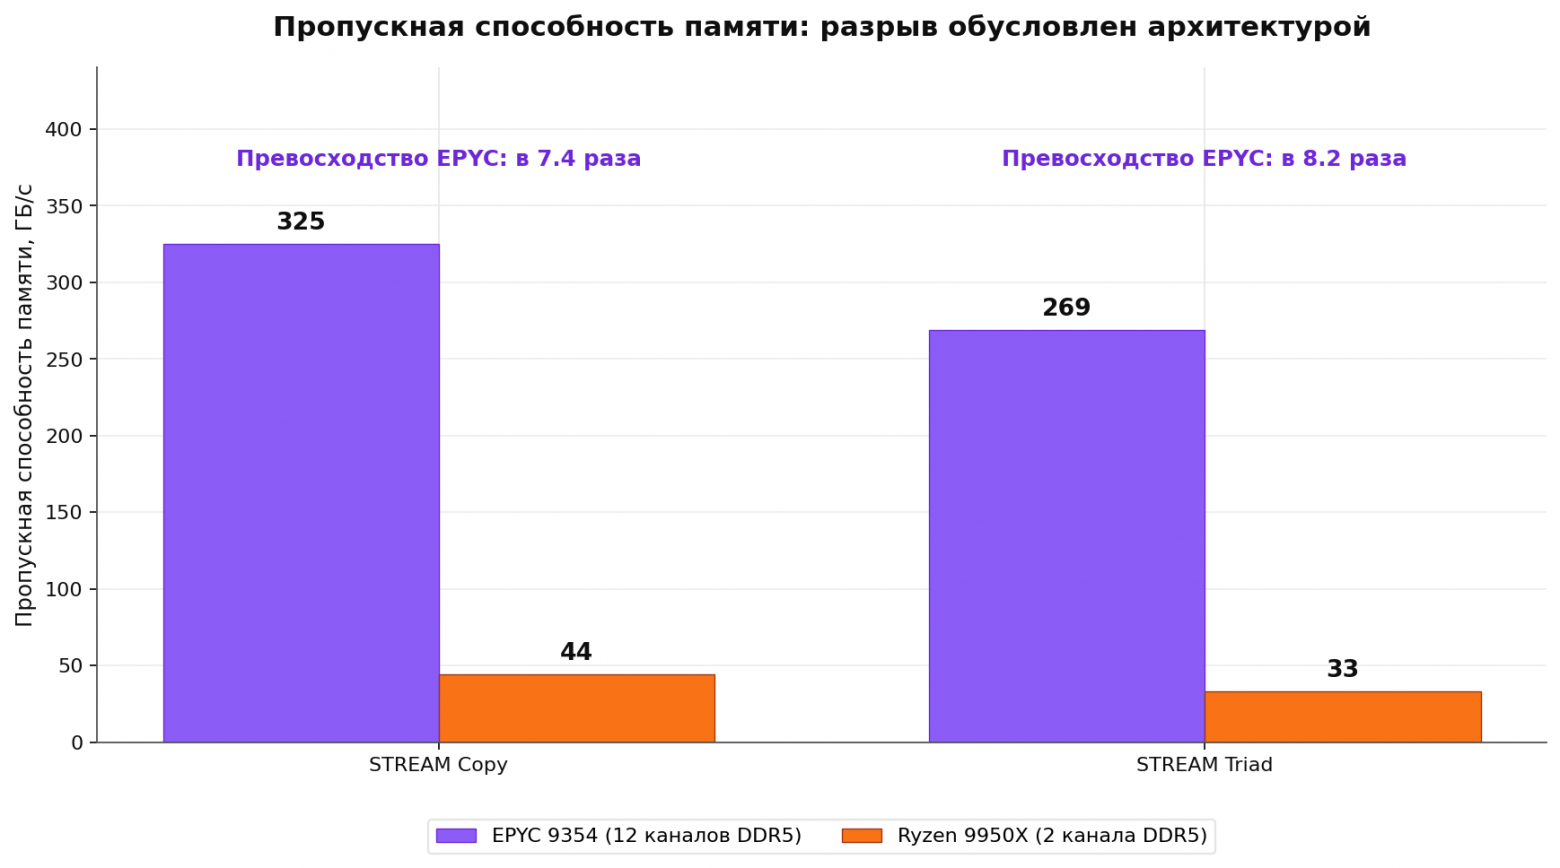
Это самый показательный по разрыву тест из всей подборки. STREAM измеряет, насколько быстро процессор и подсистема памяти умеют перекачивать данные. Это не синтетика ради синтетики, она напрямую коррелирует с производительностью всего, что упирается в оперативную память.


Разрыв здесь составляет примерно 7–8 раз. Причина кроется не в настройке или прошивке, а в самой архитектуре. У EPYC 9354 предусмотрено 12 каналов памяти DDR5, тогда как у Ryzen 9950X их всего 2. Получается шесть каналов друг против друга, каждый со своей шиной. Подобное соотношение не оптимизируется ни драйверами, ни ядром, поскольку это плата с разводкой под двенадцать слотов оперативной памяти против платы с разводкой под четыре слота. Многопоточность здесь ни при чём, ведь в STREAM упор идёт не в потоки, а в пропускную способность.

На практике это означает следующее. Любая нагрузка, в которой данные не помещаются в кэш и постоянно ходят между ядрами и памятью, на EPYC будет работать заметно быстрее. К типичным примерам относятся базы данных, работающие в оперативной памяти (in-memory), такие как Redis при большом объёме данных и Memcached, а также аналитические запросы по большому объёму данных, вывод моделей машинного обучения (inference) на процессоре и любые приложения, оптимизированные под архитектуру памяти с неравномерным доступом (NUMA).

В разделе про nginx и Redis на петле обратной связи мы видели обратную картину, там Ryzen был впереди в несколько раз. Никакого противоречия здесь нет, просто речь идёт о двух разных режимах работы. Redis в loopback-тестах гоняет короткие операции на маленьких ключах, всё помещается в кэш процессора, и частота оказывается важнее пропускной способности. Как только объем данных вырастает за пределы кэша третьего уровня (L3), а это 256 МБ у EPYC против 64 МБ у Ryzen, или нагрузка становится по-настоящему параллельной, узким местом становится память, и расстановка сил меняется.

Многопоточная нагрузка на процессор
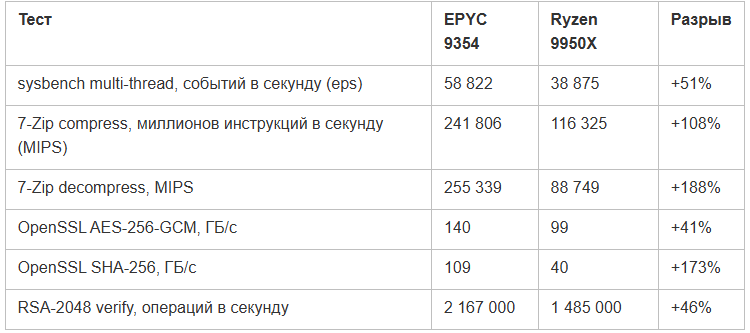
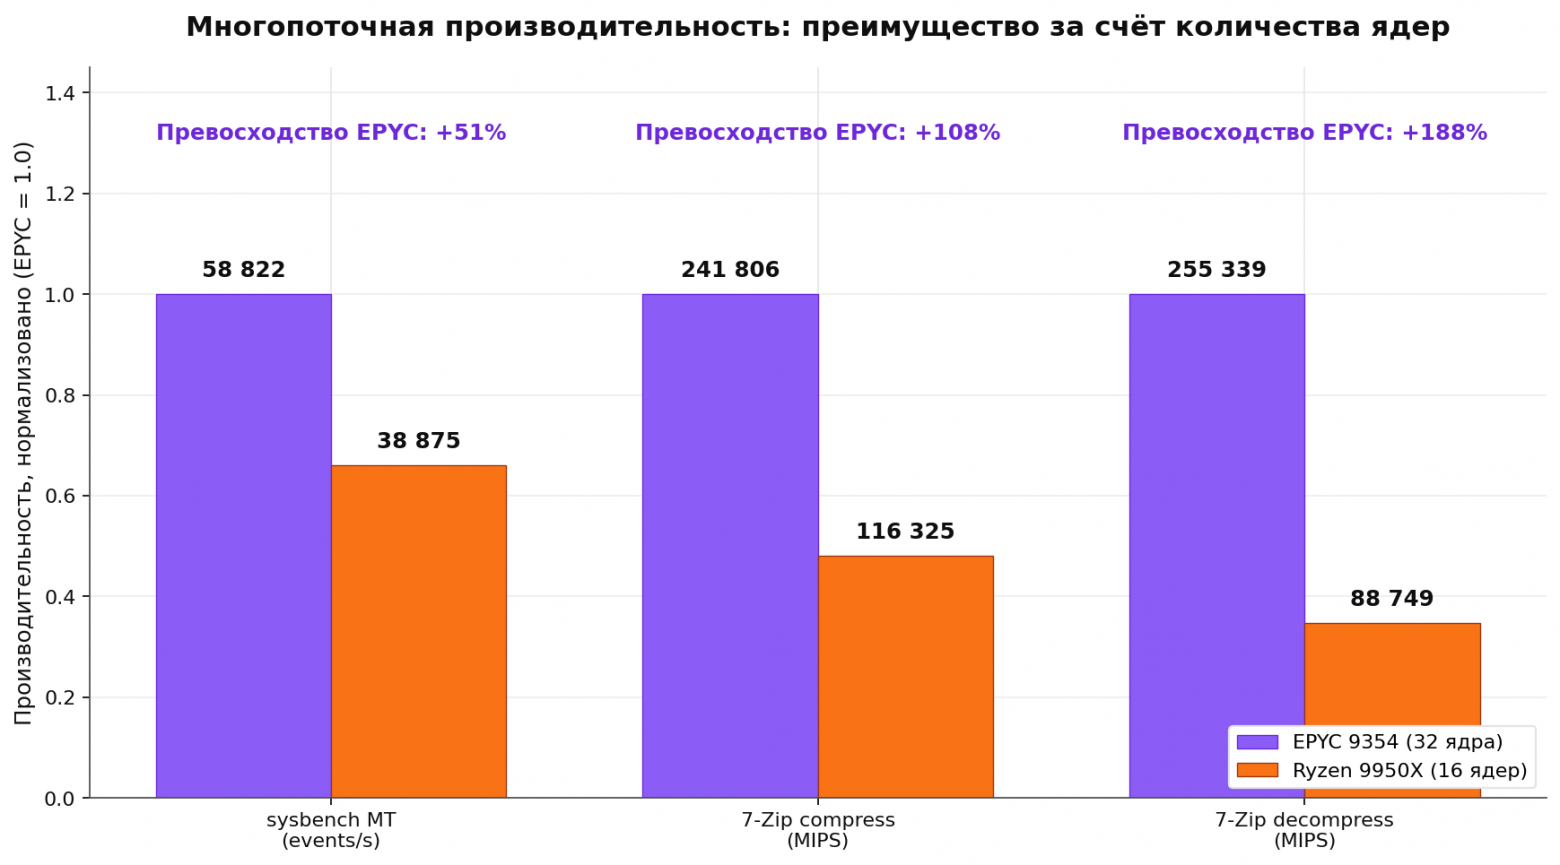
Здесь ситуация ожидаемая. Когда задача параллелится по ядрам, 32 ядра EPYC дают преимущество над 16 ядрами Ryzen.


Здесь самое время вернуться к разговору про одновременную многопоточность (SMT). Эти тесты как раз из тех, на которые её отсутствие влияет напрямую. Поскольку на стенде с Ryzen многопоточность недоступна на уровне платформы, цифры в таблице отражают именно тот результат, который получит арендатор сервера. Никакого «теоретического потолка с включённым SMT» в реальной эксплуатации не будет, поскольку условия обслуживания запрещают вмешиваться в настройки прошивки. Поэтому разрыв с EPYC, который виден в таблице выше, это не методологическая поправка, а та самая разница, с которой клиенту предстоит работать. EPYC выходит вперёд в многопоточных нагрузках за счёт удвоенного количества физических ядер и за счёт того, что использует свою многопоточность в полной мере.

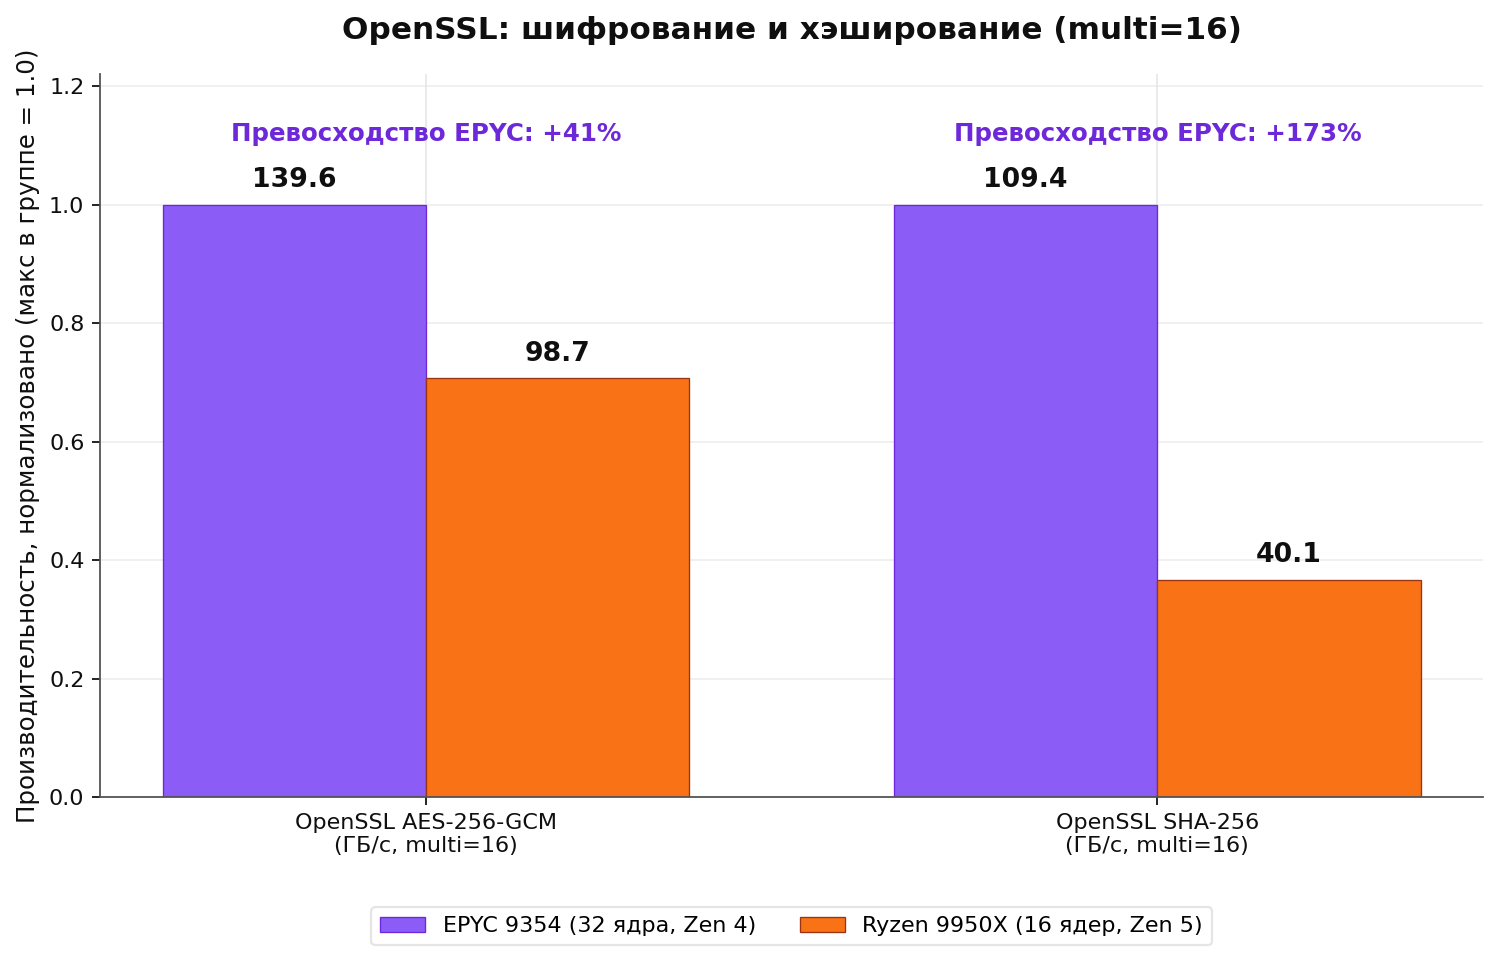
Отдельно стоит остановиться на тесте OpenSSL SHA-256, где EPYC опережает Ryzen на 173%. Эта цифра аномально велика даже с учётом разницы 32 ядер против 16. Причина кроется в специализированных аппаратных инструкциях SHA-NI. У EPYC их вдвое больше просто за счёт количества ядер, и каждая такая инструкция считает блок SHA-256 за один такт. Получается, что на хэшировании разница в ядрах транслируется в производительность почти линейно. На алгоритме AES-GCM похожая инструкция AES-NI тоже присутствует на обоих процессорах, но там разрыв скромнее (+41%), поскольку упор смещен в сторону частоты.


Понять, где это имеет значение, несложно. На веб-серверах с большим количеством рукопожатий по протоколу защищённой передачи данных (TLS) основная нагрузка приходится именно на хэш-функции и асимметричное шифрование при установке соединения. На задачах архивирования и распаковки, при компиляции больших проектов, а также на любых фоновых задачах, которые распараллеливаются по ядрам, разница между двумя процессорами вырастает в полтора-три раза.

PostgreSQL под параллельной нагрузкой
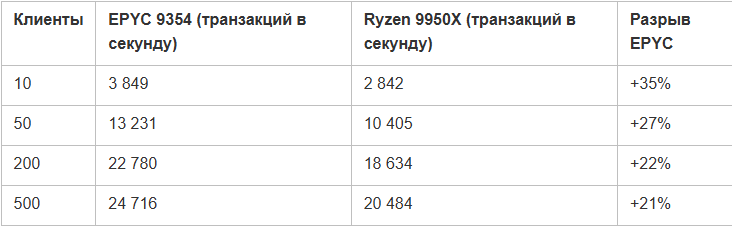
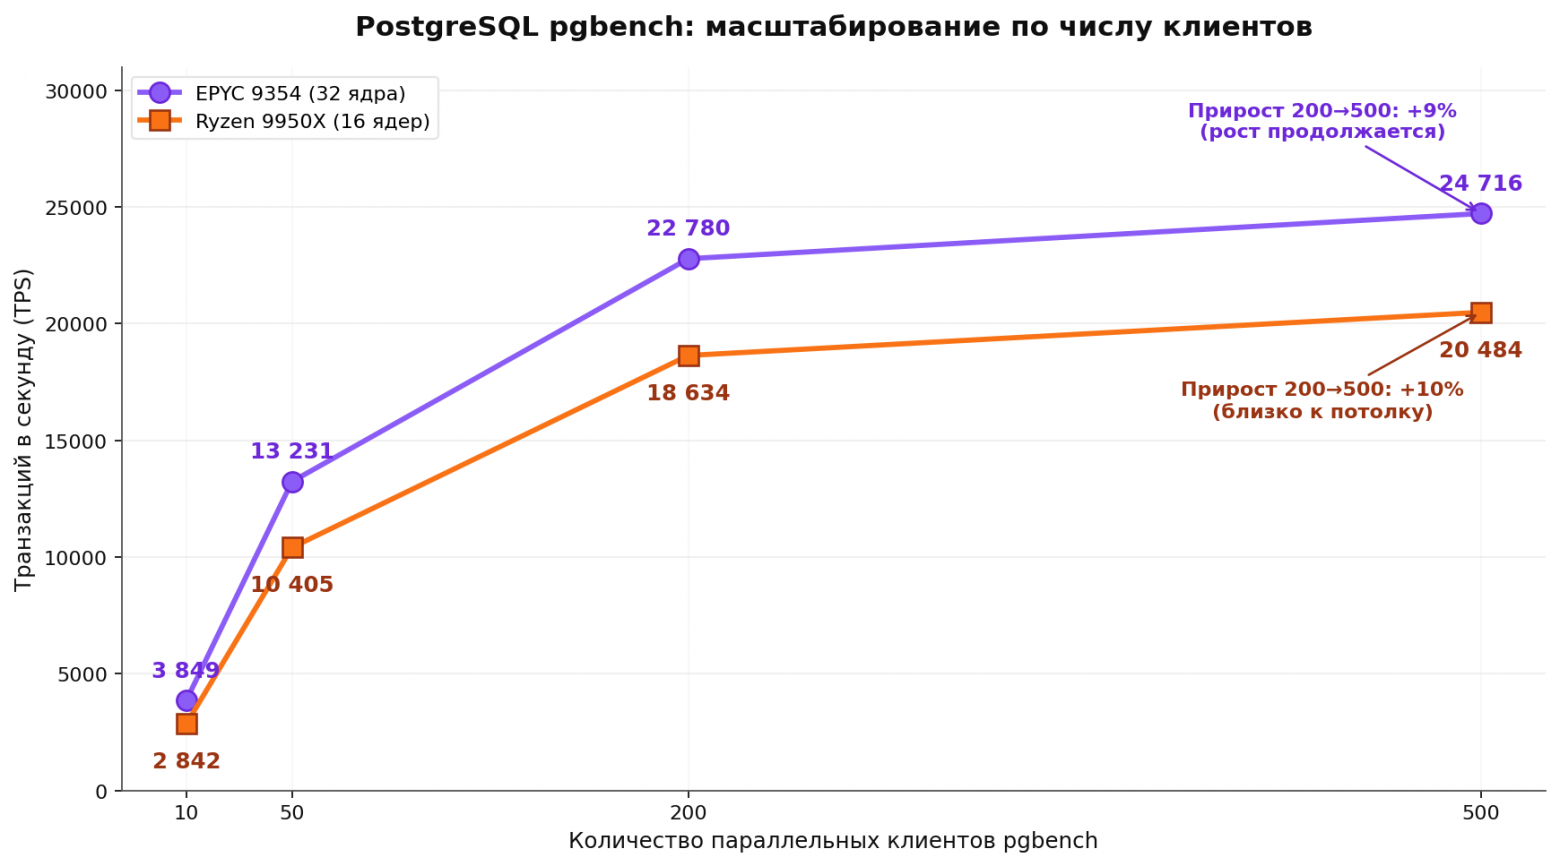
Этот тест кажется мне наиболее интересным с точки зрения того, что обычно крутится на арендованных серверах. Запускали мы инструмент pgbench с нагрузкой, подобной TPC-B (стандартный синтетический бенчмарк для операций оперативной обработки транзакций, OLTP), с масштабным коэффициентом 100. Измеряли количество транзакций в секунду (TPS) при разном числе одновременных клиентов.


На небольшом числе клиентов разница составляет около 30%, и она вполне объяснима разницей в частотах и объёме кэша. Куда интереснее посмотреть на то, как ведут себя кривые при росте нагрузки. На промежутке от 200 до 500 клиентов EPYC даёт прирост с 22 780 до 24 716 транзакций в секунду, и его кривая всё ещё идёт вверх. Ryzen за тот же промежуток вырос с 18 634 до 20 484 транзакций в секунду, однако каждый следующий шаг даётся ему всё тяжелее, и кривая визуально начинает выходить на плато.

Здесь стоит быть осторожным с выводами. У нас всего четыре точки, и любые рассуждения о том, как поведёт себя нагрузка на 1000 клиентах, остаются в области предположений. Если экстраполировать тренд, Ryzen упрётся в потолок раньше, чем EPYC, и разрыв на больших количествах подключений будет расти, но это всего лишь предположение, а не измерение. Чтобы проверить его, нужен прогон на 1000 и 2000 клиентов, и пока такого замера нет, цифры в таблице выше остаются всем, что у нас есть.

Стоит ещё раз вспомнить про одновременную многопоточность (SMT). На инструменте pgbench, особенно при большом числе клиентов, многопоточность вносит ощутимый вклад, поскольку каждое соединение системы управления базами данных PostgreSQL живёт в своём процессе, и физических ядер на всех попросту не хватает. На стенде с Ryzen многопоточность недоступна на уровне платформы, поэтому цифры при 200 и 500 клиентах отражают именно то, что получит арендатор, без всяких теоретических поправок. Это и есть реальная картина для тарифа, а не лабораторный замер с условиями, до которых клиент дотянуться не сможет.

Несколько клиентов на одной машине
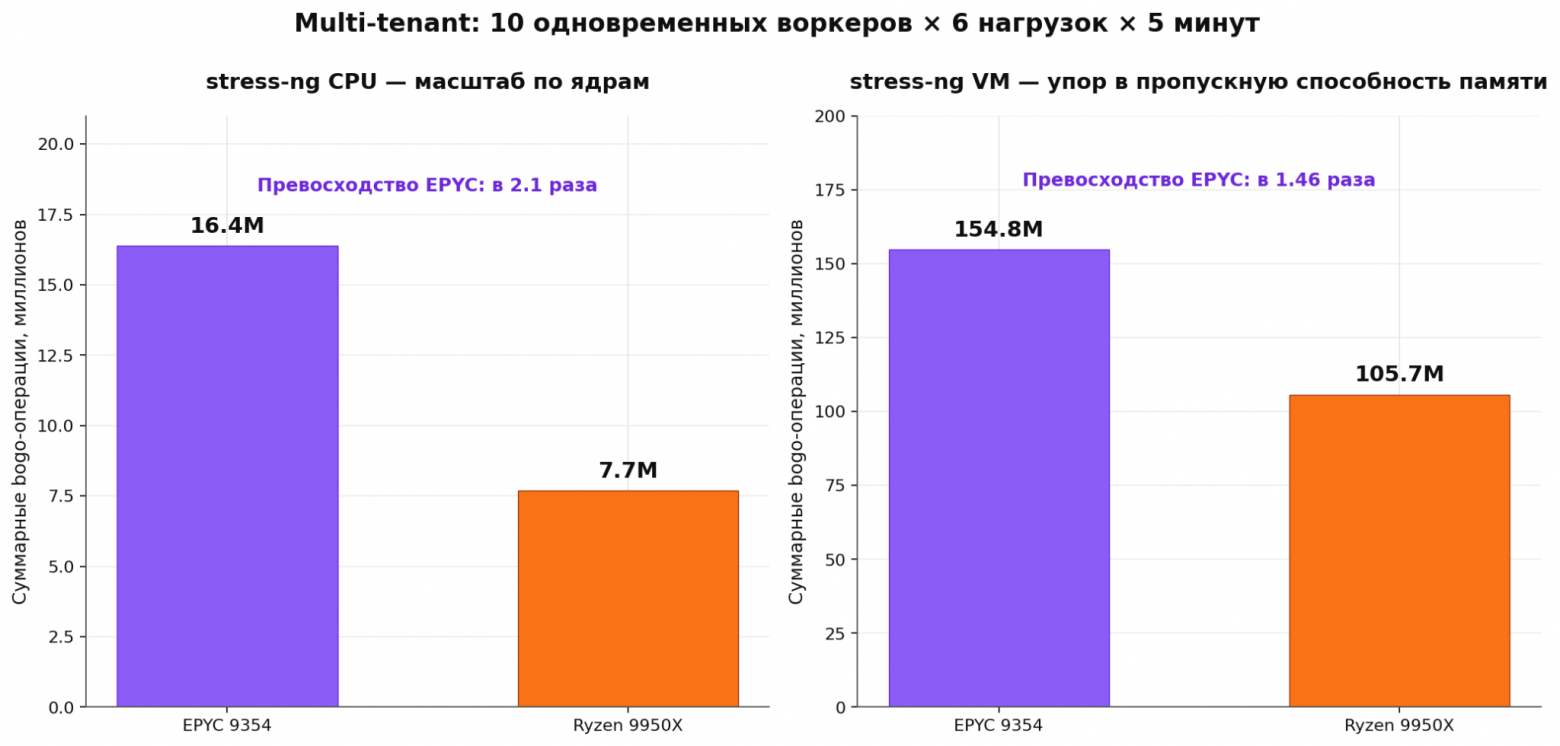
Этот сценарий для хостинга оказывается куда важнее многих синтетических тестов. На одной физической машине обычно живет не одно приложение, а несколько клиентов с разными нагрузками. Чтобы прикинуть, как процессор ведёт себя в подобной ситуации, мы запустили утилиту stress-ng в десять параллельных рабочих процессов (воркеров), у каждого из которых было по четыре нагружающих модуля на центральный процессор и два на оперативную память, а общая длительность теста составила пять минут.


Здесь видны сразу две вещи. На чисто процессорной нагрузке EPYC даёт ровно двукратный отрыв (×2,1), что точно соответствует двойному количеству ядер, и нагрузка масштабируется почти линейно. На модулях, которые гоняют оперативную память, картина выглядит иначе, отрыв составляет ×1,46. Узкое место смещается с процессора на пропускную способность памяти, и здесь уже двенадцать каналов DDR5 у EPYC играют большую роль, чем количество ядер.

Двукратный отрыв EPYC по процессорной метрике, как и в предыдущих тестах, отражает реальное соотношение для арендатора с учётом того, что многопоточность на Ryzen-стенде недоступна. Сама же форма картины, а именно линейное масштабирование на процессоре и упор в память на нагрузках с оперативной памятью, от настроек не зависит и определяется архитектурой.

Серверные функции, которых у Ryzen нет на уровне архитектуры
Речь дальше пойдёт не о производительности, а о наборе серверных функций, которых у Ryzen 9950X либо нет совсем, либо они присутствуют в урезанном виде. Об этом стоит сказать отдельно, поскольку в технической документации производителя такие различия часто скрываются за общими формулировками.

Память с коррекцией ошибок (ECC). Аббревиатура ECC расшифровывается как Error-Correcting Code и означает, что модули памяти умеют обнаруживать и исправлять одиночные битовые ошибки на лету. Ryzen 9950X ее формально поддерживает, но только в режиме UDIMM-ECC и только на тех платах, где производитель сделал соответствующую разводку. На большинстве потребительских материнских плат поддержки нет вовсе или она работает в усеченном режиме. У EPYC память с коррекцией обязательна, без неё процессор просто не запустится. Аппаратно обрабатываются как одиночные (SBE), так и двойные битовые ошибки (DBE). Что это значит на практике. Если в оперативной памяти случайно перевернется бит (а это случается, особенно при длительной работе и высокой плотности модулей), на EPYC ошибка будет либо исправлена прозрачно, либо залогирована. На Ryzen без ECC ошибка пройдёт незамеченной и может проявиться, например, как испорченные данные в базе.

Набор RAS-функций. Reliability, Availability, Serviceability, или функции надежности, доступности и обслуживаемости. На EPYC это около тридцати разных механизмов. Machine Check Architecture (MCA) с автоматическим восстановлением, platform security processor (PSP) для отдельной обработки уязвимостей, propagation бита «отравленных» данных через подсистему памяти, аппаратный вывод поврежденных страниц памяти из эксплуатации без участия операционной системы. На Ryzen большинство этих механизмов либо отсутствует, либо реализовано в потребительском объёме.

Удалённое управление (IPMI и BMC). На серверных платах под EPYC стоит отдельная микросхема BMC (Baseboard Management Controller), которая работает независимо от основного процессора и операционной системы. Через интерфейс IPMI (Intelligent Platform Management Interface) к ней можно подключиться по сети, увидеть процесс загрузки, перезагрузить машину, перепрошить BIOS, посмотреть температуру и состояние датчиков, даже когда основная система зависла или не загружается. На потребительских платах под Ryzen такой микросхемы нет. В случае зависания сервера у администратора остаётся вариант с физическим визитом в центр обработки данных.

Линии PCIe. У EPYC 9354 их 128 версии 5.0, у Ryzen 9950X — 28, причем примерно половина из этого числа уходит на чипсет и встроенную периферию. Для одного-двух NVMe-накопителей и одной сетевой карты Ryzen достаточно. Для конфигурации с RAID-массивом из четырёх и более NVMe, отдельной 100-гигабитной сетевой карты, плюс графическим ускорителем — линий просто не хватит, и встанет выбор, что подключить, а что нет.

Если суммировать, набор отличий выше делает EPYC более предсказуемым в эксплуатации. На стороне хостера это переводится в более раннее обнаружение проблем (через ECC, RAS-механизмы, удалённое управление) и в более широкие возможности по подключению периферии. На Ryzen многие из этих сценариев либо невозможны, либо требуют компромиссов.

Температурный режим под длительной нагрузкой
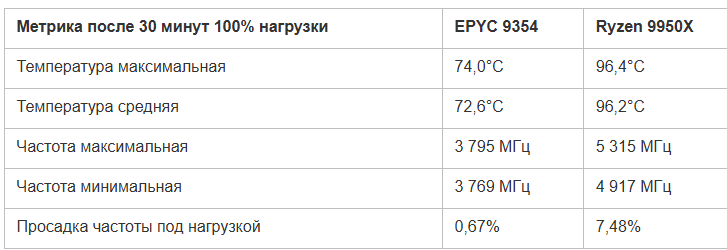
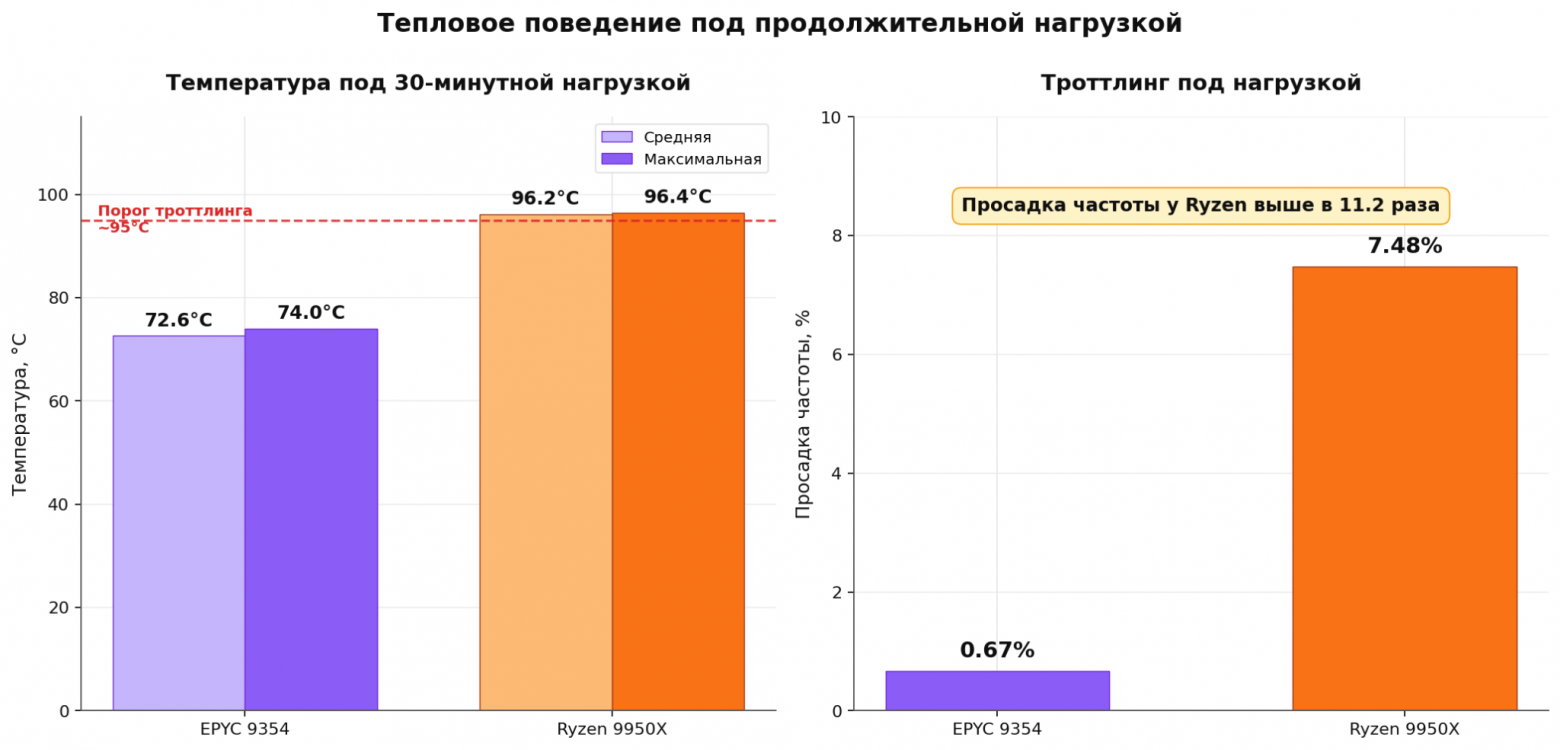
Один из менее очевидных результатов теста касается уже не производительности, а температурного поведения. Ryzen 9950X в стандартном серверном шасси без жидкостного охлаждения под продолжительной стопроцентной нагрузкой выходит на температуру 96°C.


Один из менее очевидных результатов теста касается уже не производительности, а температурного поведения. Ryzen 9950X в стандартном серверном шасси без жидкостного охлаждения под продолжительной стопроцентной нагрузкой выходит на температуру 96°C.

Сам по себе Ryzen 9950X спроектирован под настольный сценарий с массивным воздушным или жидкостным охлаждением, и в такой системе он способен длительное время держать частоты выше пяти гигагерц. Однако серверное шасси высотой 1U или 2U физически не вмещает большой кулер, и в нём используются вентиляторы ограниченных размеров с высокой частотой вращения. В этой конфигурации Ryzen упирается в свою предельную температуру перехода Tjmax, которая по технической документации составляет 95°C, и начинает снижать частоту, теряя около 7%.

EPYC 9354 спроектирован под тепловыделение (TDP) 280 Вт именно с расчётом на серверное охлаждение. В тех же условиях он держится в районе 72–74°C, что заметно ниже его предельной температуры, а просадка по частоте остаётся в пределах 1%.

За цифрами в таблице стоит несколько вполне ощутимых последствий. На сервере с Ryzen под продолжительной нагрузкой вентиляторы работают на максимальных оборотах, а это увеличивает их износ и шум. Заявленные в маркетинговых материалах частоты до 5,7 ГГц достижимы только в настольной системе, тогда как в серверной нагрузка стабилизируется на отметке порядка 4,9 ГГц. Производитель допускает работу процессора вплоть до Tjmax, и сам по себе режим в 96°C не является аварийным. Однако работа на постоянной близости к этой границе оставляет минимальный запас на пиковые нагрузки, колебания температуры в стойке и постепенное ухудшение теплоотвода по мере накопления пыли в радиаторах. В долгосрочной перспективе это означает более раннюю необходимость профилактики, чем у процессора, который штатно работает на 70–75°C.

Когда переплата за EPYC оправдана, а когда выгоднее Ryzen
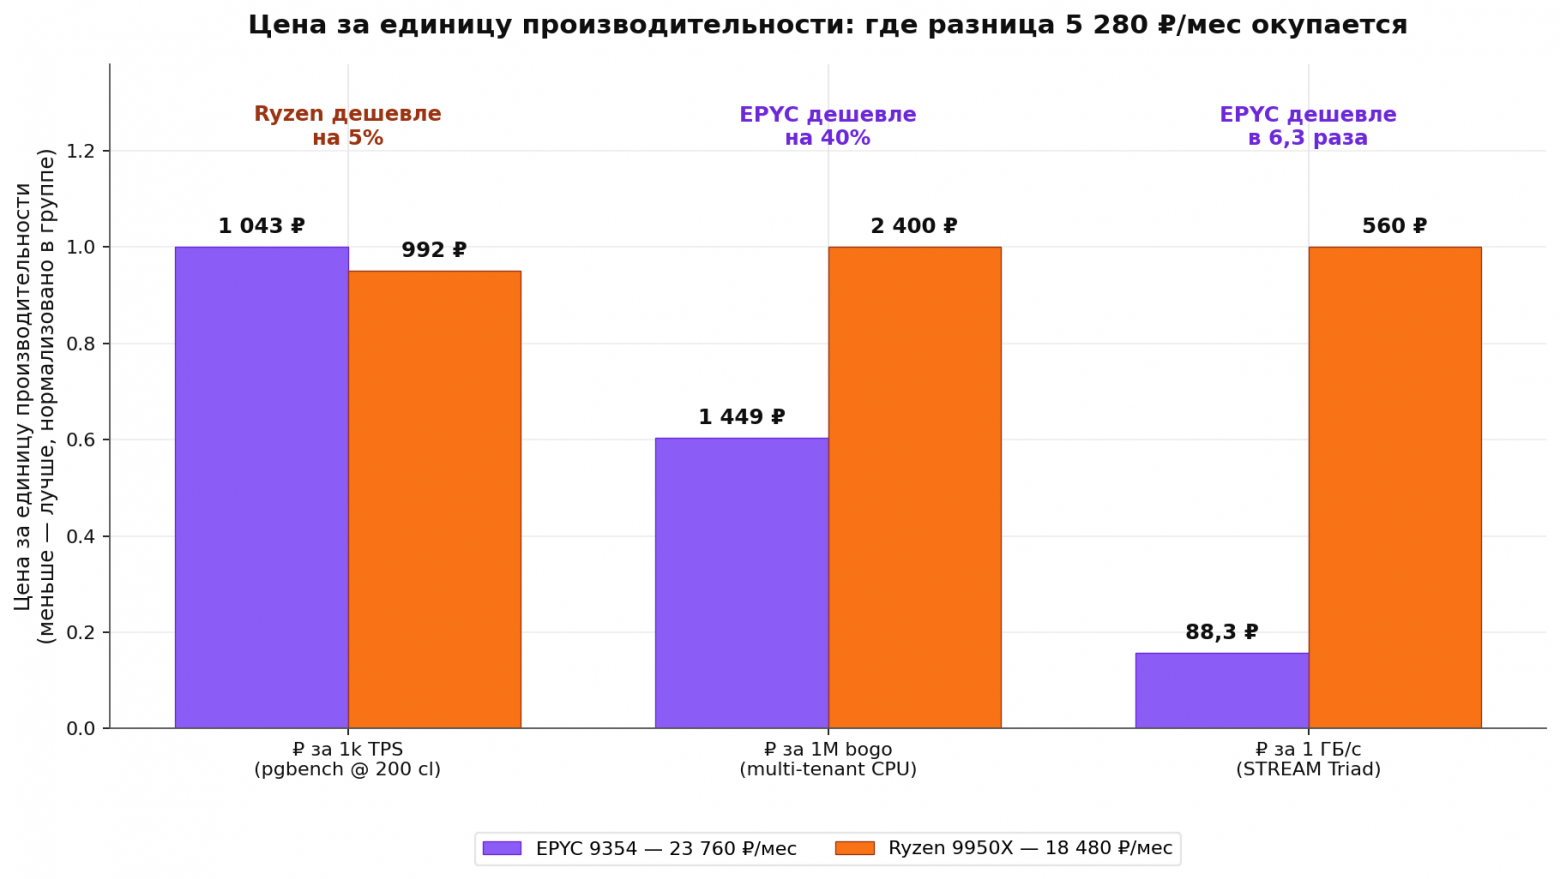
Точная разница в цене на момент заказа составляла в 5 280 рублей в месяц, и здесь возникает логичный вопрос, в каких сценариях эта разница оправдывается. Чтобы на него ответить, стоит посмотреть не на абсолютную цену сервера, а на стоимость в пересчете на единицу полезной нагрузки.


Картина складывается следующая. На лёгком веб-сервисе и серверной части (бэкенде) с небольшим числом одновременных подключений Ryzen остаётся выгоднее по соотношению цены и производительности. Как только нагрузка начинает упираться в пропускную способность памяти или в количество параллельных задач на одной машине, разница в 5280 рублей окупается эффективностью.

В пользу Ryzen 9950X работает целый ряд соображений. Сервер используется под одно приложение или сайт и не делится между клиентами. Нагрузка преимущественно однопоточная или с небольшим числом одновременных пользователей. Бюджет ограничен суммой около 20000 рублей в месяц. Данные не критичные, например, для тестовой среды или среды разработки, где отсутствие памяти с коррекцией ошибок (ECC) не играет роли. Сетевой канал в 1 гигабит в секунду полностью закрывает потребности.

В пользу EPYC 9354 говорят совсем другие соображения. База данных работает под нагрузкой от ста одновременных клиентов и выше. Один сервер делится между несколькими клиентами или контейнерами. На нём крутятся нагрузки, упирающиеся в память, такие как Redis, Memcached или вывод моделей машинного обучения. Есть требования к соответствию стандартам или повышенная чувствительность данных, когда память с коррекцией ошибок становится не опцией, а необходимостью. Нужно удалённое управление через интерфейс интеллектуального управления платформой (IPMI) на случай проблем с операционной системой. Сетевого канала в 1 гигабит в секунду недостаточно, и нужны 10 гигабит. Ожидается рост нагрузки, пользовательской базы или объёма базы данных.

Граница между этими сценариями довольно размытая, и в большинстве случаев решение остаётся на стороне того, кто лучше всех знает свою нагрузку.

Итог сравнения
Сравнение Ryzen 9950X и EPYC 9354 не сводится к одному числу или одной метрике. Расстановка сил во многом зависит от того, какая именно нагрузка крутится на сервере. Ryzen выигрывает в однопоточных тестах, в сценариях по петле обратной связи (loopback) и в задачах с небольшим числом одновременных соединений. EPYC же опережает соперника по пропускной способности памяти (разрыв в 7–8 раз), в многопоточной нагрузке и в работе под высокой температурой (просадка частоты меньше 1% против 7,5% у Ryzen), а также предлагает набор серверных функций, которых на потребительской платформе нет на уровне архитектуры.

Если посмотреть на главные находки в краткой форме:
  • Память. Разрыв в пропускной способности 7–8 раз, и причина кроется в двенадцати каналах DDR5 у EPYC против двух у Ryzen.
  • PostgreSQL. Кривая Ryzen визуально начинает выходить на плато к 500 клиентам, тогда как у EPYC ещё остаётся запас (с оговоркой про экстраполяцию).
  • Многопоточная нагрузка с несколькими клиентами. Разрыв составляет около двух раз по процессорной метрике, что соответствует двойному количеству ядер.
  • Температура. Ryzen в серверном шасси работает на пределе своей предельной температуры перехода (Tjmax) с просадкой частоты около 7,5%.
  • Серверные функции. Память с коррекцией ошибок (ECC), интерфейс интеллектуального управления платформой (IPMI) и механизмы надежности, доступности и обслуживаемости (RAS) на EPYC присутствуют как часть платформы, а на Ryzen они либо отсутствуют, либо ограничены.

Разница в чуть более 5000 рублей позволяет выбрать серверный процессор вместо потребительского, установленного в серверном корпусе. Вопрос окупаемости этой разницы зависит от того, насколько реальная нагрузка соответствует параметрам, которые были учтены при разработке серверного процессора.

hostkey.ru

«Технический центр Интернет» стал первым участником Yandex Browser Root Certificate Program

На прошлой неделе «Яндекс» объявил о запуске публичной программы Yandex Browser Root Certificate Program. Она определяет, какие центры сертификации и на каких условиях могут добавить свои корневые сертификаты в хранилище «Яндекс Браузера».

Первым участником программы стал «Технический центр Интернет», входящий в ГК РТК-ЦОД, — оператор национальных доменных зон .RU,.РФ, .SU, .TATAR и.ДЕТИ. Наши коллеги уже несколько лет участвуют в развитии прозрачной и проверяемой инфраструктуры WebPKI. В частности, они добровольно передавали сведения о сертификатах в CT-логи «Яндекса» задолго до запуска Yandex Browser Root Certificate Program.

Что означает участие в программе:
  • «Яндекс Браузер» сможет доверять TLS-сертификатам Центра сертификации ТЦИ, а пользователи браузера — безопасно открывать сайты, которые используют эту инфраструктуру;
  • Сертификаты ТЦИ соответствуют публичным требованиям программы и проходят внешний аудит;
  • Данные о выпущенных сертификатах попадают в независимые журналы Certificate Transparency, поэтому их выпуск можно проверить.

Важный момент: доверие не выдаётся один раз и навсегда. Участники программы будут постоянно соблюдать требования безопасности, сообщать об инцидентах и оперативно реагировать на риски.

Подводим итоги лета в Марфино


Стройка заметно продвинулась: энергоцентр обзавёлся готовыми фундаментами, к площадке подвели газ, а проект дата-центра ушёл на экспертизу. Рассказываем по порядку, что сделано.

Энергоцентр: фундаменты готовы
Все шесть фундаментов энергоцентра построены — ровно по проекту, под запуск первого этапа. Основания готовы под установку трёх ГПУ и трёх ДГУ.

Газификация: труба в земле
Газоснабжение перешло из проектирования в стройку: начаты строительно-монтажные работы, и газовая труба для энергоцентра уже проложена. Это тот самый газопровод, по которому топливо пойдёт к установкам энергоцентра.

Проект ЦОД — на экспертизе
Проектная документация ЦОД Марфино вышла на следующий этап: заключён договор с экспертной организацией, весь материал передан на проверку.

Связность: оптика готова к работе
Подземную оптику довели до финала. Линию полностью проложили и сварили в контейнерном ЦОД, а затем отладили и перепроверили — сделали все виды измерений со всех сторон. Канал готов к использованию.

Подготовка площадки
  • За лето закрыт блок подготовительных работ по первому зданию ЦОД:
  • зачищено пятно застройки первого здания;
  • проведены экологические изыскания;
  • выполнена геодезическая разметка проезда;
  • по воде — получен результат анализа воды из скважины и заключён договор на её лицензирование.

Логистика
Логистику доставки тяжёлого оборудования закрыли: решён вопрос с въездом для крупногабаритного транспорта. Само оборудование энергоцентра встанет на готовые фундаменты совсем скоро — покажем это уже в следующем отчёте.

Итоги лета
Главное за лето: энергоцентр получил шесть готовых фундаментов, к площадке подвели газовую трубу, подземная оптика готова к работе, а проект ЦОД Марфино ушёл на экспертизу. Осенью ждём результаты экспертизы и монтаж установок энергоцентра — о нём расскажем в следующем выпуске.

Не дожидаясь ввода нового корпуса, серверную стойку можно арендовать уже сейчас — в действующей инфраструктуре.

www.cloud4y.ru/cloud-hosting/server_stand_rental/
hosting.kitchen/tag/DC4Y.1-%D0%9C%D0%B0%D1%80%D1%84%D0%B8%D0%BD%D0%BE/

Даллас запущен


Для нас это было очень насыщенное лето, и сегодня мы вычеркиваем из нашего списка последнее (и, пожалуй, самое востребованное) место.

Даллас официально запущен!

Внедрите наши решения уже сегодня, используя доступные конфигурации, всего за 10 минут, поскольку в ближайшие дни мы продолжим расширять линейку!

Ожидайте высокопроизводительные варианты, включая AMD Ryzen 9950X и AMD EPYC 4545P, оба доступны с 256 ГБ оперативной памяти, а также дополнительные конфигурации по мере их появления.

Вот что их питает:
  • Стратегическое расположение: Наша точка присутствия в Далласе подключена через Dallas Infomart, один из ведущих центров обработки данных для операторов связи в стране и крупный узел межсетевого взаимодействия, обеспечивая связь с низкой задержкой по всей южно-центральной части США.
  • Подключение к сети первого уровня: Подключение к сети в Далласе обеспечивается ведущими мировыми операторами связи, включая Arelion, GTT, NTT, TATA и Comcast.
  • Стандарт ReliableSite: Как и во всех наших филиалах, на все имеющиеся в наличии серверы в Далласе распространяется гарантия развертывания в течение 10 минут, возможность выбора неограниченной полосы пропускания, круглосуточная защита от DDoS-атак и поддержка 24/7 от нашей команды и наших собственных специалистов для непосредственной поддержки оборудования.

Если вы уже используете наши услуги где-либо ещё, все необходимые вам дополнения, от модернизации видеокарты, оперативной памяти и хранилища до Metal+, программы для реселлеров и многого другого, — доступны в Далласе.

В том, как вы с нами взаимодействуете, ничего не меняется. Вы можете управлять своей деятельностью в США, ЕС и Мексике через ту же панель и API, которые вы уже используете.

Если вы новичок в ReliableSite, Даллас — идеальное место для начала. Вы получаете инфраструктуру, которой мы владеем и управляем, с подтвержденной 100% бесперебойной работой в последние годы.

Внедрение в Далласе уже сегодня → www.reliablesite.net/dedicated-servers/dallas-dedicated-servers.aspx

Спустя два десятилетия цель осталась неизменной. Мы по-прежнему строим лучшую инфраструктуру для предприятий, которые от нас зависят. Благодарим вас за доверие и надеемся на дальнейшее сотрудничество в удовлетворении ваших инфраструктурных потребностей на протяжении многих лет.

Есть вопросы? Брайан доступен на нашей главной странице круглосуточно, или вы можете в любое время создать заявку в службу поддержки.

Спасибо,
— Команда ReliableSite

Что не так с попытками бизнеса заменить джунов на ИИ


Компании сейчас массово режут косты и сокращают джунов. Решение кажется бизнесу идеальным: выдаём мидлам токены, ускоряем время выкатки фич, а бонусом экономим на выращивании спецов.

Тем более на рынке уже есть кейсы, как команды до 30 человек с ИИ собирают и запускают целые облачные платформы. Например, мы в H3LLO Cloud. Эта модель называется tiny teams.

Разница в том, что мы умеем думать, знаем, зачем применять и для чего НЕ применять LLM. И у нас нет KPI на использование токенов. При этом в корпорациях они обычно есть, и часто там мидлы гоняют бессмысленные запросы, просто чтобы дойти до лимита по KPI.

Я в этой истории по обе стороны баррикад: сам каждый день работаю с нейронками и сам же нанимаю людей. И я могу очень чётко рассказать, где у этой красивой схемы дыры.

Их минимум 5, и каждая со временем обойдётся дороже, чем весь сэкономленный фонд оплаты труда джунов. Ну, например, то, что найм сломан, а система резюме не работает.

Цифры и истории дальше — в основном от моего знакомого, предпринимателя и преподавателя Даниила Пилипенко, который с 2014 года занимается подбором и оценкой айтишников в своей компании SymbioWay. Он и его команда принципиально не делают выводов на резюме.

И они же больше десяти лет ведут статистику: сколько на рынке вакансий, сколько резюме и что из этого получается на практике. Мы будем рассказывать о наблюдениях вместе.

Начнём с того, как кончилась сказка про то, что в ИТ всё хорошо и всех ждут золотые горы.

Сказка кончилась прошлым летом
Десятилетиями рынок IT жил в режиме хронического дефицита: вакансий было стабильно больше, чем резюме, примерно на 40%. Кривые шли параллельно, дружно проседали к Новому году (все хотят отдыхать, а не нанимать) и снова расходились.


Весной 2020-го пандемийный локдаун уронил обе кривые: кандидаты сидели по домам, а компании перестали нанимать. Потом всем срочно понадобились доставки и онлайн-сервисы, и спрос меньше чем за два года вырос почти в три раза. Это был пузырь, но изнутри он ощущался как новая нормальность: айтишников носили на руках и давали офферы и контрофферы, зарплаты и «плюшки» кратно росли.

В марте 2021-го знакомый провёл эксперимент. Java-разработчик выложил резюме утром во вторник. К вечеру вторника у него уже было 60 писем на почте и 30 звонков на телефоне. К вечеру среды — оффер: кто-то особо настойчивый прорвался и уговорил выйти на работу в четверг утром. Вот так выглядел рынок. Утром публикуешь резюме, днём сидишь и выбираешь, вечером проходишь короткое собеседование, а буквально завтра уже выходишь на работу.

В марте 2022-го инвесторы прикрыли финансирование почти всех проектов, потому что стало непонятно, что будет дальше. Кривая вакансий упала вниз и сильно приблизилась к кривой резюме.

Уже в марте 2023-го российский рынок вернулся, и до октября 2024-го всё было как раньше: дефицит 40%, жизнь хороша.

А с октября-ноября 2024-го вакансии снова полетели вниз. И прошлым летом кривые впервые за десятилетия пересеклись. Резюме стало больше, чем вакансий.

Локальной российской аномалией это не назовёшь. В США в пике было около полумиллиона технических вакансий, в июне 2022-го рынок просел втрое — до 150 тысяч. Сейчас отрос до 260 тысяч и ползёт вверх со скоростью улитки. По еврозоне график выглядит аналогично.


Сейчас у Python-разработчиков конкурс — 20 человек на место, во фронтенде ситуация немногим лучше. А вот, например, в 1С или разработке на Go всё не так плохо, там конкурс гораздо меньше, но в среднем температура по рынку пугающая. Джуну, чтобы попасть на одно собеседование, нужно откликнуться несколько сотен раз, а такого количества вакансий по его специальности может и не быть. Не 30, после которых обычно опускаются руки, а несколько сотен!

Дальше происходит вот что. HeadHunter — это примерно 40% рынка. Кандидатам лениво откликаться руками, и они включают ботов-автооткликаторов. Рекрутер утром открывает вакансию и видит тысячу откликов. Он читает первые двадцать, зовёт самого «симпатичного» кандидата, на неделе читает ещё 40−50 откликов, кого-то в итоге нанимает и закрывает вакансию. Хвост из девятисот откликов не прочитает никто и никогда.

Вот в такую среду бизнес и принёс свежую идею: джунов больше не нанимаем, у нас теперь ИИ.

Соблазн понятен и подкреплён фактами
Свежий пример от заказчика. Он устал платить за amoCRM и Bitrix24: дорого, интерфейс перегруженный, половина функций не нужна, есть опасения за безопасность данных о клиентах. Хочет свою CRM. Знакомый спросил нескольких фулстек-разработчиков, которые ещё пишут по старинке (тех, кто ещё не заразился подходом и не стал AI-native специалистами), во сколько они оценивают такой проект в одно лицо. Объём известен: 15 таблиц в базе данных, страниц тридцать интерфейса. Все ответили примерно одинаково — два-три месяца, если нормально отладить и протестировать.

В итоге подключили того, что владеет ИИ-инструментами, и у него на создание полноценной системы ушло 12 часов плотной работы. Заказчик пользуется своей системой уже 4-й месяц. За этот срок он всего пару раз попросил доработать функционал под свои задачи, на что ушло где-то 3 часа.

Секрет при этом обидно скучный. Никакого промпт-инжиниринга со специальной структурой запросов, которой учат на курсах. Работает инженерная последовательность: сначала проектируем базу, потом интерфейс, потом API по REST. Сверяем всё это между собой. Потом пишем бэкенд отдельно — по API и базе. Потом фронтенд отдельно — по API и описанию интерфейса. Потом стыкуем, пишем автотесты на интерфейс и API и автоматически исправляем все ошибки. На выходе — чистый код в единой архитектуре, всё документировано, в README инструкция: залил на хостинг, прошёл шаги, и готовый ресурс с удобным интерфейсом заработал.

День против двух-трёх месяцев. Плюс такой исполнитель стабилен: не болеет, не увольняется и не приходит в среду вечером поговорить про пересмотр зарплаты.

Знакомый техлид из крупного e-commerce — Дмитрий Буров, senior разработчик Go в Lamoda — хорошо сформулировал, что с нами всеми произошло: «Мы перестали думать о том, как красиво написать код, и начали двигать квадратики. Уровень абстракции повысился, и мы поголовно стали архитекторами. В англоязычных компаниях таких специалистов уже начали неформально называть „builders“ — строителями».

В пределе картинка такая: инженер заводит себе AI-агента-фронтендера и AI-агента-бэкендера, ставит им задачи и валидирует результат. Также тут не помешает агент-тестировщик. Рядом — живой системный аналитик, который общается со стейкхолдерами и приносит бизнесовые задачи. Двое вместо команды из десяти человек.

Выглядит как смертный приговор джунам.

Токены без тимлида не работают
Те двое с AI-агентами в среднем по рынку эффективнее команды из десяти примерно в два раза. В два. Не в 50. Не на порядок.

Потому что нейронка — джун. Очень быстрый, очень начитанный, не болеющий, но джун. Ей нужны рамки и границы ровно так же, как живому стажёру. Сформулируешь джуну задачу в общих чертах — получишь в общих чертах продукт. С нейронкой то же самое, слово в слово. А садиться вайб-кодить, не понимая, какой результат хочешь получить, — на выходе будет каша и огромный расход токенов.

Очень частая ситуация — получить что-то похожее на результат почти сразу, а потом 3−5 дней доформулировать требования и переделывать мелочи. И это ещё повезёт, если выйдет — на больших проектах надо сразу думать иначе.

Отдельная иллюстрация — самопроверка. Спросите ИИ, какие проблемы он видит в собственном только что написанном коде. Первая итерация — что-то найдёт. Вторая — ещё что-то. На третьей-четвёртой зациклится и объявит, что проблем больше нет. Живой опытный разработчик на этом вопросе может копать бесконечно и технически грамотно: конкурентность, безопасность, узкие места архитектуры, что будет со второй итерацией продукта. Нейронка комплексно на это не смотрит. Такие требования в промпт впишет только человек, который сам набил эти шишки, — он же заметит проблемы в готовом коде глазами.

И вот первая нестыковка бизнес-плана. «Выдадим мидлам токены» на практике означает «назначим каждого мидла техлидом AI-команды». А техлидство — это отдельные конкретные навыки: проектирование архитектуры, декомпозиция, постановка задач, выстраивание границ, валидация чужой работы. Откуда эти навыки берутся? Из опыта руководства живыми джунами. Которых мы только что сократили. А ведь мы выступаем в роли техлидов для ИИ ровно в той же мере, как если бы перед нами сидел живой джуниор.

Мидлы не самозарождаются
Любой мидл — это джун, которого кто-то когда-то терпел.

В 2011 году знакомый нанимал себе разработчика, дал задачку на листочке бумаги, в духе «компилируй в голове, пиши на бумаге». Кандидат решил всё, кроме рекурсивной функции. Просто не смог написать рекурсию. Формально это отказ: заместитель знакомого такого кандидата завернул бы не раздумывая. Вместо этого они заключили сделку: про рекурсию никому не рассказываем, а к понедельнику, к выходу на работу, ты знаешь её идеально. В понедельник человек вышел со знанием рекурсии, проработал в компании много лет и сейчас занимает серьёзную должность. А заместитель, который завернул бы кандидата за незнание рекурсии, лишил бы компанию отличного кадра.

Это один из вариантов «вырастить специалиста» — поверить в него и установить жёсткий план развития. Дёшево, быстро, эффективно.

Теперь смотрим, что стало со входом в профессию. Сам по себе язык программирования учится с нуля за полгода, по вечерам — месяцев за семь-восемь. Но выучить один язык давно перестало быть достижением: знания стали доступными, толстые книжки с распечатками кода на шесть страниц, которые перепечатывали руками, уехали в музей. Чтобы джун начал приносить пользу, ему нужен комплекс: бэкенд, желательно с парой языков, фронтенд с фреймворком, вёрстка, архитектура, понимание микросервисов. Это уже года два учёбы. Плюс стажировки, фриланс и дешёвые проекты ради практики — период разгона от нуля до способности приносить пользу вырос в разы.

То есть конвейер производства мидлов стал длиннее и дороже ровно в тот момент, когда бизнес решил его выключить. Запас прочности у такого решения — года три-четыре: пока нынешние мидлы не станут синьорами, не выгорят и не подорожают. Потом выяснится, что новых брать неоткуда. Джунов не растили, а ИИ за это время так и остался джуном. Да, модели умнеют с каждым релизом, но растут они у вендора. А вендор продаёт вам токены, а не выращенного внутри вашей команды специалиста.

Ладно, скажет бизнес, не будем растить сами — купим готовых мидлов на рынке!
Их же теперь много, вон какой конкурс!

Здесь начинается самое весёлое. Знаем ситуацию, когда за годы отбора накопилась стабильная, повторяющаяся из года в год конверсия: из всех людей, называющих себя программистами, реально работать программистом может каждый 20-й.

Перегретый рынок так устроен в любой профессии. В 2015-м компания Даниила подбирала клиенту бухгалтера. Решено было тестировать бухгалтеров так же, как программистов, — задачами в электронной системе, где нужно было не выбирать варианты ответов, а писать текст. На вакансию откликнулись около 600 человек. До онлайн-задач дошли 400. Задачи несложные: две компании, одна посредник, одна работает с НДС, другая без, посчитайте НДС в этой схеме. Эту задачу из четырёхсот бухгалтеров правильно решили человек двадцать пять. Все десять задач — только семеро. Троих с нормальными софт-скилами показали клиенту, одного в итоге наняли.

Отдельный штрих: ещё 7 из той воронки физически приехали в офис клиента выяснять, как им пройти собеседование, которое вообще-то целиком проходило удалённо. И это при том, что они даже простейший НДС не смогли посчитать!

Теперь добавим в эту картину ИИ — и она станет хуже. Резюме теперь пишут нейронкой, по тексту вообще ничего не понять. На онлайн-собеседованиях кандидаты включают прозрачные окна поверх экрана, которые не видны при демонстрации, и зачитывают оттуда ответы. Зачитывающих пока выдают глаза: они бегают по строчкам. Дошло до вопросов-ловушек: например, внезапно спросить кандидата, как пожарить свиные крылышки. Человек, погружённый в техническую беседу, на секунду зависнет и рассмеётся. Зачитывающий начнёт уверенно излагать рецепт — нейронка-то ответ честно сгенерировала.

Палятся и на фактах. Самый надёжный вопрос — сколько времени занимало создание продукта, о котором кандидат рассказывает. Без реального опыта масштаб не прикинуть, и суфлёр тут не спасает. Знакомый тимлид как-то поймал кандидата ещё проще: тот назвал его родной вуз, а на вопрос, какой факультет, ответил, что компьютерный. Такого факультета там не существует. Пятнадцать минут собеседования.

Есть и ещё организованное движение — «волки». Философия простая, они сами называют её осознанной меркантильностью: рынок нам должен, заходим на грейд выше, чем умеем, зарабатываем максимум. Справедливости ради, часть из них потом действительно дорастает до заявленного грейда: берут на себя ответственность и пашут, действительно выдавая нужные результаты. Но для работодателя это уже лотерея.

Для компании опасен вовсе не слабый кандидат. Слабый честен: ему не дают сложных задач, его постепенно растят, все понимают, что с ним делать. Опасен кандидат, который научился выглядеть сильным. По нему компания принимает неверные управленческие решения — а потом ловит сбои в проектах там, где ничего не должно было сбоить.

Если компания уволила джунов, на своих выращенных опереться больше не может и идёт на рынок за «готовыми мидлами» — на рынок, где конкурс 10 к одному толкает людей к обману, нейронки делают обман дешёвым и массовым, а настоящим специалистом по-прежнему оказывается каждый двадцатый.

Резюме умерло, а нанимать по-новому дорого
Хорошо, а как отличать настоящих?

Старый интерфейс найма — резюме — сломался окончательно.

Он, честно говоря, никогда толком и не работал. В подкасте Даниил рассказал про товарища, который сейчас работает одним из технических руководителей в Google. И вот он как-то показал Даниилу своё резюме, в котором была всего одна строчка навыков — PHP, MySQL, HTML, CSS, JavaScript — и невзрачное место работы. За этой строчкой скрывался человек, который написал собственную версию PHP: лазил в исходники интерпретатора и переделывал синтаксис под себя, в частности, менял точку на плюсик для конкатенации строк.

Другой пример. К Даниилу на консультацию пришёл PHP-разработчик с резюме, которое выглядит так, будто у него опыта лет пятнадцать. Начинаешь расспрашивать: с микросервисами работал — слова «микросервис» в резюме нет. Гитом владеет — слова «Git» нет. Редис, очереди, хранилища — ничего нет. Объяснение прекрасное: мозг не заточен под самопрезентацию, и вообще он это всё не любит, резюме и так далось с трудом. Сильные специалисты сплошь и рядом игнорируют самопродвижение: им годами не нужно было выходить на открытый рынок, их передавали из рук в руки по рекомендациям.

А в 2015 году у Даниила был случай: искали клиенту фронтенд-разработчика на Angular. В воронку попали двое лучших кандидатов после тестирования, при этом эксперт выбирал их, не видя резюме — только по тому, как они решали задачи. У первого оказалось идеальное резюме фронтендера. У второго — всё про 1С, и лишь где-то внизу сиротливое слово «Angular», потому что он «по вечерам сайтики делал для себя» и не верил, что это коммерческий опыт. Клиент провёл собеседование, перезвонил и в восторге сказал: «Они оба такие классные, я пойду выбивать бюджет на двоих». И взял обоих, и оба проработали в этой компании по 6 лет, пока она не закрылась. И это доказывает, что честность с резюме кандидату никак не помогла, а помог наработанный вечерами опыт.

Бывают и зеркальные случаи. Знакомого позвали оценить команду из десяти верстальщиков и фронтендеров: руководитель компании засомневался в их лиде. У лида десять лет стажа, по идее, давно пора в синьоры. По навыкам оказался джун с плюсом. Все десять лет команда клепала однотипные плоские лендинги — стаж шёл, скилы не развивались.

Что работает вместо резюме? Компания Даниила уже год практикует формат, который считает самым эффективным в настоящее время. Звонок кандидату начинается с вопроса, владеет ли он Cursor. Владеет — отлично: открывай, включай демонстрацию экрана, вот описание продукта, у тебя час. Хотел списать на собеседовании — пожалуйста, списывай официально, нейронка перед тобой, сделай нам продукт и размести на тестовом сервере. Фокус в том, что для результата нужны оба набора скилов сразу: программировать и работать с ИИ. Без «включения» мозга нейронка такое не вытянет: надо поставить задачу, разложить систему на части, заметить, где она привирает, запускать агентов параллельно. Без владения инструментом не уложишься в час.

Это заодно ответ на вопрос, кого теперь считать джуном. Джун с Cursor и джун без Cursor — две разные профессии.

Дальше — устный экзамен, как в университете: эксперт, кандидат и разговор. Даниил считает этот формат золотым стандартом, и там есть свои детекторы. Например, вопрос про методы HTTP. Кандидат называет GET, POST, PUT, PATCH, DELETE — нормальный мидл. Вспомнил HEAD и OPTIONS — условно мидл с плюсом. А вот если назвал TRACE и CONNECT и бойко рассказывает, что это, — иногда отказ. Нормальные люди их не помнят, на практике они почти не встречаются (если только вы не синьор, который случайно столкнулся с этим в специфической задаче). Либо списал, либо подглядел.

Ещё есть проверка профессиональной интуиции: спросить то, чего кандидат знать не обязан. Вы Ruby не знаете? А как, по-вашему, там может быть устроено ООП? Честный человек начинает рассуждать, тянуть связи от того, что знает, и ошибаться правдоподобно — по этому видно, что чутьё есть, с остальным разберётся. «Волк» же отвечает подозрительно точно. Слишком точно для человека, который Ruby не знает.

У компании Даниила, к слову, есть и автоматизация: система онлайн-оценки следит за 67 признаками списывания — вплоть до того, как кандидат набирает текст. С ChatGPT в соседнем окне или в телефоне на столе текст набирают заметно иначе, чем из головы. Но он сам говорит, что достоверности пока не хватает, и финальное слово должно оставаться за экспертом и живым собеседованием.

Про роль ИИ в найме у него тоже есть чёткая позиция. Загрузить запись собеседования и попросить выписать плюсы и минусы кандидата — полезно: взгляд со стороны, нейронка заметит то, что вы пропустили. А вот решение отдавать ей нельзя. Решение о найме — это взвешивание рисков: вот этого кандидат не знает, ну и ладно, за выходные выучит, зато глаза горят. Машина так не взвешивает.

Богатые компании делают ещё круче: устраивают тестовые дни, когда кандидат день-два сидит за реальной работой, знакомится с компанией, а компания смотрит на него в деле. Лучший способ отбора из существующих. И самый дорогой.

Живой эксперт, час демонстрации экрана, устный экзамен, тестовые дни. Найм стал заметно дороже ровно в тот момент, когда бизнес решил на нём сэкономить.

Ставка на чужую инфраструктуру
Последняя дыра стратегическая, про неё почти не говорят на конференциях.

ИИ хорошо пишет на том, на чём его обучили, и это уже искажает рынок технологий. Проектов на TypeScript становится больше в том числе потому, что нейронки на нём сильны. Go за последние год-полтора рванул с привычных десяти процентов рынка к двадцати и вот-вот обойдёт Python по популярности в бэкенде — старая иерархия, где сверху Java, за ней Python, дальше PHP, поплыла на глазах. А вот на 1С, который держит заметную долю российского рынка, нейронки пишут плохо: данных мало, модели учились на англоязычном коде, и ждать паритета ещё года два. Embedded — вообще отдельная планета: какие баги и капризы у конкретной железки, не знает ни одна модель, поэтому люди с C, C++ и Assembler могут не паниковать в принципе.

И здесь важно понимать, что разные ИИ-модели хороши в разном: для написания кода сейчас отлично работают Gemini или продукты Anthropic, а вот отечественная Алиса, хоть и не блещет в программировании, зато делает весьма неплохие юридические подборки. То есть лозунг «заменим джунов на ИИ» в реальности звучит как «заменим джунов на ИИ в тех стеках, где ИИ повезло с обучающей выборкой». В заголовках такое уже смотрится хуже.

И второе. Взрывной рост моделей упирается в железо и энергетику, а того и другого в мире не прибавляется. Уже ходят осторожные прогнозы, что в ближайшее время рост притормозится просто потому, что вычислять будет не на чем. Знакомый позавчера сел дописать свою утилиту с Cursor — тот тормозил так, что проще было написать руками, а в какой-то момент написал, что его сервера перегружены и надо подождать. Один тормозящий вечер — мелочь. Но стратегия «джунов сократим, токенов докупим» молча предполагает, что токены всегда будут дешёвыми, быстрыми и доступными. Это ставка на чужую инфраструктуру, чужую экономику и чужую энергосеть. Откат назад возможен гораздо легче, чем кажется из 2026 года.

Под конец две истории, обе на самом деле про одно
2006 год, четвёртый курс университета. Человек в совершенстве пишет на Java и приходит на вакансию PHP-разработчика. PHP не знает вообще, ни строчки кода не написал. Всё собеседование уместилось в один вопрос: знает ли он PHP. Ответил, что знает. Приняли. Дальше он за месяц перечитал весь PHP.net, через несколько лет дорос до ведущего разработчика, и вся эта авантюра давно превратилась в длинную успешную карьеру. Работа ему тогда была не особо нужна, четвёртый курс всё-таки. Это был вызов самому себе: соврал — теперь соответствуй.

Формально перед нами волк. По сути — лучший найм тех лет.

История посвежее. Парень на собеседовании в команду поиска мимоходом упомянул, что знает, как растёт слайс в Go: в одной версии языка алгоритм был один, потом поменяли буквально строчку, и распределение памяти стало лучше. Его спросили, зачем ему это знать. Ответ обезоруживал: незачем, просто прикольно лазить по исходникам. В ту команду он не прошёл, так как не очень хорошо знал Elasticsearch, который там требовался, но запись собеседования увидел тимлид из соседней — и забрал его к себе за один этот ответ.

Вот это и есть джуны. Это люди, которые от чистого любопытства лезут в исходники, на спор выучивают язык за месяц и через несколько лет становятся теми самыми мидлами, которым бизнес сегодня торжественно выдаёт токены. Даниил Пилипенко, который сейчас собирает материал для своей будущей книги о профессионализме, говорит: именно этот искренний, глубинный интерес к тому, как всё устроено под капотом, является основной движущей силой профессионализма.

Интерес заставляет наращивать новые нейронные связи и решать всё более сложные задачи, а не только получать зарплату.

Так что просто в мире появилось новое ремесло — работать с LLM. Как когда-то появилось ремесло работать со счётами, а потом с Excel.
Готовы размещать по себестоимости любое сетевое оборудование с 2 БП в М9

Итоги модернизации сети: пропускная способность между площадками Colobridge выросла в 10 раз


Команда Colobridge завершила масштабную модернизацию сетевой архитектуры дата-центров, на базе которых развернута технологическая платформа компании. Проект завершился переходом от классической трехуровневой сети к современной фабрике EVPN-VXLAN Spine-Leaf — архитектуре, на которой строят инфраструктуру крупнейшие облачные провайдеры мира.

Все работы были выполнены в четыре запланированных ночных окна, как и было анонсировано клиентам заранее. Инфраструктура клиентов Colobridge уже работает в новой сети.

Ключевые изменения в работе сети
В ходе модернизации мы заменили устаревшее оборудование и перешли на новую топологию сети и устранили ключевое ограничение прежней архитектуры: протокол Spanning Tree Protocol (STP) больше не блокирует резервные каналы, а трафик распределяется по нескольким параллельным маршрутам одновременно через технологии vPC и ECMP.


Что изменится в работе клиентских сервисов
Главный эффект модернизации — отказоустойчивость. В прежней архитектуре отказ отдельного узла или канала мог приводить к простою в пределах 40 секунд, пока сеть перестраивала маршруты через протокол STP. В новой резервные пути используются одновременно, а не блокируются в ожидании отказа основного маршрута. Поэтому переключение при сбое любого компонента ядра занимает менее одной секунды и остается незаметным для клиентских сервисов.

Рост пропускной способности напрямую снимает риск перегрузок в периоды пиковых нагрузок — при резервном копировании, репликации хранилищ или миграции виртуальных машин между узлами.

Отдельным направлением модернизации стало повышение безопасности и изолированности. Теперь клиентская среда может быть выделена в приватную изолированную сеть в рамках технологической платформы Colobridge. А это снижает риск распространения инцидента между сегментами и обеспечивает более строгий контроль трафика между критическими компонентами инфраструктуры.

Позиция Colobridge
Модернизация сети стала одним из этапов долгосрочной программы развития инфраструктуры Colobridge. Новая архитектура создает запас пропускной способности и отказоустойчивости на годы вперед. Она позволяет добавлять оборудование модульно, без остановки действующих сервисов, и снижает зависимость от единичных точек отказа.

Чтобы узнать, как обновленная сеть повлияла на вашу конкретную IT-инфраструктуру, или получить бесплатную консультацию по размещению сервисов на платформе Colobridge, напишите нам.