Мы прокачали мониторинг — смотрите, что получилось


Следить за состоянием сайта должно быть просто. Поэтому мы обновили мониторинг и сделали его удобнее: собрали важные показатели в одном месте, упростили навигацию и добавили выгрузку отчетов по инцидентам.
Стало проще:
  • оценивать состояние сайтов,
  • замечать сбои и проблемные зоны,
  • переходить от общего обзора к деталям,
  • выгружать данные для отчетности и анализа.

firstvds.ru/services/site-monitoring

Как обеспечить сохранность данных: храните бэкапы на разных площадках


Сегодня резервное копирование — это основа непрерывности бизнеса. И гарантом того, что будет обеспечена максимальная сохранность и доступность данных остается правило «3-2-1». Это значит, что как минимум одна резервная копия должна храниться на независимой площадке.

Мы разделяем этот подход и рекомендуем клиентам дублировать критически важные данные во внешний контур — например, на собственную локальную площадку или инфраструктуру другого провайдера. Это гарантирует максимальную сохранность и доступность данных, но требует действий от вас.

Внутренние механизмы Selectel защищают ваши проекты от локальных аппаратных сбоев, а создание внешней копии сделает хранение данных надежнее.

Подробнее о том, как организовать резервное копирование в Selectel, вы найдете в документации.
docs.selectel.ru/security-guide/backups/

Команда Selectel

Что сейчас происходит с ЦОДами, рынком и беженцами из Яндекса


Основное, что сейчас с рынком:
  • У многих коллег по рынку моментально и некисло выросли ценники
  • Мы не планируем повышать цены из-за текущей ситуации всвязи с повышенным спросом
  • Мы вывезли почти всё оборудование из IXcellerate (крупные ЦОДы) и разместили на своих площадках
  • Площадки снаружи не выглядят как ЦОД, инфраструктура внутри распределена шире, чем в обычном машзале
  • Многие намеренно раскидывают оборудование на десяток разных площадок по чуть-чуть, возрождают старые серверные и админов в свитерах.
  • Все переписывают Disaster Recovery-планы, потому что такого ещё не было, и главная проблема уже не в экскаваторах.

Коллеги что‑то не очень делятся информацией, а она, вероятно, нужна много кому. В первую очередь мне совершенно не хочется как‑то навариваться на проблемах коллег по цеху или ловить на этом дешёвый хайп. Но выразить свою позицию и рассказать, что мы прямо сейчас наблюдаем изнутри, необходимо. А наблюдаем мы много всего интересного.

Теперь подробнее.

Что мы видим сейчас
Как только всё случилось, к нам повалила куча людей, чтобы срочно воткнуться. Я посмотрел по сторонам и увидел, что у многих коллег по рынку моментально и некисло выросли ценники. Некоторые виды ресурсов вообще перестали быть доступны к заказу.

Мы, если что, не поднимаем и не планируем поднимать цены. Мы продолжаем жить ровно на тех же ценах и условиях, что и до мая.

Возможно, поэтому было тяжело поднять голову в эти дни, потому что свалилось много работы.

Все с мелкими виртуалками как‑то размазались по рынку (возможно, ушли в ЦОДы СНГ), а вот корпораты и гиганты не могут так сделать. У них обработка персональных данных, и она должна делаться на территории России. Поэтому к нам вполне утром может прилететь запрос на огромную инфраструктуру, мы отвечаем коммерческим предложением, днём мы её выделяем, вечером начинаем миграцию — и параллельно юристы обсуждают бумажки. Многим важнее подняться и найти новый ЦОД.

Корпораты очень требовательные. Они точно знают, какие кластеры k8s им нужны. Например, один из мигрирующих спросил, есть ли у нас managed Kafka. Кафка у нас была только гречневая, но за ночь мы сделали им первый сервис, а потом уже патчили на лету.

Ещё мы были очень заняты тем, что вывозили оборудование из крупных дата‑центров IXellerate — мы ещё пару месяцев назад начали подозревать что‑то и думали, что, если что, они в списке целей. Поэтому мы оттуда смигрировали почти полностью — там остались только единичные серверы и точки присутствия (где стык с провайдерами и тому подобное), это для технического резерва инфраструктуры.

Один новый дата‑центр развернули, ещё два на подходе. Где они — не скажем, но это не бункеры.

Что происходит с рынком?
Ну, все резко проснулись. Теперь сидят в когнитивном диссонансе и с разной скоростью пытаются осознать реальность.

Уже точно понятно, что, во‑первых, все теперь будут по чуть‑чуть бояться крупных, известных всем объектов, особенно если они находятся за пределами МКАДа.

Во‑вторых, концепция Disaster Recovery изменилась навсегда. Это смешно, но когда ваш DR‑план начинается со слов «найти уцелевший сервак». Концепция отказа целого региона или отвала крупного провайдера перестала быть чем‑то из области мифических единорогов, которых никто никогда не встретит. Теперь об этом стоит серьёзно думать.

Удивительно, что ситуация с AWS у арабов, когда им расхерачили огромный амазоновский ЦОД, ничему крупный бизнес не научила. Раньше дата‑центры проектировались из расчёта, что вылетит максимум что‑то одно — условно, перебьют линию с интернетом или отвалится питание. Сейчас ЦОДы выпадают не случайно. Бьют целенаправленно: выискивают самые загруженные узлы, точки отказа и фигачат прямо по ним. Теперь все большие компании будут тестировать отказоустойчивость из расчёта «а если ударили в самое больное?», и DR будут строить именно через это.

Кто приходит сейчас?
Профиль клиента сильно изменился. Повалили не небольшие пользователи, которым нужна виртуалка подешевле, а крупняк со специфическими запросами на нюансы работы. Им нужен Managed‑кластер Kubernetes с хитрой балансировкой внутри зон доступности и между другими кластерами. Возможно, это потому что у них уже поменялись подходы к Disaster Recovery.

Вчера через пятые руки пришёл запрос: нужно срочно собрать 900 стоек под одного очень крупного арендатора. И вот сейчас по рынку бегают все кому не лень и пытаются эти стойки собрать. Но в моменте такого объёма не найдётся примерно нигде.

Многим арендаторам просто не нашлось места в Яндексе — они, очевидно, приоритезировали собственные сервисы, в том числе критичные. Кто жил в нём как в единственной точке присутствия и нигде не резервировался — не повезло. Надо было делать Disaster Recovery. Теперь те, кто не делал, бродят по рынку и охреневают.

Когда мы выехали из IXellerate?
Ровно в тот момент, когда начали что‑то понимать про ситуацию и её прогнозы. Это понимание у всего рынка резко случилось несколько месяцев назад, и, глядя, кто рядом с нами стоит из крупняка, мы решили, что лучше стоять от них подальше. Даже до того, как сам Икселерейт начал рассылать инструкции о том, как вести себя в случае угрозы БПЛА.

В это же время на рынке начали появляться люди, которые искали подземные помещения типа бункеров для новых ЦОДов.

У нас была одна своя полностью готовая площадка, мы повезли железо туда. Ещё два помещения мы нашли за это время и проработали, как там развернуть свои мощности.

Куда сейчас встают клиенты коммерческого облака?
На нашу собственную площадку. Адрес не скажу: мы внимательно изучили столб дыма и решили, что не будем светить расположением своих ЦОДов вообще. Поэтому три новые площадки у нас без адресов — но это Москва внутри Садового кольца (две) и в пределах МКАД (ещё одна). Адрес нужен в одном случае — например, если корпораты едут регистрироваться в государственном органе. Там мы подписываем NDA и показываем.

Самое смешное, что наш самый первый ЦОД, где стоит водяное охлаждение, ещё не достроен под коммерческое облако — физически мы не сможем быстро включить там серьёзные нагрузки. Там всё всегда жило в экспериментальном формате, и банально не хватит ни сетей, ни производительности. Чтобы довести её до ума, нужно строить три ноги оптики, и это планы аж до конца 2027 года. Мы только недавно закончили там все юридические оформления.

Как поменялась архитектура ЦОДа на рынке?
Про бункеры я уже говорил. Это не наш подход, мы боимся затопления. Да, по стандартам Tier их сертифицировать нельзя. Но если рассматривать их не как основную рабочую единицу под всю нагрузку, а как место, куда в реальном времени снимаются актуальные бэкапы, — это суперперспективная история.

Наши же новые площадки мы проектировали вот так:
  • Снаружи ничего не должно выдавать, что это ЦОД.
  • Инфраструктура должна быть разнесена гораздо шире, чем в обычном ЦОДе, по гораздо большей площади, никакого кучкования в плотные машзалы.
  • При этом она должна быть распределена по возможности — чтобы не было единых точек отказа.


Главное для ЦОДа — электричество и сеть. Внутри Москвы ни с тем, ни с тем по доступности проблем нет, но по электричеству есть вопрос цены, это одно из важных усложнений.

С другой стороны, те, кто так не может, тоже уже придумали выход. Буквально за дни индустрия реагирует на глазах. Возвращается концепция микроЦОДов на предприятиях, когда маленькие стойки снова начинают запихивать в шкафы. Лично к нам приходили ребята, у которых раньше всё стояло в Яндексе, а сейчас они намеренно раскидывают оборудование на десяток разных площадок по чуть‑чуть.

Если прилетит, мы фактически теряем бизнес?
Да. Но тут нужно понимать вероятности. Вряд ли прилетит сразу в три площадки и резервные узлы. Тем не менее завтра мы общаемся со страховщиками — они, конечно, уже тоже подняли цены, и немного жалко, что мы не уделяли этому время раньше, но всё равно надо будет посмотреть. Уровень риска сейчас возрастает, а страховка — это всегда компенсация, помноженная на вероятность риска.

Были попытки помочь Яндексу?
Я знаю, что многие туда стучали со словами «дайте нам ваших бывших клиентов». Мы общались по другим вопросам. Меня в первую очередь интересовала инфраструктура Рунета. Мы им предложили наши мощности и серваки для той инфры, на которую опирается всё IT‑комьюнити. Я говорю про DNS, NTP‑шки, зеркала репозиториев и так далее. Это та хрень, которая бизнесу денег не приносит, но которая реально нужна всем. Если её не станет, очень печально будет абсолютно всем.

Что будет с рынком?
Ну, стоимость владения инфраструктурой сейчас пересматривают примерно все. Причём это касается не столько облачных провайдеров, сколько обычного рядового среднего и малого бизнеса. Облака в том абстрактном виде, к которому мы привыкли, нужно пересматривать. Поэтому вопросы гибридной инфраструктуры (когда часть лежит on‑premise, а часть распределена по разным облакам) стали невероятно острыми.

Собственно, вот. Через пару дней узнаю, что происходит со страховщиками, потом нас опять накроет кучей работы (в основном миграций), а потом уже можно будет выдохнуть и чуть разобраться ещё.

Мы переезжаем в новый дата-центр в Германии


Мы переносим наши серверы в Германии в дата-центр Digital Realty. Digital Realty — один из крупнейших операторов дата-центров в мире; их объекты ориентированы на бизнес-клиентов, для которых стабильность является главным приоритетом.

Для вас перенос осуществляется бесплатно.

ДАТЫ ПЕРЕНОСА
С 29 октября по 5 ноября включительно
Это касается только VPS на нашем оборудовании в Германии (тарифы LiteCPU и Hi-CPU). Выделенных серверов Hetzner/WorldStream это не затрагивает.

Что улучшится после переезда
  • Каналы 10 Гбит/с. Каждый физический сервер, на котором размещаются VPS, теперь подключен по каналу 10 Гбит/с. Это обеспечивает узлу значительный запас пропускной способности.
  • Новое сетевое ядро. Мы обновляем сетевое ядро ​​и подключаем вышестоящих провайдеров (апстримы) по каналам 100 Гбит/с.
  • Точка обмена трафиком GNM-IX. Мы подключаемся к GNM-IX — точке обмена трафиком, где представлены Telegram, Meta (Facebook, Instagram, WhatsApp), Cloudflare и другие крупные сети. Часть трафика к ним будет направляться напрямую, минуя промежуточных провайдеров.
  • + И множество других преимуществ, о которых вы узнаете позже.

Как будет проходить перенос
Перемещение оборудования занимает несколько дней, поэтому мы указываем весь этот период. В течение указанного времени ваш сервер может быть временно недоступен или работать с перебоями, пока оборудование, на котором он размещен, будет перемещаться и подключаться на новой площадке.

Это не означает, что сервер будет отключен на протяжении всех этих дней. Мы возвращаем серверы в строй сразу же после их подключения. Мы называем весь период целиком, чтобы вы могли заранее спланировать свою работу.

Перенос никак не повлияет на данные, хранящиеся на вашем сервере.

Это не последнее письмо касательно переноса. Ближе к началу работ мы пришлем вам дополнительную информацию. Мы также будем публиковать актуальные сведения на странице spacecore.online/status/uptime

Наша рекомендация: до 29 октября создайте актуальную резервную копию важных данных и сохраните её вне сервера. Это стандартная мера предосторожности перед проведением любых плановых работ. Убедитесь, что ваши службы настроены на автоматический запуск после перезагрузки — тогда они возобновят работу самостоятельно сразу же после включения сервера.

Если у вас возникнут вопросы, создайте обращение в личном кабинете — мы всегда готовы помочь. Благодарим за то, что доверяете нам свою инфраструктуру.

Позаботьтесь о резервных копиях заранее


Регулярное резервное копирование и хранение бэкапов отдельно от основных данных помогают снизить риск потери информации и повысить шансы на её восстановление.

Для дополнительного хранения резервных копий предлагаем наше объектное S3-хранилище.
Его преимущества:
  • Масштабируемость. Автоматическое увеличение объёма с возможностью установить лимиты.
  • Репликация данных. Данные хранятся в двух копиях на независимых серверах в дата-центре IXcellerate.
  • Простая интеграция. Поддержка S3 API для работы с вашей инфраструктурой.
  • Прозрачная тарификация. 750 ₽/мес. за 300 ГБ, далее — 2,5 ₽/ГБ в месяц. Трафик и операции с данными не тарифицируются.

1dedic.ru/services/s3

Scaleway Milan: отказоустойчивость корпоративного уровня


Мы рады объявить о важном этапе нашей европейской экспансии: миланский регион Scaleway ( it-mil ) теперь официально является полноценным регионом.

С запуском стандартов MIL-2 и MIL-3 наряду с существующей зоной зон MIL-1, наша итальянская инфраструктура теперь предлагает полную отказоустойчивость корпоративного уровня, позволяя вам создавать, развертывать и масштабировать критически важные рабочие нагрузки в Южной Европе.

Что это значит для вашей инфраструктуры:
  • Готовая к использованию экосистема: воспользуйтесь полным набором облачных ресурсов, включая экземпляры, блочное хранилище, публичный шлюз, объектное хранилище с поддержкой нескольких зон доступности и многое другое.
  • Максимальная доступность: распределите вычислительные ресурсы, хранилище и сеть между тремя физически изолированными зонами доступности в одном регионе. Это помогает защитить ваши приложения от инцидентов уровня центра обработки данных благодаря бесшовной архитектуре высокой доступности (HA).
  • Всё большая европейская автономия: сохраняйте полный контроль над своей инфраструктурой и данными на всей территории наших 3 зон доступности.

Готовы начать строительство?
Независимо от того, планируете ли вы создать собственную инфраструктуру, расширить свой бизнес в Южной Европе или перенести существующие производственные нагрузки к европейскому облачному провайдеру, мы готовы оказать поддержку на каждом этапе.

www.scaleway.com/en/

Бесплатный VPS для вашего проекта: запускаем программу поддержки


Начинающим стартапам, пет-проектам и open-source продуктам часто не хватает бюджета на надежную инфраструктуру. Мы готовы взять эти расходы на себя.

Что предлагаем:
  • Бесплатный VPS (2 vCPU, 2 ГБ RAM, 40 ГБ SSD) на срок до 3 месяцев.
  • Помощь с переездом и приоритетную техподдержку.
  • Возможность получить более мощную конфигурацию под вашу задачу.
Взамен мы попросим от вас один честный материал о вашем опыте работы с UFO.Hosting — это может быть статья, обзор, пост или видео.

А ещё публикация может приносить вам доход: добавьте реферальную ссылку и получайте до 20% комиссии с привлечённых клиентов.

Программа подойдёт проектам с активной аудиторией, а для open-source — в том числе с активным GitHub-сообществом.

Количество мест ограничено.

ufo.hosting/programma-podderzhki-proektov

Изменение Пользовательского соглашения Selectel


Обновили Пользовательское соглашение Selectel.

В разделе 6 «Ограничение ответственности» уточнены условия ограничения ответственности Исполнителя, а также положения об обстоятельствах, при которых Исполнитель не несет ответственности за убытки Заказчика.

В разделе 8 «Обстоятельства непреодолимой силы» дополнили перечень таких обстоятельств, а также упростили порядок прекращения действия Соглашения при длительном воздействии таких обстоятельств.

С новой редакцией Пользовательского соглашения можно ознакомиться по ссылке: selectel.ru/about/documents/user-agreement/

Сбой в работе Яндекса: данные показывают, что вместо того, чтобы затихнуть, вредоносные боты перешли в другое русло


После сообщений об атаках на дата-центры Яндекса в интернете распространились утверждения о том, что российские бот-фермы и операции по оказанию влияния были выведены из строя. Графики HTTP-трафика показали резкое падение, что подпитывало предположения о том, что повреждение инфраструктуры остановило действия этих злоумышленников. Однако агрегированные показатели трафика могут легко ввести в заблуждение. С Яндексом связаны два номера автономных систем (ASN): AS13238 используется поисковой системой Яндекса, а AS200350 — облачными сервисами.

Используя данные Cloudflare Radar и Bot Management, мы проанализировали, как это повлияло на эти две автономные системы (ASN), и хотя в обеих наблюдалось снижение трафика, последствия были разными.
  • Поиск Яндекса (AS13238): Падение трафика было вызвано почти исключительно индексацией веб-страниц, изображений и ресурсов сайта проверенными поисковыми роботами.
  • Yandex.Cloud (AS200350): Наблюдалось снижение вредоносной активности, такой как сканирование и проверка уязвимостей, но высокопроизводительная автоматизация не исчезла — она просто переместилась к другим хостинг-провайдерам.
Хотя вредоносный трафик может исходить от конкретного провайдера, это не обязательно указывает на то, кто за него отвечает. Чтобы понять, почему атаки не оказали существенного долговременного влияния на вредоносный трафик, необходимо анализировать поведение запросов, а не только общие закономерности трафика.

Что произошло: последствия забастовок и исходный уровень до события.
В период с 7 по 11 октября, по сообщениям, украинские беспилотники нанесли удары по трем объектам Яндекса в России, постепенно выводя из строя центры обработки данных и сетевые мощности. Как видно на Cloudflare Radar, это привело к почти полному коллапсу сети Яндекса 11 октября, когда трафик упал на 99% ниже базового уровня для Яндекс Поиска (AS13238) и на 90% для Яндекс.Облака (AS200350). Несмотря на кратковременное частичное восстановление, обе сети оставались неработоспособными до 13 октября, стабилизировавшись на уровне 86-90% ниже нормального базового уровня. (По состоянию на 14 октября, 18:00 UTC, трафик составляет 85% от нормального уровня.)


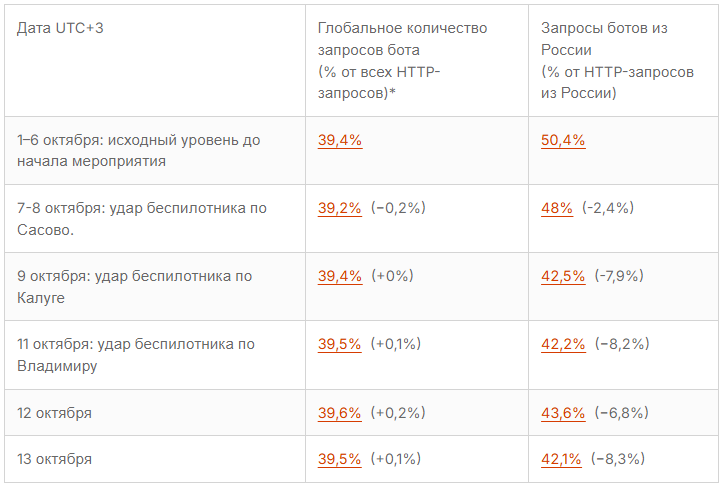
Снижение общего HTTP-трафика лишь подтверждает сбой в сети. Оно не показывает, были ли нарушены действия вредоносных или скрытых ботов. Рассматривая базовый уровень автоматизации до инцидента, мы видим, что до атак автоматизированные запросы составляли 36,1% всего HTTP-трафика, наблюдаемого в сети Cloudflare по всему миру, и 35,8% трафика с российских IP-адресов.

Сбой по-разному повлиял на автоматизированную работу двух затронутых автономных сетей, поскольку они выполняли разные функции.

ASN «Яндекс Поиск» (AS13238) используется для индексации поисковых систем. Cloudflare классифицировал 99,5% его запросов как автоматические, а 93,6% запросов от ботов — как подтвержденные. Наш анализ показал, что трафик из этого ASN индексировал страницы, отображал страницы и отображал изображения, что является типичным поведением для поискового робота. На ASN «Яндекс Поиск» приходилось около 7% запросов от ботов из России и всего 0,05% от общего глобального объема.

Азиатско-Тихоокеанская сеть Yandex.Cloud (AS200350) — это сеть облачного хостинга с совершенно иным набором автоматизации. Примерно 95% запросов, оцененных ею, были запросами от ботов, но ни один из наблюдаемых запросов от ботов не был подтвержден Cloudflare. Боты Yandex.Cloud больше походили на программные приложения: почти две трети их запросов отправляли данные на веб-сайты, некоторые идентифицировали себя как программы на JavaScript, Python или Go, и большая их часть направлялась компаниям-разработчикам программного обеспечения, чем поисковые боты Yandex. На долю Азиатско-Тихоокеанской сети Yandex.Cloud приходилось около 2% запросов от ботов из России и всего 0,01% от общего мирового объема.

Влияние события на общий трафик ботов.
«Бот-трафик» — это автоматизированные запросы к веб-сайтам в сети Cloudflare, такие как запросы от поисковых роботов и скриптов, а не обязательно активность на платформах социальных сетей. По мере снижения пропускной способности сетей Яндекса количество запросов от ботов также сократилось. Это было ожидаемо: почти весь трафик от Яндекс Поиска и Яндекс.Облака был автоматизированным. Хотя мы наблюдали очевидное падение общего трафика, мы не обнаружили никаких доказательств, связывающих глобальное снижение вредоносного трафика с падением трафика от Яндекса.

Количество запросов от ботов российского происхождения сократилось примерно пропорционально объему трафика Яндекса, который перестал работать, поскольку большинство запросов из этих сетей были автоматизированными.

Влияние на ASN Яндекс Поиска (AS13238): меньше индексации поисковых систем.
Снижение популярности Яндекс Поиска было практически полностью обусловлено индексацией поисковых систем. Анализ запросов показал, что 78,1% из них принадлежали проверенному ЯндексБоту, 11,5% — ЯндексРендРепозиторсБоту и 1,9% — ЯндексИзображениям.

Среди веб-сайтов и сервисов наиболее резкое падение наблюдалось в сегменте издательского дела и газет, где трафик из сетей Яндекса упал на 44%. Примерно 90% трафика на новостные сайты из этой ASN до события составлял индексация статей Яндексботом, при этом 40,5% клиентов Cloudflare получали HTTP-ответы 403 Forbidden, поскольку владелец сайта блокировал поискового робота. Когда ASN Яндекс Поиска отключился, клиенты просто увидели меньшее количество индексации от Яндекса.

Влияние на ASN Яндекс.Облако (AS200350): легитимное использование и миграция вредоносного трафика.
В Яндекс.Клауде наблюдалась совершенно иная картина. После сообщений об атаках бот-трафик с Яндекс.Клауда упал примерно на 40%. Особенно резкое снижение наблюдалось в нескольких категориях, связанных с атаками. Например, количество запросов к плагинам WordPress упало на 90%, а количество запросов, идентифицированных сканером, — на 93%. Интересно (и показательно), что количество блокировок трафика Яндекс.Клауда со стороны клиентов Cloudflare также снизилось на 70% за период событий, что говорит о том, что даже вредоносный трафик с этой ASN попадал на WAF Cloudflare пропорционально меньше.

Влияние на бизнес-вертикали
Боковый трафик Yandex.Cloud также представляет интерес, если его сегментировать по наиболее часто запрашиваемым отраслям:
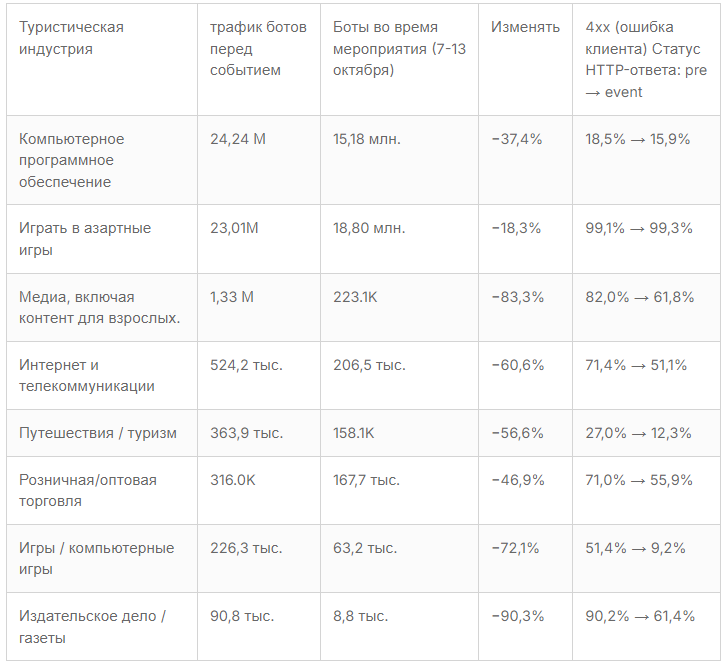

Большая часть трафика из ASN Yandex.Cloud приходилась на две отраслевые категории: программное обеспечение и азартные игры. Отношение к программному обеспечению было предсказуемым для ASN, предназначенной для размещения сторонних приложений и интеграций с программным обеспечением. Более того, мы даже обнаружили, что api.cloudflare.com является одним из основных хостов для запросов к Yandex.Cloud. В целом, большая часть этого трафика была успешной (запросы возвращали коды 200) как до, так и во время мероприятия, что указывает на легитимное использование.

Наиболее убедительные доказательства того, что вредоносная автоматизация не исчезла, а переместилась в другое место, — это игорный сектор. Практически все запросы ботов от Yandex.Cloud были направлены на один аккаунт клиента игорного сервиса, при этом трафик переключался между его хостами. Сразу после сбоя 8 октября количество запросов ботов от Yandex.Cloud к этому аккаунту упало до нуля. Одновременно с этим начали появляться идентичные запросы от других российских хостинговых ASN, включая Radist и Selectel. Входящий трафик сохранял идентичный «отпечаток» у всех провайдеров:
  • Тот же отпечаток клиента JA4 TLS
  • Те же самые нестандартные пути запроса и HTTP-заголовки.
  • Те же самые пользовательские строки User-Agent.
В целом, трафик российских ботов, нацеленных на игровые аккаунты, за неделю остался практически неизменным, увеличившись со 167,7 млн ​​до 170,1 млн запросов (+1,4%). Автоматизация не прекращалась; операторы просто перенесли свои рабочие нагрузки на альтернативных облачных провайдеров, как только Yandex.Cloud стал недоступен.

В большинстве отраслей доля запросов ботов к Yandex.Cloud, возвращающих HTTP-ответы 4xx, снизилась. Это во многом связано с уменьшением трафика, подобного атакам, о котором говорилось выше. В сочетании с анализом поведения клиентов, занимающихся азартными играми, это показывает, что вредоносный трафик, отправлявший запросы через Yandex.Cloud, просто переключился на других провайдеров после сбоя в работе сервиса.

Наконец, при анализе трафика в социальных сетях мы не обнаружили неожиданных изменений ни с российских IP-адресов (снижение общего трафика на 0,6% за период событий), ни в глобальном масштабе (увеличение общего трафика на 1,2% за период событий). Мы повторили анализ трафика ботов, обращающегося к конечным точкам «публикация», «ответ» и «лайк» на конкретной платформе социальных сетей, и аналогично не обнаружили неожиданных изменений до или во время периода событий ни с российских IP-адресов (снижение общего трафика на 5,7% за период событий), ни в глобальном масштабе (увеличение общего трафика на 1,1% за период событий). На основании нашей оценки, данные, по-видимому, не подтверждают утверждения о том, что атаки парализовали манипуляции в социальных сетях, хотя без дальнейшего анализа данных вне Cloudflare мы не можем с уверенностью сказать, что связи нет.

Что показали нам данные — и чего они не показали.
Когда трафик из сетей Яндекса резко упал, в интернете распространились предположения о том, что российские операции по оказанию влияния и вредоносные ботнеты получили сокрушительный удар. Данные Cloudflare говорят об обратном: в сети Cloudflare не было обнаружено никаких доказательств того, что атаки вывели из строя манипуляции в социальных сетях или иным образом нарушили вредоносную деятельность в интернете. Вместо этого данные показали:

Индексация поисковых систем снизилась. Подавляющее большинство трафика, упавшего с Яндекс Поиска, составляли проверенные краулеры ЯндексБот, загружавшие новостные статьи и веб-ресурсы. Основное влияние заключалось в снижении видимости контента в Яндекс Поиске.
Вредоносная автоматизация переместилась, а не прекратилась. Хотя сканирование уязвимостей и проверка плагинов временно прекратились на Yandex.Cloud, высоконагруженные операции быстро переместились на альтернативные хостинговые сети.
Сбой в сети означает, что конкретные серверы перестали отправлять запросы, но это не значит, что автоматизированная угроза исчезла. Облачные рабочие нагрузки являются переносимыми, поэтому, когда центр обработки данных выходит из строя или блокируется IP-префикс, операторы могут перенести свои скрипты к другому провайдеру за несколько часов.

Наш анализ напоминает, что объем трафика клиентских ASN является ненадежным показателем для интерпретации поведения автоматизированных ботов. Защита от автоматизированных угроз требует анализа поведения запросов, например, выявления общих отпечатков JA4, мониторинга аномальных частот запросов и применения правил WAF к конфиденциальным конечным точкам, независимо от того, из какой сети исходит запрос. Физическая инфраструктура статична, но вредоносная автоматизация создана для перемещения.