Рейтинг
0.00

Hetzner дата-центры

23 читателя, 286 топиков

Готовый к использованию Kubernetes в облаке Hetzner


Эффективное применение CCM, CSI и экосистемы открытого исходного кода

Почему Kubernetes? Кто его использует и для чего?
Kubernetes — это платформа с открытым исходным кодом, которая автоматизирует развертывание, масштабирование и управление контейнеризированными приложениями. Первоначально разработанная в Google и выпущенная в 2014 году, она стала стандартом де-факто для оркестровки контейнеров. Ее основные преимущества можно суммировать в трех пунктах:
  • Автоматическое масштабирование: во время пиковых нагрузок кластер автоматически запускает дополнительные экземпляры и уменьшает их количество при снижении спроса. Даже такие организации, работающие с большими объемами данных, как CERN, используют Kubernetes для быстрого масштабирования своих систем в ответ на внезапные всплески спроса.
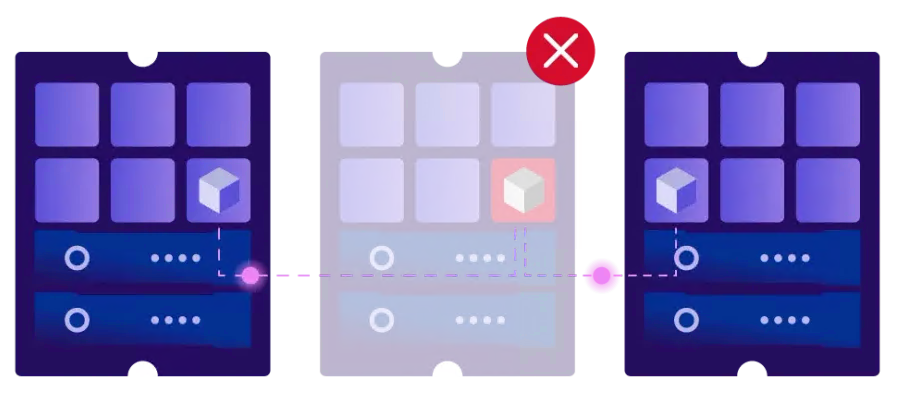
  • Самовосстановление: если выходит из строя контейнер или даже целый узел, Kubernetes автоматически перезапускает затронутые рабочие нагрузки или перемещает их на другие узлы. Приложение остается доступным, и никому не нужно вставать посреди ночи.
  • Последовательная работа: будь то микросервисная архитектура, традиционное веб-приложение или конвейер CI/CD, все использует одни и те же декларативные конфигурации и работает согласованно, независимо от базовой инфраструктуры.
  • Пользователи Kubernetes столь же разнообразны: команды, работающие с SaaS-приложениями или микросервисами, которым необходимо обрабатывать изменяющиеся нагрузки, команды DevOps, стремящиеся автоматизировать развертывание, и организации, желающие объединить несколько приложений на общей инфраструктуре и управлять ими согласованно.

Анализ экосистемы показывает, насколько разнообразны варианты использования Kubernetes в Hetzner Cloud. Самым популярным проектом сообщества по этой теме, получившим 5,7 тыс. звезд, является, что несколько неожиданно, руководство «Кластеры Kubernetes для любителей», а такие инструменты, как hetzner-k3s, явно обещают «готовые к использованию в производственной среде» кластеры. От проектов выходного дня до производственных систем — экосистема охватывает все.

Если вы используете одну виртуальную машину с Docker Compose для небольшой статической конфигурации, Kubernetes вам не обязательно нужен. Он становится интересным, когда начинают иметь значение доступность, масштабируемость и автоматизация. И именно тогда возникает вопрос: как правильно настроить Kubernetes в облаке Hetzner?


Kubernetes в облаке Hetzner: запустите его самостоятельно, не создавая все с нуля.
Запуск Kubernetes в Hetzner Cloud — это осознанный выбор: полный контроль над собственным кластером вместо зависимости от управляемого сервиса. То, что на первый взгляд может показаться большим объемом ручной работы, на самом деле поддерживается хорошо развитой экосистемой. В теме GitHub «hetzner-cloud» в настоящее время перечислены 383 публичных репозитория, и почти все самые популярные из них — это инструменты для Kubernetes. Только terraform-hcloud-kube-hetzner (3,9 тыс. звезд) и hetzner-k3s (3,7 тыс. звезд) имеют в сумме более 7500 звезд.

Основой служат собственные официальные интеграции Hetzner с открытым исходным кодом: Cloud Controller Manager, драйвер CSI, провайдер Terraform и CLI hcloud. Они напрямую сопоставляют ресурсы Kubernetes, такие как узлы, сервисы и тома, с ресурсами Hetzner Cloud. Давайте рассмотрим каждый компонент подробнее.
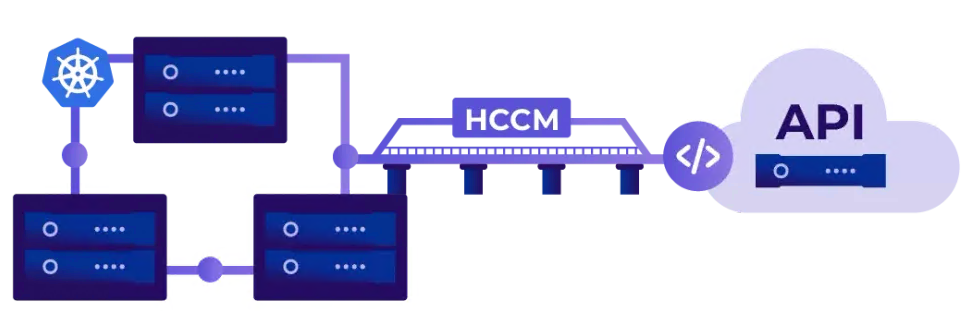


Cloud Controller Manager: мост к API
hcloud -cloud-controller-manager (HCCM) подключает кластер Kubernetes к API Hetzner Cloud и Robot. Он реализует интерфейсы, определенные Kubernetes в пакете k8s.io/cloud-provider — механизм, позволяющий каждому облачному провайдеру интегрировать свою собственную логику в общий набор контроллеров. В HCCM эту работу выполняют четыре контроллера:
  • Контроллер узлов: инициализирует каждый узел Kubernetes и добавляет метаданные, такие как тип экземпляра и идентификатор поставщика. Этот идентификатор соответствует идентификатору сервера в Hetzner Cloud или Robot, с префиксом или – обеспечивая неизменяемую связь между узлом Kubernetes и сервером .hcloud://hrobot://
  • Контроллер жизненного цикла узлов: отслеживает узлы, которые больше не «готовы», проверяет, существует ли связанный с ними сервер или он был выключен, и удаляет объекты узлов, серверы которых больше не существуют.
  • Контроллер маршрутов: Создает маршрут в частной сети для каждого узла, сопоставляя CIDR его пода с его частным IP-адресом. Это позволяет трафику, предназначенному для подов на узле, проходить напрямую через частную сеть, без накладных расходов, связанных с использованием оверлейной сети, такой как VXLAN.
  • Контроллер сервисов: автоматически создает и настраивает балансировщик нагрузки Hetzner Cloud Load Balancer для каждого сервиса Kubernetes соответствующего типа .LoadBalancer.

Последний раунд оптимизаций показывает, насколько активно разрабатывается этот компонент: общий кэш для контроллеров узлов и согласование маршрутов на основе событий вместо периодического согласования сокращают количество запросов к API Hetzner Cloud примерно на 76% при масштабировании и на 94% в стабильном режиме. Изменения в контроллере маршрутов не ограничились HCCM. Они также были напрямую внесены в основной проект Kubernetes в рамках KEP-5237 — пример того, как работа над интеграцией Hetzner приносит пользу основному проекту. Все подробности вы можете найти в нашей статье в блоге «Как мы сократили количество запросов к API в Hetzner Cloud Controller Manager». Все улучшения включены в HCCM версии 1.33 и более поздние версии.
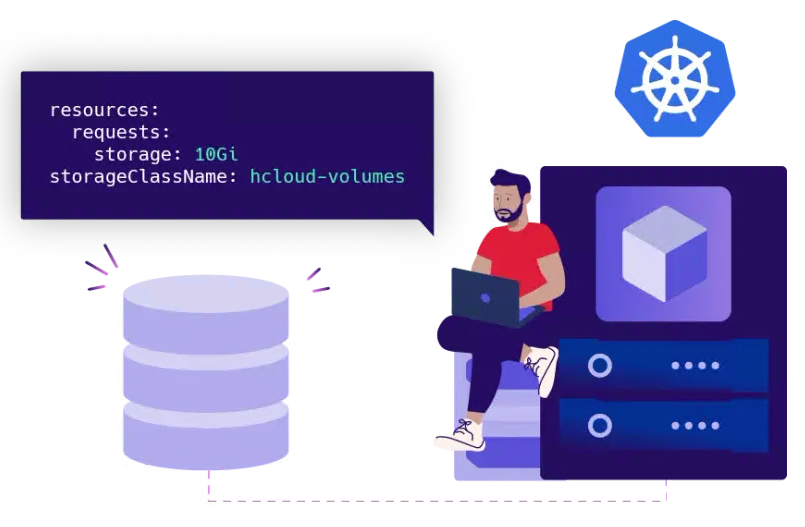


Драйвер CSI: Постоянное хранилище для рабочих нагрузок с сохранением состояния.
Базы данных, очереди сообщений, мониторинг — практически ни один производственный кластер не может обойтись без постоянного хранилища. Официальный csi-драйвер — это драйвер интерфейса контейнерного хранилища для Hetzner Cloud, который поддерживает тома ReadWriteOnce в Kubernetes и других оркестраторах контейнеров.

Для пользователей процесс соответствует стандартным рабочим процессам Kubernetes: вы создаете PersistentVolumeClaim, используя StorageClass, и назначаете его поду. Затем Kubernetes автоматически выделяет PersistentVolume через драйвер CSI. Для этого драйвер создает Hetzner Cloud Volume, подключает его к соответствующему узлу и предоставляет хранилище поду .hcloud-volumes
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: csi-pvc
spec:
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 10Gi
  storageClassName: hcloud-volumes


Сетевые технологии и балансировка нагрузки: как происходит обмен трафиком.
Картину дополняют еще два облачных продукта Hetzner:
  • Частные сети позволяют соединять узлы кластера через частную сеть. Способ настройки сети подов внутри кластера зависит от выбранного вами сетевого решения. Один из вариантов — контроллер маршрутов HCCM, который создает маршруты, обеспечивающие доступ к сети подов каждого узла через его частный IP-адрес.
  • Балансировщики нагрузки обеспечивают внешнюю точку входа. Контроллер сервисов HCCM управляет ими автоматически: все, что вам нужно, это экземпляр в вашем кластере, и Kubernetes создаст и настроит соответствующий балансировщик нагрузки Hetzner Cloud. В типичных конфигурациях он принимает трафик из интернета и перенаправляет его по частной сети на контроллер входящего трафика, например, работающий на рабочих узлах .ServiceLoadBalancerTraefik

Экосистема сообщества: четыре способа построения кластера
Вокруг этих официальных компонентов сформировалась удивительно активная общественная экосистема. Следующие проекты заслуживают особого внимания:

terraform-hcloud-kube-hetzner (3,9 тыс. звезд) обещает «оптимизированный и не требующий обслуживания Kubernetes в облаке Hetzner Cloud одной командой». Он объединяет Terraform с k3s, легковесным дистрибутивом Kubernetes.

hetzner-k3s (3,7 тыс. звезд) использует аналогичный подход в качестве автономного интерфейса командной строки. Согласно собственному описанию, он предлагает самый простой и быстрый способ развертывания готовых к использованию кластеров Kubernetes в облаке Hetzner, также с использованием k3s.

В конфигурациях на основе Talos используется другой подход к операционной системе: Talos — это минималистичная ОС с API-интерфейсом, созданная исключительно для Kubernetes. В дополнение к модулю Terraform terraform-hcloud-talos (349 звезд), модуль Kubernetes hcloud-k8s предоставляет подход, используемый в официальном руководстве сообщества для частных кластеров.

cluster-api-provider-hetzner (1,1 тыс. звезд) позволяет декларативно создавать и управлять кластерами Kubernetes в облаке Hetzner и на физических серверах. Проект основан на Kubernetes Cluster API и в первую очередь ориентирован на опытных пользователей, желающих автоматизировать операции с кластерами.

Кроме того, в большинстве этих конфигураций за кулисами работают официальные интеграции Hetzner: провайдер Terraform (728 звезд), hcloud-CLI (1,8 тыс. звезд) — и, конечно же, сами HCCM и драйвер CSI. Обзор других проектов Kubernetes на Hetzner Cloud можно найти в разделе Kubernetes нашего списка awesome-hcloud.

Эталонная архитектура для производственных сред
Как на самом деле выглядит кластер, готовый к использованию в производственной среде? В руководстве сообщества «Частный кластер Kubernetes с использованием Terraform и Talos» представлена ​​архитектура, объединяющая все компоненты:
  • Три узла плоскости управления для обеспечения высокой доступности плоскости управления (etcd, kube-apiserver, kube-scheduler)
  • Рабочие узлы без публичных IP-адресов, распределенные по группам размещения, обеспечивают работу виртуальных машин на различном физическом оборудовании.
  • Частная сеть (например, 10.21.0.0/16) в качестве основы кластера.
  • Исходящая виртуальная машина, выступающая в качестве NAT-шлюза, позволяет частным узлам получать доступ к интернету и обеспечивает SSH-доступ для запуска kubectl и talosctl.
  • Балансировщик нагрузки Hetzner, управляемый Kubernetes, служит точкой входа для ingress-nginx.
  • Longhorn для распределенного постоянного хранения данных и cert-manager для TLS-сертификатов
  • Cluster Autoscaler — это инструмент, который выделяет дополнительные рабочие узлы по мере необходимости.

Для автоматического масштабирования в облаке Hetzner существует официальная интеграция облачного провайдера с Kubernetes Cluster Autoscaler. Она позволяет автоматически выделять дополнительные облачные серверы в качестве рабочих узлов по мере необходимости. Когда они больше не нужны, Autoscaler может их удалить. Это позволяет вашей инфраструктуре адаптироваться к потребностям ваших приложений в ресурсах.

Для еще большей высокой доступности можно распределить рабочие узлы и балансировщики нагрузки по нескольким локациям и добавить резервные виртуальные машины для исходящего трафика. В руководстве пошагово описаны оба варианта.

Какой подход подходит для вашего проекта?
Выбор правильного подхода зависит не столько от размера вашего кластера, сколько от ваших конкретных требований:
  • Быстро разверните работающий кластер: если вы хотите начать работу с минимальными усилиями, hetzner-k3s или terraform-hcloud-kube-hetzner — хороший выбор. Оба позволяют развернуть кластер с официальными интеграциями за короткое время.
  • Инфраструктура как код с максимальным уровнем защиты: конфигурации Terraform на основе Talos особенно хорошо подходят, если вам нужна неизменяемая операционная система, полностью управляемая API, и полностью приватный кластер — как показано в приведенной выше эталонной архитектуре.
  • Полный контроль над каждым компонентом: если вы создаете кластер вручную или с помощью собственных инструментов автоматизации, вы можете установить HCCM и драйвер CSI напрямую и самостоятельно определить все детали — от топологии сети до стратегии хранения данных.
  • Декларативное управление кластерами: Если вы хотите автоматизировать создание, управление и обновление кластеров Kubernetes, поставщик API для кластеров Hetzner предлагает решение, разработанное специально для Kubernetes, как для облачных, так и для физических серверов.

Все четыре подхода основаны на одном принципе: Cloud Controller Manager, драйвер CSI, частные сети и балансировщики нагрузки. Поняв, как эти компоненты взаимодействуют друг с другом, вы сможете принимать обоснованные решения о выборе инструментов и более эффективно устранять неполадки в случае возникновения проблем.

Заключение
Kubernetes в облаке Hetzner сочетает в себе официальные интеграции с открытым исходным кодом и активную экосистему сообщества. HCCM преобразует концепции Kubernetes в облачные ресурсы, драйвер CSI обеспечивает постоянное хранилище, а частные сети и балансировщики нагрузки формируют сетевую основу. Такие проекты, как kube-hetzner, hetzner-k3s и модули Talos, основаны на этих компонентах и ​​позволяют быстро создавать готовые к работе кластеры. Для более подробного изучения вы можете найти исходный код всех этих проектов на GitHub, а также более 350 руководств в сообществе Hetzner — от вашего первого кластера до высокодоступной многолокационной архитектуры.
Важная информация для клиента: требуется обновление прошивки


Мы хотели бы сообщить вам, что твердотельные накопители Micron 5200, установленные в ваших выделенных серверах, могут демонстрировать снижение производительности после длительного использования:

По этой причине для решения этих проблем доступно обновление прошивки от производителя. Поэтому просим вас установить обновление как можно скорее.

Почему необходимо обновление?
Согласно имеющейся информации, скорость чтения и записи SSD-накопителей Micron 5200 может снизиться примерно после 65 000 часов работы. SSD-накопители с меньшим временем работы, как правило, не демонстрируют никаких проблем. Тем не менее, мы рекомендуем выполнить обновление в качестве профилактической меры.

Что вам следует сделать?
Пожалуйста, обновите прошивку до версии D1MU040 через систему восстановления, используя команду «update_crucial_micron». Вы можете использовать программное обеспечение smartctl для проверки установленной прошивки на вашем SSD. Для получения дополнительной информации посетите docs.hetzner.com/robot/dedicated-server/troubleshooting/serial-numbers-and-information-on-defective-hard-drives

Обновление занимает до пяти минут на один диск.
Дополнительно: Мы можем выполнить обновление за вас.
В качестве альтернативы, мы будем рады выполнить обновление в удобное для вас время с понедельника по пятницу с 6:00 до 22:00 (CET).
Если вы хотите, чтобы мы выполнили обновление, пожалуйста, отправьте подтвержденный запрос в службу поддержки через административный интерфейс Robot. Для этого сначала выберите затронутый сервер по адресу robot.hetzner.com/server Затем перейдите на вкладку «Поддержка», выберите категорию «Сервер – Нестабильная работа» в разделе «Техническая поддержка» и предоставьте следующую информацию:

Желаемый период технического обслуживания (время простоя до 60 минут)
Подтверждение того, что вы осведомлены о потенциальном риске потери данных.
Обратите внимание, что мы можем продолжить работу только на основании подтвержденного запроса в службу поддержки. Простого ответа на это письмо недостаточно.

По данным производителя, потеря данных, как правило, не ожидается. Однако мы настоятельно рекомендуем создать полную резервную копию ваших данных перед обновлением прошивки.

Каковы последствия обновления?
После успешной установки, как правило, восстанавливается полная производительность ввода-вывода SSD-накопителей. По заявлению производителя, описанные проблемы с производительностью после этого больше не будут возникать.

Спасибо за вашу поддержку.

С наилучшими пожеланиями,
Hetzner Online

Самостоятельно размещаемая система обмена сообщениями Matrix Messaging с использованием Synapse


Обмен информацией в режиме реального времени — одна из областей, где организации чаще всего в наибольшей степени зависят от внешних поставщиков программного обеспечения как услуги (SaaS). История чатов, вложения файлов, пользовательские каталоги и внутренние беседы могут храниться на инфраструктуре, управляемой Microsoft, Slack, Discord или другой третьей стороной. Для команд, которые хотят больше контролировать место хранения своих коммуникационных данных и работу своей инфраструктуры обмена сообщениями, Matrix предлагает открытую альтернативу.
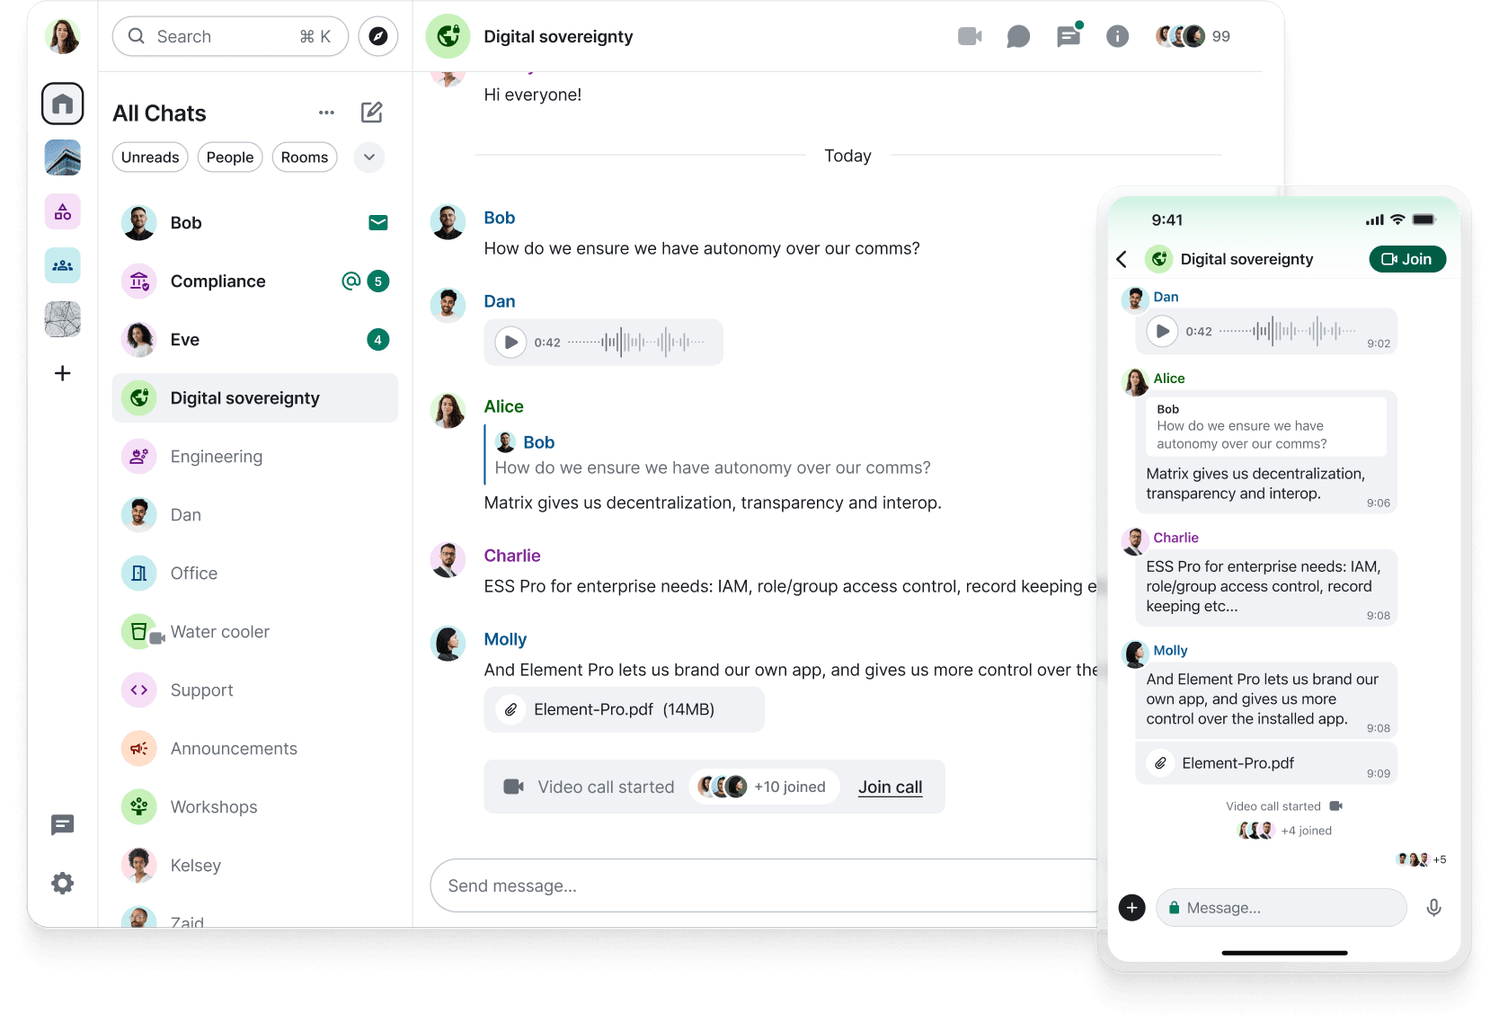
Synapse — наиболее широко используемая реализация домашнего сервера Matrix. Она предоставляет серверную инфраструктуру для пользователей Matrix, комнат, сообщений, федерации, аутентификации и хранения медиафайлов. Synapse разработан компанией Element и может быть размещен на вашей собственной инфраструктуре. В сочетании с клиентом Matrix, таким как Element, он может предоставить организации полноценную платформу для чата, позволяя при этом общаться с пользователями, размещенными на других серверах Matrix.

Информация о проекте Synapse:
Название: Синапс
URL: element-hq.github.io/synapse/
Лицензия: AGPLv3 или коммерческая лицензия Element.
Протокол: Матрица
Язык программирования: Python/Twisted с компонентами Rust.
Последняя версия: 1.163.0
База данных: рекомендуется PostgreSQL.
Коммерческое предложение: Synapse Pro/Element Server Suite


Домашний сервер для сети Matrix
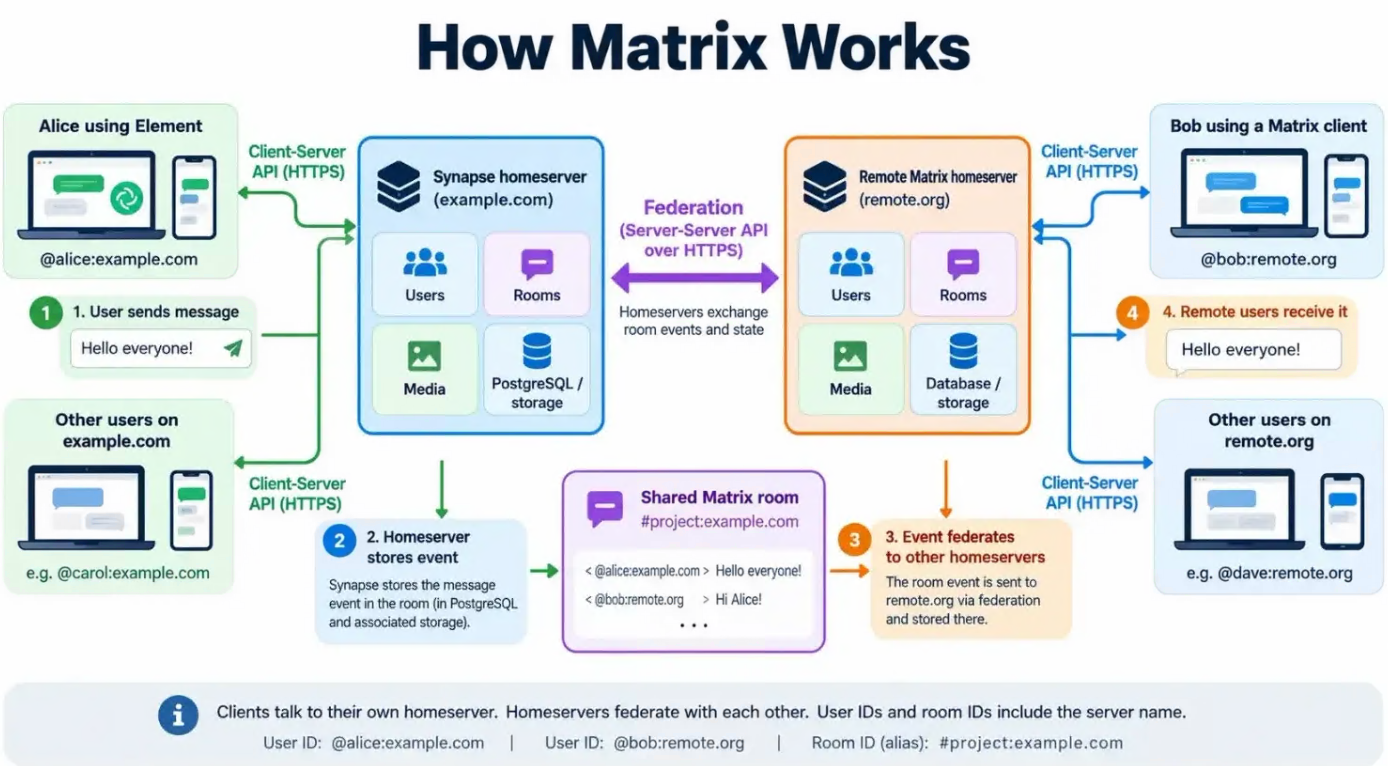
Matrix — это протокол федеративной связи. Вместо того чтобы каждый пользователь принадлежал одному центральному провайдеру, организации могут использовать собственные домашние серверы, продолжая при этом взаимодействовать с пользователями на других серверах.

Synapse реализует эту роль домашнего сервера. Когда пользователь создает учетную запись на сервере Synapse, его идентификатор Matrix ID содержит имя сервера (например, @alice:example.com). Комнаты, пользователи, сообщения, информация о членстве и другие события Matrix затем обрабатываются одним или несколькими домашними серверами, участвующими в беседе.

Для пользователей, самостоятельно размещающих свой сервер, выбор server_name является одним из важнейших решений во время установки. Это значение становится частью идентификаторов пользователей и адресов помещений и не может быть просто изменено позже. Таким образом, компания может использовать example.com в качестве своего идентификатора Matrix, в то время как физически Synapse работает по адресу matrix.example.com.

В Synapse обычно не входит сам интерфейс чата для пользователей. Пользователи подключаются через клиент Matrix, например Element, FluffyChat или другое совместимое приложение. Такое разделение между клиентом и сервером является одним из преимуществ Matrix: пользователи не привязаны к конкретному приложению только потому, что организация выбрала Synapse в качестве своего сервера.

Федерация
Федерация — это то, что отличает Matrix от многих систем чата с самостоятельным размещением. Если федерация включена, пользователи вашего сервера Synapse могут присоединяться к комнатам с пользователями, размещенными на других серверах, а удаленные серверы Matrix могут обмениваться событиями напрямую с вашим сервером.

В концептуальном плане Matrix ближе к электронной почте, чем к традиционной корпоративной платформе для чата. Две организации могут использовать собственную инфраструктуру, не имея учетных записей в одном и том же центральном сервисе.

Однако федерация несколько усложняет настройку сети. Другие серверы Matrix должны знать, как связаться с вашим домашним сервером. По умолчанию это определяется на основе настроенного параметра, но Matrix также поддерживает делегирование через файлы. Это позволяет использовать идентификаторы пользователей, например, в то время как сам Synapse работает под другим именем хоста, например, .server_name.well-known@alice:example.commatrix.example.com

Для частных установок федерацию также можно ограничить или отключить. Компании, которая хочет использовать Matrix только в качестве внутренней коммуникационной платформы, не обязательно предоставлять доступ к своему домашнему серверу более широкой федерации Matrix.

Развертывание и база данных
Synapse можно установить из пакетов, сред Python или контейнеров. Для развертывания в производственной среде на собственном сервере типичная архитектура включает Synapse, PostgreSQL, обратный прокси-сервер, постоянное хранилище медиафайлов и, при необходимости, сервер TURN (Traversal Using Relays around NAT) для надежного голосового и видеосоединения.

Synapse поддерживает SQLite для простых установок, но PostgreSQL следует рассматривать как стандартный выбор для производственных систем. PostgreSQL становится особенно важным по мере роста установки и необходим при масштабировании Synapse с использованием нескольких рабочих процессов.

Обычно перед Synapse устанавливается обратный прокси-сервер, такой как NGINX, Caddy, Apache или HAProxy. Он завершает TLS-соединение и предоставляет доступ к клиенту Matrix и конечным точкам федерации через стандартные порты HTTPS, в то время как сам Synapse прослушивает внутренний порт HTTP.

Для работы с медиаконтентом также требуется планирование. Изображения, видео, голосовые сообщения, документы и другой загруженный контент хранятся отдельно от базы данных PostgreSQL. Поэтому администраторам необходимы резервные копии как базы данных, так и хранилища медиафайлов. Резервного копирования только PostgreSQL недостаточно для полного восстановления.

Аутентификация и управление пользователями
Synapse может управлять собственными пользователями и паролями, но организации часто предпочитают интегрировать его с существующим поставщиком идентификационных данных. В зависимости от среды, Synapse может работать с механизмами аутентификации, такими как OpenID Connect и Security Assertion Markup Language (SAML), позволяя пользователям входить в систему через существующую платформу идентификации.

Настройка регистрации должна быть тщательно продумана. Домашний сервер, доступный из интернета, как правило, не должен разрешать неограниченную регистрацию учетных записей, если это не является преднамеренной частью сервиса. Вместо этого администраторы могут создавать учетные записи самостоятельно, использовать механизмы контролируемой регистрации или полагаться на внешнего поставщика идентификационных данных.

Конфигурация сервера также содержит конфиденциальные данные, такие как секретные ключи регистрации и ключи подписи. К ним следует относиться так же, как и к другим учетным данным инфраструктуры, и включать их в стратегию резервного копирования и управления секретами.


Масштабирование с помощью сотрудников
Для небольших или средних установок Matrix Synapse обычно следует запускать как единый процесс. Официального ограничения по количеству пользователей или событий в секунду не существует, поскольку нагрузка на системы Matrix значительно варьируется: 500 в основном простаивающих пользователей в небольших частных комнатах создают совершенно иную нагрузку, чем 500 пользователей, участвующих в больших объединенных комнатах. Как правило, хорошо сбалансированный единый процесс Synapse с PostgreSQL может без проблем обслуживать несколько сотен активных пользователей, а в системах с примерно 1000 зарегистрированными пользователями может и не быть необходимости вводить дополнительные рабочие процессы, если параллельная обработка и трафик объединения невелики.

Масштабирование рабочих процессов стоит рассмотреть, когда основной процесс Synapse регулярно приближается к 100% одного ядра ЦП, запросы /sync заметно замедляются, очереди федерации начинают отставать или задержка доставки сообщений увеличивается при нормальной пиковой нагрузке. Synapse в основном разделен на специализированные рабочие нагрузки, поэтому первым шагом часто является не создание нескольких идентичных экземпляров, а перенос ресурсоемких функций, таких как синхронизация клиентов, обработка федерации, обработка мультимедиа, фоновые задачи или сохранение событий, на выделенные рабочие процессы. В больших масштабах сохранение событий также может быть распределено по идентификатору комнаты между несколькими рабочими процессами.

Поэтому разумная модель планирования заключается в том, чтобы поддерживать более простую монолитную архитектуру в системах с десятками или несколькими сотнями активных пользователей и отслеживать их состояние перед добавлением сложных компонентов. Как только количество одновременно активных пользователей достигает нескольких сотен, частота запросов исчисляется сотнями в секунду или происходит загрузка ЦП основного процесса, использование рабочих процессов становится все более оправданным. Очень крупные развертывания с тысячами одновременно активных пользователей, как правило, следует проектировать с использованием нескольких рабочих процессов с самого начала. Все рабочие процессы по-прежнему используют общую базу данных PostgreSQL и взаимодействуют через механизмы репликации Synapse, обычно с использованием Redis, поэтому горизонтальное масштабирование Synapse не устраняет необходимость в базе данных соответствующего размера.

Для небольшого выделенного сервера Synapse не требуется особенно мощное оборудование. Домашний сервер для небольшой компании, семьи или сообщества может комфортно начать работу с 2-4 современными ядрами ЦП, 4-8 ГБ оперативной памяти и примерно 100-250 ГБ SSD или NVMe-накопителя, при условии умеренного использования федерации и работы с медиафайлами. Для среднего сервера с несколькими сотнями активных пользователей, большими федеративными комнатами или начальными рабочими процессами лучше подойдет около 6-12 ядер, 32-64 ГБ оперативной памяти и 500 ГБ-1 ТБ NVMe-накопителя. Для крупного сервера с тысячами активных пользователей и несколькими рабочими процессами Synapse разумной отправной точкой являются 16-32 ядра, 64-128 ГБ оперативной памяти и 1-4 ТБ быстрого NVMe-накопителя. Однако в таком масштабе разделение PostgreSQL, рабочих процессов Synapse и хранилища медиафайлов между несколькими системами обычно становится более полезным, чем дальнейшее вертикальное масштабирование одного сервера. Во всех случаях быстрое хранилище на SSD-накопителях важнее больших объемов медленных дисковых накопителей, поскольку производительность PostgreSQL оказывает существенное влияние на быстродействие Synapse.

Безопасность и сквозное шифрование
Matrix поддерживает сквозное шифрование для частных разговоров и комнат. В зашифрованной комнате содержимое сообщений шифруется клиентами до того, как они достигнут Synapse, то есть домашний сервер хранит и пересылает зашифрованные события, а не содержимое сообщений в открытом виде.

Это важное различие при самостоятельном размещении. Использование собственного сервера Synapse дает вам контроль над данными учетной записи, метаданными комнаты, медиафайлами, инфраструктурой и хранением данных, но сквозное шифрование по-прежнему в основном зависит от клиентов Matrix и управления ключами.

Сам домашний сервер по-прежнему имеет критически важное значение с точки зрения безопасности. Администраторам следует обновлять Synapse и PostgreSQL, ограничивать доступ к административным API, защищать механизмы регистрации, использовать HTTPS, создавать резервные копии ключей подписи и избегать прямого доступа к внутренним сервисам через Интернет.

Обзор и перспективы
Synapse — наиболее зрелый вариант для организаций, желающих использовать собственный домашний сервер Matrix. Его главные преимущества — совместимость с экосистемой Matrix, федерация, поддержка сквозного шифрования, развитые функции администрирования и возможность масштабирования от небольшой установки на одном сервере до гораздо более крупных развертываний.

Компромисс заключается в сложности. Серьезная установка включает в себя гораздо больше, чем просто запуск контейнера чата: необходимо учитывать PostgreSQL, DNS, TLS, федерацию, хранилище медиафайлов, резервное копирование, управление идентификацией и, при необходимости, инфраструктуру TURN.

В целом, Synapse отлично подходит для команд, которые хотят контролировать свою коммуникационную инфраструктуру, не создавая при этом еще один изолированный «островок» обмена сообщениями. Для тех, кто самостоятельно управляет вспомогательной инфраструктурой, Matrix и Synapse предлагают привлекательную альтернативу централизованным коммуникационным платформам.

Четыре графических процессора в одном сервере: это новый многопроцессорный сервер Hetzner GEX430


Представляем вашему вниманию ежемесячный обзор интересных новостей и полезных советов от Hetzner! Приятного чтения!

Четыре видеокарты в одном сервере: это новый GEX430
Hetzner представляет GEX430 — свой первый высокопроизводительный сервер с несколькими графическими процессорами. Четыре графических процессора NVIDIA RTX PRO 6000 Blackwell Max-Q с общим объемом 384 ГБ видеопамяти GDDR7 ECC делают его по-настоящему высокопроизводительным сервером для ресурсоемких задач в области искусственного интеллекта. GEX430 обеспечивает мощность, необходимую для профессиональных приложений, таких как обучение ИИ, вывод результатов для больших языковых моделей (LLM), тонкая настройка или ресурсоемкие задачи рендеринга и моделирования.

Благодаря огромному объему графической памяти, он способен запускать большие модели ИИ и обрабатывать множество запросов одновременно. Он идеально подходит для компаний, которые, например, хотят использовать чат-боты с ИИ в службе поддержки клиентов или предоставлять внутренние информационные помощники для большого числа сотрудников.

Четыре высокопроизводительных графических процессора оснащены тензорными ядрами 5-го поколения, ядрами RT 4-го поколения и поддерживают FP4. В GEX430 также установлен процессор Intel Xeon Gold 5412U “Sapphire Rapids” с 24 ядрами и 48 потоками, 128 ГБ регистровой оперативной памяти DDR5 ECC и два быстрых твердотельных накопителя NVMe Datacenter Edition (Gen4) объемом 1,92 ТБ каждый.

Приобретите этот сервер за 3 599,00 евро / 4 199,00 долларов США в месяц, включая IPv4-адрес. Стоимость установки также составляет 3 599,00 евро / 4 199,00 долларов США.
www.hetzner.com/dedicated-rootserver/matrix-gpu/

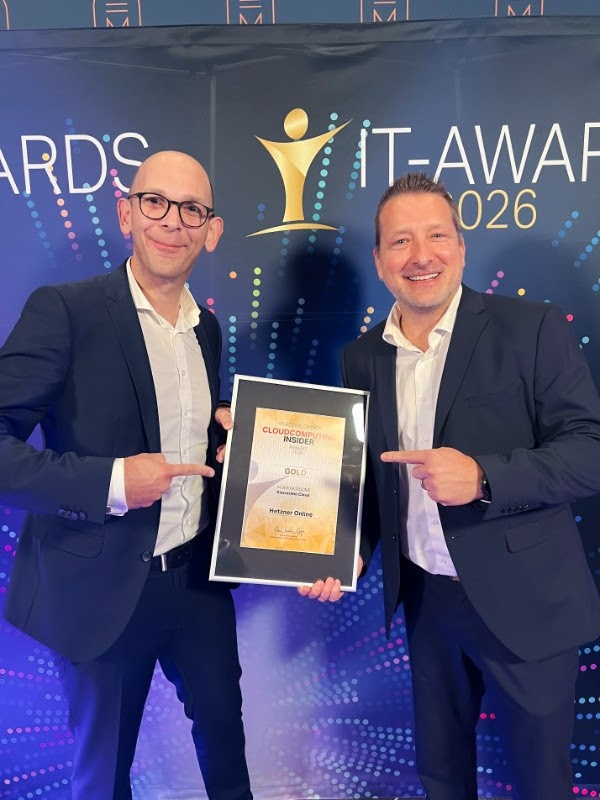
Компания Hetzner получила премию IT Awards 2026 за проект «Суверенное облако»
На церемонии вручения наград IT Awards 2026, организованной Vogel IT-Medien, компания Hetzner впервые получила золотую награду в категории «Суверенное облако». Церемония награждения состоялась 15 октября 2026 года в Аугсбурге, Германия. В этом году читатели различных IT-порталов Vogel IT-Medien отдали в общей сложности 60 000 голосов, выбирая своих предпочтительных IT-провайдеров.


Эта награда подчеркивает, насколько важны для пользователей независимые, безопасные и высокопроизводительные облачные инфраструктуры. Благодаря собственным центрам обработки данных в Нюрнберге, Фалькенштайне и Хельсинки, мы предлагаем европейскую альтернативу для всех, кто ценит защиту данных и цифровой суверенитет.

Мы особенно рады получить эту награду непосредственно от избирателей из ИТ-сообщества. Огромное спасибо всем, кто проголосовал за нас и оказал нам доверие!

Взгляд за кулисы облачной сетевой инфраструктуры Hetzner
Наша сетевая архитектура — результат многолетней разработки и собственных инженерных разработок. Но как на самом деле работает лежащая в её основе технология?

В нашей статье в блоге мы покажем вам ключевые компоненты нашей текущей сетевой инфраструктуры, как она развивалась в прошлом и какое отношение немецкое слово «Flusskrebs» имеет к нашему подходу «сделай сам».

Саммит Хетцнера 2026: Видеообзор
Саммит Hetzner 2026 позади, и мы можем оглянуться назад на этот чрезвычайно успешный день. В нашем видеообзоре мы вернем вас в Фалькенштайн и покажем самые яркие моменты мероприятия. Ощутите особую атмосферу саммита Hetzner 2026: от сессий и экскурсий по дата-центрам до многочисленных личных встреч.

Хотите узнать больше? Ознакомьтесь с нашей статьей в блоге, где вы найдете дополнительную информацию о мероприятии.
www.youtube.com/watch?v=y3d4G1HB9QY

Учебное пособие: Настройка собственного сервера резервного копирования с использованием Minarca и RAID1 на Debian

Хотите самостоятельно управлять резервными копиями и хранить их, не прибегая к внешним облачным сервисам?

В этом руководстве показано, как настроить собственный сервер резервного копирования на Debian, используя программное обеспечение с открытым исходным кодом Minarca и RAID1.

Шаг за шагом вы узнаете, как настроить хранилище, установить Minarca, защитить свой сервер и настроить автоматическое резервное копирование.
community.hetzner.com/tutorials/minarca-backup-server-raid1/

Компания Hetzner представила свой первый многопроцессорный сервер с четырьмя графическими процессорами NVIDIA Blackwell


С моделью GEX430 хостинг-провайдер Hetzner расширяет свой портфель, добавляя свой первый сервер с несколькими графическими процессорами. Новая модель оснащена четырьмя графическими процессорами NVIDIA RTX PRO 6000 Blackwell Max-Q и 384 ГБ графической памяти GDDR7 ECC. Этот высокопроизводительный выделенный сервер специально разработан для предприятий и профессиональных пользователей, которым требуется высокая вычислительная мощность для обучения ИИ, вывода больших языковых моделей (LLM), тонкой настройки, а также для сложных задач рендеринга и моделирования.

Четыре высокопроизводительных графических процессора позволяют запускать особенно ресурсоемкие модели ИИ и работать с несколькими моделями параллельно. Это позволяет компаниям объединять различные приложения ИИ на одном сервере. Например, одна языковая модель может использоваться для поддержки клиентов, другая — для помощи разработчикам в программировании, а третья — для автоматической обработки входящих запросов. Эти задачи могут быть распределены между отдельными графическими процессорами.

Доступная графическая память также играет центральную роль в выполнении задач искусственного интеллекта. Требования к памяти значительно возрастают, особенно при обработке большого объема одновременных запросов. Благодаря общему объему видеопамяти в 384 ГБ, GEX430 предлагает значительные ресурсы для обработки больших языковых моделей и одновременного обслуживания множества пользователей. Это выгодно, например, компаниям, использующим чат-боты с искусственным интеллектом в службе поддержки клиентов или внутренним информационным ассистентам для своих сотрудников.

Особенно когда речь идет о выводе данных в рамках искусственного интеллекта, графическая память так же важна, как и вычислительная мощность. Чем больше запросов обрабатывает модель одновременно, тем больше памяти ей, как правило, требуется. Благодаря четырем графическим процессорам и общему объему видеопамяти в 384 ГБ, GEX430 предлагает достаточный запас для ресурсоемких приложений ИИ. Компании могут использовать его, например, для параллельного запуска нескольких языковых моделей или для предоставления своих услуг ИИ большому количеству одновременно работающих пользователей
говорит Стефан Вайберг, менеджер по продуктам в Hetzner.

Каждая из четырех видеокарт NVIDIA RTX PRO 6000 Blackwell Max-Q оснащена 96 ГБ видеопамяти GDDR7 ECC и поддерживает современные технологии искусственного интеллекта, такие как тензорные ядра пятого поколения, ядра RT четвертого поколения и FP4. Конфигурация видеокарт дополнена процессором Intel Xeon Gold 5412U с 24 ядрами и 48 потоками, 128 ГБ регистрируемой памяти DDR5 ECC и двумя твердотельными накопителями NVMe Datacenter Edition (Gen4) объемом 1,92 ТБ каждый.

Благодаря GEX430 компании могут запускать модели искусственного интеллекта с открытым исходным кодом, такие как GLM, Mistral или Qwen, на выделенном оборудовании в пределах ЕС, не полагаясь на внешние платформы ИИ. При соответствующей настройке конфиденциальная информация, такая как внутренние документы, данные клиентов или исходный код, остается в собственной серверной среде компании. Это создает благоприятные условия для выполнения индивидуальных требований по защите данных и соблюдению нормативных требований. В то же время пользователи сохраняют контроль над используемыми моделями, своими данными и конфигурацией инфраструктуры.

Маршрутизатор Hetzner GEX430 доступен по цене 3 599,00 евро / 4 199,00 долларов США в месяц, включая IPv4-адрес. Единовременная плата за настройку также составляет 3 599,00 евро / 4 199,00 долларов США.

Дополнительную информацию можно найти по адресу www.hetzner.com/dedicated-rootserver/matrix-gpu/

Все цены указаны без НДС.

Важная информация для клиентов: обновление PHP в связи с критическими уязвимостями безопасности CVE-2026-109618 и CVE-2026-109619


Как вы, вероятно, уже слышали из СМИ, в PHP были обнаружены две критические уязвимости. Разработчики PHP выпустили обновления безопасности для устранения этих проблем. Данные обновления призваны предотвратить выполнение злоумышленниками вредоносного кода в затронутых системах при определенных условиях.

Поскольку вы используете выделенный сервер и/или облачный сервер, вы самостоятельно несете ответственность за установку обновлений безопасности. Если вы используете PHP, мы настоятельно рекомендуем как можно скорее установить доступные обновления безопасности на соответствующие системы: www.php.net/archive/2026.php#2026-10-21-5

Кроме того, внимательно следите за своими системами на предмет подозрительной активности и возможных признаков атаки.

Дополнительную информацию и актуальные сведения можно найти на нашем сайте о состоянии сервисов: status.hetzner.com/incident/f4144d55-38c3-48d1-8664-7a3429355cd7

Благодарим вас за сотрудничество.
С уважением,
Hetzner Online

Срочное техническое обслуживание всех основных маршрутизаторов


В настоящее время мы проводим срочное техническое обслуживание всех наших основных маршрутизаторов. Обслуживание проводится поочередно. В ходе этих работ снижается общая избыточность сети. Мы не ожидаем перебоев в работе, но вы можете заметить увеличение задержки.

Это техническое обслуживание обеспечивает долгосрочную безопасность и стабильность нашей инфраструктуры. Благодарим вас за понимание и терпение.