Рейтинг
0.00

H3LLO CLOUD

2 читателя, 44 топика

Как и почему мы проектировали последнее коммерческое облако России и от какого буллшита избавились по ходу


Меня часто спрашивают:
— Почему к вам, а не к гигантам?

Ответ простой:
— Мы не охреневшие.

Сначала я хотел рассказать про нашу сеть хранения, которая быстрее, чем скорость записи на RAID 0, про удивительное конкурентное преимущество «Трезвая поддержка», про 400G‑линки на каждом хосте, про изоляцию сетей и топологию Dragonfly+ с full mesh на уровне зон доступности. Но всё‑таки я решил: самое главное, что мы не охреневшие.

Это главная штука, которую мы решили для себя со старта.

А теперь расскажу, что же мы последовательно делали и что запускаем.
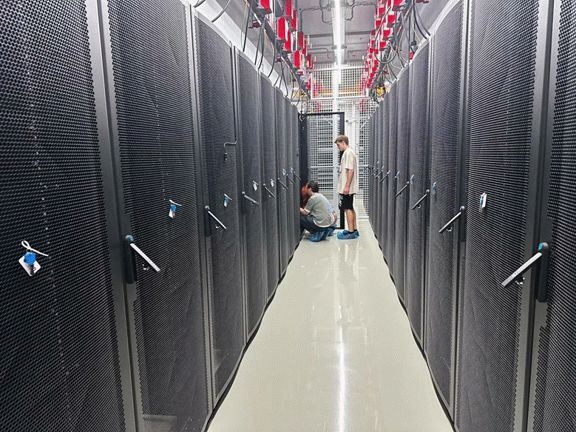
Это прототип нашего облака, сейчас ЦОД выглядит чуть иначе
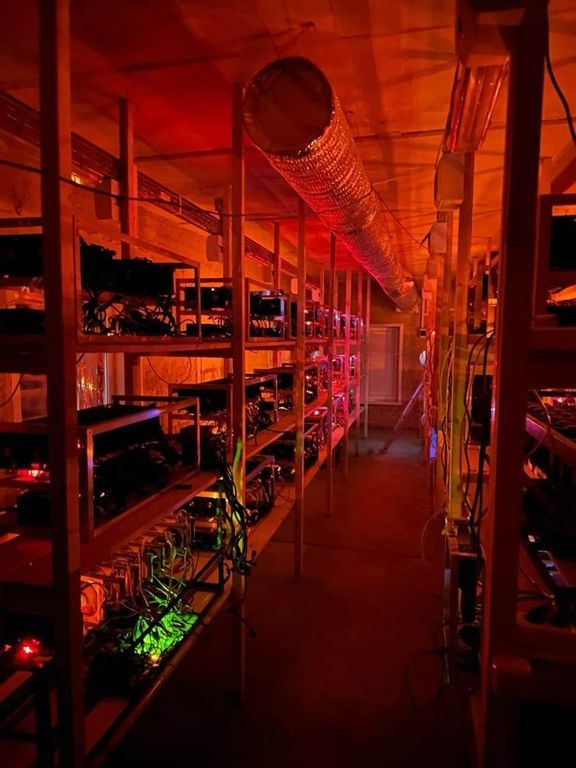
Вот примерно так одна из площадок выглядит

Площадки и зоны доступности
Основные площадки — это три наших локации в Москве в пределах МКАДа (часть вообще внутри Садового) с новым типом инфраструктуры — когда снаружи непонятно, что это ЦОД, и инфра не собирается в маленький плотный кубик в очевидном месте.

Плюс два московских дата‑центра: IXcellerate North (Север) и IXcellerate South (Юг). По мере готовности двух наших площадок мы мигрируем из IXcellerate в них. Сами точки присутствия мы тоже хитро организовали. Заводить 50 разных операторов в своё свежеоборудованное здание — неприкольно. Поэтому у нас понятный транзитный процесс, который мы скоро завершим: остаётся бордер для стыковки с внешними сетями и пара серваков для резерва внутренней инфры в одной точке, такой же бордер и пара серваков в другой.

И между ними обеими, а также между основной точкой, где всё развёрнуто, проложена хорошая оптическая связь независимыми маршрутами.

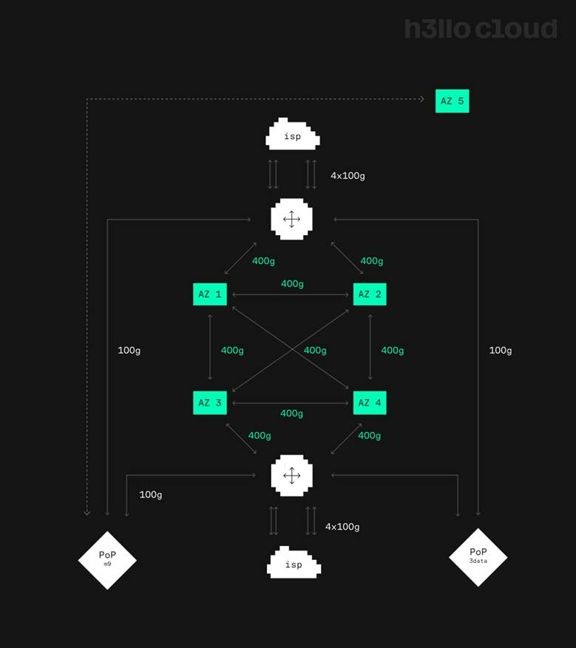
Итого у нас получается 5 зон доступности (по 2 внутри IXcellerate/новых и одна на самой первой локации), будет 6. Зоны доступности — это полностью изолированные инфраструктуры: свои непересекающиеся сетевые железки, свои отдельные энерговводы, своё охлаждение, свои источники бесперебойного питания. Полностью. Выход из строя оборудования в одной зоне доступности никак не должен затронуть другую.

Кроме того, у нас есть ЦОД в Александрове, где развёрнуты AZ с воздушным и жидкостным охлаждением, включая иммерсионное. Это отдельные зоны, потому что там разные системы охлаждения и разные физические помещения. Топим мы только старое и десктопное железо, потому что найти серверное оборудование, сертифицированное под иммерсионное охлаждение, практически нереально. Там мы не ставим коммерческих клиентов облака.

Также у нас была точка присутствия в дата‑центре 3data, из‑за которой нас называли перекупами, и, что очень важно, на М9 — главном телекоммуникационном узле в России. Здесь мы можем быстро сделать физический линк с кем угодно, организовать прямой коннект для клиентов, затащить любого оператора, которого нет в основных ЦОДах (хотя там есть практически все). Фактически это наш третий Meet‑Me Room.

Сейчас мы подключаемся к точке обмена трафиком MSK‑IX. Зачем? Это даёт невероятную гибкость: мы можем пириться с кем угодно, как угодно, очень быстро и легко. Можно дать трафик на пользователей любого провайдера напрямую, не поднимаясь на вышестоящих операторов. Это как ещё один Meet‑Me Room, но уже виртуальный.

Связь
Между ключевыми площадками (обоими IXcellerate, М9, 3Data и офисом) мы взяли тёмное волокно, которое нам любезно предоставил «Мастертел», и засветили его на 400 Гбит/с. Про новое — деталей не будет, простите, мы решили поменьше открывать варежку про такие вещи, но уровень тот же.

В будущем планируем расширять ёмкость с помощью DWDM.

Связь с Александровом пока реализована через 10-гигабитный интернет от Ростелекома и 10-гигабитный L2 VPN‑канал до М9. Суммарной пропускной способности в 20 Гбит/с для этой площадки более чем достаточно. Работаем над строительством оптических трасс, но это небыстрая история.

Для сравнения: пиковый трафик всего Cloud.ru, по словам их бывшего сетевого инженера, не превышал 40 Гбит/с. У нас восемь внешних аплинков по 100 Гбит/с.

В каждом из ключевых ЦОДов ядро сети вынесено в отдельный независимый по питанию и инфраструктуре модуль — Meet‑Me Room. У нас прямо трассы с кросс‑панелями: всё красиво разведено. В каждом MMR у нас по четыре линка от разных провайдеров (два основных, два резервных). Мы специально проверяли, чтобы их трассы физически не пересекались и не приходили в один и тот же маршрутизатор.

Суммарная ёмкость каналов — 800 Гбит/с. Это мегаоверкилл, но такой запас — это фундамент для нашего собственного сервиса анти‑DDoS. Мы сейчас внедряем его на базе коммерческой версии одного open‑source‑решения, и, скорее всего, на старте он будет встроенным и бесплатным для всех клиентов.

Вся эта сложная система из AZ, MMR и ЦОДов построена по топологии Dragonfly+. Если упрощать, то каждая AZ и каждый MMR — это независимая группа узлов. В группе серверов — классический Клоз (Node‑Leaf‑Spine). Между всеми группами — full mesh. Это даёт потрясающую отказоустойчивость.

Представим себе худший сценарий: в одном из ЦОДов IXcellerate полностью выходит из строя MMR. Это значит, что все четыре внешних аплинка в этом ЦОДе отваливаются. Что произойдёт? Ничего критичного. Во‑первых, каждая зона доступности в этом упавшем ЦОДе напрямую связана с зонами доступности в другом ЦОДе через те самые 400-гигабитные каналы. Трафик просто пойдёт через бордер второго ЦОДа. Система спроектирована так, чтобы пережить отказ любого компонента.

Железо
Одно‑ и двухюнитовые серверы HPE 11-го поколения. На борту у них:
  • Процессоры Intel Xeon 5-го поколения.
  • По 2 терабайта оперативной памяти DDR5.
  • NVMe для операционной системы и как сверхбыстрые локальные диски для кластерных баз данных (когда у вас кластерная СУБД, ей не нужен сетевой диск, а локальный NVMe даёт сумасшедшую скорость) и SSD для объединения в storage‑сеть.
  • Опционально — GPU. Сейчас это в основном NVIDIA, уже наладили закупку B300 для задач инференса и нашей будущей дата‑платформы. GPU мы продаём не поминутно, а с долгосрочным коммитом — минимум на год.

Следующая закупка — это либо HPE 12-го, либо Dell 17-го поколения. Там уже Xeon 6-го поколения.

В сервере стоят две сетевые карты по два порта 100G. Каждая карта подключена к двум разным ToR’ам (лифам). Лифы, в свою очередь, соединены с двумя спайнами. Отказ любого кабеля или коммутатора не приводит к потере связности. Ну и, конечно, в каждой стойке — два независимых ввода питания. Сети задублированы на всех уровнях. При этом нам доступна вся полоса в 400G.

Каждый хост соединяется с тремя независимыми сетями:
  • Управление железом (iLO/MGT): отдельная полностью изолированная сеть для управления физическими устройствами.
  • OOB: ещё одна физически изолированная сеть с линками 2×25G для управляющих команд, обновлений, метрик и внутреннего доступа хостов. Даже если основная фабрика ляжет, то доступ к хостам останется.
  • Основная фабрика: 400G‑сеть для Control Plane и Data Plane. Через Control Plane общаются наши кластеры. Сервисы управления говорят кластеру нагрузок, какие именно ресурсы должны быть и в каком состоянии (да, кубер оперирует понятием «желаемое состояние»). Это отдельный сегмент. Data Plane (SDN + SDS) — это второй отдельный сегмент 400G‑фабрики для трафика клиентских виртуальных машин и сетевых дисков.

Приоритеты трафика разграничиваются через QoS. Сами сети изолируются либо физически, либо через VRF без route‑leaking. Помимо Data Plane и Control Plane, есть ещё четыре служебных сегмента, но о них — как‑нибудь отдельно.

Доступность
Мы делаем гиперскейлер. Гиперскейлер — это про доступность и отказоустойчивость. В нашем случае — на уровне виртуальной машины. Под ней может ломаться что угодно, но если она может быстро и бесшовно мигрировать с сервера на сервер — это норм. Сейчас наша цель — обеспечивать SLA на уровне 99,5%.

К концу года мы целимся в SLA 99,99% для двух виртуальных машин, запущенных в разных зонах доступности, и 99,97% — для одной виртуальной машины или любого другого сервиса. Для дата‑центра уровня TIER-3 — это 99,982% доступности. Наши 99,99% для разнесённых виртуалок — это уже выше. А стоят они в двух сертифицированных TIER-3-ЦОДах и одном несертифицированном.

Выше TIER-3 не прыгнуть. Плюс доступность там считается без учёта времени простоя сети, то есть просто по включению. Ну, точнее, можно поискать Tier-4, но оно того обычно не стоит.

У нас доступность считается с сетью. И это доступность сервисов ВМ, а не пинг до гипервизора. Чтобы ваш сервис упал всего на несколько минут в год, даунтаймы ЦОДа, даунтаймы интернет‑провайдера и даунтаймы самого сервера должны совпасть в одном временном окне. Но так не бывает. Даже надёжный сервер Hewlett‑Packard 12-го поколения в первый год эксплуатации требует около четырёх часов регламентного простоя, плюс его нужно перезагружать для апдейтов.

В облаке таких проблем нет.

Вероятно, мы нарушим это обещание. Такое случается при авариях или идиотских проблемах. Сейчас, на период обкатки в продакшене, уровни гарантий для публичного облака выглядят у нас так:
  • Если доступность между 99,5 и 99% — 10% скидки.
  • Если доступность 95–99%, то 15% скидки.
  • Ниже 95% — 30% скидки.

Убедившись, что с этим справляемся, мы перейдём к более жёстким SLA:
  • Если доступность между 99,97 и 99% — 10% скидки.
  • Если доступность 95–99%, то 30% скидки.
  • Ниже 95% — расчётный период бесплатно.

Для приватных инсталляций возможны ещё более жёсткие гарантии, обсуждаемые в индивидуальном порядке.

По БПЛА‑форсмажорам пока не отвечу, мы в переговорах со страховщиками.

Как же мы достигаем такой надёжности? За счёт правильной физической архитектуры и живой миграции. В этом и есть смысл облаков — воткнуть сервисы в две разные зоны доступности и получить надёжность выше, чем у любого физического ЦОДа. Потому что упасть может что угодно: отдельный сервер, стойка, вся автономная зона, ЦОД или даже целый регион. Наша задача — минимизировать вероятность такого события и его последствий.

Софт
А теперь самое интересное — софт. Мы не используем OpenStack, CloudStack, китайский Z‑Stack или модный Cozy (как мы его прозвали, «козий стек»). Наша платформа — полностью собственная разработка. Почему? Потому что мы всё это попробовали и поняли, что лучше не надо. Если вы нас читаете, то видели часть этих экспериментов.

Любой фреймворк — это компромисс. Ты получаешь что‑то «из коробки», но быстро упираешься в его ограничения. Например, в нижележащей системе есть нужная тебе функция, а API фреймворка её ещё не поддерживает. И ты ничего не можешь с этим сделать. Мы прошли этот путь на раннем этапе беты, когда использовали гибрид из Cozy Stack и наших сервисов, и в итоге приняли решение выпилить его полностью и написать всё с нуля.

Ещё одна важная причина — сертификация. Ни один OpenStack никогда не пройдёт серьёзную сертификацию ФСТЭК или 152-ФЗ УЗ-1.

А собственная разработка может. Мы сейчас как раз этим и занимаемся. Конечно, есть нюанс: при каждом обновлении системы сертификат ФСТЭК нужно получать заново, а это дорого — услуги испытательной лаборатории стоят порядка 400+ тысяч рублей за раз. Как показывает опыт, многие коллеги получают его один раз на какую‑то версию, вывешивают на сайт, а в продакшене крутится уже совсем другое. Мы же для приватных инсталляций будем поддерживать сертифицированные версии, потому что нашли более правильный путь беспрерывной сертификации изменений.

В основе — Kubernetes. Причём мы используем его не только для управляющего контура (control plane), но и для оркестрации всей клиентской нагрузки, включая виртуальные машины. Когда мы накидывали архитектуру с собственным оркестратором, то в какой‑то момент посмотрели на результат и поняли: «Так вот же он, Кубер!» Зачем изобретать велосипед, если есть прекрасный стек технологий, который отлично с ним интегрируется: kubevirt — для виртуализации KVM, Linstor — для SDS, и не без боли — Kube‑OVN — для SDN.

Правда, это не навсегда. Для публичного облака мы уже видим пределы Kubernetes по масштабу и перепиливаем отдельные компоненты. Сейчас переходим на мультикластерную систему.

Для виртуализации мы выбрали самый нативный и стандартный для Linux‑мира стек: KVM — в качестве гипервизора и QEMU — для эмуляции аппаратного обеспечения. Это компоненты, встроенные прямо в ядро Linux. Некоторые конкуренты используют Xen или VMware, но сегодня KVM — это де‑факто стандарт индустрии, и изобретать тут что‑то своё просто не имеет смысла.

Хранение
Вычисления и хранилище находятся на одних и тех же физических серверах. За хранение отвечает система Linstor с DRBD под капотом. Это гиперконвергентная архитектура.

Работает это так: все SSD‑диски на сервере отдаются JBOD. Да, вы не ослышались: JBOD, который не даёт никакой отказоустойчивости, но обеспечивает максимальную производительность. Мы превращаем диски в одну большую быструю «мясорубку». Linstor поверх этого массива нарезает тома для виртуальных машин (с помощью LVM‑thin).

Надёжность обеспечивает DRBD. В тот момент, когда Linstor создаёт том на одном сервере, он тут же создаёт и его полную синхронную реплику на другом, который находится в другом домене отказа, и опционально — в другой зоне доступности. Наше хранилище знает топологию облака и понимает, что реплицироваться нужно в соседнюю геоточку.

Если один сервер (или все его диски разом) выходит из строя, то система мгновенно переключается на работу со второй репликой. Пользователь даже не заметит этого. Репликация синхронная, но за это приходится платить оверхедом. Вообще DRBD поддерживает три схемы репликации: Protocol A — полностью асинхронная, Protocol B — синхронная in‑memory (операция считается выполненной при записи на primary‑диске и при записи в память на ноде с secondary‑диском) и Protocol C — полностью синхронная.

Оверлейные сети
На заре нашего проекта, в бете, всё было просто: каждая виртуалка получала белый IP‑адрес. Это было щедро, но небезопасно: никакой изоляции между клиентами на сетевом уровне. Естественно, нас это не устраивало.

Мы выбрали Kube‑OVN для создания программно‑определяемой сети (SDN). Решение отличное, но очень непростое в настройке. Наш сетевик пытался расспросить всех, до кого только мог дотянуться (а в списке были ведущие архитекторы крупных российских клаудов), а они лишь пожимали плечами. Помню, я потратил два дня на траблшутинг проблемы, почему пакеты не ходят из VPC во внешний мир при правильно настроенном (прямо по инструкции) шлюзе. Пришлось обвесить всё tcpdump'ом и на уровне каждого пакета отслеживать его путь.

Проблема оказалась в связке конфигурации VPC и NAT Gateway — виртуального маршрутизатора, который стоит на границе VPC и Интернета. Пакеты извне на него приходили, он их отправлял внутрь VPC, адресат их получал, а вот ответные пакеты обратно не уходили. И хоть ты тресни! Оказалось, что вещь, которую в документации преподносили как опцию — статические маршруты, — на самом деле является обязательным компонентом. Без прописанных вручную маршрутов к этому NAT Gateway ничего не работало. Мы победили эту проблему.

Следом мы научили систему анонсировать белые IP‑адреса клиентов по BGP. Дефолтный способ работы (ARP) нам не нравится, потому что это L2, а в нашем масштабе он был бы ещё и растянутым, что есть конкретный антипаттерн. Буквально до текущей версии Kube‑OVN не умел корректно анонсировать /32 специфики по BGP и хотел слать целые подсети. Сейчас всё работает как надо. Когда NAT Gateway получает IP‑адрес, с ноды, где он запущен, улетает анонс маршрута /32 нашему пограничному маршрутизатору с помощью BGP‑спикеров. В результате IP становится доступен из всего мира.

Сейчас в арсенале сетей у вас есть:
  • Неограниченное количество VPC и подсетей.
  • SNAT: все машины внутри VPC могут выходить в интернет через один общий белый IP.
  • DNAT: можно пробрасывать трафик с внешнего IP на разные машины и порты внутри VPC по гибким правилам.
  • FIP: можно привязать IP к хосту в формате 1:1.
  • Static Routes: можно задать любые статичные маршруты внутри VPC между подсетями.
  • Policy‑based Routes: то же самое, что и static, но с более гибкой настройкой по условиям.
  • Security Groups (читай: файрвол), правила которых применяются на уровне шлюза или отдельного хоста. Тоже без ограничений.

Для оптимизации производительности мы применяем продвинутые приёмчики, среди которых — Mellanox ASAP для аппаратного ускорения и eBPF‑bypass для трафика между ресурсами на одной ноде.

По умолчанию мы создаём рабочую конфигурацию: VPC, сабнет, NAT Gateway с белым IP, SNAT‑rule и Static Route. Всё работает «из коробки». Но мы даём пользователям и тонкие настройки. Правда, тут есть нюанс: если вы не понимаете, что делаете, то появляется миллион способов выстрелить себе в ногу. Поэтому наш совет: если не уверены, то используйте дефолтные настройки.

S3, IAM, биллинг и бэкапы
Мы даём S3-совместимый API для объектного хранилища, чтобы клиенты могли легко перенести свои приложения с Amazon AWS, просто сменив эндпоинт.

Сейчас для скорости мы развернули его на базе Ceph и RADOS Gateway. Но, честно говоря, RADOS Gateway — это так себе решение. Оно начинает деградировать при большом количестве объектов и упирается в производительность одного Ceph‑кластера. Поэтому мы уже пишем собственный API‑шлюз. Он будет работать с группой независимых Ceph‑кластеров, распределяя нагрузку и данные между ними. Этот шлюз будет взаимодействовать с RADOS, который, в отличие от RADOS Gateway, как раз хорош. Это позволит нам масштабироваться практически бесконечно и проще управлять репликацией между автономными зонами.

Сервис управления пользователями и правами доступа (IAM) мы писали с нуля, вдохновляясь архитектурой AWS. Нас интересовало, как они обрабатывают более миллиарда запросов в секунду. Чтобы не перегружать основной сервис, существует легковесный Authentication Runtime Service. Он кэширует необходимые данные и выполняет быструю проверку прав доступа для каждого API‑вызова, будь то чтение объекта из S3 или создание виртуальной машины.

Ключевой принцип безопасности, который мы заложили: API‑ключ можно увидеть только один раз при создании. Дальше он не подлежит чтению, его можно только проверить. Никто, даже мы, не сможет его восстановить. Потерял — перевыпускай новый. Это не шутка. Умный учится на чужих ошибках. Перевыпустить ключ — дело двух кликов.

Биллинг — целая пачка микросервисов, которая должна работать строго консистентно и идемпотентно. Идемпотентность означает, что случайный повторный запрос на списание не спишет деньги дважды. Система должна корректно обрабатывать пополнения через платёжные шлюзы, не допуская фрода, и, конечно же, автоматически останавливать ресурсы пользователя при нулевом балансе. Да, на старте у нас была забавная ситуация, когда ресурсы при нулевом балансе не прибивались. Тем, кто нашёл эту дыру, мы разрешили пользоваться ею до исправления). Багбаунти, кстати, пока нет (хотя коллеги и бета‑тестеры уже накидали пару раз в панамку), про неё думаем.

Бэкапы реализованы через снапшоты. Linstor, используя LVM‑thin, умеет делать мгновенные снимки дисковых томов. Эти снапшоты мы выгружаем в наше S3-совместимое объектное хранилище. Снапшоты, кстати, тоже есть — можно зафиксировать состояние диска в моменте и разворачивать из него виртуалки сколько угодно.

Важно, что хранилище для бэкапов работает на совершенно других, выделенных серверах. Кроме того, у нас есть партнёрство с «Киберпротектом» (это, если что, бывший Acronis, который разделился на Acroni~1 и Acroni~2 с момента начала санкций) для защищённых резервных копий в отдельном хранилище. Прямо под капотом их нет, но по запросу мы их включим.

А для самых параноидальных клиентов мы рассматриваем внедрение ленточных хранилищ. Звучит как анахронизм, но на самом деле — очень крутая штука. У ленты есть одно убойное преимущество — её нельзя заразить шифровальщиком. В смысле можно, но нельзя. Лента надёжна.

Поддержка
Помните историю про «Ваша виртуалка на согласовании» из одного энтерпрайзного облака, когда это должно решаться одной кнопкой в личном кабинете? А вот у кого‑то она до сих пор на согласовании. У кого‑то поломался биллинг, и, когда его починили, заблокировали треть пользователей разом без предупреждения. А у людей — праздники. Как им срочно пополнять баланс? И ответ один: «Не нравится — идите на...» Где‑то надо смотреть 40-минутный вебинар, чтобы разобраться, как поднять простенький сайт…

Мы другие.

Мы небольшая команда инженеров, которая строит продукт для таких же инженеров. Мы — это вы.

И хотим и дальше так делать.

Мы, конечно, накосячим по дороге, и не раз. Но мы быстро всё исправим. И услышим вас. И даже если не будем делать то, чего вы просите, то ответим.

Сейчас мы небольшого размера — сотни серверов. Это топовое современное железо, которое производительнее «среднего по рынку» в несколько раз. Так что по мощности мы соответствуем среднестатистическому облачному провайдеру. Какого размера мы хотим быть? Просто передам привет Селектелу, МТСу и Сберу.


Друзья, мы пришли на этот рынок всерьёз и надолго.

h3llo.cloud
Что сейчас происходит с ЦОДами, рынком и беженцами из Яндекса


Основное, что сейчас с рынком:
  • У многих коллег по рынку моментально и некисло выросли ценники
  • Мы не планируем повышать цены из-за текущей ситуации всвязи с повышенным спросом
  • Мы вывезли почти всё оборудование из IXcellerate (крупные ЦОДы) и разместили на своих площадках
  • Площадки снаружи не выглядят как ЦОД, инфраструктура внутри распределена шире, чем в обычном машзале
  • Многие намеренно раскидывают оборудование на десяток разных площадок по чуть-чуть, возрождают старые серверные и админов в свитерах.
  • Все переписывают Disaster Recovery-планы, потому что такого ещё не было, и главная проблема уже не в экскаваторах.

Коллеги что‑то не очень делятся информацией, а она, вероятно, нужна много кому. В первую очередь мне совершенно не хочется как‑то навариваться на проблемах коллег по цеху или ловить на этом дешёвый хайп. Но выразить свою позицию и рассказать, что мы прямо сейчас наблюдаем изнутри, необходимо. А наблюдаем мы много всего интересного.

Теперь подробнее.

Что мы видим сейчас
Как только всё случилось, к нам повалила куча людей, чтобы срочно воткнуться. Я посмотрел по сторонам и увидел, что у многих коллег по рынку моментально и некисло выросли ценники. Некоторые виды ресурсов вообще перестали быть доступны к заказу.

Мы, если что, не поднимаем и не планируем поднимать цены. Мы продолжаем жить ровно на тех же ценах и условиях, что и до мая.

Возможно, поэтому было тяжело поднять голову в эти дни, потому что свалилось много работы.

Все с мелкими виртуалками как‑то размазались по рынку (возможно, ушли в ЦОДы СНГ), а вот корпораты и гиганты не могут так сделать. У них обработка персональных данных, и она должна делаться на территории России. Поэтому к нам вполне утром может прилететь запрос на огромную инфраструктуру, мы отвечаем коммерческим предложением, днём мы её выделяем, вечером начинаем миграцию — и параллельно юристы обсуждают бумажки. Многим важнее подняться и найти новый ЦОД.

Корпораты очень требовательные. Они точно знают, какие кластеры k8s им нужны. Например, один из мигрирующих спросил, есть ли у нас managed Kafka. Кафка у нас была только гречневая, но за ночь мы сделали им первый сервис, а потом уже патчили на лету.

Ещё мы были очень заняты тем, что вывозили оборудование из крупных дата‑центров IXellerate — мы ещё пару месяцев назад начали подозревать что‑то и думали, что, если что, они в списке целей. Поэтому мы оттуда смигрировали почти полностью — там остались только единичные серверы и точки присутствия (где стык с провайдерами и тому подобное), это для технического резерва инфраструктуры.

Один новый дата‑центр развернули, ещё два на подходе. Где они — не скажем, но это не бункеры.

Что происходит с рынком?
Ну, все резко проснулись. Теперь сидят в когнитивном диссонансе и с разной скоростью пытаются осознать реальность.

Уже точно понятно, что, во‑первых, все теперь будут по чуть‑чуть бояться крупных, известных всем объектов, особенно если они находятся за пределами МКАДа.

Во‑вторых, концепция Disaster Recovery изменилась навсегда. Это смешно, но когда ваш DR‑план начинается со слов «найти уцелевший сервак». Концепция отказа целого региона или отвала крупного провайдера перестала быть чем‑то из области мифических единорогов, которых никто никогда не встретит. Теперь об этом стоит серьёзно думать.

Удивительно, что ситуация с AWS у арабов, когда им расхерачили огромный амазоновский ЦОД, ничему крупный бизнес не научила. Раньше дата‑центры проектировались из расчёта, что вылетит максимум что‑то одно — условно, перебьют линию с интернетом или отвалится питание. Сейчас ЦОДы выпадают не случайно. Бьют целенаправленно: выискивают самые загруженные узлы, точки отказа и фигачат прямо по ним. Теперь все большие компании будут тестировать отказоустойчивость из расчёта «а если ударили в самое больное?», и DR будут строить именно через это.

Кто приходит сейчас?
Профиль клиента сильно изменился. Повалили не небольшие пользователи, которым нужна виртуалка подешевле, а крупняк со специфическими запросами на нюансы работы. Им нужен Managed‑кластер Kubernetes с хитрой балансировкой внутри зон доступности и между другими кластерами. Возможно, это потому что у них уже поменялись подходы к Disaster Recovery.

Вчера через пятые руки пришёл запрос: нужно срочно собрать 900 стоек под одного очень крупного арендатора. И вот сейчас по рынку бегают все кому не лень и пытаются эти стойки собрать. Но в моменте такого объёма не найдётся примерно нигде.

Многим арендаторам просто не нашлось места в Яндексе — они, очевидно, приоритезировали собственные сервисы, в том числе критичные. Кто жил в нём как в единственной точке присутствия и нигде не резервировался — не повезло. Надо было делать Disaster Recovery. Теперь те, кто не делал, бродят по рынку и охреневают.

Когда мы выехали из IXellerate?
Ровно в тот момент, когда начали что‑то понимать про ситуацию и её прогнозы. Это понимание у всего рынка резко случилось несколько месяцев назад, и, глядя, кто рядом с нами стоит из крупняка, мы решили, что лучше стоять от них подальше. Даже до того, как сам Икселерейт начал рассылать инструкции о том, как вести себя в случае угрозы БПЛА.

В это же время на рынке начали появляться люди, которые искали подземные помещения типа бункеров для новых ЦОДов.

У нас была одна своя полностью готовая площадка, мы повезли железо туда. Ещё два помещения мы нашли за это время и проработали, как там развернуть свои мощности.

Куда сейчас встают клиенты коммерческого облака?
На нашу собственную площадку. Адрес не скажу: мы внимательно изучили столб дыма и решили, что не будем светить расположением своих ЦОДов вообще. Поэтому три новые площадки у нас без адресов — но это Москва внутри Садового кольца (две) и в пределах МКАД (ещё одна). Адрес нужен в одном случае — например, если корпораты едут регистрироваться в государственном органе. Там мы подписываем NDA и показываем.

Самое смешное, что наш самый первый ЦОД, где стоит водяное охлаждение, ещё не достроен под коммерческое облако — физически мы не сможем быстро включить там серьёзные нагрузки. Там всё всегда жило в экспериментальном формате, и банально не хватит ни сетей, ни производительности. Чтобы довести её до ума, нужно строить три ноги оптики, и это планы аж до конца 2027 года. Мы только недавно закончили там все юридические оформления.

Как поменялась архитектура ЦОДа на рынке?
Про бункеры я уже говорил. Это не наш подход, мы боимся затопления. Да, по стандартам Tier их сертифицировать нельзя. Но если рассматривать их не как основную рабочую единицу под всю нагрузку, а как место, куда в реальном времени снимаются актуальные бэкапы, — это суперперспективная история.

Наши же новые площадки мы проектировали вот так:
  • Снаружи ничего не должно выдавать, что это ЦОД.
  • Инфраструктура должна быть разнесена гораздо шире, чем в обычном ЦОДе, по гораздо большей площади, никакого кучкования в плотные машзалы.
  • При этом она должна быть распределена по возможности — чтобы не было единых точек отказа.


Главное для ЦОДа — электричество и сеть. Внутри Москвы ни с тем, ни с тем по доступности проблем нет, но по электричеству есть вопрос цены, это одно из важных усложнений.

С другой стороны, те, кто так не может, тоже уже придумали выход. Буквально за дни индустрия реагирует на глазах. Возвращается концепция микроЦОДов на предприятиях, когда маленькие стойки снова начинают запихивать в шкафы. Лично к нам приходили ребята, у которых раньше всё стояло в Яндексе, а сейчас они намеренно раскидывают оборудование на десяток разных площадок по чуть‑чуть.

Если прилетит, мы фактически теряем бизнес?
Да. Но тут нужно понимать вероятности. Вряд ли прилетит сразу в три площадки и резервные узлы. Тем не менее завтра мы общаемся со страховщиками — они, конечно, уже тоже подняли цены, и немного жалко, что мы не уделяли этому время раньше, но всё равно надо будет посмотреть. Уровень риска сейчас возрастает, а страховка — это всегда компенсация, помноженная на вероятность риска.

Были попытки помочь Яндексу?
Я знаю, что многие туда стучали со словами «дайте нам ваших бывших клиентов». Мы общались по другим вопросам. Меня в первую очередь интересовала инфраструктура Рунета. Мы им предложили наши мощности и серваки для той инфры, на которую опирается всё IT‑комьюнити. Я говорю про DNS, NTP‑шки, зеркала репозиториев и так далее. Это та хрень, которая бизнесу денег не приносит, но которая реально нужна всем. Если её не станет, очень печально будет абсолютно всем.

Что будет с рынком?
Ну, стоимость владения инфраструктурой сейчас пересматривают примерно все. Причём это касается не столько облачных провайдеров, сколько обычного рядового среднего и малого бизнеса. Облака в том абстрактном виде, к которому мы привыкли, нужно пересматривать. Поэтому вопросы гибридной инфраструктуры (когда часть лежит on‑premise, а часть распределена по разным облакам) стали невероятно острыми.

Собственно, вот. Через пару дней узнаю, что происходит со страховщиками, потом нас опять накроет кучей работы (в основном миграций), а потом уже можно будет выдохнуть и чуть разобраться ещё.

Отреверсили проприетарный gRPC и выложили в опенсорс 100% совместимый аналог их сервера, потом CLI


А вы тоже организуете общение между микросервисами по HTTP/1.1 + JSON? Так вот, адекватные люди на хайлоаде давно так не делают.

Как это выглядит в классическом REST: какой-нибудь сервис заказов стучится в сервис оплаты и отдаёт JSON-файлик: {«user_id»: 123, «amount»: 1000}. Принимающий сервис этот текст читает, парсит, валидирует, переводит в машинный код…

JSON сделан для людей. Человеку удобно читать JSON, потому что это текст. Но серверу для обработки текста приходится тратить драгоценные такты процессора на поиск и разбиение. Ещё классический HTTP тащит за собой гигантские заголовки с метаданными. Часто они весят больше, чем сама полезная нагрузка. Ещё если вы передаете число 123456789, в JSON оно займёт 9 байт (по байту на символ), а в бинарном виде — всего 4 байта.

Гугл ещё в 90-х это посчитал. Они со своими масштабами столкнулись с проблемами за 10 лет до того, как с ними столкнулся весь остальной мир. Для DNS-а в Гугле сделали внутреннюю систему Borg-NS. Они пытались сделать предка gRPC, чтобы решить две фундаментальные проблемы. Во-первых, зоопарк технологий. Когда у тебя тысячи микросервисов — одни на Java, другие на C++, третьи на Python, четвёртые на Go (ладно, этих тогда точно не было) — им нужен единый язык общения. Нужно было запилить стандарт: описали спецификацию интерфейса в одном независимом стиле — и система сама сгенерировала готовый сетевой код для всех нужных языков.

А во-вторых — это как раз производительность обмена.

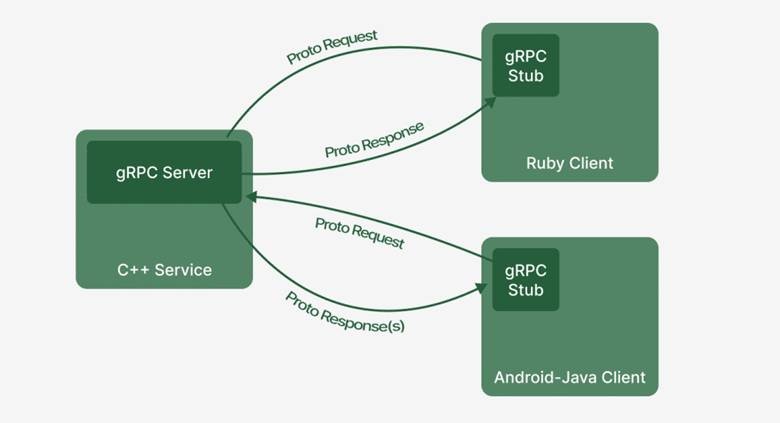
Поэтому сейчас используется gRPC. И вот когда началась какая-то там по счёту волна санкций, внезапно выяснилось, что в России нет поддержки серверов gRPC.

Не было, пока не появился наш клиент EasyP. Передаю слово Эдгару Сипки — Founder EasyP & Sipki Tech. Он расскажет, зачем и как это сделали.

Зачем это обычным людям?
99% наших пользователей — это бэкендеры, которые строят микросервисы. Бэкенд общается с бэкендом. Да, связывать бэкенд с фронтом, например, с мобилой, тоже можно, это не проблема, но это просто не стандарт рынка. В России, да и вообще во всём мире, я знаю буквально только одну компанию — Uber, кто реально сидел с gRPC на мобилках.

Первый запрос — стандартизация. Объёмы, как у Гугла, есть не у всех, а вот зоопарк — точно у всех. Можно использовать OpenAPI, а можно gRPC. Big Tech (американские Google, Amazon, Microsoft или наши Ozon, WB и Сбер) ещё и экономят на железе. В рамках их гигантских архитектур работают тысячи микросервисов, и в секунду происходят сотни тысяч таких внутренних вызовов.

Чтобы стал понятен масштаб: представьте, что вы открываете приложение, чтобы заказать такси или купить кроссовки. Вы нажимаете всего одну кнопку «Заказать», но под капотом этот единственный клик порождает каскад из 50−100 микросервисных вызовов. Сервис авторизации проверяет токен, сервис геопозиции ищет водителя, биллинг проверяет карту, сервис рекомендаций обновляет вашу ленту, антифрод анализирует паттерн поведения, а пуш-сервис готовит уведомление. И все они общаются между собой. Если на каждом таком шаге сервер будет тратить миллисекунды на открытие новых соединений и парсинг текстовых JSON-ов со скобочками, то на 10 тысяч пользовательских запросов в секунду вы немного охренеете. Гонять тяжёлые текстовые данные со всеми массивными HTTP-заголовками и постоянно их парсить обходится для серверов дорого.

gRPC работает поверх HTTP/2 и использует бинарную сериализацию: данные передаются не как текст, а как архив. HTTP/2 умеет мультиплексировать запросы, он не открывает новое соединение для каждого чиха, а гоняет сотни параллельных запросов по одной уже открытой «трубе». Во-вторых, данные пакуются в бинарный формат. Сервер-отправитель не пишет ключи типа «user_id», он отправляет только числовые теги и сами значения. Сервер-получатель не занимается парсингом текста, он просто считывает смещения в памяти процессора. Это работает куда быстрее.

В итоге это раза в 2−3 дешевле по пропускной способности сети и нагрузке на процессоры. То есть gRPC реально очень сильно экономит деньги на железе (мы говорим про миллионы долларов на закупку и обслуживание серверов), но этот эффект в полной мере ощущается только при огромных объёмах.

Ну и де-факто этот протокол сильно защищённее, там есть ещё ряд бонусов.

Но есть нюанс: с этим протоколом исторически было очень неудобно работать
Когда вы пишете обычный REST-сервер, вам надо как-то объяснить команде одного микросервиса, как работать с микросервисом другой команды. Нужна документация. Если вы когда-нибудь работали с OpenAPI (или Swagger) для REST, то Protobuf (язык описания интерфейсов для gRPC) — это альтернатива OpenAPI, которая просто родилась фактически за 10−15 лет до него.

Protobuf — это строгий контракт. В нём чётко написано: поле номер один — это ID юзера, тип — целое число (int32 user_id = 1;), поле номер два — сумма платежа.

Но в самом ванильном Protobuf нет встроенного линтера! Каждый разработчик мог описать сервисы так, как он захотел. В итоге рождалась классическая катастрофа распределённых систем: разработчики одного микросервиса поменяли контракт и никому об этом не сказали.

Представьте вполне реальную ситуацию на проде: команда сервиса оплаты решает изменить тип поля или удалить поле user_id и молча выкатывает обновление. Или, например, джун в сервисе корзины решает, что сумму заказа лучше передавать не в виде строки «100.50», а в виде целого числа (в копейках — 10050), и меняет это в своём коде. А сервис заказов всё ещё шлёт старый формат. Сервис оплаты получает неожиданный тип данных, не может его прочитать, выкидывает ошибку, и всё падает в рантайме. Платежи не проходят, бизнес теряет миллионы рублей в минуту, а дежурные инженеры в панике ищут, где именно сломалась цепочка из десятков микросервисов.

Чтобы как-то впихнуть эту стихийную разработку в рамки и защититься от таких ошибок, в мире появилось четыре конкурирующих инструмента: один от Uber, один от индусов, один от канадцев и один ещё от кого-то. В итоге в какой-то момент канадский стартап сказал всем остальным троим: «А давайте мы вас всех купим? Давайте вы все станете мной?»

И все стали ими, переложили наработки в единый продукт Buf Build, получили 93 миллиона долларов инвестиций и заняли нишу.

А потом наступает 2023 год
Архитектура российского ИТ-рынка начинает сильно меняться.

У меня это выглядело так: мне надо через пару дней выступать в Сколково на конференции HighLoad с темой работы с gRPC. Доклад о том, насколько этот протокол важен и ценен для бизнеса. Все мои примеры архитектуры и пайплайнов в докладе были построены на Buf Build. Доклад приняли. А потом Buf Build выпускает заявление:

— До свидания. Мы в России блокируем доступ к своим сервисам!

Куратор моего доклада был сотрудником Yadro — это наш гигант, производящий серверное оборудование и железо для ЦОДов. Он был там кластер-лидом, и у него как раз стояла острая рабочая задача в рамках компании: решить проблему того, что инфраструктура Buf перестала собираться в России. Он говорит мне: «Эдгар, а ты сможешь сделать так, чтобы Buf Build заработал в России?»

Ну, потому что невозможно же делать доклад о продукте, который не работает, кому это надо? Я говорю: «Ну, окей, я подумаю».

Я сел и ровно за один месяц просто зареверс-инжинирил их серверную инфраструктуру. Она у них проприетарная, не open source. Я буквально стучался по их API и по крупицам формировал понимание (это было ещё даже до появления мощных нейросетей), как именно это говно у них устроено и почему оно так работает.

Разобравшись в логике, я с нуля создал эмулятор их сервера. В итоге их собственная CLI и кусок клиентской части продукта завелись с моим сервером так, как будто он для них родной.

Всё заработало.

Мы повозились, отладили процессы, показали это решение прямо на конференции, все кайфанули. А потом мы сели и такие: «А зачем нам делать поддержку инструмента, который нас забанил?» Мы по факту сделали костыль. Зачем нам поддерживать чужую экосистему? Давайте сделаем прям свою полноценную замену?

Первыми, кто взял мой сервер, были как раз Yadro и Positive Technologies. В каком-то общем чате инфраструктурщиков ребята написали: «Так и так, кто-то же должен был столкнуться с блокировкой Buf, как решаете?» Им кинули запись моего доклада. Они взяли оттуда продукт, стали активно юзать у себя на больших объёмах, и в итоге столкнулись там с очень специфическими багами.

Чувак, который отвечал за развёртку этой инфраструктуры в Позитиве, искал создателя, то есть меня. Через кого-то ему передали контакт, он мне написал, я ему ответил. А потом я случайно смотрю в Телеграме в общую группу нашего ЖК в Петербурге, и мы такие: «А ты что тут делаешь?» Оказалось, живём буквально в соседних парадных! В тот же вечер мы собрались с кальяном, поштормили и начали делать с ним прям аналог — нашу собственную CLI-ку.

Полноценный dev-tool для разрабов, чтобы им было просто и безопасно работать с Protobuf'ом. Наш продукт — EasyP.

Мы сделали то, зачем крупные энтерпрайзы изначально шли к Buf'у — железобетонную стандартизацию. Используя наш продукт, микросервисная команда получает проверяемый манифест API с понятной документацией, быстрый протокол gRPC под капотом и строгий линтер поверх всего этого.

Как это работает на практике?
Во-первых, наш инструмент — это строгий контролёр. Он заставляет тебя писать контракты по единым правилам компании, чтобы код никуда не вылез за рамки стайлгайдов.

Во-вторых — это пакетный менеджер. Раньше, чтобы сервис уведомлений на Python узнал о новых ручках сервиса заказов на Go, разрабам приходилось руками копировать .proto-файлы или городить костыли с Git-сабмодулями. Мы же сделали элегантный механизм: ты просто указываешь нужную версию контракта, EasyP сам скачивает зависимости из реджистри и фиксирует их в easyp.lock. Дальше ты пишешь easyp generate, и мы внутри изолированных Docker-контейнеров (или через Wasm) сами компилируем нужный код. Больше никакой боли с фразами «а у меня локально всё собиралось» — у всех разработчиков всё генерируется абсолютно идентично.

Но самое главное: на уровне CI/CD (при автоматической сборке кода) наш инструмент проверяет обратную совместимость. Он прямо на этапе пулл-реквеста проанализирует изменения и защитит от фатальных ошибок. Если разраб сервиса заказов случайно удалит поле, а сервис уведомлений всё ещё завязан на него, линтер просто заблокирует деплой и скажет: «Стоп, ты ломаешь обратную совместимость. Все клиенты твоего микросервиса упадут, если ты сейчас замержишь эту ветку».

Ну и наконец — интеграция с IDE. Специально для OpenIDE с поддержкой Go прямо из коробки мы разработали плагин EasyP, который уже сейчас доступен в маркетплейсе для установки. Пишешь в .proto строку import «orders/v1/order.proto» — и IDE сразу знает, откуда эта зависимость тянется по твоему easyp-конфигу. Никаких красных «unresolved import»: работает переход к определению и автокомплит по чужим контрактам, будто они лежат локально. Заодно плагин подтягивает в редактор правила и стандарты EasyP — те самые, по которым потом бьёт линтер на CI.

В 2025 мы выяснили, что стали монополистами в России
Да, продукт нишевый, инфраструктурный, но монопольный. Сервера полностью наши, CLI-ка написана нами. Мы Git-native, то есть никакие корпоративные контракты не улетают на чужие облачные сервера, всё крутится внутри контура компаний. Плюс мы полностью open source под лицензией Apache 2.0.

Долгое время мы специально сохраняли обратную совместимость с CLI-кой от канадского Buf'а, чтобы российским компаниям было легко переезжать. Но этим летом мы выкатим мощную энтерпрайзную версию, зарелизим версию 1.0 (потому что мы всё ещё числимся в бете уже 3 года) и планируем отсечь старое легаси, отказавшись от прямой совместимости с их синтаксисом. Но чтобы никого не бросать, мы сделаем изящную механику: девопсу достаточно будет вызвать одну команду нашей CLI-ки, и она автоматически прочитает старый конфиг Buf'а, переведёт его в наши концепции и бесшовно сгенерирует родной конфиг EasyP.

Что мы делаем в H3LLO
У нас были высокие требования к инфраструктуре. Собственно, пошли смотреть облака по рынку, их там ровно три, подходящих два. В H3LLO написал в поддержку, типа, у меня нет проблем, есть идея. И они связались!

Короче, мы получили мощность на развитие проекта, поддержку от облака с крупными корпоратами и сейчас делаем совместные проекты.

Зачем нам облако, если всё можно On-Prem? Ну, надо было разместить реестр схем. Это облачный репозиторий, где хранятся, версионируются и документируются все Protobuf-файлы компании. Туда можно в любой момент загружать новые версии API-контрактов и скачивать актуальные схемы. Обычно это сервер в корпоративной сети, но у нас ещё работает малый бизнес, поэтому это для него.

P.S. А, и кстати, вот ссылка на комьюнити t.me/easyptech

Что не так с попытками бизнеса заменить джунов на ИИ


Компании сейчас массово режут косты и сокращают джунов. Решение кажется бизнесу идеальным: выдаём мидлам токены, ускоряем время выкатки фич, а бонусом экономим на выращивании спецов.

Тем более на рынке уже есть кейсы, как команды до 30 человек с ИИ собирают и запускают целые облачные платформы. Например, мы в H3LLO Cloud. Эта модель называется tiny teams.

Разница в том, что мы умеем думать, знаем, зачем применять и для чего НЕ применять LLM. И у нас нет KPI на использование токенов. При этом в корпорациях они обычно есть, и часто там мидлы гоняют бессмысленные запросы, просто чтобы дойти до лимита по KPI.

Я в этой истории по обе стороны баррикад: сам каждый день работаю с нейронками и сам же нанимаю людей. И я могу очень чётко рассказать, где у этой красивой схемы дыры.

Их минимум 5, и каждая со временем обойдётся дороже, чем весь сэкономленный фонд оплаты труда джунов. Ну, например, то, что найм сломан, а система резюме не работает.

Цифры и истории дальше — в основном от моего знакомого, предпринимателя и преподавателя Даниила Пилипенко, который с 2014 года занимается подбором и оценкой айтишников в своей компании SymbioWay. Он и его команда принципиально не делают выводов на резюме.

И они же больше десяти лет ведут статистику: сколько на рынке вакансий, сколько резюме и что из этого получается на практике. Мы будем рассказывать о наблюдениях вместе.

Начнём с того, как кончилась сказка про то, что в ИТ всё хорошо и всех ждут золотые горы.

Сказка кончилась прошлым летом
Десятилетиями рынок IT жил в режиме хронического дефицита: вакансий было стабильно больше, чем резюме, примерно на 40%. Кривые шли параллельно, дружно проседали к Новому году (все хотят отдыхать, а не нанимать) и снова расходились.


Весной 2020-го пандемийный локдаун уронил обе кривые: кандидаты сидели по домам, а компании перестали нанимать. Потом всем срочно понадобились доставки и онлайн-сервисы, и спрос меньше чем за два года вырос почти в три раза. Это был пузырь, но изнутри он ощущался как новая нормальность: айтишников носили на руках и давали офферы и контрофферы, зарплаты и «плюшки» кратно росли.

В марте 2021-го знакомый провёл эксперимент. Java-разработчик выложил резюме утром во вторник. К вечеру вторника у него уже было 60 писем на почте и 30 звонков на телефоне. К вечеру среды — оффер: кто-то особо настойчивый прорвался и уговорил выйти на работу в четверг утром. Вот так выглядел рынок. Утром публикуешь резюме, днём сидишь и выбираешь, вечером проходишь короткое собеседование, а буквально завтра уже выходишь на работу.

В марте 2022-го инвесторы прикрыли финансирование почти всех проектов, потому что стало непонятно, что будет дальше. Кривая вакансий упала вниз и сильно приблизилась к кривой резюме.

Уже в марте 2023-го российский рынок вернулся, и до октября 2024-го всё было как раньше: дефицит 40%, жизнь хороша.

А с октября-ноября 2024-го вакансии снова полетели вниз. И прошлым летом кривые впервые за десятилетия пересеклись. Резюме стало больше, чем вакансий.

Локальной российской аномалией это не назовёшь. В США в пике было около полумиллиона технических вакансий, в июне 2022-го рынок просел втрое — до 150 тысяч. Сейчас отрос до 260 тысяч и ползёт вверх со скоростью улитки. По еврозоне график выглядит аналогично.


Сейчас у Python-разработчиков конкурс — 20 человек на место, во фронтенде ситуация немногим лучше. А вот, например, в 1С или разработке на Go всё не так плохо, там конкурс гораздо меньше, но в среднем температура по рынку пугающая. Джуну, чтобы попасть на одно собеседование, нужно откликнуться несколько сотен раз, а такого количества вакансий по его специальности может и не быть. Не 30, после которых обычно опускаются руки, а несколько сотен!

Дальше происходит вот что. HeadHunter — это примерно 40% рынка. Кандидатам лениво откликаться руками, и они включают ботов-автооткликаторов. Рекрутер утром открывает вакансию и видит тысячу откликов. Он читает первые двадцать, зовёт самого «симпатичного» кандидата, на неделе читает ещё 40−50 откликов, кого-то в итоге нанимает и закрывает вакансию. Хвост из девятисот откликов не прочитает никто и никогда.

Вот в такую среду бизнес и принёс свежую идею: джунов больше не нанимаем, у нас теперь ИИ.

Соблазн понятен и подкреплён фактами
Свежий пример от заказчика. Он устал платить за amoCRM и Bitrix24: дорого, интерфейс перегруженный, половина функций не нужна, есть опасения за безопасность данных о клиентах. Хочет свою CRM. Знакомый спросил нескольких фулстек-разработчиков, которые ещё пишут по старинке (тех, кто ещё не заразился подходом и не стал AI-native специалистами), во сколько они оценивают такой проект в одно лицо. Объём известен: 15 таблиц в базе данных, страниц тридцать интерфейса. Все ответили примерно одинаково — два-три месяца, если нормально отладить и протестировать.

В итоге подключили того, что владеет ИИ-инструментами, и у него на создание полноценной системы ушло 12 часов плотной работы. Заказчик пользуется своей системой уже 4-й месяц. За этот срок он всего пару раз попросил доработать функционал под свои задачи, на что ушло где-то 3 часа.

Секрет при этом обидно скучный. Никакого промпт-инжиниринга со специальной структурой запросов, которой учат на курсах. Работает инженерная последовательность: сначала проектируем базу, потом интерфейс, потом API по REST. Сверяем всё это между собой. Потом пишем бэкенд отдельно — по API и базе. Потом фронтенд отдельно — по API и описанию интерфейса. Потом стыкуем, пишем автотесты на интерфейс и API и автоматически исправляем все ошибки. На выходе — чистый код в единой архитектуре, всё документировано, в README инструкция: залил на хостинг, прошёл шаги, и готовый ресурс с удобным интерфейсом заработал.

День против двух-трёх месяцев. Плюс такой исполнитель стабилен: не болеет, не увольняется и не приходит в среду вечером поговорить про пересмотр зарплаты.

Знакомый техлид из крупного e-commerce — Дмитрий Буров, senior разработчик Go в Lamoda — хорошо сформулировал, что с нами всеми произошло: «Мы перестали думать о том, как красиво написать код, и начали двигать квадратики. Уровень абстракции повысился, и мы поголовно стали архитекторами. В англоязычных компаниях таких специалистов уже начали неформально называть „builders“ — строителями».

В пределе картинка такая: инженер заводит себе AI-агента-фронтендера и AI-агента-бэкендера, ставит им задачи и валидирует результат. Также тут не помешает агент-тестировщик. Рядом — живой системный аналитик, который общается со стейкхолдерами и приносит бизнесовые задачи. Двое вместо команды из десяти человек.

Выглядит как смертный приговор джунам.

Токены без тимлида не работают
Те двое с AI-агентами в среднем по рынку эффективнее команды из десяти примерно в два раза. В два. Не в 50. Не на порядок.

Потому что нейронка — джун. Очень быстрый, очень начитанный, не болеющий, но джун. Ей нужны рамки и границы ровно так же, как живому стажёру. Сформулируешь джуну задачу в общих чертах — получишь в общих чертах продукт. С нейронкой то же самое, слово в слово. А садиться вайб-кодить, не понимая, какой результат хочешь получить, — на выходе будет каша и огромный расход токенов.

Очень частая ситуация — получить что-то похожее на результат почти сразу, а потом 3−5 дней доформулировать требования и переделывать мелочи. И это ещё повезёт, если выйдет — на больших проектах надо сразу думать иначе.

Отдельная иллюстрация — самопроверка. Спросите ИИ, какие проблемы он видит в собственном только что написанном коде. Первая итерация — что-то найдёт. Вторая — ещё что-то. На третьей-четвёртой зациклится и объявит, что проблем больше нет. Живой опытный разработчик на этом вопросе может копать бесконечно и технически грамотно: конкурентность, безопасность, узкие места архитектуры, что будет со второй итерацией продукта. Нейронка комплексно на это не смотрит. Такие требования в промпт впишет только человек, который сам набил эти шишки, — он же заметит проблемы в готовом коде глазами.

И вот первая нестыковка бизнес-плана. «Выдадим мидлам токены» на практике означает «назначим каждого мидла техлидом AI-команды». А техлидство — это отдельные конкретные навыки: проектирование архитектуры, декомпозиция, постановка задач, выстраивание границ, валидация чужой работы. Откуда эти навыки берутся? Из опыта руководства живыми джунами. Которых мы только что сократили. А ведь мы выступаем в роли техлидов для ИИ ровно в той же мере, как если бы перед нами сидел живой джуниор.

Мидлы не самозарождаются
Любой мидл — это джун, которого кто-то когда-то терпел.

В 2011 году знакомый нанимал себе разработчика, дал задачку на листочке бумаги, в духе «компилируй в голове, пиши на бумаге». Кандидат решил всё, кроме рекурсивной функции. Просто не смог написать рекурсию. Формально это отказ: заместитель знакомого такого кандидата завернул бы не раздумывая. Вместо этого они заключили сделку: про рекурсию никому не рассказываем, а к понедельнику, к выходу на работу, ты знаешь её идеально. В понедельник человек вышел со знанием рекурсии, проработал в компании много лет и сейчас занимает серьёзную должность. А заместитель, который завернул бы кандидата за незнание рекурсии, лишил бы компанию отличного кадра.

Это один из вариантов «вырастить специалиста» — поверить в него и установить жёсткий план развития. Дёшево, быстро, эффективно.

Теперь смотрим, что стало со входом в профессию. Сам по себе язык программирования учится с нуля за полгода, по вечерам — месяцев за семь-восемь. Но выучить один язык давно перестало быть достижением: знания стали доступными, толстые книжки с распечатками кода на шесть страниц, которые перепечатывали руками, уехали в музей. Чтобы джун начал приносить пользу, ему нужен комплекс: бэкенд, желательно с парой языков, фронтенд с фреймворком, вёрстка, архитектура, понимание микросервисов. Это уже года два учёбы. Плюс стажировки, фриланс и дешёвые проекты ради практики — период разгона от нуля до способности приносить пользу вырос в разы.

То есть конвейер производства мидлов стал длиннее и дороже ровно в тот момент, когда бизнес решил его выключить. Запас прочности у такого решения — года три-четыре: пока нынешние мидлы не станут синьорами, не выгорят и не подорожают. Потом выяснится, что новых брать неоткуда. Джунов не растили, а ИИ за это время так и остался джуном. Да, модели умнеют с каждым релизом, но растут они у вендора. А вендор продаёт вам токены, а не выращенного внутри вашей команды специалиста.

Ладно, скажет бизнес, не будем растить сами — купим готовых мидлов на рынке!
Их же теперь много, вон какой конкурс!

Здесь начинается самое весёлое. Знаем ситуацию, когда за годы отбора накопилась стабильная, повторяющаяся из года в год конверсия: из всех людей, называющих себя программистами, реально работать программистом может каждый 20-й.

Перегретый рынок так устроен в любой профессии. В 2015-м компания Даниила подбирала клиенту бухгалтера. Решено было тестировать бухгалтеров так же, как программистов, — задачами в электронной системе, где нужно было не выбирать варианты ответов, а писать текст. На вакансию откликнулись около 600 человек. До онлайн-задач дошли 400. Задачи несложные: две компании, одна посредник, одна работает с НДС, другая без, посчитайте НДС в этой схеме. Эту задачу из четырёхсот бухгалтеров правильно решили человек двадцать пять. Все десять задач — только семеро. Троих с нормальными софт-скилами показали клиенту, одного в итоге наняли.

Отдельный штрих: ещё 7 из той воронки физически приехали в офис клиента выяснять, как им пройти собеседование, которое вообще-то целиком проходило удалённо. И это при том, что они даже простейший НДС не смогли посчитать!

Теперь добавим в эту картину ИИ — и она станет хуже. Резюме теперь пишут нейронкой, по тексту вообще ничего не понять. На онлайн-собеседованиях кандидаты включают прозрачные окна поверх экрана, которые не видны при демонстрации, и зачитывают оттуда ответы. Зачитывающих пока выдают глаза: они бегают по строчкам. Дошло до вопросов-ловушек: например, внезапно спросить кандидата, как пожарить свиные крылышки. Человек, погружённый в техническую беседу, на секунду зависнет и рассмеётся. Зачитывающий начнёт уверенно излагать рецепт — нейронка-то ответ честно сгенерировала.

Палятся и на фактах. Самый надёжный вопрос — сколько времени занимало создание продукта, о котором кандидат рассказывает. Без реального опыта масштаб не прикинуть, и суфлёр тут не спасает. Знакомый тимлид как-то поймал кандидата ещё проще: тот назвал его родной вуз, а на вопрос, какой факультет, ответил, что компьютерный. Такого факультета там не существует. Пятнадцать минут собеседования.

Есть и ещё организованное движение — «волки». Философия простая, они сами называют её осознанной меркантильностью: рынок нам должен, заходим на грейд выше, чем умеем, зарабатываем максимум. Справедливости ради, часть из них потом действительно дорастает до заявленного грейда: берут на себя ответственность и пашут, действительно выдавая нужные результаты. Но для работодателя это уже лотерея.

Для компании опасен вовсе не слабый кандидат. Слабый честен: ему не дают сложных задач, его постепенно растят, все понимают, что с ним делать. Опасен кандидат, который научился выглядеть сильным. По нему компания принимает неверные управленческие решения — а потом ловит сбои в проектах там, где ничего не должно было сбоить.

Если компания уволила джунов, на своих выращенных опереться больше не может и идёт на рынок за «готовыми мидлами» — на рынок, где конкурс 10 к одному толкает людей к обману, нейронки делают обман дешёвым и массовым, а настоящим специалистом по-прежнему оказывается каждый двадцатый.

Резюме умерло, а нанимать по-новому дорого
Хорошо, а как отличать настоящих?

Старый интерфейс найма — резюме — сломался окончательно.

Он, честно говоря, никогда толком и не работал. В подкасте Даниил рассказал про товарища, который сейчас работает одним из технических руководителей в Google. И вот он как-то показал Даниилу своё резюме, в котором была всего одна строчка навыков — PHP, MySQL, HTML, CSS, JavaScript — и невзрачное место работы. За этой строчкой скрывался человек, который написал собственную версию PHP: лазил в исходники интерпретатора и переделывал синтаксис под себя, в частности, менял точку на плюсик для конкатенации строк.

Другой пример. К Даниилу на консультацию пришёл PHP-разработчик с резюме, которое выглядит так, будто у него опыта лет пятнадцать. Начинаешь расспрашивать: с микросервисами работал — слова «микросервис» в резюме нет. Гитом владеет — слова «Git» нет. Редис, очереди, хранилища — ничего нет. Объяснение прекрасное: мозг не заточен под самопрезентацию, и вообще он это всё не любит, резюме и так далось с трудом. Сильные специалисты сплошь и рядом игнорируют самопродвижение: им годами не нужно было выходить на открытый рынок, их передавали из рук в руки по рекомендациям.

А в 2015 году у Даниила был случай: искали клиенту фронтенд-разработчика на Angular. В воронку попали двое лучших кандидатов после тестирования, при этом эксперт выбирал их, не видя резюме — только по тому, как они решали задачи. У первого оказалось идеальное резюме фронтендера. У второго — всё про 1С, и лишь где-то внизу сиротливое слово «Angular», потому что он «по вечерам сайтики делал для себя» и не верил, что это коммерческий опыт. Клиент провёл собеседование, перезвонил и в восторге сказал: «Они оба такие классные, я пойду выбивать бюджет на двоих». И взял обоих, и оба проработали в этой компании по 6 лет, пока она не закрылась. И это доказывает, что честность с резюме кандидату никак не помогла, а помог наработанный вечерами опыт.

Бывают и зеркальные случаи. Знакомого позвали оценить команду из десяти верстальщиков и фронтендеров: руководитель компании засомневался в их лиде. У лида десять лет стажа, по идее, давно пора в синьоры. По навыкам оказался джун с плюсом. Все десять лет команда клепала однотипные плоские лендинги — стаж шёл, скилы не развивались.

Что работает вместо резюме? Компания Даниила уже год практикует формат, который считает самым эффективным в настоящее время. Звонок кандидату начинается с вопроса, владеет ли он Cursor. Владеет — отлично: открывай, включай демонстрацию экрана, вот описание продукта, у тебя час. Хотел списать на собеседовании — пожалуйста, списывай официально, нейронка перед тобой, сделай нам продукт и размести на тестовом сервере. Фокус в том, что для результата нужны оба набора скилов сразу: программировать и работать с ИИ. Без «включения» мозга нейронка такое не вытянет: надо поставить задачу, разложить систему на части, заметить, где она привирает, запускать агентов параллельно. Без владения инструментом не уложишься в час.

Это заодно ответ на вопрос, кого теперь считать джуном. Джун с Cursor и джун без Cursor — две разные профессии.

Дальше — устный экзамен, как в университете: эксперт, кандидат и разговор. Даниил считает этот формат золотым стандартом, и там есть свои детекторы. Например, вопрос про методы HTTP. Кандидат называет GET, POST, PUT, PATCH, DELETE — нормальный мидл. Вспомнил HEAD и OPTIONS — условно мидл с плюсом. А вот если назвал TRACE и CONNECT и бойко рассказывает, что это, — иногда отказ. Нормальные люди их не помнят, на практике они почти не встречаются (если только вы не синьор, который случайно столкнулся с этим в специфической задаче). Либо списал, либо подглядел.

Ещё есть проверка профессиональной интуиции: спросить то, чего кандидат знать не обязан. Вы Ruby не знаете? А как, по-вашему, там может быть устроено ООП? Честный человек начинает рассуждать, тянуть связи от того, что знает, и ошибаться правдоподобно — по этому видно, что чутьё есть, с остальным разберётся. «Волк» же отвечает подозрительно точно. Слишком точно для человека, который Ruby не знает.

У компании Даниила, к слову, есть и автоматизация: система онлайн-оценки следит за 67 признаками списывания — вплоть до того, как кандидат набирает текст. С ChatGPT в соседнем окне или в телефоне на столе текст набирают заметно иначе, чем из головы. Но он сам говорит, что достоверности пока не хватает, и финальное слово должно оставаться за экспертом и живым собеседованием.

Про роль ИИ в найме у него тоже есть чёткая позиция. Загрузить запись собеседования и попросить выписать плюсы и минусы кандидата — полезно: взгляд со стороны, нейронка заметит то, что вы пропустили. А вот решение отдавать ей нельзя. Решение о найме — это взвешивание рисков: вот этого кандидат не знает, ну и ладно, за выходные выучит, зато глаза горят. Машина так не взвешивает.

Богатые компании делают ещё круче: устраивают тестовые дни, когда кандидат день-два сидит за реальной работой, знакомится с компанией, а компания смотрит на него в деле. Лучший способ отбора из существующих. И самый дорогой.

Живой эксперт, час демонстрации экрана, устный экзамен, тестовые дни. Найм стал заметно дороже ровно в тот момент, когда бизнес решил на нём сэкономить.

Ставка на чужую инфраструктуру
Последняя дыра стратегическая, про неё почти не говорят на конференциях.

ИИ хорошо пишет на том, на чём его обучили, и это уже искажает рынок технологий. Проектов на TypeScript становится больше в том числе потому, что нейронки на нём сильны. Go за последние год-полтора рванул с привычных десяти процентов рынка к двадцати и вот-вот обойдёт Python по популярности в бэкенде — старая иерархия, где сверху Java, за ней Python, дальше PHP, поплыла на глазах. А вот на 1С, который держит заметную долю российского рынка, нейронки пишут плохо: данных мало, модели учились на англоязычном коде, и ждать паритета ещё года два. Embedded — вообще отдельная планета: какие баги и капризы у конкретной железки, не знает ни одна модель, поэтому люди с C, C++ и Assembler могут не паниковать в принципе.

И здесь важно понимать, что разные ИИ-модели хороши в разном: для написания кода сейчас отлично работают Gemini или продукты Anthropic, а вот отечественная Алиса, хоть и не блещет в программировании, зато делает весьма неплохие юридические подборки. То есть лозунг «заменим джунов на ИИ» в реальности звучит как «заменим джунов на ИИ в тех стеках, где ИИ повезло с обучающей выборкой». В заголовках такое уже смотрится хуже.

И второе. Взрывной рост моделей упирается в железо и энергетику, а того и другого в мире не прибавляется. Уже ходят осторожные прогнозы, что в ближайшее время рост притормозится просто потому, что вычислять будет не на чем. Знакомый позавчера сел дописать свою утилиту с Cursor — тот тормозил так, что проще было написать руками, а в какой-то момент написал, что его сервера перегружены и надо подождать. Один тормозящий вечер — мелочь. Но стратегия «джунов сократим, токенов докупим» молча предполагает, что токены всегда будут дешёвыми, быстрыми и доступными. Это ставка на чужую инфраструктуру, чужую экономику и чужую энергосеть. Откат назад возможен гораздо легче, чем кажется из 2026 года.

Под конец две истории, обе на самом деле про одно
2006 год, четвёртый курс университета. Человек в совершенстве пишет на Java и приходит на вакансию PHP-разработчика. PHP не знает вообще, ни строчки кода не написал. Всё собеседование уместилось в один вопрос: знает ли он PHP. Ответил, что знает. Приняли. Дальше он за месяц перечитал весь PHP.net, через несколько лет дорос до ведущего разработчика, и вся эта авантюра давно превратилась в длинную успешную карьеру. Работа ему тогда была не особо нужна, четвёртый курс всё-таки. Это был вызов самому себе: соврал — теперь соответствуй.

Формально перед нами волк. По сути — лучший найм тех лет.

История посвежее. Парень на собеседовании в команду поиска мимоходом упомянул, что знает, как растёт слайс в Go: в одной версии языка алгоритм был один, потом поменяли буквально строчку, и распределение памяти стало лучше. Его спросили, зачем ему это знать. Ответ обезоруживал: незачем, просто прикольно лазить по исходникам. В ту команду он не прошёл, так как не очень хорошо знал Elasticsearch, который там требовался, но запись собеседования увидел тимлид из соседней — и забрал его к себе за один этот ответ.

Вот это и есть джуны. Это люди, которые от чистого любопытства лезут в исходники, на спор выучивают язык за месяц и через несколько лет становятся теми самыми мидлами, которым бизнес сегодня торжественно выдаёт токены. Даниил Пилипенко, который сейчас собирает материал для своей будущей книги о профессионализме, говорит: именно этот искренний, глубинный интерес к тому, как всё устроено под капотом, является основной движущей силой профессионализма.

Интерес заставляет наращивать новые нейронные связи и решать всё более сложные задачи, а не только получать зарплату.

Так что просто в мире появилось новое ремесло — работать с LLM. Как когда-то появилось ремесло работать со счётами, а потом с Excel.

Что там с последним коммерческим облаком в России (и как мы лажали этот год)


Коротко итоги за год:
  • Пустили ИИ в прод.
  • Уволили отдел продаж.
  • Чуть не положили дата‑центр.
  • Ещё раз пустили ИИ в прод.

Сейчас ещё один раунд халявы на 4000 рублей в облаке для новых пользователей.

Примерно год назад мы опубликовали статью о том, что запускаем последнее коммерческое облако в РФ. Тогда мы честно рассказывали про наши амбиции, про ненависть к медленному корпоративному подходу и так далее.

А потом на год пропали. Вышли из беты и пропали.

Нас сгубили корпоративные заказы. Они оказались намного более жирными, чем коммерческое облако. И ещё их стало ОЧЕНЬ МНОГО.

Самый простой ответ на вопрос, почему мы ничего не писали: нам было тупо некогда.

Но облако тоже развивалось. За этот год мы прошли путь от стартапа до нормального IaaS‑провайдера.

Официальный старт состоялся 26 декабря 2025, под самый Новый Год. И пока вся страна просыпалась и лечила похмелье, я сидел и отвечал на тикеты в саппорт. Я смотрел в монитор и думал: «Кто вообще эти люди, которые 1 января лезут настраивать виртуалки и писать в поддержку?»

Январь
В январе мы знали, что просто не будет, потому что люди сталкиваются с облаком, и там для них всё новое и непонятное. А справки, которая идеально всё покрывает, ещё нет. Поэтому приходилось сразу писать справку, допиливать интерфейсы, выносить функции с бека в UI‑панель и так далее.

Тикеты были самые разные: от тривиального «ой, я, кажется, криво загрузил SSH‑ключ, проверьте» и «почему у меня нет денег на балансе» до жёсткого траблшутинга на стадии загрузки ОС через консоль и расследования вторжений в машины.

Почти 100% L2-саппорта я тогда закрывал один, просто потому что доступ к боевым серверам был только у меня. Напомню, у нас команда — 10 человек. Мы с тех пор выросли до мегакорпорации в 20 человек, кстати.

В бете нам прощали мелкие даунтаймы, но в проде ставки выросли. Отвлекаться на написание статей в таком режиме ежедневного тушения пожаров было физически невозможно.

Февраль: пошли крупные факапы
У нас было два по‑настоящему массовых инцидента, которые затронули больше одного тенанта (клиента).

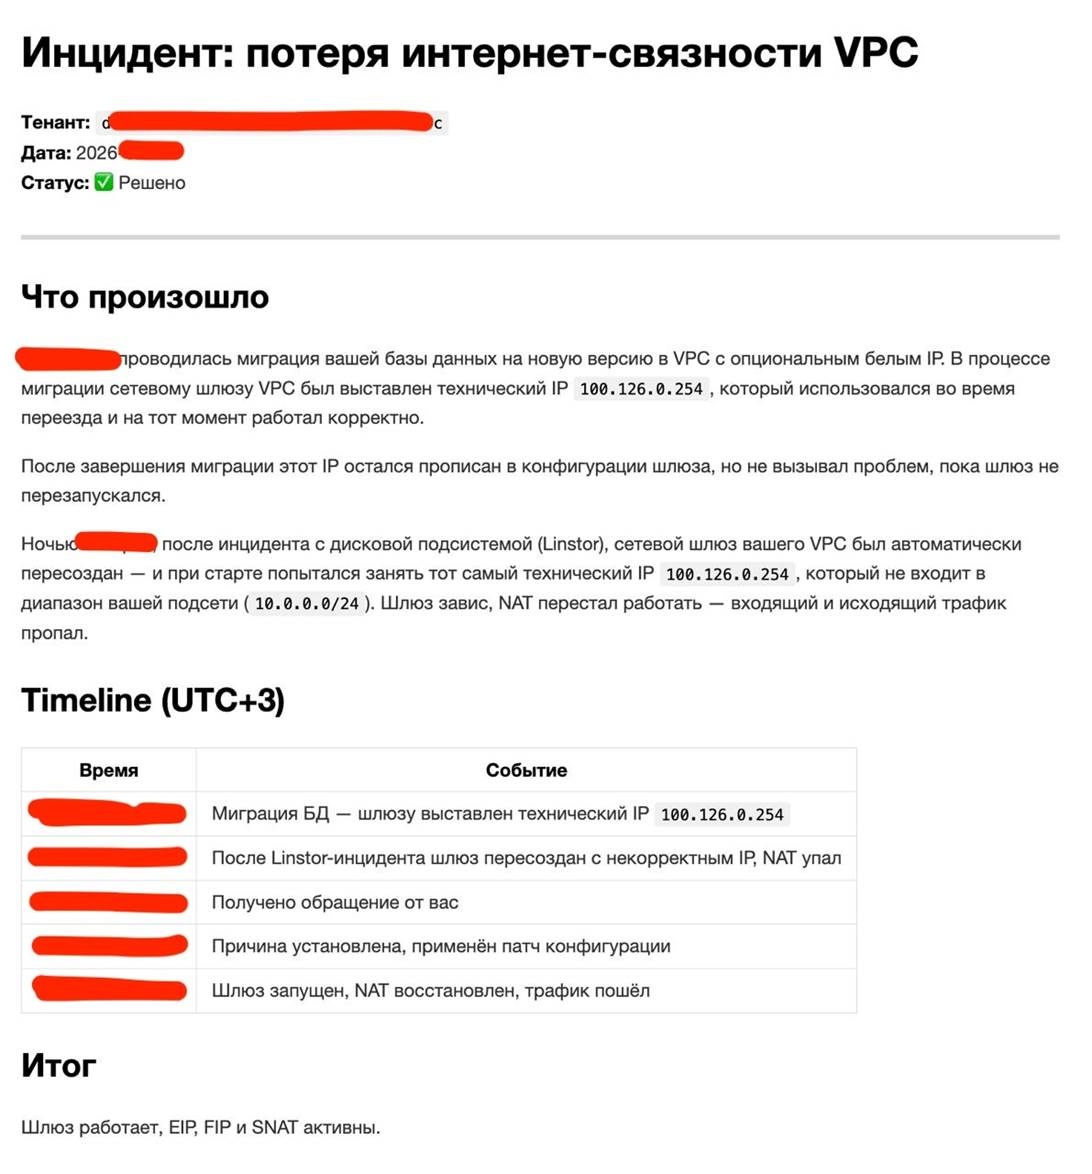
Инцидент первый. Изначально наши Managed БД жили в публичной сети — у каждой был белый IP. Мы решили дать пользователям возможность прятать базы в изолированную приватную сеть. Со стороны кажется: ну поменяй ты IP, пропиши два Network Policy, делов‑то. Нам так в саппорт и писали: «Вы чё, два полиси настроить не можете?» Хотелось ответить: «Приезжай к нам в офис, подпишем NDA, покажешь на нашем проде, как ты это сделаешь».

Дело в том, что у нас под капотом не классический Kubernetes с простыми неймспейсами. За сеть отвечает суровый зверь — Kube‑OVN. Он изолирует тенантскую подсеть намертво. Трафик за её пределы не выходит вообще. Но базой данных управляет оператор, которому нужен доступ к подам БД для контроля жизненного цикла. Нам пришлось изящно и точечно выпускать наружу конкретную нагрузку, сохраняя абсолютную безопасность.

На бете мы бы, конечно, херанули бы иначе. Но тут уже не бета.

Мы сделали это архитектурно, но споткнулись на автоматизации. Скрипт миграции старых баз на новую архитектуру не учёл, что у нас исторически скопилось две версии созданных ресурсов. Версия 2 (более новая) смигрировала идеально. А вот десяток баз версии 1 сломался. Пользователи начали обрывать тикеты: «База недоступна, у меня там прод!» Пришлось всё бросать и ручками, индивидуально по каждому тенанту, править конфиги. Починили быстро, за пределы SLA в годовом измерении не вышли, но седых волос прибавилось.

Инцидент второй: AI‑кодеры и зацикленный IPAM. Мы запартнерились с одним курсом по AI‑кодингу. К нам на интенсив пришла толпа студентов, которым нужно было массово и одновременно разворачивать виртуалки. И тут наш любимый Kube‑OVN выкинул фокус: его счётчик в IPAM зациклился и перестал вовремя освобождать адреса.

Подсеть на 1000 адресов выжралась моментально. Студенты жмут кнопку создания машины, а им не хватает IP! Нам пришлось прямо в моменте, за полтора часа, склеивать четыре маленькие подсети (/24) в одну большую, анонсировать её, учить Kube‑OVN (который из коробки этого не умеет) маршрутизировать трафик в две разные публичные сети и писать скрипты‑костыли, чтобы новые юзеры падали только в новую подсеть.

Самое крутое в этой истории — тенантская изоляция. SLA не пострадал вообще, потому что ни одна из уже запущенных машин даже не моргнула.

Март: AI Ops и чем это закончилось
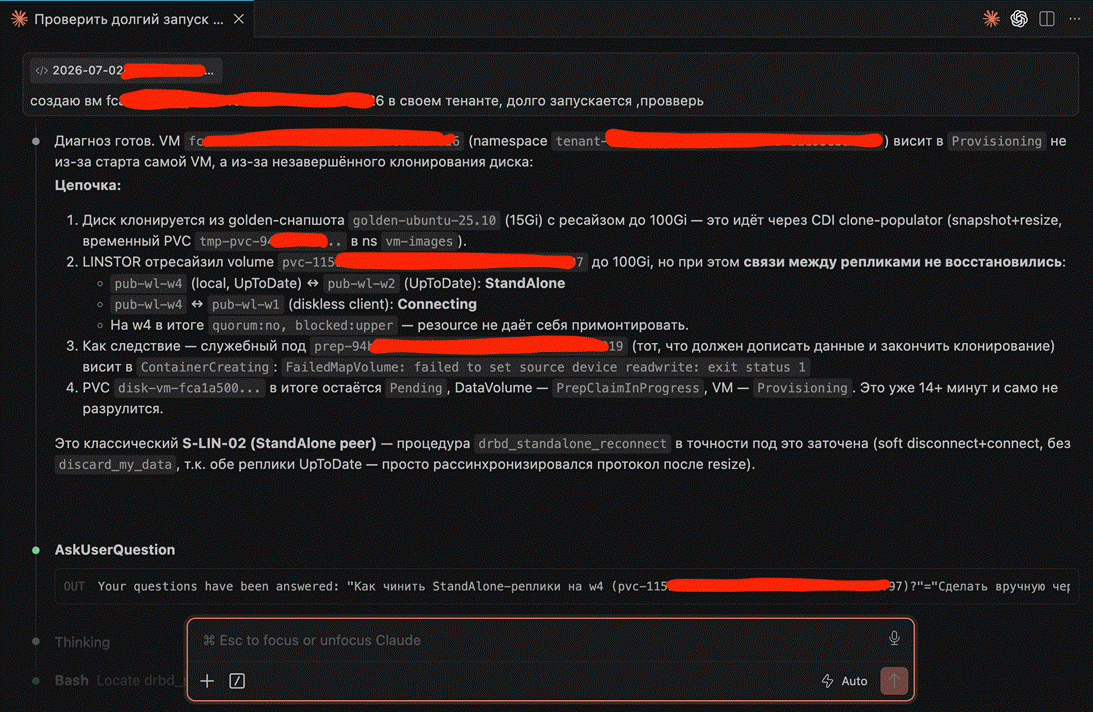
Пока я полгода сидел на первой линии поддержки, я методично превращал свой опыт в данные. Я скрупулёзно собирал каждый кейс в отдельный чат с Claude. У меня накопилось около 500 чатов с детальными постмортемами и десяток пошаговых ранбуков (инструкций по починке). В какой‑то момент стало ясно: пора это автоматизировать. Но пускать LLM в прод бесконтрольно — самоубийство.


Правило 32x. Недавно коллеги из энтерпрайза поделились математикой: успешно решённый ИИ‑агентом тикет стоит 10% от стоимости работы человека. А вот неуспешно решённый (когда ИИ галлюцинирует и ломает систему) обходится в 32 раза дороже, чем если бы туда изначально полез человек. Выгоднее вообще не пускать агента, чем пускать его без тормозов.

Поэтому мы создали строгий фильтр и собственный MCP‑сервер. Он дал агенту строгий набор инструментов и обогащённый контекст (RAG). Наш инструмент всеяден: через OpenRouter мы можем подключать и дорогую Claude Opus, и открытую Code Llama. При правильном контексте и жёстких ранбуках даже дешёвая модель решает задачи на уровне толкового мидла.

Как это работает сейчас:
Автопилот: пользователь пишет, что его виртуалка недоступна. Раньше я тратил 30 минут: пинговал, лез в кластер, проверял сеть, логи, ключи. Сейчас агент делает это сам за 1,5 минуты и выдаёт мне саммари: «Снаружи доступно, внутри сеть жива, SSH отвечает, в консоли виден login prompt, проблема на стыке провайдера юзера и ТСПУ».

Привилегированные действия: если для решения проблемы нужно перезапустить под с новыми параметрами, агент проводит диагностику, находит нужный ранбук и выводит мне всплывающее окно: «Разрешаешь выполнить этот экшен?» Я жму «Да».


Сейчас агент съедает почти 55 миллионов токенов в месяц (в пересчёте по API это было бы около $1100, но в рамках подписки обходится в копейки). Этот «безустальный мидл» закрывает 80–90% рутины.

То есть как бы я есть, но мне надо только покивать на то, что выдумал агент в 90% случаев. Ещё в 2% случаев это нечто новое, и он там накосорезил, и это надо исправить, а стоит это х32, то есть получается 64% работы + 10% — 74%. То есть польза от внедрения агента — 26% экономии рабочего времени.


На деле я немного шучу, но не сильно. В следующие месяцы неопознанных ситуаций стало меньше, и там реально освободилось время.

Кстати, интересный инсайд: к нам пришёл человек из корпорации с 600 разработчиками. Так вот, они массово AI‑кодят, но тщательно скрывают это от руководства. Потому что в корп‑культуре за использование нейросетей могут наказать. Мы же, команда до 20 человек, благодаря легализованному AI‑кодингу обгоняем эту корпорацию по роадмапу на полтора года.

Продажи, корпораты и перебежчики
В прошлом году мы решили поиграть во взрослый B2B‑бизнес. Наняли крутого Head of Sales и коммерческого директора (на минуточку — бывшего коммерческого директора MTS Cloud). Ребята пришли со своей огромной записной книжкой, пошли по старым связям и вширь открыли шикарную воронку продаж в крупном энтерпрайзе.

А на выходе — ноль.

Я сейчас не про те ситуации, когда заказчик пришёл к нам за машзалом в аренду, поставил что‑то своё и крутит (такого, как я уже говорил, много). А именно про попытки поставить корпоратов в коммерческое облако.

Ни одной закрытой сделки.

Почему? Сработал жёсткий коктейль из стартапных реалий и корпоративной бюрократии. Корпоративные безопасники просто резали нас по формальному скорингу. Уставный капитал мы не раздували, а во всех базах светились с чистым убытком. Почему? Да потому что мы реинвестировали вообще всё и вливали бешеные деньги в закупку железа последнего поколения! Но для СБшника в пиджаке это выглядит как: «Э‑э, ребята, с этими не связываемся».

К концу года мы честно признали поражение на этом поле. Мы попрощались со всем отделом продаж и полностью сменили фокус. Наш B2B‑путь — это не прямые продажи, а партнерская модель через доверенных проводников (DevOps‑студии и системных интеграторов). Если DevOps‑студия, которая ведёт инфраструктуру клиента, скажет: «Съезжаем из Яндекса к этим ребятам», — клиент переедет.

А почему? Потому что мы бьём в главную боль гигантов — наплевательское отношение к клиентам. Один из клиентов, который сейчас рассматривает нас в качестве альтернативы, отгружает БигТех‑Облаку 6,5 миллионов рублей ежемесячно. И в поддержке он для них — никто. Его тикеты просто падают в бэклог. Хочется, чтобы на них реагировали? Ещё 1,5 миллиона в месяц, пожалуйста.

Проблема в том, что у того же Яндекса жесточайший вендор‑лок. Просто откройте их документацию в разделе «Как перенести данные своей виртуальной машины». Там бесконечная простыня текста и целая последовательность шагов с бубном: вот тут постучи, тут попляши, тут за ухом почеши — и так для каждой виртуалки.

Поэтому прямо сейчас мы дописываем автоматизацию этого процесса миграции. В том числе автоматизацию бубна. Мы хотим сделать так, чтобы вытащить инфраструктуру клиента из клетки вендор‑лока корпораций можно было без боли. С VMware, кстати, тоже помогаем соскочить.

Воронка открылась шикарная. На выходе — уже не ноль закрытых сделок )

Ещё халява
Наша старая механика «закинь 5000 рублей и получи год ресурсов» отлично отсекала ботов. Основная проблема была именно с триал‑хантерами, когда пробовали чуть ли не майнить.

Но там надо было доставать и показывать 5000 рублей на баланс (и их можно было потом вернуть в любой момент). Это как капча: показать 5000 рублей робот не может.

На vc.ru уже есть пост от одного обиженного юзера, который возмущался, что мы попросили паспортные данные, чтобы оформить ему возврат аж 6 рублей с баланса. Он там путает тёплое с мягким, мы попросили паспорт, чтобы перевести ему сумму с баланса обратно (все 5к), а не для отмены списания на 6 рублей (которые, конечно, отменили без вопросов). В общем, всё строго по правилам и вбелую.

Сейчас у нас другая механика — проще.

Теперь при регистрации мы даём бонусный демо‑баланс 4000 рублей на один месяц.

Аккаунт надо подтвердить: российский телефон, российская карта. Без этого, увы, по закону нельзя.

Что выкатываем прямо сейчас
Наш базовый IaaS (виртуальные машины, VPC, быстрые диски, S3, балансировщики, Managed PostgreSQL) работает как часы. Managed Kubernetes тоже работает в полный рост — автоскейлинг вверх и вниз, автоапдейт, autoprovisioning PV и load balancer с белым IP. Плюс мы сейчас дотягиваем его до уровня оператора Capability Level 5 (полный автопилот).

Впереди жирные релизы:
  • Serverless‑платформа (preview в конце сентября). Это Serverless Functions, Containers, очереди, Key‑Value БД и API Gateway. Главная фича: масштабирование до нуля. Пока нет запросов — контейнер схлопывается в 0 реплик, и вы не платите за простой. Логи, трейсы и метрики интегрированы из коробки.
  • AI‑платформа (в октябре). Managed inference, GPU‑виртуалки, среда для обучения открытых моделей. Мы делаем свой AI Gateway, который по API на 100% совместим с OpenAI и Anthropic. Чтобы переехать к нам, вам достаточно поменять одну строчку с URL в вашем коде.
  • AI Ops для Managed Kubernetes (октябрь). Тот самый MCP‑сервер, который мы отладили на своей поддержке, мы отдаём пользователям. Ваши SRE‑инженеры получат AI‑агента, который помогает чинить инциденты по вашим ранбукам.
  • SDLC‑платформа (релиз к концу года). Знаете проблему, когда ИИ‑кодер нагенерил кода, уволился, и весь контекст архитектуры (C4, Gherkin) потерялся? Наша платформа хранит весь агентский контекст унифицированно. А ещё она решает новую болезнь индустрии: когда разрабов премируют за использование ИИ, они качают с Гитхаба скрипты, которые гоняют LLM по кругу, просто чтобы сжечь токены для KPI. Наша SDLC считает реальные DORA‑метрики и показывает экономику фичи, включая стоимость потраченных на неё токенов.

Почему мы не боимся спойлерить роадмап?
Резонный вопрос: вдруг Яндекс или Сбер прочитают и скопируют? Не боимся. Показательный пример: в 2022 году от MWS (MTS Cloud) ушёл вендор Canonical, оставив их OpenStack без поддержки. Ребята выбили 7,5 миллиардов рублей инвестиций, наняли 400 человек и пошли пилить облако. В итоге в сентябре прошлого года они выкатили то, что у нас работало ещё в мае. Чтобы нас догнать, конкурентам с их масштабом и текущими обязательствами нужно сначала набить наши шишки и влить миллиарды в инфраструктуру. Можно пробовать )

Почему мы так уверены в своих силах? Во‑первых, по чистой производительности мы обходим гигантов. У того же Яндекса база — это Xeon 2-го и 3-го поколения и память DDR4. У нас — 5-е поколение Xeon и DDR5. В бенчмарках мы быстрее в 2 раза в базе, в 5–7 раз на базах данных и до 10 раз в инференсе.

Про инференс и GPU в целом есть нюансы. Мы ждём поставку GPU‑установок топового уровня — целимся построить кластер в два раза больше Сберовского суперкомпьютера. Но сроки уехали до 20 недель, а поставщики в открытую говорят: «В Китае я продам каждую установку на $200 000 дороже, чем повезу вам в РФ». Цена улетела за миллион долларов за штуку. Притом что себестоимость её ниже 500 тысяч. Это новые реалии, которые рождаются спросом.

А ещё мы активно переселяемся в собственные ЦОДы: с нами по соседству живёт инфраструктура Cloud.ru, X5 и OZON, что делает объект очень лакомой мишенью. Глядя на то, что происходит вокруг, очень не хочется, чтобы нам прилетело «за компанию».

Так что мы вернулись, и мы поехали дальше.

h3llo.cloud

Подключаем международные каналы связи


Прокладываем международные ВОЛС — в 23:00 моргнём на пять минут
Новость из машзала: подключаем собственные международные каналы связи. Прям настоящие трансграничные ВОЛС.

Техническая часть
Прямо сейчас переходим на наши каналы. Сегодня (10.07.26) в 23:00 по Москве возможны перерывы связи длительностью до 5 минут. Работы плановые, дольше не затянем.

Обновлена юридическая информация


Было


Стало

h3llo.cloud

Как попробовать Managed Kubernetes, кайфануть, и больше никогда не соглашаться на что-то другое


В пятницу мы открыли Managed Kubernetes, и сделали рассылку об этом (и еще о нескольких обновлениях).

И, возможно, показали его слишком инфраструктурно. Когда я вижу тарифы Dev / Prod / Prod+, сроки и цены, я читаю это так:
«Ага, опять что-то впаривают».

Это не то, что мы хотели показать.

С того момента, как мы запустили кубер в preview, мы сами создаём и убиваем кластеры по 10 раз в день — и дико тащимся от этого. Отношение к kubernetes поменялось очень сильно.

Было так:
  • «Вожусь ручками, чтобы поднять кластер, а потом молюсь на него».

Стало так:
  • «Ща, 5 сек, подниму кластер под эту задачу и отдам нейронке kubeconfig».

И вот этот кайф очень трудно передать экраном с выбором пакета.

Его надо просто ощутить:
  • Клик — и через пару минут уже можно деплоить в прод, вместо танцев с виртуалками и kubespray. Кайф!
  • Балансировщик с белым IP — одним манифестом, вместо дрочи с MetalLB и HAProxy. Огонь, дайте два!
  • Сетевой диск с репликацией — одним манифестом. Поднимали Ceph и CSI с AutoProvisioner или Rook? Забудьте!
  • Обновление и масштабирование — просто галочки, и всё едет само. На этих строчках где-то прослезился DevOps on-prem кластера.

Вот в чём смысл Managed Kubernetes.

Не купить пакет. Не выбрать побольше vCPU и RAM. Не собрать очередной инфраструктурный проект вручную.

А дойти от идеи до работающего кластера настолько быстро, что kubernetes перестаёт быть отдельной проблемой.

Мы даем не ресурсы, мы даем драйв от того, что:
  • кластер готов по клику;
  • сеть, диски и балансировка уже встроены;
  • первый деплой можно сделать через пару минут;
  • расходы понятны заранее, и они меньше, чем у любого другого провайдера;
  • при необходимости можно вырасти в моменте хоть в 10 раз, без заморочек;
  • если что-то не зайдёт, есть 7 дней на полный возврат.

Итого:
  • Было: сначала пинаем кубер, потом допиливаем напильником, и уже потом начинаем работать.
  • Стало: поднимаем кластер под задачу в один клик, и сразу идём к релизу.

И это обязательно надо попробовать!

Посмотреть, что входит в платформу mk8s.h3llo.cloud

В следующем письме покажу самый первый шаг: от активации до живого кластера и первого деплоя.

P.S. Если вам не хочется разбираться с kubernetes, а хочется просто попробовать на практике — следующее письмо будет особенно полезным.

С уважением,
Константин
CTO \m/
h3llo cloud

Бодрый апдейт: Kubernetes для всех, бюджетные ВМ и голое железо


За последнее время у нас накопилось несколько обновлений. Расскажу по порядку.

Managed Kubernetes
Запустили autoscaling, autoupdate и сделали control-plane бесплатным для dev-кластеров. Если Kubernetes давно висел в списке «разберусь когда-нибудь» — сейчас отличный момент.
  • Autoscaling — кластер сам подстраивается под нагрузку, скейлится и вверх, и вниз.
  • Autoupdate — версии обновляются без ручного вмешательства (по клику или по расписанию).
  • Control-plane для dev-кластеров не тарифицируется.
Dev-пакет — 3 месяца за 12 000 ₽ (4 000 ₽/мес)
Прод-пакеты — от 15 000 ₽/мес.
Знаем, что Kubernetes пугает не столько ценой, сколько количеством вкладок, которые нужно открыть, чтобы в нём разобраться. Поэтому готовим гайды и разборы — для тех, кто хочет разобраться по-настоящему, а не просто запустить кластер и молиться.
app.h3llo.cloud/ru/billing/commitment_package/new_package

Капсулы — бюджетные виртуальные машины
Запустили новый тип ВМ на Xeon 4-го поколения с DDR5 — от 545 ₽ в месяц. Это реальная стартовая цена, без звёздочек и мелкого шрифта снизу.

Можно запускать как некритичные задачи, так и прод для нормальных нагрузок. Отличие от ВМ — тарификация за месяц и одна реплика диска (тогда как у инстансов — две).
Найти можно в консоли, в разделе «Капсулы»
app.h3llo.cloud/ru/console/

Bare-metal: два CPU, до 512 ГБ RAM
Добавили конфигурации с двумя процессорами и памятью до 512 ГБ.

В панели управления появятся совсем скоро, но если нужно прямо сейчас — напишите в поддержку или на почту. Дадим сервер со скидкой.

До запуска в релиз раздаем сервера от 19 000 рублей в месяц. Это за 44 ядра и 128 ГБ RAM!

GPU-инстансы — уже едут!
Готовим инстансы с GPU. Мы собираем резервы, потому что конфигурации и цены будут прям очень сочные! Застолбить хоть одну карточку, хоть целый кластер из 8 установок HGX B300 можно ответив на это письмо.

Еще пачка улучшений
Другие способы логина: теперь можно логиниться без кода из письма. Мы прикрутили TOTP и WebAuthN, оба способа можно настроить в личном кабинете. И почта теперь ходит без задержек.

На подходе: продвинутый Load Balancer, Security Groups и IAM. Подробности — в следующих письмах.

С уважением,
Константин
CTO \m/
h3llo cloud

Вы просили - мы сделали: Public API + Terraform


Мы запустили Public API и выкатили официальный Terraform Provider.

Да, тот самый. Теперь инфраструктура — это не только пара кликов мышкой в нашем симпатичном UI. Это еще и код.

Сценарий максимально скучный и поэтому прекрасный: terraform apply. И через несколько минут у тебя живой сервис. Без дрочи с security group, без “почему порт закрыт”, без ритуалов с тремя перезапусками и пробиванием кеша.

Мы сейчас пишем набор готовых рецептов — чтобы одной коммандой можно было поднимать:
  • продакшен-сайты;
  • n8n;
  • OpenClaw + OpenRouter;
  • личную или корпоративную почту на своем домене;
  • файловые серверы;
  • TG-ботов;
  • корпоративные чаты, wiki и таск-трекеры;
  • GitLab и свои Container Registry;
  • VPN;
  • и даже k8s!
Идея простая, как в песне: «I see it, I like it, I want it, I got it». Нужен файловый сервер — terraform apply, и готово. Нужен OpenClaw? Аналогично.

Бубен висит на стене, шаман отдыхает. Магия — это когда работает с первого apply. Именно так выглядит облако здорового человека.

Terraform уже живой. Инфраструктура уже код.

h3llo.cloud

С уважением,
Константин
CTO \m/
h3llo cloud