Статистика продаж за 2 квартал 2026 года: последние результаты


Управление облачным хранилищем означает одновременно и роль строителя, и строительного инспектора. Вы выбираете материалы, используете их в больших масштабах и ежеквартально проверяете, как держится конструкция. После более чем 13 лет публикации статистики Drive Stats мы хорошо знаем материалы, использованные в этом конкретном доме. Поэтому, когда наш любимый магазин товаров для дома представляет новый, улучшенный кирпич (так сказать), мы хотим понять, как он впишется в строительную конструкцию.

Этот вопрос становится все более актуальным, поскольку накопители большей емкости становятся (осмелимся сказать) более нагруженными. Мы уже отслеживали производительность накопителей объемом 20 ТБ и более в целом; позже в этом выпуске статистики накопителей мы поговорим о некоторых различиях между нашими нынешними основными компонентами (жесткими дисками CMR) и новыми устройствами. Но сначала, чтобы довести эту затянувшуюся игру слов до неизбежного завершения, проведем осмотр (или, другими словами, статистику).

В этом отчете о статистике приводной техники за второй квартал 2026 года мы начнем с обзора последних данных: годовых показателей отказов за квартал, моделей, которые показали себя лучше всего, и общего срока службы парка. Затем мы рассмотрим некоторые новые технологии, которые могут определить следующий этап строительства.

Статистика поездок: краткая версия
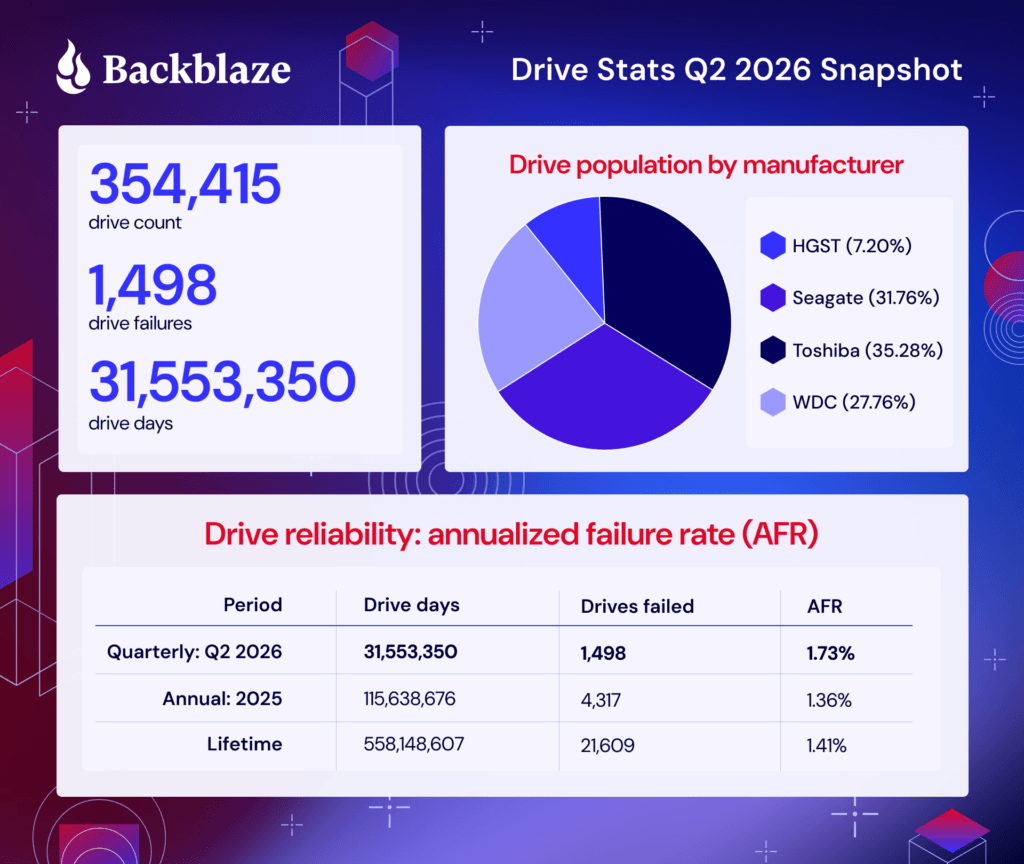

Показатели отказов жестких дисков во втором квартале 2026 года.
В течение второго квартала 2026 года компания Backblaze отслеживала 359 101 диск, используемый для хранения данных. Для нашей оценки мы исключили из рассмотрения 3881 загрузочный диск и 705 жестких дисков, поскольку они не соответствовали критериям включения. Критерии, которые мы использовали, будут рассмотрены в следующем разделе этого отчета. После исключения этих дисков у нас осталось 354 415 жестких дисков для анализа. В таблице ниже показаны годовые показатели отказов за первый квартал 2026 года для этой группы дисков.

Показатели частоты отказов жестких дисков Backblaze за 2 квартал 2026 года
Отчетный период: 1 апреля 2026 г. – 30 июня 2026 г. включительно.
Модели приводов с количеством приводов > 100 и количеством приводных дней > 10 000 по состоянию на 30 июня 2026 г. во втором квартале 2026 г.
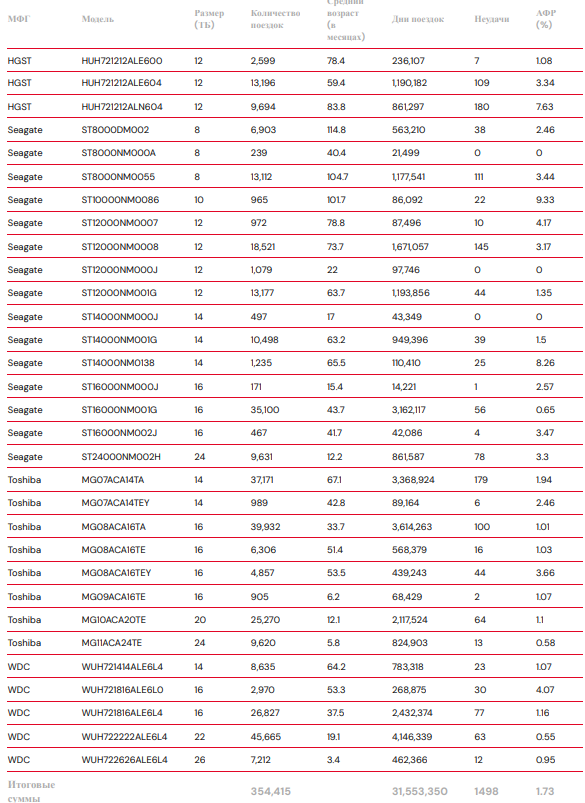

Заметки и наблюдения
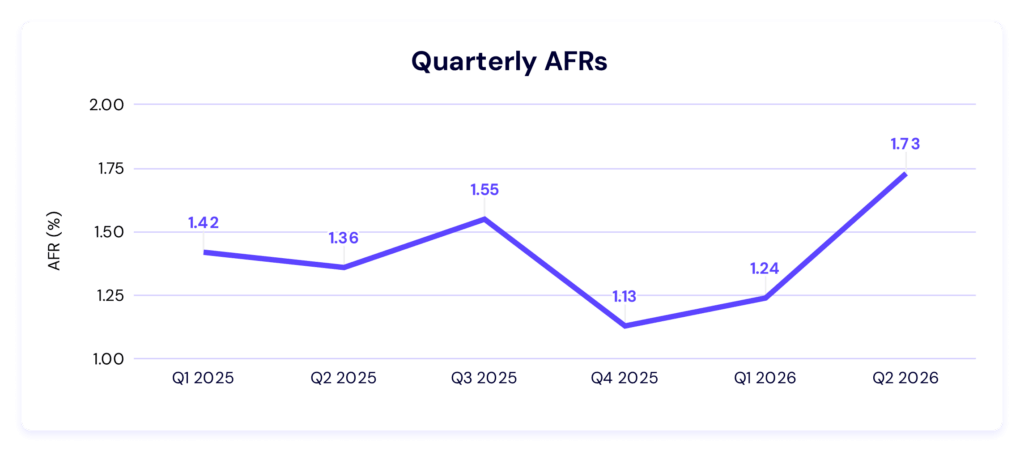
Квартальный показатель AFR составляет 1,73%, что является самым высоким показателем за довольно долгое время. Мы поговорим о причинах чуть позже, а пока представляем вам квартальную динамику уровня отказов:

Как обычно, давайте подведем итоги. У этих накопителей не было ни одного сбоя:
  • Seagate ST8000NM000A (8 ТБ)
  • Seagate ST12000NM000J (12 ТБ)
  • Seagate ST14000NM000J (14 ТБ)
И у этих накопителей был один:
  • Seagate ST16000NM000J (16 ТБ)
  • Никаких опечаток, друзья: Seagate одержала полную победу.

Старые накопители уходят в прошлое. В этом квартале мы стали свидетелями полного вывода из эксплуатации двух жестких дисков: 4-терабайтного HGST HMS5C4040BLE640, которому почти девять лет, и 8-терабайтного HGST HUH728080ALE600, которому почти восемь лет.
Но где же новинки? Как и в прошлом квартале, новых моделей накопителей нет — это любопытно, особенно учитывая, что такое происходит уже второй квартал подряд. Но, как и в прошлом квартале, это не означает отсутствия новых развертываний. Хотя количество большинства моделей накопителей осталось более или менее неизменным (плюс-минус замены), мы снова видим, что развертывание сосредоточено в основном на накопителях объемом более 20 ТБ.

Что происходит с этими элитными экземплярами, выходящими за рамки стандартных предложений?
В этом квартале у нас было три выброса, которые, согласно анализу по квартилям, определяются как показатели AFR выше 6,95%. Этими выбросами являются:
  • HGST HUH721212ALN604 (12 ТБ) — 7,63 %
  • Seagate ST10000NM0086 (10 ТБ) — 9,33%
  • Seagate ST14000NM0138 (14 ТБ) — 8,26%
У каждого из этих накопителей есть довольно очевидные причины высокой частоты отказов. Накопителю HGST почти семь лет, а 10-терабайтному Seagate — почти 8,5 лет.

Между тем, оба накопителя Seagate имеют довольно низкое количество отказов — у 10-терабайтного накопителя всего 965, а у 14-терабайтного — 1235. Это означает, что, хотя у них было всего 22 и 25 отказов (соответственно), их показатели AFR были довольно высокими.

Стоит отметить, что в общей сложности у семи накопителей показатель AFR по-прежнему превышал 3,0%. Хотя мы только что определили, что это не выбросы, это все равно довольно много высоких значений AFR по сравнению с другими кварталами — это означает, что у 10 из 31 накопителя показатель AFR был выше 3,0%.

Я не проводил полного анализа того, насколько редко встречается такое сильное смещение распределения более чем на 3,0%, но беглый взгляд на последние несколько кварталов показывает, что оно смещено в сторону верхней границы спектра. Это, конечно, повысит наш средний показатель. За этим стоит следить в дальнейшем.

Стандартные определения
Как уже упоминалось, мы удаляем диски, не соответствующие нашим критериям. Причины, по которым мы ввели эти исключения, мы уже объясняли в предыдущих отчетах, но вот краткое изложение сути:
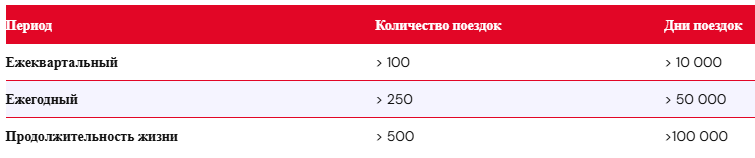

Независимо от того, включена ли конкретная модель привода в диаграммы и таблицы этой статьи, все данные по отдельным позициям содержатся в нашем наборе данных статистики приводов, который вы можете загрузить, посетив нашу страницу статистики приводов.

Показатели отказов жестких дисков за весь срок службы
Показатели отказов жестких дисков Backblaze за весь срок службы
Отчетный период, заканчивающийся 30 июня 2026 года включительно.
Модели приводов с более чем 500 приводами и более чем 100 000 приводных дней за весь срок службы.
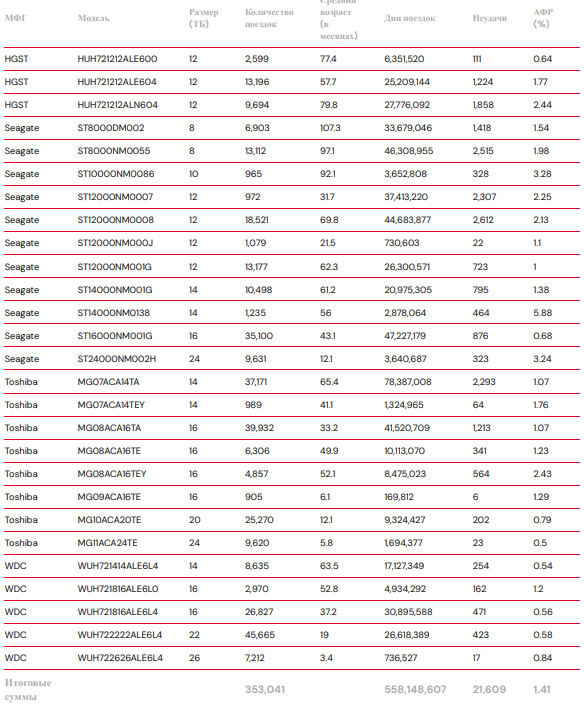

Заметки и наблюдения
Показатель AFR за весь период существования компании остается стабильным. В этом квартале мы наблюдаем небольшой рост до 1,41%.
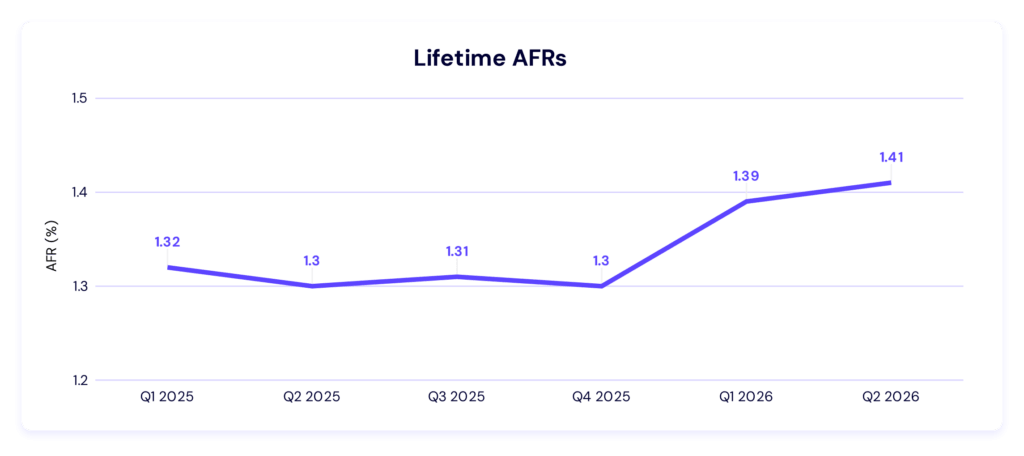

Четыре модели не попали в таблицу учета общего количества накопителей. Эти модели не достигли минимального количества накопителей, необходимого для включения в таблицу учета общего количества накопителей:
  • Seagate ST8000NM000A (8 ТБ) — 239 дисков
  • Seagate ST14000NM000J (14 ТБ) — 497 дисков
  • Seagate ST16000NM000J (16 ТБ) — 171 диск.
  • Seagate ST16000NM002J (16 ТБ) — 467 дисков
Интересно, что первые три пункта в этом списке также входили в наш список компаний, не допустивших ни одного сбоя.

Что касается тех более крупных накопителей?
В последнее время в этой серии статей мы много времени уделяли обсуждению накопителей большой емкости. Клуб накопителей объемом более 20 ТБ вырос из редкого явления до более чем 25% накопителей в данных за этот квартал, и развертывание продолжает концентрироваться на более крупных моделях.

В нашей отрасли мы наблюдаем устойчивое движение к увеличению емкости накопителей — компания WD только в этом году анонсировала накопитель UltraSMR на 40 ТБ, а в дорожной карте показано, как они достигнут объема в 100 ТБ к 2029 году. Один из способов повышения плотности — изменение расположения дорожек на диске, что влияет на то, как центры обработки данных считывают и записывают данные. Давайте поговорим о том, как это выглядит на практике.

CMR, SMR и несколько слов о кровле
Жесткие диски записывают данные по концентрическим дорожкам. Каждая дорожка может быть перезаписана независимо. Прежде чем мы перейдем к чему-либо еще, важно понимать, что существует разница в физических размерах между считывающей и записывающей головками жесткого диска.
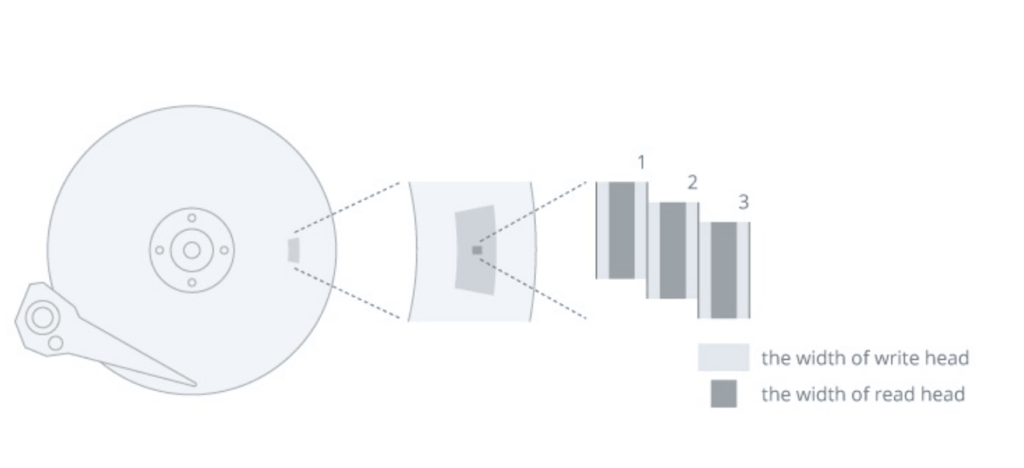

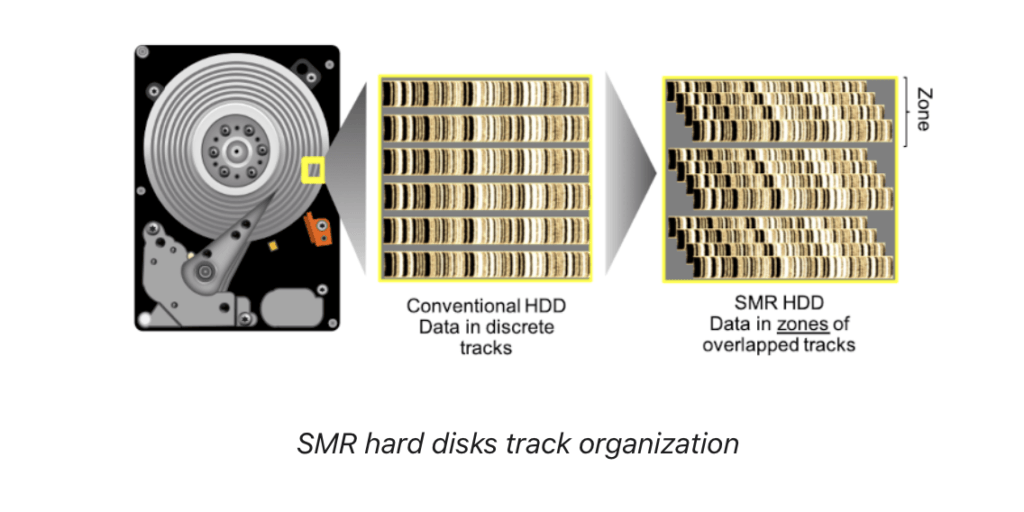
При обычной магнитной записи (CMR) дорожки располагаются рядом друг с другом с защитным зазором между ними. При черепичной магнитной записи (SMR) геометрия дорожек изменяется. Дорожки перекрываются, подобно кровельной черепице — это название, на котором, по крайней мере для этого отчета, мы решили сделать упор.

Теперь вернёмся к головкам накопителя: этот метод работает потому, что записывающая головка накопителя прокладывает более широкую дорожку, чем требуется для чтения считывающей головке. Перекрытие части каждой дорожки следующей позволяет данным оставаться читаемыми, при этом большая их часть помещается на диске. В зависимости от реализации это может увеличить ёмкость примерно на 10–25%.

Компромисс также напоминает настоящую черепицу: изменение чего-либо в середине может нарушить то, что было наложено поверх этого. SMR организует дорожки в полосы или зоны, поэтому обновление данных может потребовать от накопителя — или управляющего им программного обеспечения — реорганизации большего участка.

То, как управляется такое поведение, имеет значение, поэтому вы на самом деле увидите несколько разных вариантов SMR:
  • SMR с управлением накопителем: встроенное программное обеспечение накопителя обрабатывает размещение данных и перезапись полос. Для хоста он выглядит как обычное блочное устройство, но производительность записи может стать непредсказуемой.
  • SMR с управлением хостом: операционная система или приложение записывают данные последовательно в пределах обозначенных зон. Это требует совместимого программного обеспечения, но дает хосту больший контроль.
  • Поддержка команд SMR с учетом хоста: обеспечивает поддержку команд SMR, сохраняя при этом некоторую совместимость с традиционными рабочими процессами.
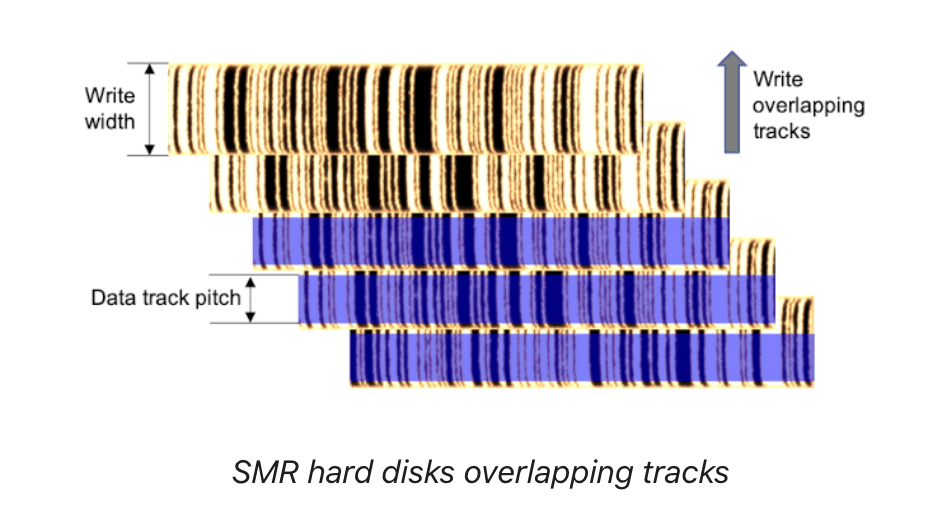
Без наглядного примера это может быть немного сложно понять, поэтому вот как это выглядит на практике. Вот разобранная версия ленты записи SMR:


А также сравнение CMR и SMR.


CMR против SMR приводов: в чем разница?
Чтобы всё было предельно ясно (игра слов, как всегда, уместна), вот удобная таблица для сравнения:
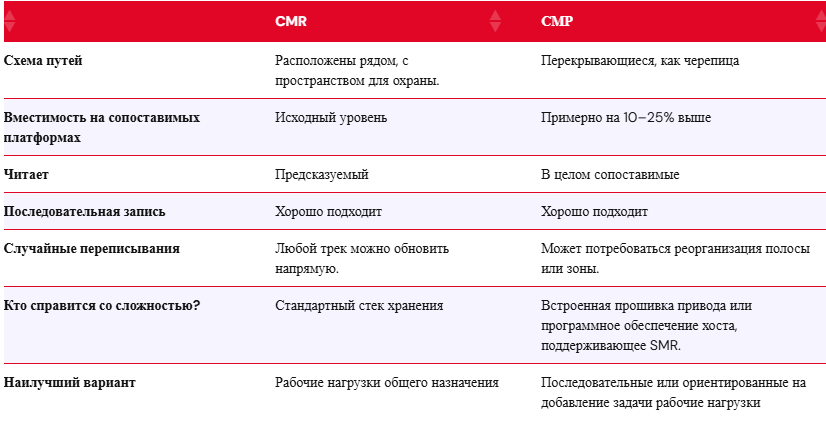

Что означают CMR и SMR в центре обработки данных?
Привлекательность очевидна: больше терабайт на один слот для накопителя, в том же объеме стойки, при примерно одинаковом энергопотреблении на уровне накопителя. Это может улучшить как экономическую эффективность (в долларах), так и энергопотребление (в ваттах) без необходимости строительства нового здания. В масштабах центров обработки данных даже небольшое увеличение плотности превращается в очень большое число, имеющее денежный знак перед ним.

Однако SMR учитывает структуру рабочей нагрузки. Последовательная и ориентированная на добавление запись хорошо сочетаются с его архитектурой; частые небольшие перезаписи создают больше работы. В зависимости от типа SMR, программному стеку также может потребоваться понимание зон и соответствующее размещение данных.

Это делает процесс квалификации менее похожим на «замену накопителя» и больше на «планирование проекта». Емкость и AFR по-прежнему важны, но не менее важны устойчивое поведение при записи, производительность восстановления, накладные расходы на кодирование четности или исправление ошибок, встроенное ПО и программное обеспечение для хранения данных, установленное поверх накопителя.

А что насчет HAMR?
Не будем прибегать к банальным шуткам, давайте поговорим о том, как HAMR вписывается в этот разговор.

HAMR — это технология жестких дисков, при которой во время записи данных микроскопическая точка на пластине нагревается лазером в течение короткого времени. Нагрев позволяет накопителю записывать данные на более мелкие и стабильные магнитные зерна, увеличивая объем данных, который может поместиться на каждой пластине. И хотя большинство пластин жестких дисков традиционно изготавливались из алюминиевых сплавов, стекло является стандартом для 2,5-дюймовых накопителей HAMR и все чаще используется в высокоемких 3,5-дюймовых накопителях HAMR.

Поскольку эти технологии решают разные проблемы, производители могут их комбинировать. Поэтому ответ на вопрос «SMR или HAMR?» в большинстве случаев — «да».

Что это значит для статистики поездок?
В настоящее время в парке накопителей Backblaze нет дисков SMR, и ни один из дисков, представленных в таблицах выше, не имеет черепичной конструкции. Однако технология SMR разрабатывается в масштабах всей индустрии жестких дисков, и «не сегодня» не означает «никогда».

Мы будем подходить к этому так же, как и к первым накопителям большей мощности: по мере поступления в парк накопителей SMR мы будем отмечать, какие именно это накопители, и у нас будет возможность обсудить их коэффициенты AFR.
Beget сделал публичную IPv6-подсеть /64 доступной для облачных серверов во всех локациях


Облачная платформа Beget предоставила публичную IPv6-подсеть /64 для облачных серверов во всех локациях. IPv6 можно использовать одновременно с IPv4 или вместо него. Подключить подсеть к облачному серверу можно в панели управления Beget.

IPv6 для облачной инфраструктуры

Подсеть IPv6 /64 предоставляется бесплатно и позволяет выделять глобальные IPv6-адреса отдельным сервисам, контейнерам и другим сетевым ресурсам. В ряде сценариев это помогает сократить использование NAT и упростить организацию сетевого взаимодействия.

«IPv6 особенно актуальна для инфраструктур с большим количеством сервисов, контейнеров и сетевых ресурсов. Мы сделали публичную подсеть /64 для облачных серверов Beget, чтобы пользователи могли гибко развивать инфраструктуру и не сталкиваться с ограничениями адресного пространства IPv4. IPv6 позволяет выделять публичные адреса отдельным сервисам и другим ресурсам, а возможность использовать протокол одновременно с IPv4 дает возможность постепенно внедрять его в существующую инфраструктуру без необходимости перестраивать ее целиком», – Владислав Колесников, CPO Beget.

Сценарии использования

Публичную IPv6-подсеть можно использовать для размещения сайтов и API, запуска Docker и Kubernetes, построения микросервисных архитектур, создания тестовых и изолированных сред, а также проектов с большим количеством подключаемых устройств, включая IoT.
Большое адресное пространство IPv6 позволяет гибко организовывать сети и выделять адреса отдельным контейнерам и сервисам. Использование IPv6 параллельно с IPv4 позволяет постепенно внедрять протокол в существующую инфраструктуру.

Подключение IPv6


Публичную IPv6-подсеть /64 можно подключить к любому виртуальному серверу в панели управления Beget.

Для пользователей доступны инструкции по настройке глобальных IPv6-адресов для контейнеров и размещению сайта и API с поддержкой IPv6 и IPv4. В дальнейшем Beget планирует расширить доступность IPv6 для других облачных продуктов, включая облачные базы данных и Kubernetes.

Inscale 3.0.0: группы доставки, единый дашборд кластеров и массовая диагностика

Вышла версия 3.0.0 Inscale — российской платформы серверной виртуализации и VDI на KVM (разработчик — «Лаборатория Виртуализации», Санкт-Петербург, реестр российского ПО № 28671).

Для эксплуатации кластеров

  • единый дашборд по кластерам и серверам;
  • удалённый перезапуск сервисов, сбор логов и массовая диагностика узлов из консоли;
  • выбор шины и типа диска ВМ, шифрование дисков стало опциональным;
  • улучшена работа с iSCSI.

Для VDI

  • группы доставки: пользователи, пулы, политики и профиль протокола назначаются одним объектом;
  • права из AD/LDAP выдаются заранее по атрибутам каталога;
  • блокировка локальных учётных записей;
  • клиент показывает состояние сессии.

Метрики выгружаются в Zabbix, Prometheus и Grafana.

Полный список изменений — в release notes. Сайт: inscale.ru

Больше места для рабочих задач


Мы запустили новую услугу — облачное объектное хранилище S3 для хранения файлов, резервных копий, медиаконтента, логов и данных приложений.

Хранилище подойдёт как для активных данных, к которым нужен быстрый доступ, так и для объёмных архивов. Данные размещаются на NVMe-накопителях, а поддержка S3 API позволяет легко подключать хранилище к приложениям, сервисам резервного копирования, CLI и привычным SDK.

Сервис масштабируется без остановки работы и обеспечивает высокую доступность и надёжность хранения за счёт репликации данных на нескольких узлах.

Стоимость аренды хранилища — 2,5 ₽ за 1 ГБ в месяц.
Оплата списывается ежедневно, по факту максимального занятого объёма за предыдущие сутки.

Доступный объём хранилища — от 100 ГБ до 10 ТБ.

ispserver.ru/s3

Обновление Публичной Оферты и Условий возврата средств


ООО «Хостинг-оператор „еСервер.ру“ уведомляет Вас об утверждении и публикации новой редакции „Публичной оферты о предоставлении услуг хостинга и серверной инфраструктуры“ и „Правил возврата денежных средств“.

Новые редакции указанных документов вступают в силу с 28 сентября 2026 года.

Изменения направлены на актуализацию условий предоставления услуг, уточнение порядка взаимодействия между Компанией и Клиентами, условий предоставления отдельных видов услуг, расчетов, ответственности сторон, порядка приостановления и прекращения услуг, а также приведение положений Оферты в соответствие с действующим законодательством Российской Федерации и текущими условиями работы Компании.

Ознакомиться с новой редакцией Публичной оферты можно по постоянному адресу: www.eserver.ru/documents/eserver-virtual-hosting-agreement-online.html
Ознакомиться с новой редакцией Правил возврата денежных средств можно по постоянному адресу: www.eserver.ru/documents/refund-policy.html

Продолжение использования Услуг после вступления новой редакции Оферты в силу означает принятие ее условий в порядке, предусмотренном Офертой и законодательством Российской Федерации.

Если Вы не согласны с изменениями, Вы можете отказаться от дальнейшего использования Услуг в порядке, установленном Договором и Правилами возврата денежных средств.

В DCImanager появился мониторинг сетей Fibre Channel и FC-коммутаторов


В DCImanager появилась возможность работы с сетями Fibre Channel (FC) и FC-коммутаторами. Теперь их можно учитывать в системе, связывать с СХД и видеть вместе с Ethernet-инфраструктурой.

Для FC-коммутаторов мы добавили получение данных из Fabric Operating System (FOS), автоматический учет WWNN, WWPN и FCID, а также указание типа соединения — FC или Ethernet. В системе можно учитывать связи между серверами, СХД и коммутаторами и контролировать состояние FC-соединений.

Новая возможность подойдет компаниям, которые используют системы хранения данных и FC-сети: она позволяет контролировать состояние сетей хранения, а также отслеживать работоспособность связей между СХД и серверами.

Что дает мониторинг FC-коммутаторов:
  • Единое представление инфраструктуры: в одном окне видны все компоненты сети хранения, FC-коммутаторы, серверы и СХД.
  • Понятные связи: можно увидеть, как сервер подключен к СХД и через какие коммутаторы проходит соединение.
  • Быстрый поиск проблем: схема подключений помогает быстрее определить, на каком участке сети хранения нарушилась связность.

Зачем нужен учет и мониторинг FC-сетей
FC-сети отличаются от Ethernet особенностями передачи данных. При потере соединения восстановление передачи по другим маршрутам может занимать больше времени и ресурсов, поэтому важно своевременно обнаруживать проблемы со связностью.

В Ethernet-сетях для идентификации сетевых интерфейсов используются IP- и MAC-адреса. В Fibre Channel для этого используются свои сущности: WWPN (World Wide Port Name), WWNN (World Wide Node Name) и FCID (Fibre Channel ID). Для полноценного учета серверов и их подключений к FC-сетям важно учитывать и параметры FC.

Есть и другая особенность: в FC-сетях передаются данные файловой системы. Если в Ethernet обрыв соединения может привести к кратковременной недоступности прикладного сервиса, то в FC-сетях он может повлиять на целостность данных на СХД.

Кроме того, производительность сети хранения зависит от согласованной работы всех ее соединений и маршрутов. Если один из участков работает медленнее остальных, это может снизить производительность всей системы. Контроль состояния линков помогает вовремя обнаружить такие проблемы и определить участок инфраструктуры, требующий внимания.

FC и Ethernet в одной системе учета
На физическом уровне кабели и часть инфраструктуры FC и Ethernet могут выглядеть одинаково, но сами соединения различаются: для них используются разные трансиверы, настройки портов, параметры ОС и конечного оборудования. При учете инфраструктуры важно фиксировать не только сам факт соединения, но и его тип.

В DCImanager теперь можно просмотреть эту информацию, точнее планировать необходимые расходные материалы и учитывать особенности подключения при масштабировании сети.

Fibre Channel: прозрачность для команд и стандарт сетей хранения
В крупных инфраструктурах за сетевую часть и системы хранения часто отвечают разные команды. Сетевые администраторы работают со своими системами учета и IPAM, а специалисты по СХД — с отдельными инструментами управления фабриками Fibre Channel. При проблемах со связностью бывает сложно быстро определить зону ответственности и выявить участок с неисправностью.

DCImanager объединяет эту информацию в одном окне. Пользователь видит серверы, СХД, FC-коммутаторы и связи между ними, а также контролирует состояние соединений. Это упрощает диагностику, помогает быстрее определить границы проблемы и дает целостное представление об инфраструктуре.

Новая возможность также дополняет работу модуля СХД. Системы хранения не работают изолированно от сети, а Fibre Channel — один из основных протоколов для построения сетей хранения. Теперь связи между серверами и СХД можно учитывать и контролировать не только для Ethernet, но и для FC-инфраструктуры.

Подробнее о настройке FC-коммутаторов и работе с ними читайте в документации DCImanager.
www.ispsystem.ru/docs/dcimanager-admin/oborudovanie/kommutatory/nastrojka-kommutatora-v2026081
www.ispsystem.ru/dcimanager

CorePanel — безопасная и современная панель управления веб-хостингом


www.corepanel.net/pricing

Мы — Pyxsoft. Возможно, вы не знаете это название, но если вы когда-либо арендовали сервер cPanel у провайдера, использующего pxShield, то наш WAF (брандмауэр веб-приложений) находится перед вашим Apache с 2020 года.
Нам надоело возиться с панелью управления при отправке продукции, поэтому мы написали свою собственную.

CorePanel — это панель управления хостингом для RHEL 8/9/10, AlmaLinux и Rocky

Установка:
На новом сервере от имени root:
curl -fsSL https://get.corepanel.net/install.sh | bash


Демонстрация в реальном времени: demo.corepanel.net
Сайт: www.corepanel.net
Документация: www.corepanel.net/docs

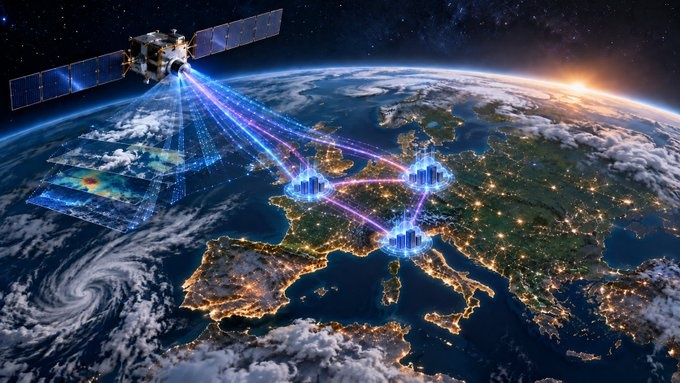
OVHcloud и CGI разрабатывают для Европейского космического агентства (ESA) «Digital EO

OVHcloud и CGI разрабатывают для Европейского космического агентства (ESA) «Digital EO»: систему информации по наблюдению Земли ESA — стратегическую и суверенную цифровую инфраструктуру, предназначенную для объединения данных, услуг и вычислительных возможностей, связанных с наблюдением за Землёй.

Цель — упростить использование >500 ПБ спутниковых изображений, увеличить количество применений, создать новые потребности и, таким образом, создать новую экономику, связанную с данными спутниковой съёмки.

Почасовой биллинг


Мы запускаем почасовой биллинг для облачных сервисов – и теперь минимальный шаг тарификации составляет один час вместо суток, что делает расчет стоимости точнее и позволяет оплачивать ресурсы по времени их использования.

Обратите внимание!
Стоимость услуг Beget остается прежней, меняется лишь формат оплаты – таким образом, вы можете гибче управлять инфраструктурой и эффективнее решать текущие задачи, оплачивая ресурсы почасово.

Почасовой биллинг позволяет:
  • запускать временную инфраструктуру для CI/CD, нагрузочного тестирования и пиков трафика;
  • проверять продуктовые гипотезы и создавать окружения для демонстрации прототипов;
  • обрабатывать разовые массивы данных и выполнять другие краткосрочные задачи.
При этом в работе сервисов всё остается по-прежнему – их можно создавать, настраивать и использовать так же, как раньше, меняется только принцип расчета стоимости.

Как работает почасовой биллинг
  • минимальная единица тарификации – один час, списания моментально отражаются на остатке баланса;
  • для расчета стоимости за сутки мы, как и ранее, используем 24 часа, за месяц – 30 дней,
поэтому стоимость календарного месяца может отличаться в зависимости от его продолжительности.
Также в соответствии с тарифами в Beget стоимость некоторых ресурсов в пересчете на час может быть меньше одной копейки. Поэтому в интерфейсе мы показываем цену с округлением до копеек, а для списаний используем точное значение.

Правила округления зависят от периода:
  • за час – стоимость округляется в большую сторону до копейки: например, 0,20000001 руб. отображается как 0,21 руб. в час;
  • за день – сначала используем точную стоимость часа и умножаем ее на 24, а затем округляем результат до копеек: например, 0,20000001 руб. × 24 = 4,80000024 руб. → 4,80 руб. в день;
  • за месяц – стоимость за день умножаем на 30 и также округляем результат до копеек: например, 4,80 руб. × 30 = 144 руб. в месяц.
То есть, к примеру, стоимость 1 Гб диска для выключенного VPS составляет 0,006666667 руб. в час – для 30 Гб в интерфейсе отображается 0,21 руб. в час, 4,80 руб. в день и 144 руб. в месяц, а в расчетах сохраняется точная стоимость.

Для каких сервисов действует почасовой биллинг
Мы запускаем почасовой биллинг поэтапно – постепенно он становится доступен для таких сервисов:
  • VPS – почасовые виртуальные серверы, включая архивные;
  • публичные IPv4-адреса;
  • лицензии на панель управления ispmanager;
  • снапшоты облачных серверов;
  • образы облачных серверов.
До конца года почасовая тарификация будет использоваться во всех облачных продуктах.

beget.com

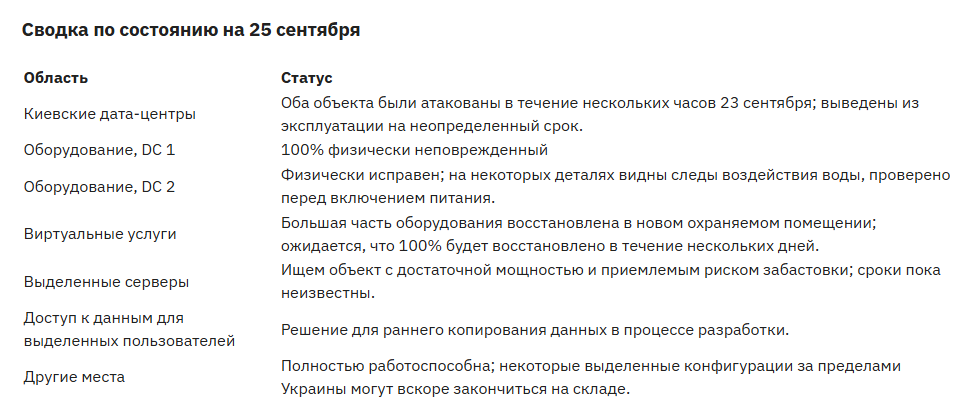
Два дата-центра в Киеве подверглись атакам с разницей в несколько часов: отчет об инциденте и статус восстановления.


23 сентября 2026 года оба дата-центра в Киеве, где размещается инфраструктура VSYS Host, подверглись ракетным ударам со стороны России с разницей в несколько часов. В этом отчете описывается произошедшее, обнаруженные на месте происшествия объекты, уже восстановленные работы и те, которые еще ведутся.

Что случилось
Наша киевская инфраструктура была намеренно разделена между двумя независимыми центрами обработки данных. Цель заключалась в снижении риска того, что отказ одного объекта приведет к полной остановке работы всей системы.

23 сентября первый ракетный удар России пришелся по одному из центров обработки данных. Через несколько часов был поражен второй центр обработки данных, а затем еще один. Оба центра обработки данных выведены из строя на неопределенный срок.

Это были не единичные случаи. Удары затронули и другие центры обработки данных, где у VSYS Host нет оборудования. Это была более масштабная российская атака на инфраструктуру центров обработки данных.

С первого часа команда работала над тремя приоритетными задачами: обеспечение бесперебойной работы компании, получение физического доступа к оборудованию и восстановление обслуживания клиентов везде, где это технически возможно.

Состояние оборудования
На первом этапе инцидента у нас не было физического доступа к нашему оборудованию. Мы получали обновления от команд дата-центра, но не могли самостоятельно проверить состояние отдельных серверов.

Как только наши инженеры прибыли на места, картина стала ясна:
  • Центр обработки данных 1: 100% нашего оборудования физически исправно.
  • Центр обработки данных 2: наше оборудование также уцелело и физически цело, но на некоторых элементах оборудования видны следы воздействия воды.
Оборудование, которое могло подвергнуться воздействию воды, нельзя просто включить. Каждое устройство необходимо сначала осмотреть и бережно с ним обращаться, иначе мы рискуем превратить восстанавливаемое оборудование в поврежденное. Поэтому восстановление происходит поэтапно, сервер за сервером, в зависимости от состояния каждой машины.

Виртуальные услуги: большинство из них уже возобновили работу в онлайн-режиме.
Вместо того чтобы ждать возобновления работы первоначальных центров обработки данных, мы перенесли виртуальную инфраструктуру в другой центр обработки данных, выбранный специально с учетом его уровня безопасности.

По состоянию на 25 сентября большинство затронутых виртуальных сервисов уже работают в новом помещении.

Мы не разглашаем его местоположение. Даже большинство сотрудников VSYS Host не знают адреса; доступ к этой информации ограничен небольшой группой, непосредственно занимающейся развертыванием и эксплуатацией инфраструктуры в этом месте. Это преднамеренная мера для защиты нового объекта, и мы уверены, что он не несет в себе того же риска атаки, что и затронутые объекты.

Работа над оставшимися системами продолжается, в том числе:
  • VPS
  • стриминговые сервисы
  • хранилище
  • хостинг
  • другие виртуальные сервисы
Исходя из текущего прогресса, мы ожидаем, что 100% затронутых виртуальных сервисов будут восстановлены в течение следующих нескольких дней.

Выделенные серверы: почему это занимает больше времени
Выделенные серверы представляют собой принципиально иную проблему. Виртуальные сервисы можно переразвернуть на новом оборудовании. Выделенные серверы — это и есть оборудование, поэтому их необходимо физически переместить в другое помещение, прежде чем они смогут снова работать.

Речь идёт об очень большом флоте.

Для того чтобы найти для него новое место, требуется гораздо больше, чем просто свободное место в стеллажах. Предприятию необходимо достаточное количество:
  • физическое пространство
  • мощность емкость
  • охлаждение
  • сетевое подключение
  • оперативный персонал и ресурсы
Кроме того, после потери двух объектов за один день у нас появилось еще одно требование: новое местоположение не должно представлять неприемлемого риска ракетного удара. Мы не будем перемещать большой объем клиентской инфраструктуры на первый попавшийся объект, где окажется свободное место.

На сегодняшний день мы не нашли учреждение, отвечающее всем этим требованиям. Поиски продолжаются.

Именно поэтому в настоящее время нет точной даты восстановления выделенных серверов. Любая оценка, данная до подтверждения наличия сервера, будет ненадежной, и мы предпочитаем не сообщать клиентам дату, за которую не можем ручаться.

Как только будет найдено подходящее помещение, переезд начнётся немедленно. Из-за большого количества оборудования серверы будут возвращаться постепенно и по порядку, а не все сразу. Затронутые клиенты будут проинформированы по мере выполнения каждого этапа.

Доступ к данным до полного восстановления
Многим клиентам нужны их данные прямо сейчас, а не после полного восстановления работы сервера. Параллельно с поиском подходящего помещения наши инженеры работают над тем, чтобы клиенты могли копировать данные со своих выделенных серверов до полного восстановления.

Техническая возможность будет зависеть от состояния и конфигурации каждого сервера, поэтому универсальной процедуры пока нет. Как только будет готов работоспособный процесс, мы напрямую свяжемся с затронутыми клиентами.

VSYS Host продолжает работать.
Компания работает в полном объеме. Команда работает, поддержка доступна, услуги в других наших офисах функционируют в обычном режиме, и мы продолжаем развертывание новой инфраструктуры.

Мы наблюдаем резкое увеличение запросов на перенос сервисов в наши центры за пределами Украины, и мы помогаем клиентам перенести их туда, где позволяют мощности. В связи с этим спросом некоторые конфигурации выделенных серверов за пределами Украины вскоре могут временно отсутствовать на складе.

Если вы планируете миграцию, свяжитесь с нашей командой, чтобы уточнить наличие свободных мест и варианты миграции.


Спасибо
Мы понимаем, насколько важны эти услуги для наших клиентов и насколько неприятны их недоступности. Команда работает круглосуточно, чтобы как можно быстрее восстановить инфраструктуру, не пренебрегая при этом вопросами безопасности.

Благодарим вас за терпение, доверие и поддержку в эти дни. Самая сложная часть, выделенные серверы, еще впереди. Мы будем и дальше открыто сообщать о ходе работ и делиться обновлениями по мере поступления новой информации.

Команда хоста VSYS
vsys.host/news/two-kyiv-data-centers-hit-within-hours-incident-report-and-recovery-status