Коротко итоги за год:
- Пустили ИИ в прод.
- Уволили отдел продаж.
- Чуть не положили дата‑центр.
- Ещё раз пустили ИИ в прод.
Сейчас ещё один раунд халявы на 4000 рублей в облаке для новых пользователей.
Примерно год назад мы опубликовали статью о том, что запускаем последнее коммерческое облако в РФ. Тогда мы честно рассказывали про наши амбиции, про ненависть к медленному корпоративному подходу и так далее.
А потом на год пропали. Вышли из беты и пропали.
Нас сгубили корпоративные заказы. Они оказались намного более жирными, чем коммерческое облако. И ещё их стало ОЧЕНЬ МНОГО.
Самый простой ответ на вопрос, почему мы ничего не писали: нам было тупо некогда.
Но облако тоже развивалось. За этот год мы прошли путь от стартапа до нормального IaaS‑провайдера.
Официальный старт состоялся 26 декабря 2025, под самый Новый Год. И пока вся страна просыпалась и лечила похмелье, я сидел и отвечал на тикеты в саппорт. Я смотрел в монитор и думал: «Кто вообще эти люди, которые 1 января лезут настраивать виртуалки и писать в поддержку?»
Январь
В январе мы знали, что просто не будет, потому что люди сталкиваются с облаком, и там для них всё новое и непонятное. А справки, которая идеально всё покрывает, ещё нет. Поэтому приходилось сразу писать справку, допиливать интерфейсы, выносить функции с бека в UI‑панель и так далее.
Тикеты были самые разные: от тривиального «ой, я, кажется, криво загрузил SSH‑ключ, проверьте» и «почему у меня нет денег на балансе» до жёсткого траблшутинга на стадии загрузки ОС через консоль и расследования вторжений в машины.
Почти 100% L2-саппорта я тогда закрывал один, просто потому что доступ к боевым серверам был только у меня. Напомню, у нас команда — 10 человек. Мы с тех пор выросли до мегакорпорации в 20 человек, кстати.
В бете нам прощали мелкие даунтаймы, но в проде ставки выросли. Отвлекаться на написание статей в таком режиме ежедневного тушения пожаров было физически невозможно.
Февраль: пошли крупные факапы
У нас было два по‑настоящему массовых инцидента, которые затронули больше одного тенанта (клиента).
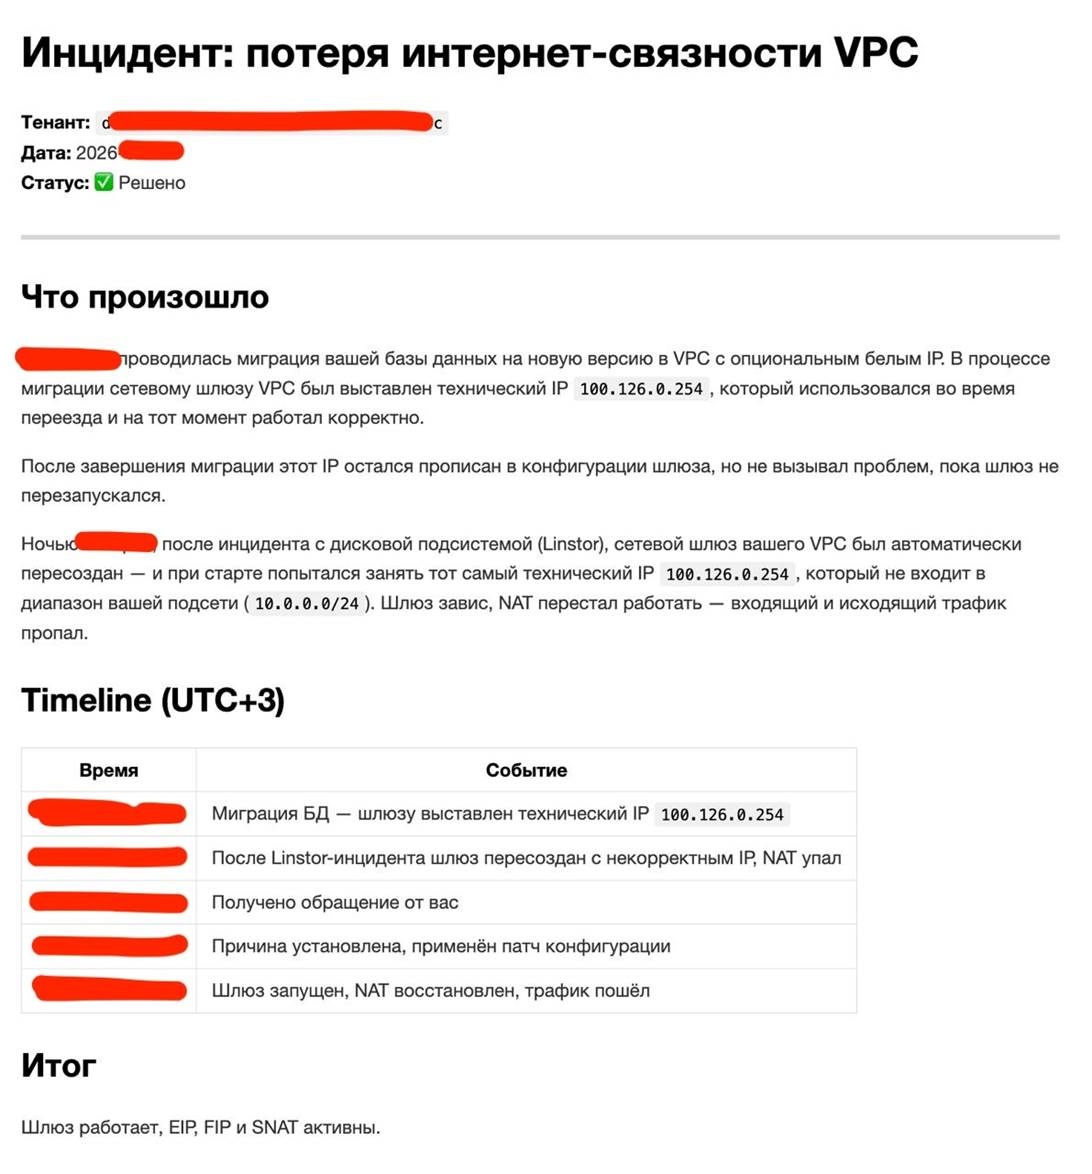
Инцидент первый. Изначально наши Managed БД жили в публичной сети — у каждой был белый IP. Мы решили дать пользователям возможность прятать базы в изолированную приватную сеть. Со стороны кажется: ну поменяй ты IP, пропиши два Network Policy, делов‑то. Нам так в саппорт и писали: «Вы чё, два полиси настроить не можете?» Хотелось ответить: «Приезжай к нам в офис, подпишем NDA, покажешь на нашем проде, как ты это сделаешь».
Дело в том, что у нас под капотом не классический Kubernetes с простыми неймспейсами. За сеть отвечает суровый зверь — Kube‑OVN. Он изолирует тенантскую подсеть намертво. Трафик за её пределы не выходит вообще. Но базой данных управляет оператор, которому нужен доступ к подам БД для контроля жизненного цикла. Нам пришлось изящно и точечно выпускать наружу конкретную нагрузку, сохраняя абсолютную безопасность.
На бете мы бы, конечно, херанули бы иначе. Но тут уже не бета.
Мы сделали это архитектурно, но споткнулись на автоматизации. Скрипт миграции старых баз на новую архитектуру не учёл, что у нас исторически скопилось две версии созданных ресурсов. Версия 2 (более новая) смигрировала идеально. А вот десяток баз версии 1 сломался. Пользователи начали обрывать тикеты: «База недоступна, у меня там прод!» Пришлось всё бросать и ручками, индивидуально по каждому тенанту, править конфиги. Починили быстро, за пределы SLA в годовом измерении не вышли, но седых волос прибавилось.
Инцидент второй: AI‑кодеры и зацикленный IPAM. Мы запартнерились с одним курсом по AI‑кодингу. К нам на интенсив пришла толпа студентов, которым нужно было массово и одновременно разворачивать виртуалки. И тут наш любимый Kube‑OVN выкинул фокус: его счётчик в IPAM зациклился и перестал вовремя освобождать адреса.
Подсеть на 1000 адресов выжралась моментально. Студенты жмут кнопку создания машины, а им не хватает IP! Нам пришлось прямо в моменте, за полтора часа, склеивать четыре маленькие подсети (/24) в одну большую, анонсировать её, учить Kube‑OVN (который из коробки этого не умеет) маршрутизировать трафик в две разные публичные сети и писать скрипты‑костыли, чтобы новые юзеры падали только в новую подсеть.
Самое крутое в этой истории — тенантская изоляция. SLA не пострадал вообще, потому что ни одна из уже запущенных машин даже не моргнула.
Март: AI Ops и чем это закончилось
Пока я полгода сидел на первой линии поддержки, я методично превращал свой опыт в данные. Я скрупулёзно собирал каждый кейс в отдельный чат с Claude. У меня накопилось около 500 чатов с детальными постмортемами и десяток пошаговых ранбуков (инструкций по починке). В какой‑то момент стало ясно: пора это автоматизировать. Но пускать LLM в прод бесконтрольно — самоубийство.
 Правило 32x
. Недавно коллеги из энтерпрайза поделились математикой: успешно решённый ИИ‑агентом тикет стоит 10% от стоимости работы человека. А вот неуспешно решённый (когда ИИ галлюцинирует и ломает систему) обходится в 32 раза дороже, чем если бы туда изначально полез человек. Выгоднее вообще не пускать агента, чем пускать его без тормозов.
Поэтому мы создали строгий фильтр и собственный MCP‑сервер. Он дал агенту строгий набор инструментов и обогащённый контекст (RAG). Наш инструмент всеяден: через OpenRouter мы можем подключать и дорогую Claude Opus, и открытую Code Llama. При правильном контексте и жёстких ранбуках даже дешёвая модель решает задачи на уровне толкового мидла.
Как это работает сейчас:
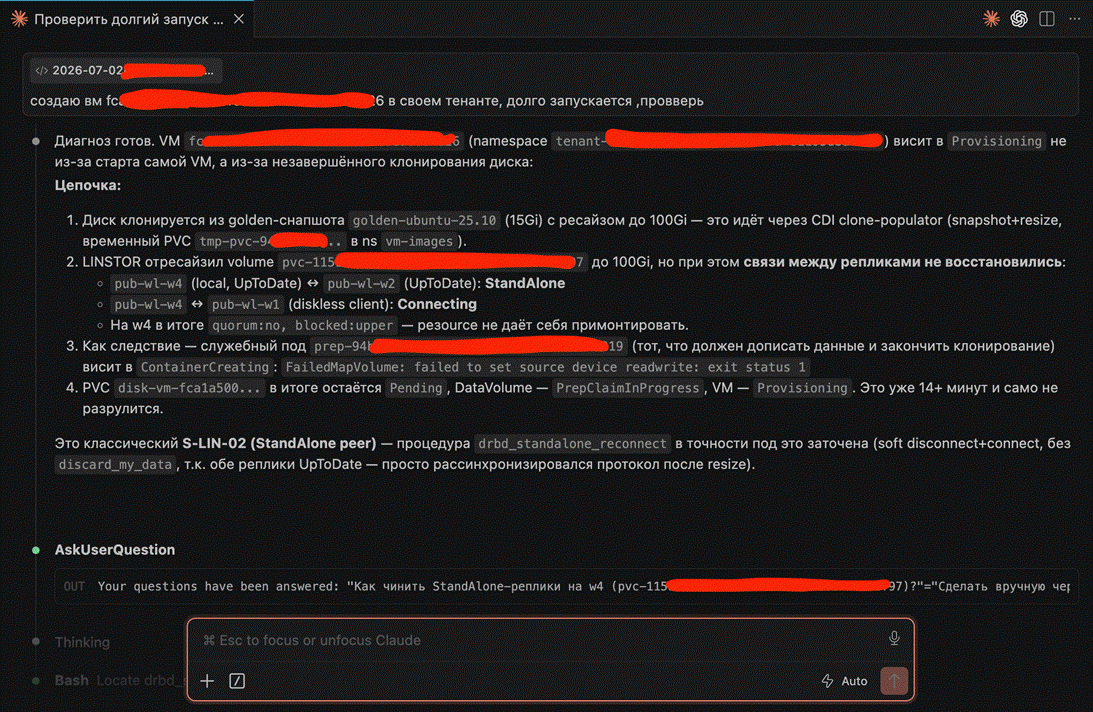
Автопилот: пользователь пишет, что его виртуалка недоступна. Раньше я тратил 30 минут: пинговал, лез в кластер, проверял сеть, логи, ключи. Сейчас агент делает это сам за 1,5 минуты и выдаёт мне саммари: «Снаружи доступно, внутри сеть жива, SSH отвечает, в консоли виден login prompt, проблема на стыке провайдера юзера и ТСПУ».
Привилегированные действия: если для решения проблемы нужно перезапустить под с новыми параметрами, агент проводит диагностику, находит нужный ранбук и выводит мне всплывающее окно: «Разрешаешь выполнить этот экшен?» Я жму «Да».
Сейчас агент съедает почти 55 миллионов токенов в месяц (в пересчёте по API это было бы около $1100, но в рамках подписки обходится в копейки). Этот «безустальный мидл» закрывает 80–90% рутины.
То есть как бы я есть, но мне надо только покивать на то, что выдумал агент в 90% случаев. Ещё в 2% случаев это нечто новое, и он там накосорезил, и это надо исправить, а стоит это х32, то есть получается 64% работы + 10% — 74%. То есть польза от внедрения агента — 26% экономии рабочего времени.
На деле я немного шучу, но не сильно. В следующие месяцы неопознанных ситуаций стало меньше, и там реально освободилось время.
Кстати, интересный инсайд: к нам пришёл человек из корпорации с 600 разработчиками. Так вот, они массово AI‑кодят, но тщательно скрывают это от руководства. Потому что в корп‑культуре за использование нейросетей могут наказать. Мы же, команда до 20 человек, благодаря легализованному AI‑кодингу обгоняем эту корпорацию по роадмапу на полтора года.
Продажи, корпораты и перебежчики
В прошлом году мы решили поиграть во взрослый B2B‑бизнес. Наняли крутого Head of Sales и коммерческого директора (на минуточку — бывшего коммерческого директора MTS Cloud). Ребята пришли со своей огромной записной книжкой, пошли по старым связям и вширь открыли шикарную воронку продаж в крупном энтерпрайзе.
А на выходе — ноль.
Я сейчас не про те ситуации, когда заказчик пришёл к нам за машзалом в аренду, поставил что‑то своё и крутит (такого, как я уже говорил, много). А именно про попытки поставить корпоратов в коммерческое облако.
Ни одной закрытой сделки.
Почему? Сработал жёсткий коктейль из стартапных реалий и корпоративной бюрократии. Корпоративные безопасники просто резали нас по формальному скорингу. Уставный капитал мы не раздували, а во всех базах светились с чистым убытком. Почему? Да потому что мы реинвестировали вообще всё и вливали бешеные деньги в закупку железа последнего поколения! Но для СБшника в пиджаке это выглядит как: «Э‑э, ребята, с этими не связываемся».
К концу года мы честно признали поражение на этом поле. Мы попрощались со всем отделом продаж и полностью сменили фокус. Наш B2B‑путь — это не прямые продажи, а партнерская модель через доверенных проводников (DevOps‑студии и системных интеграторов). Если DevOps‑студия, которая ведёт инфраструктуру клиента, скажет: «Съезжаем из Яндекса к этим ребятам», — клиент переедет.
А почему? Потому что мы бьём в главную боль гигантов — наплевательское отношение к клиентам. Один из клиентов, который сейчас рассматривает нас в качестве альтернативы, отгружает БигТех‑Облаку 6,5 миллионов рублей ежемесячно. И в поддержке он для них — никто. Его тикеты просто падают в бэклог. Хочется, чтобы на них реагировали? Ещё 1,5 миллиона в месяц, пожалуйста.
Проблема в том, что у того же Яндекса жесточайший вендор‑лок. Просто откройте их документацию в разделе «Как перенести данные своей виртуальной машины». Там бесконечная простыня текста и целая последовательность шагов с бубном: вот тут постучи, тут попляши, тут за ухом почеши — и так для каждой виртуалки.
Поэтому прямо сейчас мы дописываем автоматизацию этого процесса миграции. В том числе автоматизацию бубна. Мы хотим сделать так, чтобы вытащить инфраструктуру клиента из клетки вендор‑лока корпораций можно было без боли. С VMware, кстати, тоже помогаем соскочить.
Воронка открылась шикарная. На выходе — уже не ноль закрытых сделок )
Ещё халява
Наша старая механика «закинь 5000 рублей и получи год ресурсов» отлично отсекала ботов. Основная проблема была именно с триал‑хантерами, когда пробовали чуть ли не майнить.
Но там надо было доставать и показывать 5000 рублей на баланс (и их можно было потом вернуть в любой момент). Это как капча: показать 5000 рублей робот не может.
На vc.ru уже есть пост от одного обиженного юзера, который возмущался, что мы попросили паспортные данные, чтобы оформить ему возврат аж 6 рублей с баланса. Он там путает тёплое с мягким, мы попросили паспорт, чтобы перевести ему сумму с баланса обратно (все 5к), а не для отмены списания на 6 рублей (которые, конечно, отменили без вопросов). В общем, всё строго по правилам и вбелую.
Сейчас у нас другая механика — проще.
Теперь при регистрации мы даём бонусный демо‑баланс 4000 рублей на один месяц.
Аккаунт надо подтвердить: российский телефон, российская карта. Без этого, увы, по закону нельзя.
Что выкатываем прямо сейчас
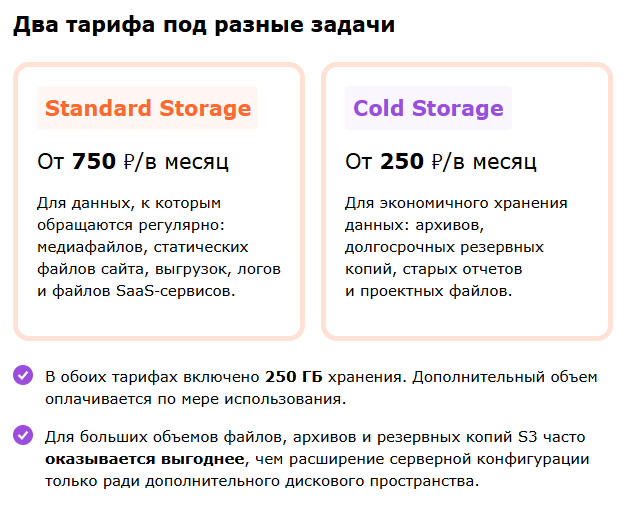
Наш базовый IaaS (виртуальные машины, VPC, быстрые диски, S3, балансировщики, Managed PostgreSQL) работает как часы. Managed Kubernetes тоже работает в полный рост — автоскейлинг вверх и вниз, автоапдейт, autoprovisioning PV и load balancer с белым IP. Плюс мы сейчас дотягиваем его до уровня оператора Capability Level 5 (полный автопилот).
Впереди жирные релизы:
- Serverless‑платформа (preview в конце сентября). Это Serverless Functions, Containers, очереди, Key‑Value БД и API Gateway. Главная фича: масштабирование до нуля. Пока нет запросов — контейнер схлопывается в 0 реплик, и вы не платите за простой. Логи, трейсы и метрики интегрированы из коробки.
- AI‑платформа (в октябре). Managed inference, GPU‑виртуалки, среда для обучения открытых моделей. Мы делаем свой AI Gateway, который по API на 100% совместим с OpenAI и Anthropic. Чтобы переехать к нам, вам достаточно поменять одну строчку с URL в вашем коде.
- AI Ops для Managed Kubernetes (октябрь). Тот самый MCP‑сервер, который мы отладили на своей поддержке, мы отдаём пользователям. Ваши SRE‑инженеры получат AI‑агента, который помогает чинить инциденты по вашим ранбукам.
- SDLC‑платформа (релиз к концу года). Знаете проблему, когда ИИ‑кодер нагенерил кода, уволился, и весь контекст архитектуры (C4, Gherkin) потерялся? Наша платформа хранит весь агентский контекст унифицированно. А ещё она решает новую болезнь индустрии: когда разрабов премируют за использование ИИ, они качают с Гитхаба скрипты, которые гоняют LLM по кругу, просто чтобы сжечь токены для KPI. Наша SDLC считает реальные DORA‑метрики и показывает экономику фичи, включая стоимость потраченных на неё токенов.
Почему мы не боимся спойлерить роадмап?
Резонный вопрос: вдруг Яндекс или Сбер прочитают и скопируют? Не боимся. Показательный пример: в 2022 году от MWS (MTS Cloud) ушёл вендор Canonical, оставив их OpenStack без поддержки. Ребята выбили 7,5 миллиардов рублей инвестиций, наняли 400 человек и пошли пилить облако. В итоге в сентябре прошлого года они выкатили то, что у нас работало ещё в мае. Чтобы нас догнать, конкурентам с их масштабом и текущими обязательствами нужно сначала набить наши шишки и влить миллиарды в инфраструктуру. Можно пробовать )
Почему мы так уверены в своих силах? Во‑первых, по чистой производительности мы обходим гигантов. У того же Яндекса база — это Xeon 2-го и 3-го поколения и память DDR4. У нас — 5-е поколение Xeon и DDR5. В бенчмарках мы быстрее в 2 раза в базе, в 5–7 раз на базах данных и до 10 раз в инференсе.
Про инференс и GPU в целом есть нюансы. Мы ждём поставку GPU‑установок топового уровня — целимся построить кластер в два раза больше Сберовского суперкомпьютера. Но сроки уехали до 20 недель, а поставщики в открытую говорят: «В Китае я продам каждую установку на $200 000 дороже, чем повезу вам в РФ». Цена улетела за миллион долларов за штуку. Притом что себестоимость её ниже 500 тысяч. Это новые реалии, которые рождаются спросом.
А ещё мы активно переселяемся в собственные ЦОДы: с нами по соседству живёт инфраструктура Cloud.ru, X5 и OZON, что делает объект очень лакомой мишенью. Глядя на то, что происходит вокруг, очень не хочется, чтобы нам прилетело «за компанию».
Так что мы вернулись, и мы поехали дальше.
h3llo.cloud