Рейтинг
0.00

Nebius Cloud

1 читатель, 40 топиков

Отказоустойчивое обучение: как мы создаем надежные кластеры для распределенных рабочих нагрузок ИИ


Начиная работу над проектом, вы ожидаете, что он будет выполняться без сбоев. Это ожидание справедливо во многих областях, но особенно остро оно ощущается инженерами машинного обучения, которые запускают масштабные проекты по предобучению. Поддержание стабильной среды обучения критически важно для достижения результатов в области ИИ в срок и в рамках бюджета.

За последние несколько месяцев в Nebius мы добились значительного прогресса в повышении надежности кластера, обеспечив отказоустойчивое обучение для всех наших клиентов. Эти улучшения привели к 169 800 часов работы графических процессоров или 56,6 часов стабильной работы для производственного кластера из 3000 графических процессоров, как записал один из наших клиентов.

Подписи, ведущая компания в области видеонаблюдения на основе ИИ, подчеркивает стабильность кластеров Nebius и показывает, насколько они важны для прогресса в разработке ИИ.
Благодаря Nebius наши долгосрочные задачи по обучению стали более предсказуемыми и эффективными. Повышение автоматизации обработки неисправностей и низкий уровень инцидентов позволили нам уделять больше времени отработке новых моделей, а не управлению инфраструктурой
Гаурав Мисра, соучредитель и генеральный директор Captions

В этой статье мы расскажем вам об основных концепциях и показателях, определяющих надежность кластеров ИИ, а также расскажем о методах, которые используют инженеры Nebius для обучения наших клиентов отказоустойчивости.

Проблема запуска учебных заданий на многоузловом кластере
Распределённое обучение ИИ подразумевает запуск модели на нескольких узлах, каждый из которых обрабатывает часть рабочей нагрузки и синхронизируется с остальными. Это ускоряет обучение, но и делает его более уязвимым. Если один узел выйдет из строя, это может прервать всю работу, сбрасывая ход обучения до последней контрольной точки и тратя драгоценное вычислительное время. В кластере из 1024 графических процессоров это означает, что 1023 исправных графических процессора будут простаивать, пока неисправный узел восстанавливается или заменяется.

С увеличением размера кластера пропорционально растёт риск сбоя. Каждый дополнительный узел усложняет аппаратное и программное обеспечение, что увеличивает вероятность возникновения сбоев.
Пересмотр надежности в крупномасштабных исследовательских кластерах машинного обучения
В статье этот факт наглядно проиллюстрирован. Метрика среднего времени до отказа (MTTF) для кластеров разных масштабов представлена ​​ниже:
  • На 1024 GPU время до полной готовности (MTTF) составляет 7,9 часов.
  • На 16 384 графических процессорах среднее время до отказа составляет 1,8 часа.
  • На 131 072 графических процессорах среднее время до полной готовности (MTTF) составляет 14 минут.

Причины перерывов в работе во время масштабного обучения
Как мы видим, перерывы в работе неизбежны. Более того, они ожидаемы в крупных учебных кластерах и могут возникнуть по следующим причинам:
  • Плановые события (обслуживание кластера или перезапуски, инициированные пользователем)
  • Незапланированные сбои инфраструктуры (оборудования, сетей, хранилищ)
  • Проблемы со стороны пользователя (ошибки обучающего кода, неправильные конфигурации)
  • Исследовательская работа Меты
  • обнаружили, что для 54-дневного задания по обучению на кластере из 16 000 графических процессоров около 78% непредвиденных прерываний задания были связаны с проблемами оборудования, тогда как на ошибки программного обеспечения пришлось всего лишь около 12,9% прерываний.
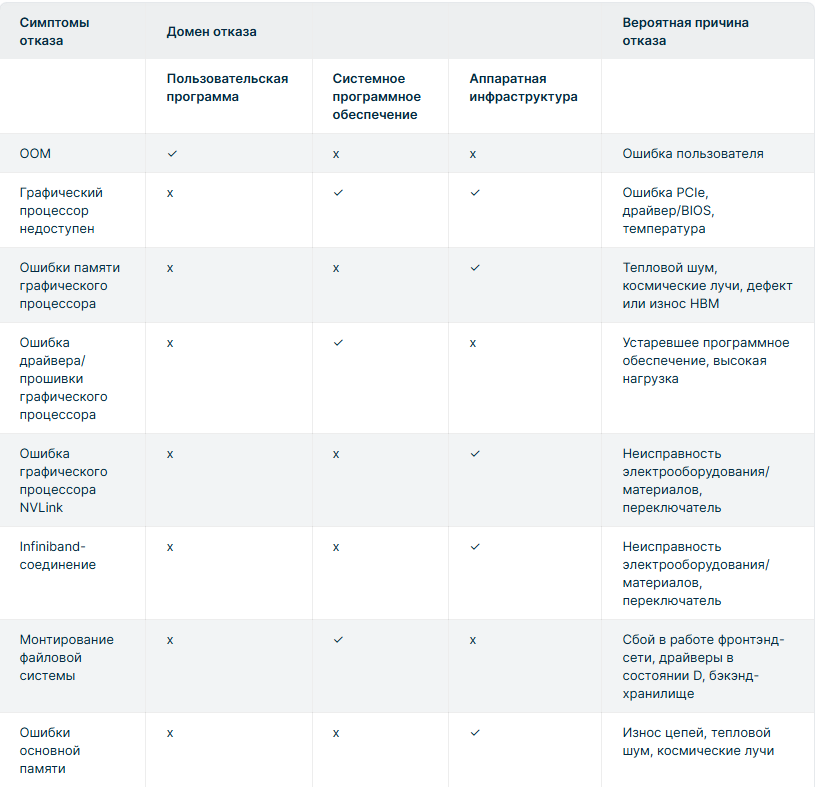
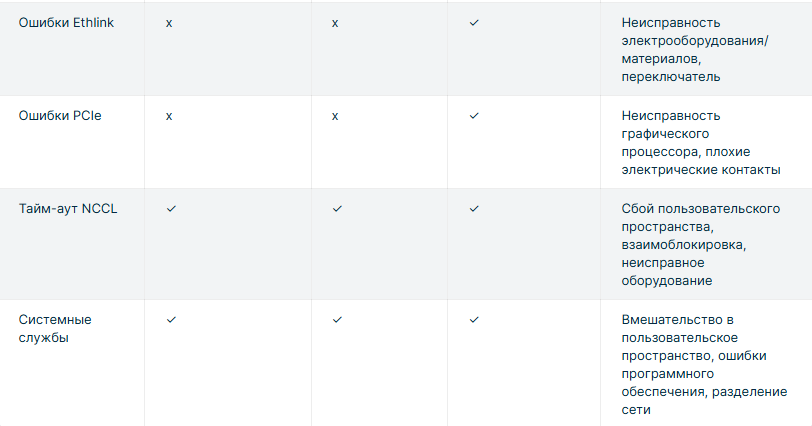
Наиболее распространенные отказы оборудования возникают из-запроблемы с внутренней сетью, проблемы с файловой системой и сбои в работе графического процессора, подчеркивая, что сбои на уровне инфраструктуры являются основной причиной прерывания учебного процесса. Кроме того, именно эти компоненты наименее заметны и контролируемы пользователями.


В то же время многие непредвиденные сбои на уровне инфраструктуры могут оставаться неясными для операторов кластера и не могут быть однозначно отнесены к их причине, что препятствует эффективному устранению неполадок. Поэтому критически важными становятся детальное наблюдение и проактивный мониторинг работоспособности.

Важность отслеживания фактического использования графического процессора
При крупномасштабном обучении машинного обучения использование графических процессоров не обязательно означает, что они способствуют реальному прогрессу разработки модели. Кластер может казаться загруженным, пока задания перезапускаются, находятся в очередях или восстанавливаются после сбоев. Перерывы в выполнении заданий увеличивают общее время обучения, добавляя дополнительное время ненужного использования ресурсов графических процессоров, когда эти вычислительные блоки простаивают для обучения модели.

Чтобы увидеть, насколько эффективно мы используем зарезервированное время графического процессора, мы можем отслеживать полезную производительность — отношение времени вычислений, потраченного на достижение фактического прогресса в задаче машинного обучения, к общему времени обучения.

Есть разные определения полезной производительности и несколько относительно близких терминов, описывающих использование вычислений кластера, такие как коэффициент эффективного времени обучения (ETTR) или использование FLOPs модели (MFU), которые мы не рассматриваем в этой статье.
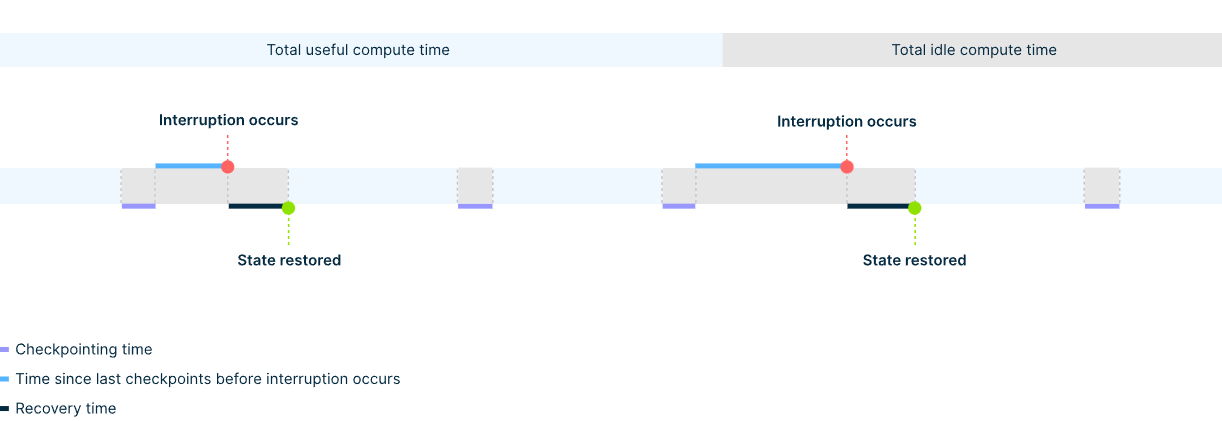

Если исключить из уравнения запланированную настройку кластера и время его обслуживания, то основным фактором, влияющим на показатель полезной производительности, будет время простоя вычислений, связанное с надежностью, вызванное прерываниями заданий и контрольными точками.

Согласно рисунку 1, мы можем рассчитать процент полезной производительности по следующей формуле:
Goodput = Useful compute time / (Useful compute time + Idle compute time)где Idle compute time

состоит из:
  • Время создания контрольной точки: процесс также занимает время и приводит к кратковременному прерыванию выполнения. Возможная потеря времени при использовании хранилища, оптимизированного для ИИ, может составить до одной минуты.
  • Потеря времени обучения с последней контрольной точки: каждая ошибка сводит на нет прогресс, достигнутый с момента последней контрольной точки. Возможная потеря до нескольких часов (в зависимости от частоты контрольных точек).
  • Время восстановления после сбоев: системе требуется время для обнаружения сбоя и запуска процесса восстановления, который включает замену узла, перезапуск задания и инициализацию модели. Потенциальные потери могут составлять от десятков минут до нескольких часов (в зависимости от уровня автоматизации).
Такой подход наглядно демонстрирует, как показатели надёжности могут влиять на эффективность инвестиций в инфраструктуру ИИ и рентабельность продуктов ИИ. Сокращение времени простоя кластера графических процессоров приводит к ускорению разработки моделей, сокращению времени вывода продуктов на рынок и освобождению ресурсов кластера для дополнительных экспериментов.

Как мы измеряем надежность кластеров ИИ
В то время как метрика полезной производительности количественно оценивает влияние низкой надежности кластера на бизнес, другие ключевые метрики предоставляют инженерам полезную информацию для повышения надежности инфраструктуры ИИ: среднее время между отказами (MTBF), среднее время до отказа (MTTF) и среднее время восстановления (MTTR).
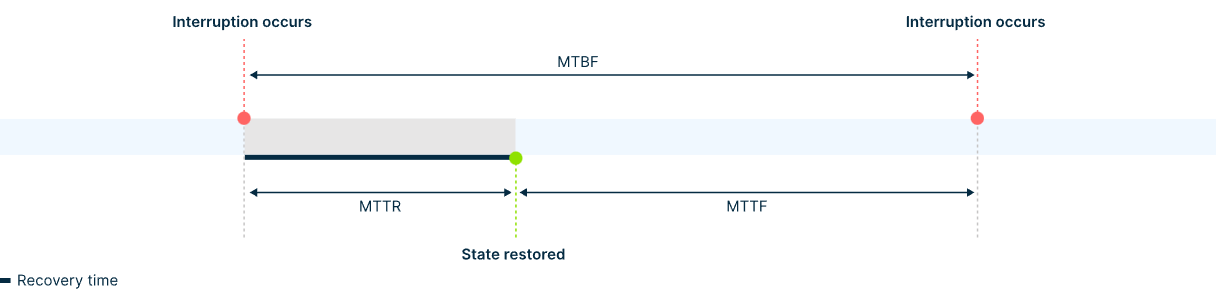
В Nebius мы уделяем особое внимание показателям MTBF и MTTR, чтобы отслеживать ход наших постоянных усилий по улучшению стабильности кластера.

MTBF: как часто происходят отказы
MTBF измеряет время работы кластера до возникновения сбоя. Мы выражаем его в часах работы графических процессоров (GPU) — общем времени безотказной работы всех графических процессоров кластера, делённом на количество сбоев, связанных с инфраструктурой (например, сбои GPU, ошибки PCIe, сбои сети).
Среднее время безотказной работы =Number of GPUs * Operational time / Number of infra failures


Например, кластер из 1024 графических процессоров, работающий в течение 336 часов с 13 сбоями инфраструктуры, даёт среднее время безотказной работы (MTBF) 26 446 графических процессоров-часов. Чтобы перевести эту метрику в обычные часы, нужно просто разделить значение на количество графических процессоров в кластере, что составляет около 25,8 часов.

Мы используем показатель MTBF для отслеживания стабильности нашей инфраструктуры. Рост MTBF указывает на повышение надежности компонентов, улучшение работы встроенного ПО или драйверов, а также на успешные стратегии профилактики (например, более разумное планирование задач или контроль работоспособности). И наоборот, снижение MTBF указывает на ухудшение качества обслуживания клиентов и надежности кластера.

Чем выше среднее время безотказной работы (MTBF), тем меньше перезапусков задания, меньше вычислительных ресурсов тратится впустую и тем более плавным становится жизненный цикл обучения ИИ.

MTTR: ​​Как быстро восстанавливается система
MTTR измеряет среднее время, необходимое для обнаружения, изоляции и устранения сбоев инфраструктуры, возвращая затронутый узел или сегмент кластера в работоспособное, планируемое состояние.
MTTR =Total resolution time / Number of infra failures

Общее время устранения неполадки включает все этапы по замене неисправного узла и предоставлению готового к использованию работоспособного узла: изоляция узла, предоставление запасного узла и повторное присоединение состояния (например, драйверов, среды, кластерной структуры).

Как мы обеспечиваем надежность кластеров ИИ в Nebius
Обеспечение надежности кластера ИИ — многоуровневая задача, требующая тесной координации инженерных усилий по всему комплексу инфраструктуры. В Nebius мы создаём вертикально интегрированное облако ИИ, обеспечивая оптимальную настройку и согласованность каждого компонента этого комплекса для обеспечения надёжности системы. Мы можем выделить пять основных компонентов с автоматизацией на каждом этапе, которые составляют наш подход к созданию предсказуемой и стабильной среды для крупномасштабного распределённого обучения.
  • Многоэтапные приемочные испытания
  • Пассивные и активные проверки здоровья
  • Изоляция и миграция рабочей нагрузки
  • Замена узла и восстановление состояния
  • Сквозное наблюдение и проактивные уведомления
Давайте подробнее рассмотрим каждый из этих методов обеспечения надежности.

Многоэтапные приемочные испытания
У нас есть уникальная возможность повысить надежность кластера уже на начальном этапе — путем проектирования серверных компонентов, разработки фирменных прошивок и осуществления тщательного контроля на площадке контрактного производства.

Заводские испытания на месте
Сначала тестирование начинается на заводе, сразу после сборки сервера. Мы тестируем производительность каждого серверного узла, гарантируя, что он покинет завод только в том случае, если все его компоненты, от системы охлаждения и блока питания до производительности графического процессора и NVMe, работают ожидаемым образом.
  • Термическая стабильность: gpu_burn стресс-тест
  • Power stress: импульсная нагрузка на графический процессор для проверки способности блока питания выдерживать пиковые нагрузки
  • Диагностика NVIDIA: DCGM -4 (8–12 часов с плагином EUD) и т. д.
  • Тесты производительности: ядра SuperBench, NCCL, HPL (LINPACK) и собственный обучающий тест LLM на основе JAX от Nebius
  • Фоновый мониторинг: dmesg, обнаружение перебоев в работе Ethernet/IB-соединения, журналы системных ошибок

Тесты развертывания узлов
После развёртывания оборудования на площадке дата-центра мы проводим следующий этап тестирования перед первой загрузкой узла или после его повторного развёртывания после устранения неполадок. Этот этап тестирования позволяет убедиться в стабильной работе узла перед его добавлением в кластерную сеть.
  • Диагностика DCGM: запустите dcgmi diag -4 с плагином EUD в 30-минутном цикле для проверки графического процессора, PCIe, питания и тепловой стабильности.
  • Фоновый мониторинг: отслеживание dmesg, счетчиков Ethernet/IB и стабильности соединения во время всех тестов.
  • Gpu_burn + NCCL p2pBandwidth: стрессовая проверка графических процессоров и проверка пропускной способности межсоединений
  • SuperBench: выполнение набора тестов производительности вычислений, памяти и связи (GEMM, gpu-copy, mem-bw, nccl-bw, вывод ORT/TensorRT и т. д.)
  • Тест Nebius LLM: запуск обучения MoE на базе JAX для проверки готовности к сквозной рабочей нагрузке
  • Диагностика партнеров (NVIDIA Field Diagnostics): расширенная диагностика графического процессора NVIDIA

Тесты виртуальной платформы
Мы проводим диагностические тесты на уровне виртуализации для образов виртуальных машин, узлов и кластерной структуры, гарантируя надежную работу облачной среды при интенсивных рабочих нагрузках.
Пассивные проверки
  • Работоспособность экземпляра/формы: проверка состояния виртуальной машины, типа платформы (H100/H200/L40S/B200), количества графических процессоров, настроек InfiniBand, IP-адреса SSH.
  • Конфигурация Virt/PCIe: проверьте MaxReadReq, устройство pvpanic, настройки PCIe
  • Состояние графического процессора NVIDIA: подтверждение количества графических процессоров, режима ECC, версии VBIOS
  • Состояние структуры: проверка топологии NVLink/PCIe, обнаружение DCGM
  • Работоспособность InfiniBand: обеспечение правильного количества устройств CX7, активных портов, согласованности прошивки и ключей pkeys.
  • Проводка для наблюдения: проверка токена IAM, плотности метрик, сбор журналов агента
Активные проверки
  • Диагностика DCGMI (уровень 2): 11-минутный стресс-тест GPU, PCIe, NVLink
  • Примеры CUDA: deviceQuery, vectorAdd, multiGPU, P2P, тесты пропускной способности
  • Пропускная способность копирования SuperBench: проверка пропускной способности графического процессора ↔ центрального процессора в сравнении с пороговыми значениями
  • OSU MPI: проверка работоспособности osu_hello / osu_init
  • NCCL all-reduce: коллективная проверка пропускной способности внутри хоста GPU
  • Кольцо NCCL через InfiniBand: проверка транспорта InfiniBand с помощью кольцевого алгоритма

Предварительные кластерные тесты
Наконец, мы запускаем несколько проверок и тестов, аналогичных производственным (например, тесты NVIDIA DGX), чтобы убедиться, что кластер соответствует всем целевым показателям производительности и полностью стабилен для распределенных рабочих нагрузок ИИ.
  • Коллективы NCCL: проверка работоспособности сети InfiniBand, обнаружение неисправных или ухудшенных соединений
  • Обучение MLPerf: оценка распределенных учебных рабочих нагрузок для производительности графических процессоров и межсоединений
  • Тесты NVIDIA DGX: сравните производительность кластера со стандартными для отрасли рабочими нагрузками
  • GPU Fryer: проверка графических процессоров на стрессоустойчивость для обнаружения аномального теплового дросселирования или ухудшения характеристик
  • HPL (LINPACK): сильно нагружает графические процессоры; чувствителен к потере пакетов и нестабильности соединений
  • InfiniBand Ring / All-to-All (без NVLink): проверка стабильности соединения InfiniBand при коллективной связи
  • ClusterKit: запустите NVIDIA IB bring-up suite для проверки пропускной способности и задержки.
  • Проверки топологии InfiniBand: проверка соединений «ядро-позвоночник-лист» и назначений рельсов через API UFM; без расхождений
  • HPL на группах хостов: запуск на подмножествах из 8, 16 и 32 узлов; требуется отклонение производительности <1%
  • NCCL в группах хостов: то же, что и выше, тестирование коллективов на узлах POD/Core
  • Длительная диагностика DCGM: запуск расширенных 8–12-часовых стресс-тестов графического процессора с плагином EUD для всех POD; все должны пройти успешно
  • Gpu_burn: проверка термостабильности на уровне стойки; перегрев не допускается
  • Импульсный тест графического процессора: подайте одновременную импульсную нагрузку на узел/стойку; блок питания должен выдерживать пиковую мощность

Только после успешного прохождения всех этих испытаний мы выпускаем оборудование в эксплуатацию. Эти первоначальные инвестиции помогают нам предотвращать сбои, увеличивая среднее время безотказной работы и обеспечивая стабильную производительность с первого дня.

Пассивные и активные проверки здоровья
При запуске кластера первым шагом для обеспечения его надёжности является как можно более раннее выявление проблемы. Для этого мы проводим комплексные проверки работоспособности. Они помогают нам определить, какие узлы кластера недостаточно работоспособны для планирования задач и постановки их в очередь.

Почему это важно?
Выявление проблем: благодаря комплексным проверкам работоспособности системы, как правило, достаточно всего нескольких секунд, чтобы выявить проблемы и минимизировать сбои в работе. Для сравнения, без проверок работоспособности системы проблемы можно выявить только в случае сбоя работы под нагрузкой.

Определение первопричины: при правильной настройке проверки работоспособности причины проблем отображаются мгновенно, что помогает выявить их и устранить. Без проверки работоспособности определение причины сбоев узлов может быть сложной задачей и потребовать многочасового исследования.

Мы разработали набор пассивных и активных проверок работоспособности, которые непрерывно работают в фоновом режиме и контролируют все критически важные компоненты системы: графические процессоры, системное программное обеспечение, сетевые соединения и многое другое.

Пассивные проверки здоровья
Пассивные проверки работоспособности непрерывно собирают, обобщают и анализируют данные в фоновом режиме. Они предназначены для раннего выявления признаков ухудшения работы или сбоя без ущерба для рабочих нагрузок. Ниже приведены некоторые примеры параметров, которые мы отслеживаем с помощью пассивных проверок работоспособности.
Аппаратное обеспечение и драйвер графического процессора
  • Согласованность версий драйверов и библиотек (CUDA, NCCL и т.д.)
  • Обнаружение ошибок ECC (код исправления ошибок)
  • Мониторинг температуры и оповещения о дросселировании
  • Мониторинг состояния электропитания и отслеживание использования
  • Отчеты об ошибках XID/SXID (коды исключений графического процессора)
  • Состояние шины PCIe и состояние питания
Сеть InfiniBand
  • Проверка статуса соединения (обнаружение работоспособности/неработоспособности)
  • Счетчики аппаратных ошибок (например, повторные попытки, CRC, потерянные пакеты)
Система и топология
  • Использование диска и доступная емкость
  • Топология NVLink: наличие, количество активных соединений, состояние пропускной способности
  • Отслеживание работоспособности коллективов NCCL (например, тайм-ауты, зависания)

Активные проверки здоровья
Активные проверки работоспособности выполняются во время определённых событий жизненного цикла кластера или в периоды простоя. Они заблаговременно выявляют неисправности до планирования заданий, помогая предотвратить перерывы в обучении и повысить общую надёжность.

Эта функция включена по умолчанию в кластерах на базе Soperator и доступна в режиме предварительного просмотра для управляемых сред Kubernetes по запросу.
  • DCGM diag 2, 3: Запуск диагностики графического процессора NVIDIA (быстрая в r2, расширенный стресс-тест в r3) для проверки состояния питания, памяти, PCIe и температуры, выявляя как общие, так и скрытые неисправности оборудования.
  • Производительность All-Reduce на одном узле (тест NCCL с NVLink): запускает NCCL All-Reduce на каждом узле для проверки высокопроизводительной связи между графическими процессорами с использованием NVLink.
  • Производительность All-Reduce с одним узлом (тест NCCL с Infiniband): выполняет тот же тест All-Reduce, принудительно использующий Infiniband вместо NVLink.
  • Производительность All-Reduce в многоузловой среде (тест NCCL с NVLink и Infiniband): выполняет распределенный тест All-Reduce, который проверяет связь NVLink между графическими процессорами в пределах одного узла и связь Infiniband в пределах разных узлов.
  • ib_write_bw / ib_write_lat (GPU Target): измеряет пропускную способность InfiniBand и задержку между графическими процессорами через RDMA для обеспечения оптимальной производительности межузловой сети GPU.
  • ib_write_bw / ib_write_lat (ЦП Целевой): Тестирует скорость InfiniBand из памяти ЦП для выявления узких мест или нестабильности сети, связанных с PCIe или сетевым адаптером.
  • GPU-fryer: подвергает стрессу вычисления и память графического процессора для обнаружения тепловой нестабильности, дросселирования или деградации кремния при полной нагрузке.
  • Проверка пропускной способности памяти (membw): измеряет пропускную способность памяти (GPU HBM или CPU DRAM) для проверки работоспособности подсистемы памяти и выявления неисправностей, ограничивающих пропускную способность.
  • Обучение модели МО: запускает небольшое распределенное задание по обучению, чтобы проверить, что графические процессоры, сетевые соединения, контейнеры и планирование работают сквозным образом, как в производственной среде.

Изоляция рабочей нагрузки и предотвращение сбоев в работе
После выявления проблемы следующим шагом является изоляция неисправного узла от доступности по расписанию и предотвращение каскадных сбоев заданий. Кроме того, нам необходимо минимизировать влияние на текущую рабочую нагрузку клиента, чтобы предотвратить сбои заданий. Ниже представлено описание нашего подхода.

Критические неисправности
  • Система автоматически отключает неработоспособные узлы, удаляя их из пула планирования, позволяя при возможности завершить текущие задания. Такой подход исключает каскадные сбои заданий, а отключённые узлы отключаются за считанные секунды без какого-либо ручного вмешательства, как и в случае неавтоматизированного потока.
  • Система отправляет сигнал «экстренной контрольной точки» в систему обучения клиента, побуждая её сохранить ход выполнения задания перед его завершением. Это может сэкономить часы обучения. Эта функция появится в ближайшее время.
  • При проблемах с сетевым подключением система перенаправляет соединение (например, AllReduce) затронутого узла через исправные каналы. Это может привести к временному снижению производительности, но предотвращает сбои заданий и потерю прогресса обучения. Эта функция появится в ближайшее время.

Некритические неисправности
Система помечает затронутый узел для упреждающего устранения неполадок, не влияя на текущие рабочие нагрузки.
«Мы экспериментируем с TorchFT, новая библиотека PyTorch, обеспечивающая отказоустойчивость на каждом этапе распределенного обучения. В отличие от традиционных схем, TorchFT позволяет продолжать обучение даже при отказе отдельных узлов или графических процессоров, избегая полного перезапуска задания. Несмотря на то, что TorchFT все еще находится в стадии развития, он демонстрирует высокий потенциал для крупномасштабного обучения LLM и рабочих нагрузок, требующих высокой отказоустойчивости.
Если вы заинтересованы во внедрении TorchFT, мы будем рады поддержать интеграцию и поделиться некоторыми идеями».

Замена узла и восстановление состояния
Когда неисправный узел выключается и переходит в режим ожидания, наши механизмы оркестровки автоматически заменяют его исправным резервным. Мы создаём выделенный резервный буфер графических процессоров для каждого клиента, чтобы обеспечить быстрое выделение ресурсов для нового узла и исключить риск его простоя из-за нехватки ресурсов. Новый узел автоматически появляется в кластере со всеми предустановленными драйверами и зависимостями, готовясь к работе сразу после выделения ресурсов.
Благодаря полной автоматизации в Nebius эта задача занимает считанные минуты.вместо часов с ручным вмешательством.

Сквозное наблюдение и проактивные уведомления
Важная составляющая надёжности — это наблюдаемость. Прозрачность инфраструктуры — ключ к отличному клиентскому опыту.

У нас есть различные уровни наблюдения: системные метрики, контроль работоспособности и т. д. Давайте рассмотрим стек контроля работоспособности для Soperator, нашего управляемого оркестратора на базе Slurm.
  • Мониторинг заданий: мы предоставляем обобщенную информацию о заданиях в кластере, что позволяет вам выбрать задание для детального изучения.
  • Мониторинг рабочих узлов: вы также можете просматривать агрегированную информацию и отдельные сведения по рабочим узлам. Здесь регистрируются все сбои инфраструктуры кластера с указанием причин (например, XID графического процессора, проблемы с IB и т. д.). Вы можете определить причины сбоя задания, а также проверить, устранены ли какие-либо проблемы кластера или продолжают ли они решаться.
  • Общее состояние кластера: содержит всю информацию, связанную с состоянием работоспособности графического процессора, центрального процессора и хранилища.

Кроме того, мы заблаговременно уведомляем клиентов о проблемах с кластерами, плановом техническом обслуживании и сбоях в работе, чтобы предотвратить скрытые сбои и потерю времени. У нас есть специальный канал Slack для интеграции с нашими клиентами для быстрого, эффективного и удобного общения. Клиенты могут настраивать уведомления о таких событиях, как:
  • Оповещения о прерываниях в режиме реального времени: мгновенные уведомления о сбоях или задержках учебных заданий. Выявлены критические проблемы со здоровьем, которые могут повлиять на рабочую нагрузку.
  • Обнаружение ухудшения производительности: выявляйте скрытые проблемы, связанные со снижением производительности, и уведомляйте о них. Эта функция появится в ближайшее время.
Без надлежащего контроля анализ сбоев в работе отнимает часы ценного рабочего времени инженера машинного обучения. Благодаря интегрированным панелям управления и уведомлениям в режиме реального времени мы сокращаем время устранения неполадок с нескольких часов до нескольких минут, обеспечивая мгновенное понимание первопричин сбоев.

Проверенная в боях надежность для производственных кластеров ИИ
Благодаря нашим уникальным стратегиям управления сбоями мы можем предоставить нашим клиентам надежную ИИ-инфраструктуру для крупномасштабных распределенных рабочих нагрузок, а также сократить потери времени и средств, связанные с перерывами в обучении.

Синтетические бенчмарки не могут полностью охватить поведение крупномасштабных кластеров ИИ под реальными рабочими нагрузками. Для получения более реалистичной картины мы также измеряем надёжность клиентских производственных сред, в которых проводится интенсивное распределённое обучение.

В начале статьи мы упомянули анонимного клиента, который запустил несколько заданий обучения LLM на кластере из 3000 графических процессоров (375 узлов). Эта система достигла пикового среднего времени безотказной работы (MTBF) 56,6 часа (169 800 часов работы GPU), при среднем показателе 33,0 часа за последние несколько недель. Хотя каждая учебная среда уникальна, и выводы об одном кластере нельзя напрямую применить к другому, мы видим, как надежность кластера приводит к уменьшению количества прерываний и уменьшению затрат, требуемых от команд машинного обучения при масштабном обучении.

Когда дело доходит до способности кластера восстанавливать свое состояние, мы достигаем среднего среднего времени восстановления (MTTR) 12 минут на большинстве наших установокЭтот впечатляющий результат стал возможен благодаря сквозной автоматизации процесса восстановления: от ранней диагностики неисправностей до развертывания заменяющих узлов без вмешательства человека.
Поскольку задачи обучения распределены по сотням графических процессоров, даже небольшие сбои могут сбить графики поставок. Стабильность, которую мы получаем от кластеров Nebius, позволяет нам планировать масштабные эксперименты без постоянной корректировки возможных сбоев
Дрю Джэгл, руководитель отдела искусственного интеллекта в Captions

Мы считаем, что представленные выше показатели надёжности говорят сами за себя, но создание устойчивой инфраструктуры ИИ — это гораздо больше, чем просто цифры. Это непрерывный процесс. Именно поэтому мы разрабатываем и постоянно совершенствуем целый комплекс механизмов для раннего обнаружения сбоев, быстрого восстановления и поддержания работы кластеров с минимальными перебоями — даже в сложных условиях масштабного и длительного обучения.

Наша цель — повысить производительность и помочь вам получить максимальную отдачу от инвестиций в инфраструктуру ИИ.Высокая доступность в любом масштабе сокращает незапланированные перерывы, сокращает циклы восстановления и позволяет командам сосредоточиться на выполнении своей работы, а не на управлении инцидентами.

Если вы ищете надежное облако, специально разработанное для крупномасштабного обучения искусственного интеллекта, или просто хотите узнать больше о нашей платформе, свяжитесь с нами

studio.nebius.com/playground
console.nebius.com
nebius.com
Представляем самообслуживаемые графические процессоры NVIDIA Blackwell в облаке Nebius AI Cloud


Экземпляры NVIDIA HGX B200 теперь доступны публично как самообслуживаемые ИИ-кластеры в облаке Nebius AI Cloud. Это означает, что любой может получить доступ к NVIDIA Blackwell — новейшему поколению платформы ускоренных вычислений NVIDIA — всего за несколько кликов и с помощью кредитной карты.
nebius.com/self-service

Nebius устраняет барьеры на пути к передовым вычислениям в области ИИ в рамках нашей стратегии демократизации ИИ. Никаких списков ожидания, долгосрочных обязательств, длительных циклов закупок или переговоров о продажах — только мгновенный доступ через нашу веб-консоль или API с оплатой по факту использования.

Получите доступ к новейшим вычислениям ИИ с помощью всего лишь кредитной карты
На выставке GTC в Париже мы объявили о том, что один из первых экземпляров GB200 NVL72 доступен для клиентов в Европе. Сегодня мы предоставляем экземпляры HGX B200 разработчикам ИИ любого масштаба через наш портал самообслуживания. Независимо от того, являетесь ли вы индивидуальным энтузиастом ИИ, инженером МО в крупной исследовательской группе или внедряете ИИ в корпоративном контексте, доступ к вычислениям NVIDIA B200 теперь стал проще, чем когда-либо.

Наш ранний доступ к NVIDIA HGX B200 через Nebius AI Cloud позволил нам достичь новых высот оптимизации вывода. Первые результаты показали многообещающее повышение производительности — примерно в 3,5 раза более быстрый вывод для диффузионных моделей, что критически важно для удовлетворения растущих потребностей индустрии ИИ
Кирилл Солодских, генеральный директор и соучредитель TheStage AI, платформы для ускорения вывода

Кластеры Nebius, созданные с использованием искусственного интеллекта
Мы поставляем экземпляры NVIDIA HGX B200 в составе Nebius AI Cloud — полнофункциональной ИИ-инфраструктуры, которую мы создали с нуля для интенсивных и масштабных рабочих нагрузок ИИ. Кластеры графических процессоров NVIDIA объединены неблокируемой инфраструктурой NVIDIA Quantum-2 InfiniBand и поставляются с предустановленными драйверами графического процессора и сети, а также программным обеспечением для оркестрации (Kubernetes или Slurm).

NVIDIA HGX B200 поставляется на одной материнской плате с восемью графическими процессорами (тот же форм-фактор, что и у предыдущих моделей Hopper SXM), что позволяет легко интегрировать HGX B200 в серверные стойки Nebius, разработанные по индивидуальному заказу.

Бескомпромиссная производительность
Независимо от того, является ли это средой с одним хостом по требованию или зарезервированной установкой с тысячей графических процессоров, все кластеры ИИ в Nebius проходят трехэтапное приемочное тестирование.

Мы осуществляем контроль качества на месте у контрактного производителя, проверяем узлы перед их развертыванием в наших дата-центрах, а затем проводим комплексное тестирование кластера перед передачей его клиентам. Это тщательное тестирование гарантирует соответствие производительности NVIDIA HGX B200 в Nebius собственным бенчмаркам NVIDIA.

Будущее ИИ уже здесь. Доступно каждому.
Независимо от того, являетесь ли вы индивидуальным исследователем или членом крупной корпоративной команды, вы получаете полностью протестированные и оптимизированные кластеры графических процессоров, индивидуально разработанную инфраструктуру и бескомпромиссную производительность, которая гарантирует, что ваши рабочие нагрузки ИИ будут выполняться именно так, как и ожидалось.

Будущее развития искусственного интеллекта уже наступило, и оно доступно по запросу.
Доступ к NVIDIA HGX B200
систем сегодня через нашу веб-консоль или API.
auth.nebius.com/ui/login

Новый вебинар с исследователем DeepMind


Присоединяйтесь к нам, чтобы исследовать пределы архитектуры LLM и увидеть, почему огромные трансформаторы могут справляться со сложными задачами, но по-прежнему испытывают трудности с простыми вычислениями.

27 августа в 19:00 по центральноевропейскому летнему времени (10:00 по тихоокеанскому времени) Nebius Academy проведет вебинар под руководством Ларисы Маркеевой, старшего инженера-исследователя и технического руководителя компании DeepMind.

Подключайтесь, чтобы узнать ключевые идеи из недавних рецензируемых статей, диагностирующих фундаментальные недостатки в программах магистратуры права и предлагающих потенциальные решения.

Мы рассмотрим:
  • Как вращательные позиционные вставки вызывают помехи в длинных контекстах.
  • «Узкое место авторегрессии» и информационный коллапс в стандартных вычислительных графах.
  • CLRS-Text — новый бенчмарк, который переводит классические алгоритмические задачи в текст для эффективной оценки рассуждений.
  • Это мероприятие идеально подходит для разработчиков, инженеров и исследователей, работающих с LLM, — особенно для тех, кому интересно узнать, как модели функционируют «под капотом».

nebius.zoom.us/webinar/register/WN_DFZTHpLZTU-evGy7cF0k1A

Nebius публикует финансовые результаты за второй квартал и повышает прогноз годовой доходности (ARR) на 2025 год


Полную информацию о раскрытии информации, включая основные финансовые показатели, можно найти здесь (PDF).
cdn.prod.website-files.com/66b32d86d735b995db912494/689482beac458b4b7e9d3209_20250807%20Nebius%20reports%202Q%202025%20financial%20results.pdf

Письмо основателя и генерального директора Аркадия Воложа акционерам можно прочитать здесь (PDF).
cdn.prod.website-files.com/66b32d86d735b995db912494/6894b55ac7e55462f2d2e03a_Nebius-SHL-Q2-2025.pdf

  • Прогнозируемая годовая норма прибыли (1) (ARR) увеличена до 900 млн долларов США, что составляет 1,1 млрд долларов США к концу 2025 года.
  • Выручка за второй квартал составила 105,1 млн долларов США, увеличившись на 625% в годовом исчислении и на 106% в квартальном исчислении.
  • Основной бизнес достиг положительного показателя скорректированной EBITDA, опережая план
  • В процессе обеспечения более 1 ГВт мощности к концу 2026 года
‍
Амстердам, 7 августа 2025 г. – Nebius Group NV (NASDAQ: NBIS), ведущая компания в области инфраструктуры искусственного интеллекта, сегодня объявила свои неаудированные финансовые результаты за второй квартал, закончившийся 30 июня 2025 г.

«Nebius продолжает демонстрировать исключительные результаты», — заявил основатель и генеральный директор Аркадий Волож. «Во втором квартале мы более чем удвоили выручку по сравнению с предыдущим кварталом, а наш основной бизнес достиг положительного показателя скорректированной EBITDA, превысив план. Благодаря этой сильной динамике мы увеличиваем прогноз годовой выручки (ARR) до 900 млн долларов США, что составляет 1,1 млрд долларов США».

Спрос на инфраструктуру ИИ — вычислительные мощности, программное обеспечение и услуги — будет только расти по мере увеличения числа вариантов использования. Мы активно наращиваем мощности, чтобы воспользоваться этой существенной возможностью, и к концу 2026 года планируем обеспечить более 1 ГВт мощности.

Сегодня компания Nebius также опубликовала ежеквартальное письмо Аркадия Воложа акционерам, с которым можно ознакомиться на сайте компании по связям с инвесторами по адресу group.nebius.com/investor-hub


‍

Изучите виброкодирование с помощью серии из 10 курсов


Мы рады сообщить, что наши курсы по кодированию вибраций и многому другому от JetBrains Academy теперь полностью доступны!

Мы начали делиться всем, что знаем о разработке программного обеспечения с использованием ИИ, и публиковать эти курсы ещё в апреле. С недавней загрузкой последнего курса Андрея Законова, теперь это комплексный набор из 10 уроков, охватывающий широкий спектр тем:
  • Станислав Федотов научит вас создавать собственного ИИ-агента
  • Роман Гаев рассказывает о методах подсказки
  • Оксана Павлова рассказала о юридических рисках, связанных с программированием с использованием ИИ
  • Клара Мейн рассказывает о программировании с помощью ИИ-помощника
  • Грэм Нойбиг рассказывает об агентах, разработанных специально для SWE
  • Дэниел Нотт знает всё об ИИ в обеспечении качества, так что вы тоже будете знать
  • Талекс Максим представляет введение в ИИ в DevOps
  • Андрей Законов рассказывает о создании агентских рабочих процессов и извлечении из них максимальной эффективности

В отчете Nebius Group об устойчивом развитии за 2024 год подчеркивается важность устойчивого развития для создания долгосрочной ценности в инфраструктуре ИИ


Nebius Group NV (NASDAQ: NBIS), ведущая компания в области инфраструктуры искусственного интеллекта, сегодня опубликовала свой отчет об устойчивом развитии за 2024 год, укрепив свои позиции лидера отрасли по прозрачности в вопросах устойчивого развития и подчеркнув, как устойчивое развитие приносит пользу Nebius, нашим клиентам и обществу в целом.

Отчет, подготовленный с учетом Европейских стандартов отчетности об устойчивом развитии (ESRS), демонстрирует, как Nebius рассматривает устойчивое развитие как ключевой элемент своей бизнес-стратегии. Это напрямую отражается в конкурентных преимуществах, включая лидерство в области операционных расходов за счет энергоэффективности, готовность к внедрению новых стандартов регулирования и конкурентоспособность на рынке, где все больше внимания уделяется устойчивому развитию.

Устойчивое развитие — это не что-то второстепенное, а неотъемлемая часть нашего бизнеса, направленного на обеспечение конкурентоспособности. Это стратегический подход, при котором каждое повышение эффективности, которое мы внедряем в нашу инфраструктуру, напрямую влияет на производительность. Экономя 10 ГВт⋅ч энергии за счёт оптимизации оборудования или достигая коэффициента полезного использования (PUE) 1,1 в наших центрах обработки данных, мы обеспечиваем превосходную экономическую эффективность, которая позволяет создавать долгосрочную ценность, одновременно снижая воздействие на окружающую среду
Джон Бойнтон, председатель Nebius

В отчёте об устойчивом развитии за 2024 год показано, как высокие показатели Nebius по ключевым показателям устойчивого развития напрямую влияют на бизнес-преимущества. Компания добилась снижения совокупной стоимости владения примерно на 20% благодаря повышению эффективности инфраструктуры, включая отказоустойчивую конструкцию оборудования и решения по энергоэффективности, а её серверы, разработанные по индивидуальному заказу, сэкономили 10 ГВт·ч энергии только в 2024 году по сравнению с готовыми решениями.

Флагманский дата-центр Nebius в Мянтсяля (Финляндия) демонстрирует подход компании к сочетанию высокой производительности с выдающейся эффективностью инфраструктуры, включая разработанное компанией оборудование, оптимизированное для терморегулирования, воздушного охлаждения без использования воды и хладагентов и утилизации серверного тепла. Инновационная система рекуперации тепла дата-центра покрывает 65% потребностей местного муниципалитета в отоплении, превращая то, что другие поставщики считают отходами, в ценный общественный ресурс.

Приверженность компании принципам низкоуглеродной деятельности отражается в её энергоснабжении: 94% потребляемой электроэнергии поступает из низкоуглеродных источников. Это обеспечивает рыночную интенсивность выбросов всего 0,04 тонны CO₂-эквивалента на 1 МВт·ч потребляемой энергии — один из самых низких показателей в технологическом секторе. Компания Nebius также переработала почти 100% своего списанного оборудования, что решает растущую проблему электронных отходов в условиях стремительного развития поколения графических процессоров.

Подробнее о комплексном подходе Nebius к устойчивому развитию, включая наш подход к устойчивым вычислениям, социальное воздействие посредством образовательных инициатив и то, как наша высокопроизводительная инфраструктура объединяет самые высокие стандарты безопасности и надежности, можно узнать в нашем Отчете об устойчивом развитии за 2024 год, доступном по адресу nebius.com/sustainability

‍

Nebius ускоряет развитие следующего поколения инноваций в здравоохранении и науках о жизни с помощью первой премии AI Discovery Awards


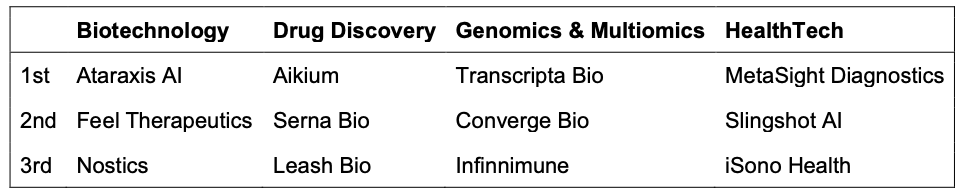
Компания Nebius (NASDAQ: NBIS) назвала победителей своей первой премии AI Discovery Awards, вручив главные призы в размере 100 000 долларов США в виде кредитов на графические процессоры каждой из четырех компаний, добившихся прорывов в области ИИ в области прогнозирования рака, таргетирования белков, транскриптомного картирования и точной диагностики.

Победители, выбранные из 257 заявок со всего мира комиссией из 19 независимых судей из ведущих биотехнологических, фармацевтических, исследовательских и венчурных организаций, представляют проверенные решения в области ИИ с четкими путями влияния на рынок:

Биотехнологии: Ataraxis AI – платформа прогнозирования лечения рака достигла точности на 30% выше, чем стандартные геномные тесты при клинической валидации с участием 7500 пациентов из 15 учреждений. Базовая модель Kestrel, обученная на сотнях миллионов патологических изображений, помогает онкологам определять необходимость агрессивных методов лечения, таких как химиотерапия.
www.ataraxis.ai/

Разработка лекарств: Aikium – разрабатывает «нелекарственные» белки, составляющие половину протеома человека, используя свою платформу Yotta-ML². Компания заключила партнёрские соглашения с четырьмя организациями, включая три ведущие онкологические больницы, благодаря успешной работе по проверке концепции GPCR.
www.aikium.com/

Геномика и мультиомика: Transcripta Bio – Создан транскриптомный атлас высокого разрешения, содержащий более миллиарда генных реакций, для моделирования ИИ, прогнозирующего биологические реакции на молекулы лекарств. Недавно мы сотрудничали с Microsoft Research для выявления новых ассоциаций между заболеваниями и генами.
www.transcriptabio.com/

HealthTech: MetaSight Diagnostics – пионер в области диагностики заболеваний в масштабах всего населения с помощью передовых методов анализа крови, создавший крупнейшую в мире базу данных молекул крови, основанную на данных более чем 500 000 участников израильского многопрофильного скринингового исследования (Multi-OMICS). Разработка продуктов для скрининга колоректального рака и метаболических заболеваний.
metasightdx.com/

Эти команды расширяют границы применения ИИ в здравоохранении и науках о жизни, предлагая достоверные научные данные и чёткие пути к выходу на рынок. Мы гордимся тем, что помогаем им превратить исследования в реальные результаты
заявил Аркадий Волож, основатель и генеральный директор Nebius

Премия Nebius AI Discovery Awards, проводимая впервые в этом году, объединяет перспективные компании, использующие ИИ в здравоохранении и науках о жизни, с вычислительной инфраструктурой и опытом, необходимыми для масштабирования их инноваций.

Победители в категориях получат 100 000 долларов США в виде кредитов на использование графических процессоров Nebius AI Cloud, а компании, занявшие второе и третье места, получат 50 000 и 30 000 долларов США соответственно, а также другие преимущества, включая наставничество и сетевую поддержку.

Ещё семь «почётных упоминаний» в каждой категории получили 5000 долларов США в виде облачных кредитов на GPU. Всем участникам премии AI Discovery Awards также были предоставлены кредиты на инференс для Nebius AI Studio.

Эти компании демонстрируют значительный прогресс в применении ИИ для решения самых сложных задач здравоохранения. От таргетирования ранее не поддающихся лечению белков до прогнозирования результатов лечения рака с беспрецедентной точностью — эти команды создают инструменты, которые напрямую повлияют на качество лечения и результаты лечения пациентов
заявил доктор Илья Бурков, руководитель отдела развития здравоохранения и биологических наук компании Nebius

Победители премии Nebius AI Discovery Awards 2025 года

‍
Премию AI Discovery Awards оценивали 19 независимых судей из ведущих фармацевтических, биотехнологических, исследовательских и медицинских организаций, включая AstraZeneca BioPharma, NVIDIA, Monte Rosa Therapeutics и Утрехтский университет.

Более подробную информацию о конкурсе Nebius AI Discovery Awards, включая список всех компаний, вошедших в шорт-лист в каждой категории, критерии квалификации и полный список жюри, можно найти на веб-сайте Nebius по адресу nebius.com/ai-discovery-award

О Небиусе
Nebius — технологическая компания, создающая полнофункциональную инфраструктуру для обслуживания бурно растущей глобальной индустрии искусственного интеллекта, включая крупномасштабные кластеры графических процессоров, облачную платформу для искусственного интеллекта, а также инструменты и сервисы для разработчиков. Компания со штаб-квартирой в Амстердаме, акции которой котируются на бирже Nasdaq, имеет глобальное присутствие с научно-исследовательскими центрами в Европе, Северной Америке и Израиле.

Облако ИИ Nebius создано с нуля для интенсивных задач ИИ. Благодаря собственному программному и аппаратному обеспечению, Nebius предоставляет разработчикам ИИ вычислительные ресурсы, хранилище, управляемые сервисы и инструменты, необходимые для создания, настройки и запуска моделей

Чтобы узнать больше, посетите nebius.com

Nebius и Saturn Cloud запускают первое в своем классе облако AI MLOps с поддержкой NVIDIA AI Enterprise


(NASDAQ: NBIS) сотрудничает с Saturn Cloud, платформой MLOps для инженеров искусственного интеллекта/машинного обучения, с целью предоставления готового решения для инфраструктуры искусственного интеллекта/машинного обучения на базе графических процессоров NVIDIA Hopper и с поддержкой программного стека NVIDIA AI Enterprise.

Решение объединяет мощь и гибкость облака ИИ Nebius с любимой инженерами платформой MLOps от Saturn Cloud. Оно позволяет любому человеку мгновенно зарегистрироваться для использования блокнотов Jupyter или других IDE, запускать задания и развертывания, а также управлять облачными ресурсами на графических процессорах NVIDIA Hopper через инфраструктуру Nebius. Услуга доступна по значительно более низкой цене, чем у традиционных поставщиков облачных услуг, что обеспечивает убедительное решение для всех типов вариантов использования.

Компании могут развернуть корпоративное приложение Saturn Cloud в виртуальной частной облачной среде Nebius, соответствующей корпоративным стандартам безопасности ИТ, а также получить доступ к мощным и экономичным графическим процессорам. Это дополнено корпоративными SLA, единым входом (SSO) и другими интеграциями безопасности ИТ, которые можно найти на соответствующих страницах документации компании.

Кроме того, отдельные лица и команды могут присоединиться к более чем 100 000 пользователей размещенных уровней Saturn Cloud, которые используют оборудование Nebius для мгновенной регистрации и развертывания облачных ресурсов. Просто предоставив кредитную карту, пользователи могут воспользоваться конкурентоспособными ценами на облако ИИ Nebius с полным набором цепочки инструментов MLOps Saturn Cloud.

В дополнение к конкурентоспособным ценам и полностью интегрированным MLOps, решение предлагает доступ к облаку Nebius AI Cloud, ускоренному NVIDIA. Команды могут использовать вычислительную мощность, управляющую самыми сложными сегодняшними системами AI, без долгосрочных инвестиций в ускоренные вычислительные системы. Резервирование мощностей также возможно и обеспечивает дополнительную экономию средств.

Сочетание инфраструктуры полного стека ИИ Nebius и платформы MLOps Saturn Cloud открывает доступ к возможностям ИИ корпоративного уровня для организаций любого размера. Nebius предлагает клиентам Saturn Cloud гибкий доступ к высокопроизводительному облаку, созданному для ИИ, с высоким уровнем надежности и экономической эффективности
сказал Данила Штан, технический директор Nebius

Вместе Nebius и Saturn Cloud позволяют организациям стать ориентированными на ИИ. Ранее ограниченные экономикой GPU или DevOps, наши клиенты могут создавать и запускать масштабируемые рабочие нагрузки ИИ с ускорением на GPU без значительных финансовых или инженерных инвестиций
сказал М. Себастьян Метти, генеральный директор Saturn Cloud

Помимо экономически эффективного доступа к мощным вычислительным ресурсам, это предложение расширяет платформу MLOps от Saturn Cloud за счет поддержки программного обеспечения NVIDIA AI Enterprise, включая микросервисы NVIDIA NIM, NVIDIA NeMo, NVIDIA RAPIDS и многое другое, работающее на высокопроизводительной инфраструктуре Nebius.

Совместное решение теперь доступно для клиентов по всему миру. Разработчики ИИ могут получить доступ к этим возможностям немедленно, зарегистрировавшись в Saturn Cloud Pro, и начать разработку на графических процессорах NVIDIA Hopper за считанные минуты. Корпоративные развертывания также доступны для команд, которые хотели бы использовать Saturn Cloud в своих учетных записях Nebius.

Nebius впервые обеспечивает общедоступность NVIDIA Blackwell в Европе; NVIDIA AI Enterprise переходит в Nebius AI Cloud


Амстердам, 11 июня 2025 г. – Сегодня компания Nebius (NASDAQ: NBIS) объявила о первой общедоступной мощности чипа NVIDIA GB200 Grace Blackwell Superchip для клиентов в Европе, продолжая наращивать комплексную инфраструктуру искусственного интеллекта по всему миру для ускорения масштабных инноваций в области искусственного интеллекта.

Аркадий Волож, основатель и генеральный директор Nebius, сказал:
Наша миссия — предоставить инфраструктуру, которая ускоряет инновации ИИ в Европе и во всем мире. Интегрируя ускоренные вычисления NVIDIA и программное обеспечение корпоративного уровня глубже в платформу Nebius AI Cloud, мы предоставляем европейским новаторам — будь то стартапы, предприятия, разработчики или исследователи — доступ к инструментам, необходимым им для создания, масштабирования и развертывания приложений ИИ следующего поколения

Сегодня Nebius также анонсировала другие интеграции с платформой ускоренных вычислений NVIDIA, включая расширение Nebius AI Cloud с помощью программного стека NVIDIA AI Enterprise; первый на рынке доступ к NVIDIA Blackwell через NVIDIA DGX Cloud Lepton; и первый в Европе доступ к графическим процессорам NVIDIA Hopper через платформу NVIDIA Brev. Позднее в этом году Nebius также предложит экземпляры с RTX PRO 6000 Blackwell Server Edition.

Nebius помогает вывести мощь фабрики ИИ на передний план европейской трансформации ИИ. Благодаря своей сильной направленности на производительность, масштабируемость и соответствие требованиям, Nebius позволяет новаторам во всех секторах разрабатывать и развертывать следующее поколение рассуждающего, агентного и физического ИИ быстрее и эффективнее
сказал Дэйв Сальватор, директор по ускоренным вычислительным продуктам в NVIDIA

Будучи одним из первых пользователей NVIDIA Blackwell, Nebius работала с исследовательской группой LMArena в сотрудничестве с NVIDIA, чтобы запустить в производство систему Prompt-to-Leaderboard (P2L) LMArena с использованием инфраструктуры GB200 NVL72. Обученная всего за четыре дня с помощью NVIDIA DGX Cloud на Nebius, P2L направляет запросы пользователей в реальном времени к наиболее точным и экономичным моделям, используя живую обратную связь для оптимизации производительности. Проект демонстрирует гибкость и масштабируемость инфраструктуры Nebius для инноваций ИИ с открытым исходным кодом.

Работа с Nebius и платформой NVIDIA GB200 кардинально изменила нашу способность быстро масштабировать P2L. Производительность системы дала нам гибкость для экспериментов, быстрых итераций и предоставления модели маршрутизации в реальном времени, которая адаптируется к живому вводу пользователя. В результате мы видим повышение точности и эффективности
сказал Вэй-Лин Чианг из LMArena

Добавление стека NVIDIA AI Enterprise в Nebius AI Cloud расширяет поддержку Nebius для корпоративных вариантов использования и национальных проектов ИИ. NVIDIA AI Enterprise предоставляет доступ к надежному набору инструментов для ускорения разработки и развертывания ИИ, включая микросервисы NVIDIA NIM, NVIDIA NeMo и другие основополагающие компоненты.

Клиенты Nebius уже осознают преимущества. Prima Mente, биотехнологическая компания, специализирующаяся на неврологических заболеваниях, таких как болезнь Альцгеймера, использует инфраструктуру Nebius для поддержки своих эпигенетических исследований.

GPU Cloud Nebius и ориентированная на ИИ инфраструктура дают Prima Mente эластичные, экономичные HPC, необходимые нам для обучения и тонкой настройки наших эпигенетических фундаментальных моделей с 90 млн до 7 млрд параметров в масштабе. Их платформа, готовая к наукам о жизни, позволяет нам за считанные минуты разворачивать защищенные кластеры, сжимая циклы разработки моделей и ускоряя доставку диагностических данных о здоровье мозга следующего поколения исследователям и врачам по всему миру
сказал Рави Соланки, генеральный директор Prima Mente

Nebius — первый партнер NVIDIA Cloud Partner (NCP) со штаб-квартирой в Европе, соответствующий нормативным стандартам ЕС и обеспечивающий производительность и прозрачность, необходимые для национальных и суверенных проектов в области ИИ.

Это делает Nebius естественным выбором для стратегических инициатив ИИ, таких как проект Hafnia от Milestone Systems, который в сотрудничестве с NVIDIA и Nebius разрабатывает совместимую, анонимную платформу видеоданных для обучения моделей языка зрения ИИ. Затем эти модели используются для помощи городам в разработке интеллектуальных городских решений ИИ на базе цифровых близнецов и агентов ИИ от NVIDIA. Все данные хранятся и обрабатываются в пределах ЕС.

Основное обязательство ЕС — быть лидером в вопросах прозрачности, справедливости и нормативной целостности в сфере ИИ и технологий. Соответствие правовой базе является ключевой частью этого. Я горжусь тем, что проект Hafnia от Milestone, созданный на базе NVIDIA, теперь может предоставить первую в мире платформу, соответствующую нормативным требованиям, а с Nebius, выступающим в качестве европейского облачного провайдера, визуальное обучение модели ИИ с использованием высококачественных, соответствующих требованиям видеоданных может действительно укорениться в Европе
говорит Томас Йенсен, генеральный директор Milestone Systems

Nebius запущен в Великобритании; расширяет инфраструктуру искусственного интеллекта Великобритании с помощью NVIDIA Blackwell Ultra


Развертывание кластера графических процессоров в Великобритании знаменует собой последний шаг в глобальном расширении. Великобритания получит инфраструктуру искусственного интеллекта, построенную на платформе NVIDIA Blackwell Ultra, что увеличит внутренние вычислительные
мощности. Поддерживает стратегию развития ИИ в Великобритании и создает новые возможности для британского бизнеса, исследователей и государственного сектора.

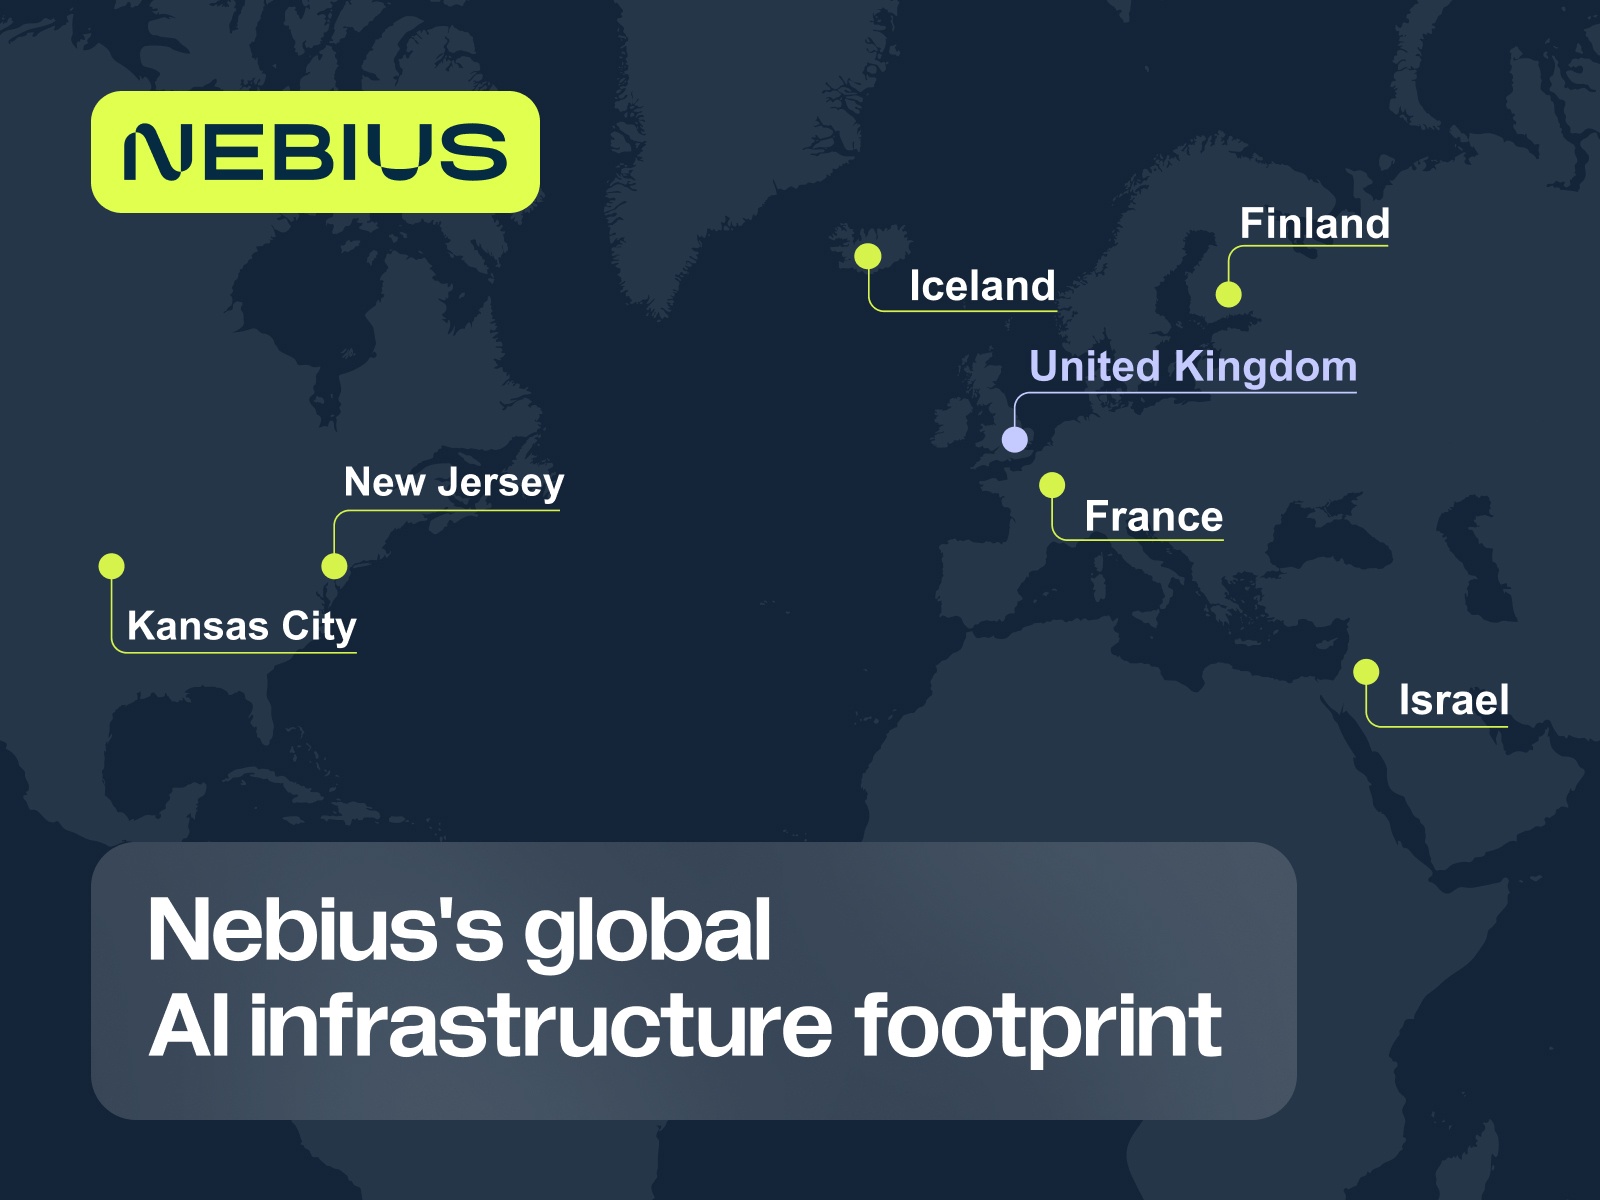
Амстердам, 9 июня 2025 г. — Nebius (NASDAQ:NBIS), ведущая компания в области инфраструктуры искусственного интеллекта, сегодня объявила о расширении своего глобального присутствия в сфере инфраструктуры искусственного интеллекта за счет развертывания графических процессоров NVIDIA Blackwell Ultra в Великобритании.

Развертывание усилит национальную цифровую инфраструктуру Великобритании и будет способствовать долгосрочному экономическому росту, позволяя британским фирмам — от стартапов до предприятий — создавать ИИ с использованием самых передовых вычислений в мире. Оно также поддержит ведущие в мире академические и исследовательские сообщества Великобритании и государственные службы, включая NHS.

Мы рады предоставить вычислительную инфраструктуру, которая будет поддерживать будущие инновации британских предприятий, исследователей и государственного сектора. Великобритания — это место, где ИИ создается, тестируется и развертывается в масштабах отраслей от финтеха до наук о жизни. Находясь здесь, мы приближаемся к стартапам, исследователям и лидерам предприятий, формирующим то, что будет дальше
Аркадий Волож, основатель и генеральный директор Nebius

Первая инвестиция Nebius в Великобритании является последней вехой в построении инфраструктуры ИИ для поддержки масштабных инноваций ИИ. С добавлением Великобритании Nebius будет управлять семью кластерами ИИ в шести странах Европы, США и Ближнего Востока, что сделает компанию одним из крупнейших независимых разработчиков инфраструктуры ИИ в мире.

Ожидается, что развертывание тысяч современных графических процессоров NVIDIA Blackwell Ultra в Великобритании начнется в четвертом квартале 2025 года.

Nebius AI Cloud использует платформу ускоренных вычислений NVIDIA и объединяет производительность суперкомпьютера с гибкостью и надежностью гиперскейлера. Компания является первым партнером по эталонной платформе NVIDIA Cloud со штаб-квартирой в Европе и одним из первых пользователей платформы NVIDIA Blackwell Ultra следующего поколения.

Дэйв Сальватор, директор NVIDIA по продуктам для ускоренных вычислений, сказал:
Локальная инфраструктура дает предприятиям и стартапам в каждой стране основу для построения собственного будущего с поддержкой ИИ. Расположенная в Великобритании инфраструктура NVIDIA Blackwell Ultra от Nebius будет поддерживать британских новаторов в разработке и развертывании приложений с передовым рассуждением, агентным и физическим ИИ

Развертывание GPU поддерживает ключевую цель, изложенную в Плане действий правительства Великобритании по возможностям ИИ, направленном на наращивание внутренних вычислительных мощностей Великобритании. Помимо прямой выгоды для британских новаторов и предприятий в области ИИ, инфраструктура ИИ, предоставляемая Nebius, будет способствовать созданию рабочих мест и привлечению дополнительных инвестиций в экономику ИИ в Великобритании.

Недавно Nebius запустила свое первое специализированное предложение с командой из Великобритании для поддержки секторов здравоохранения, естественных наук и биотехнологий. Другие британские клиенты включают компании в сфере финансовых услуг и генеративного ИИ, а также исследовательские институты, такие как Лондонский институт математических наук.

Команда Nebius в Великобритании также вносит вклад в передовые исследования ИИ, а внутренние НИОКР ИИ также ведутся из Лондона. Эта команда является уникальным отличием среди поставщиков облачных ИИ — или «neoclouds» — гарантируя, что Nebius AI Cloud действительно соответствует потребностям разработчиков ИИ. Она также проводит исследования в различных областях, включая недавнюю публикацию нового динамического бенчмарка для оценки агентских LLM.