Рейтинг
0.00

CubepathCom Хостинг

0 читателей, 3 топика

Почему мы создали собственную глобальную сеть с использованием BGP Multihoming и Anycast


Большинство хостинг-провайдеров используют один и тот же приём. Они арендуют мощности у более крупной сети, размещают за ней серверы и называют это своей инфраструктурой. Это работает, пока не перестанет работать. Когда у вышестоящего сервера возникают проблемы с маршрутизацией, у вас тоже возникают проблемы с маршрутизацией. Когда их пиринговые соединения перегружаются, это чувствуют ваши клиенты. Вы совершенно не контролируете путь трафика к вашим серверам.
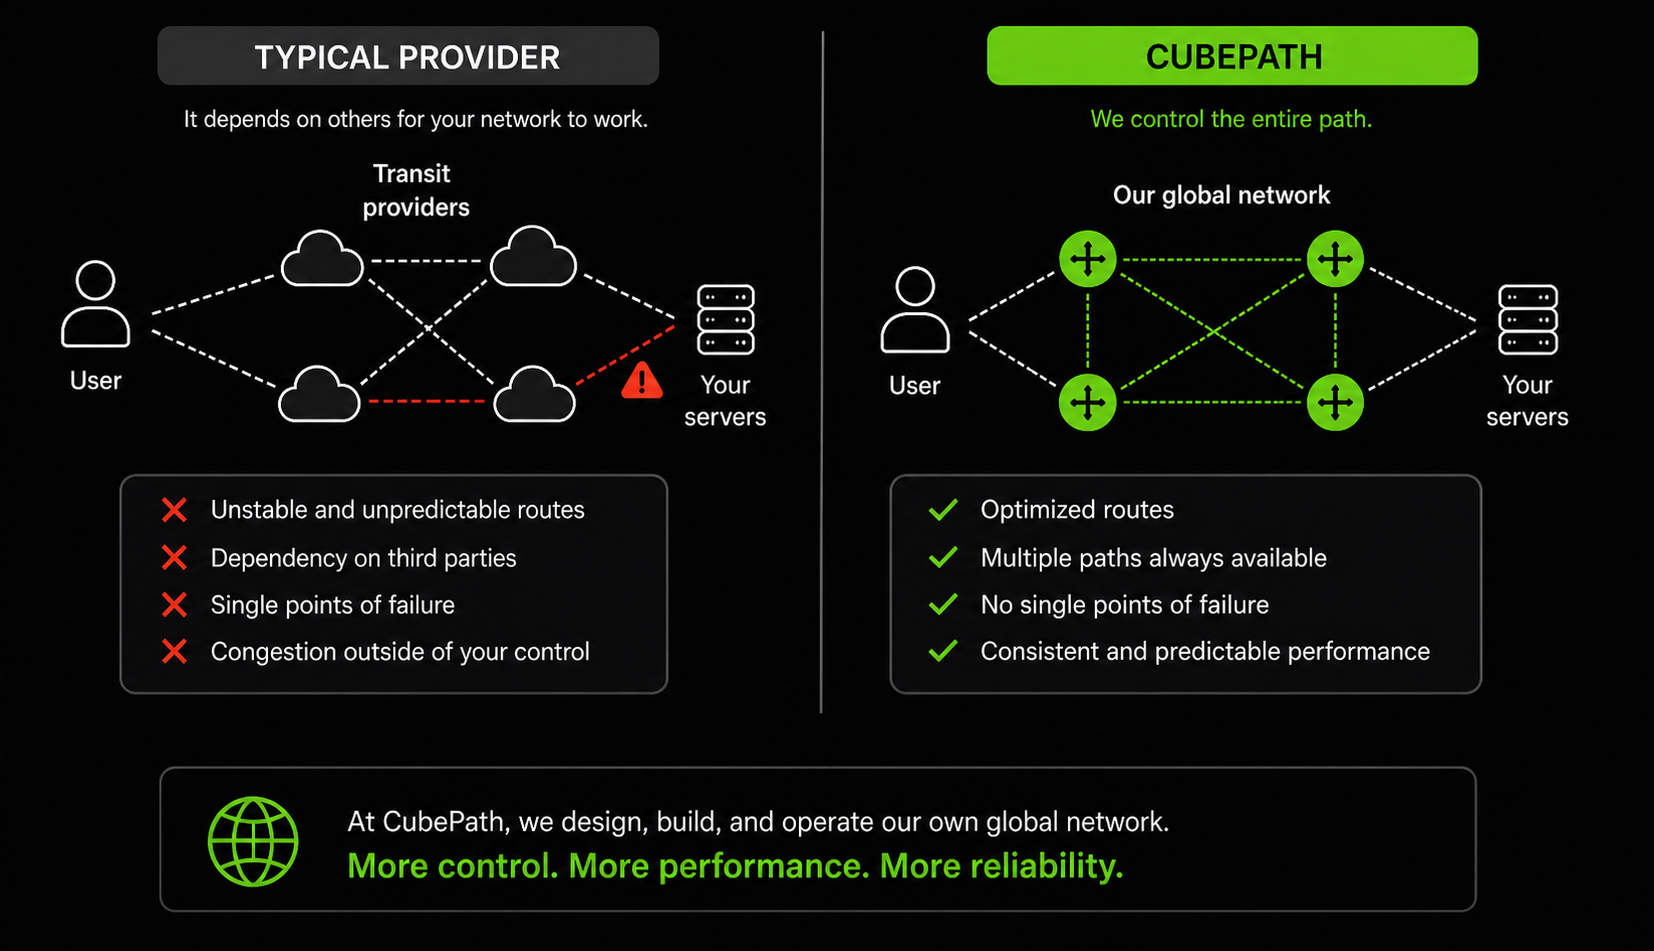


Мы с самого начала решили, что CubePath будет владеть собственной сетью, а не перепродавать чужую. Мы создали глобальную магистраль с точками присутствия в Майами, Хьюстоне, Вирджинии и Испании, используя протокол BGP multihoming с несколькими транзитными провайдерами и возможностью объявлять маршруты через Anycast с любой из наших точек присутствия.

В этом посте объясняется, почему мы сделали эти инвестиции и что это значит для всего, что вы запускаете на CubePath.

Наша сеть: точки присутствия, магистральная сеть и почему местоположение имеет значение.
Компания CubePath управляет точками присутствия в стратегически важных местах по всей Северной и Южной Америке и Европе:
  • Майами для Латинской Америки и Карибского бассейна
  • Хьюстон — центральная часть США и Мексика.
  • Вирджиния используется для перелетов через восточное побережье США и трансатлантических рейсов.
  • Испания для Южной Европы, Средиземноморья и Северной Африки
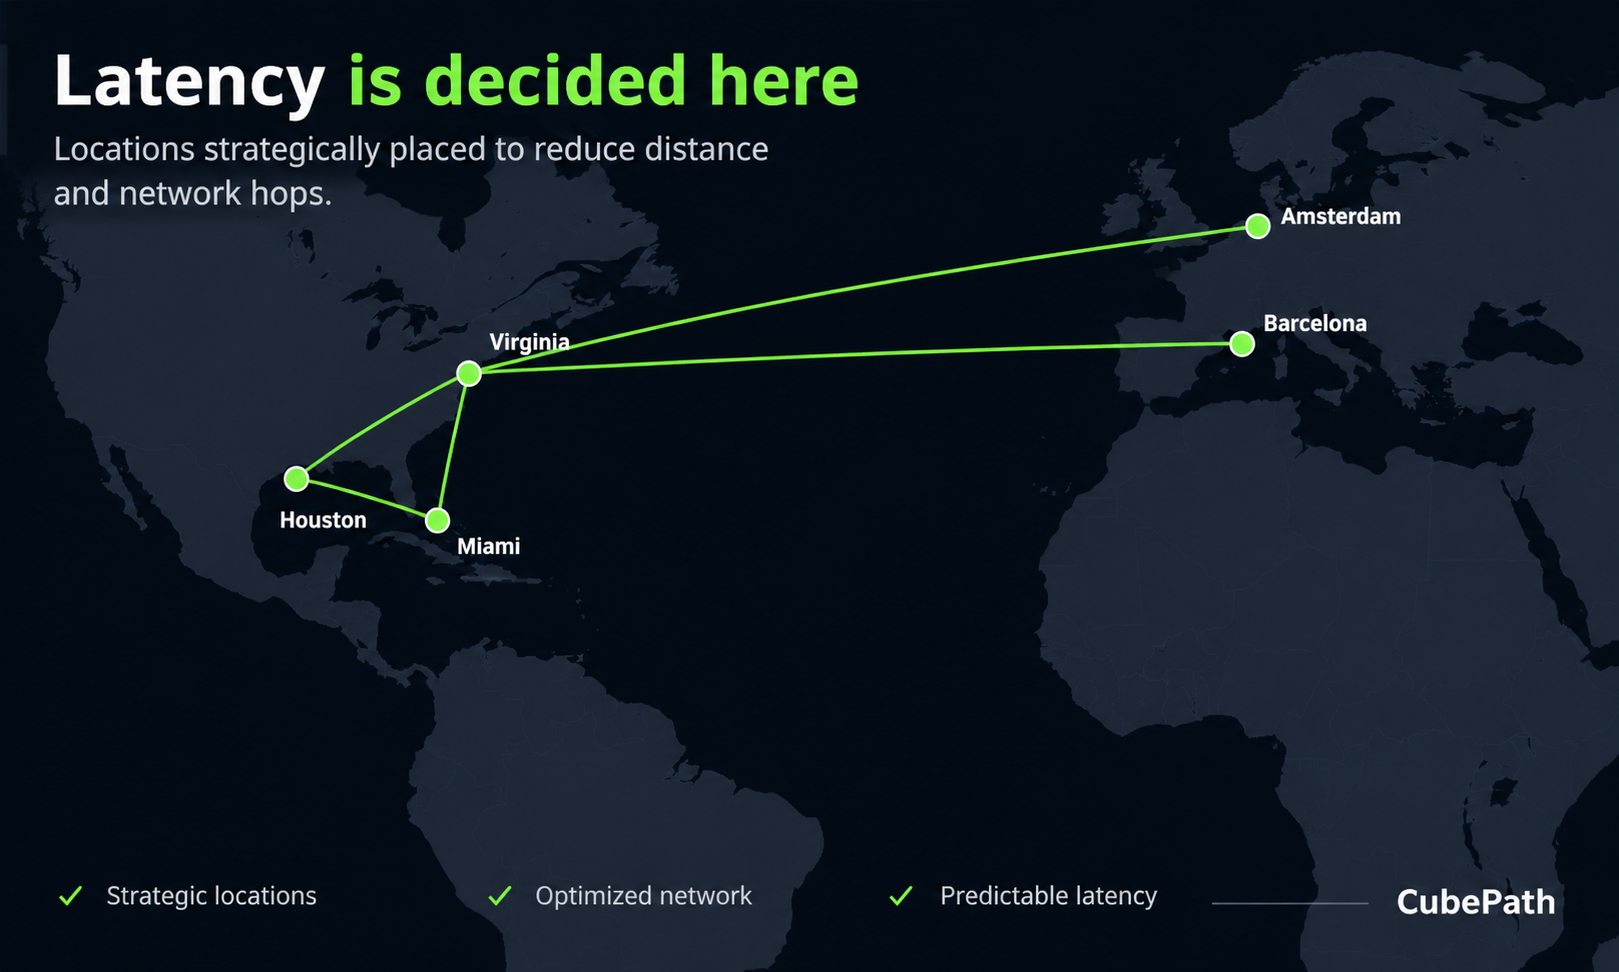


Каждый PoP — это не просто сервер в центре обработки данных. Это полноценная сетевая структура со своими собственными маршрутизаторами, транзитными соединениями и пирингом. Все PoP соединены между собой нашей частной магистральной сетью, поэтому трафик между точками остается в нашей сети, а не проходит через общедоступный интернет.

Почему физическое расположение точек присутствия имеет значение? Потому что так устроены законы физики. Свет в оптоволокне распространяется быстро, но расстояние всё равно увеличивается. Пользователю в Буэнос-Айресе, подключающемуся к серверу в Вирджинии, приходится преодолевать более 8000 км оптоволокна. Тот же пользователь, подключающийся через нашу точку присутствия в Майами, значительно сокращает это расстояние. Умножьте это на каждый запрос, каждый вызов API, каждую загрузку страницы, и разница в пользовательском опыте станет очевидной.

Но наличие точек присутствия в нужных местах — это только половина дела. Другая половина — это то, как трафик будет направляться к ним.

Многоканальное подключение BGP: несколько путей, отсутствие единых точек отказа.

BGP (Border Gateway Protocol) — это протокол, с помощью которого интернет определяет, по какому пути будет проходить трафик из точки А в точку Б. Каждая сеть в интернете объявляет свои маршруты через BGP, и маршрутизаторы по всему миру используют эти объявления для определения оптимального пути.

Большинство небольших и средних провайдеров используют простую конфигурацию BGP: один или два транзитных провайдера. Трафик поступает по тому пути, который предлагают эти провайдеры, и всё. Если у провайдера возникают проблемы, то и у вашего трафика возникают проблемы.

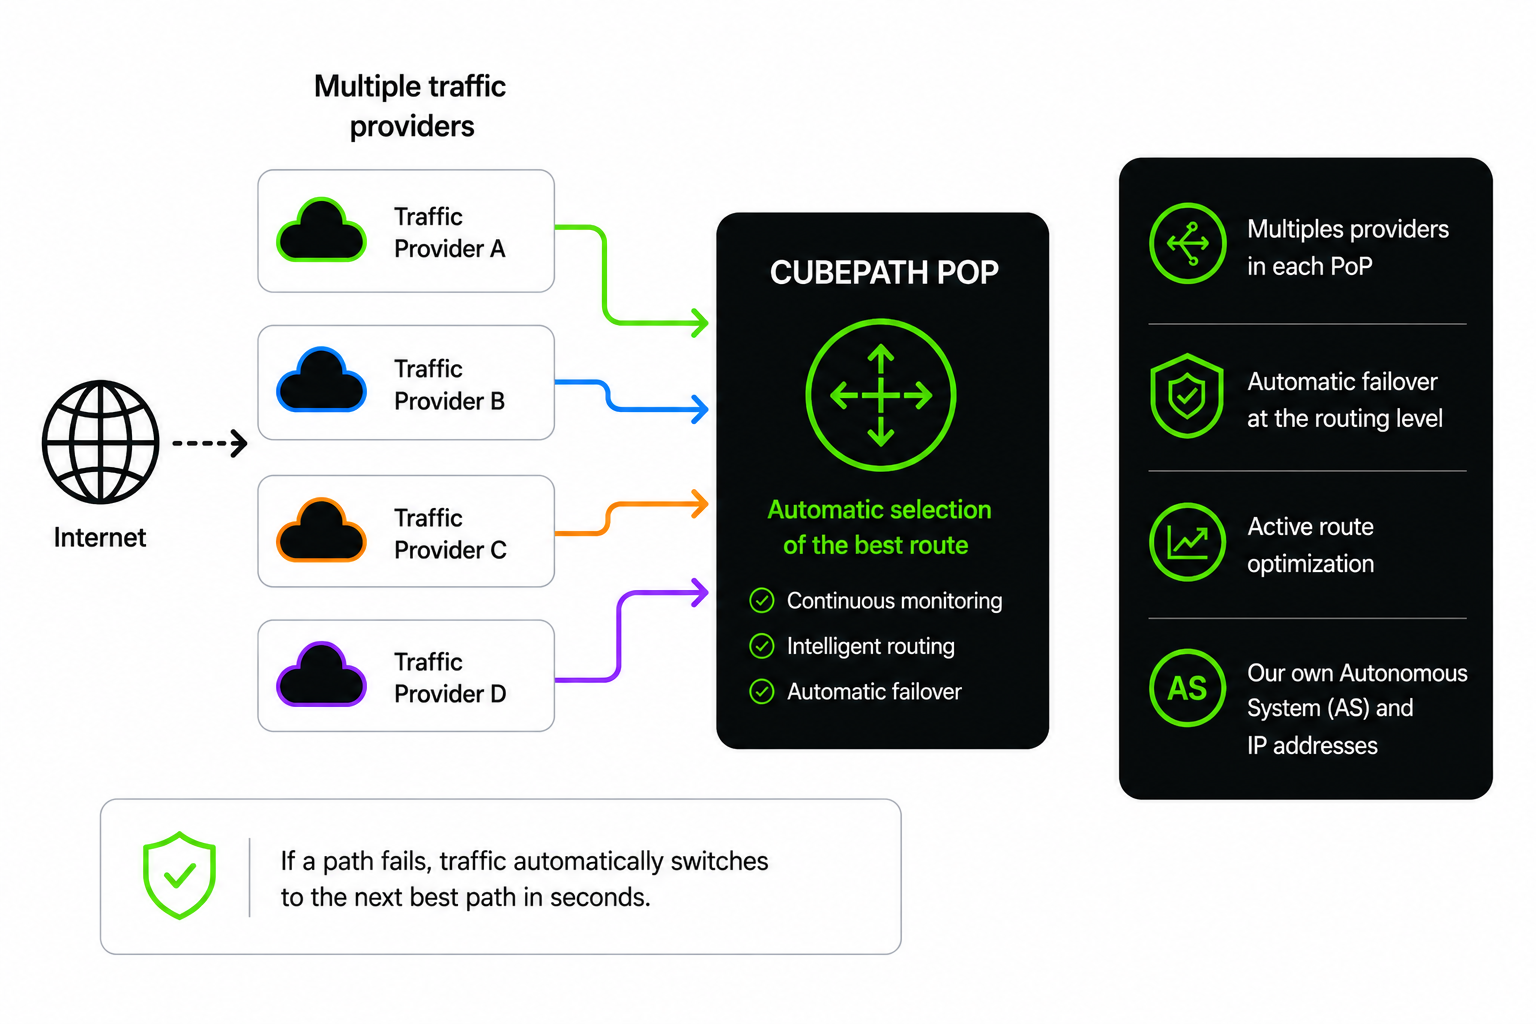
CubePath использует протокол BGP multihoming для всех наших точек присутствия (PoP). Это означает:

В каждом пункте подключения находится несколько транзитных провайдеров. Мы не зависим ни от одного вышестоящего провайдера. Каждая точка присутствия имеет соединения с несколькими транзитными провайдерами, поэтому всегда существует более одного пути для трафика к нам. Если у одного из провайдеров возникает утечка маршрута, проблема с перегрузкой или он полностью выходит из строя, трафик автоматически перенаправляется на следующий оптимальный путь.

Активная оптимизация маршрутов. Многоканальное подключение BGP — это не просто резервирование. Благодаря нескольким вышестоящим провайдерам мы можем влиять на то, по каким путям будет проходить трафик. Мы оптимизируем наши объявления BGP таким образом, чтобы трафик из разных регионов поступал через провайдера и по пути, обеспечивающему наименьшую задержку. Пользователь в Сан-Паулу получает доступ к нам по другому пути, чем пользователь в Лондоне, и оба получают наилучший доступный маршрут.

Наша собственная автономная система. CubePath использует собственный номер автономной системы и IP-пространство. Именно это делает возможной настоящую многоканальную маршрутизацию. Мы не заимствуем чужое адресное пространство и не зависим от решений маршрутизации других компаний. Мы объявляем свои собственные префиксы своим собственным вышестоящим узлам и контролируем, как мир видит нашу сеть.

Автоматическое переключение на резервный канал на уровне маршрутизации. При возникновении проблем у транзитного провайдера происходит автоматическая конвергенция BGP. Трафик перенаправляется по альтернативным маршрутам без какого-либо ручного вмешательства и без отключения ваших сервисов. Это не переключение на резервный канал на уровне приложений, занимающее минуты, а перемаршрутизация на уровне сети, происходящая за секунды.

Почему большинство поставщиков услуг этого не делают
Многоадресная маршрутизация по протоколу BGP требует значительных инвестиций. Вам потребуется собственный номер автономной системы, собственные IP-адреса, выделенные региональным интернет-регистратором, контракты с несколькими транзитными провайдерами в каждом местоположении, а также сетевые инженеры, разбирающиеся в политике BGP и оптимизации маршрутов. Большинство провайдеров обходят это стороной, поскольку единый восходящий канал проще и дешевле. Компромисс заключается в том, что их клиенты зависят от качества и надежности сети этого единственного провайдера.

Мы считаем, что такой компромисс неприемлем для производственной инфраструктуры. Если вы запускаете важные сервисы, сеть, передающая ваш трафик, должна быть отказоустойчивой по своей конструкции, а не по воле случая.

Взаимодействие с интернет-биржами: меньше переходов, более высокая скорость передачи данных.
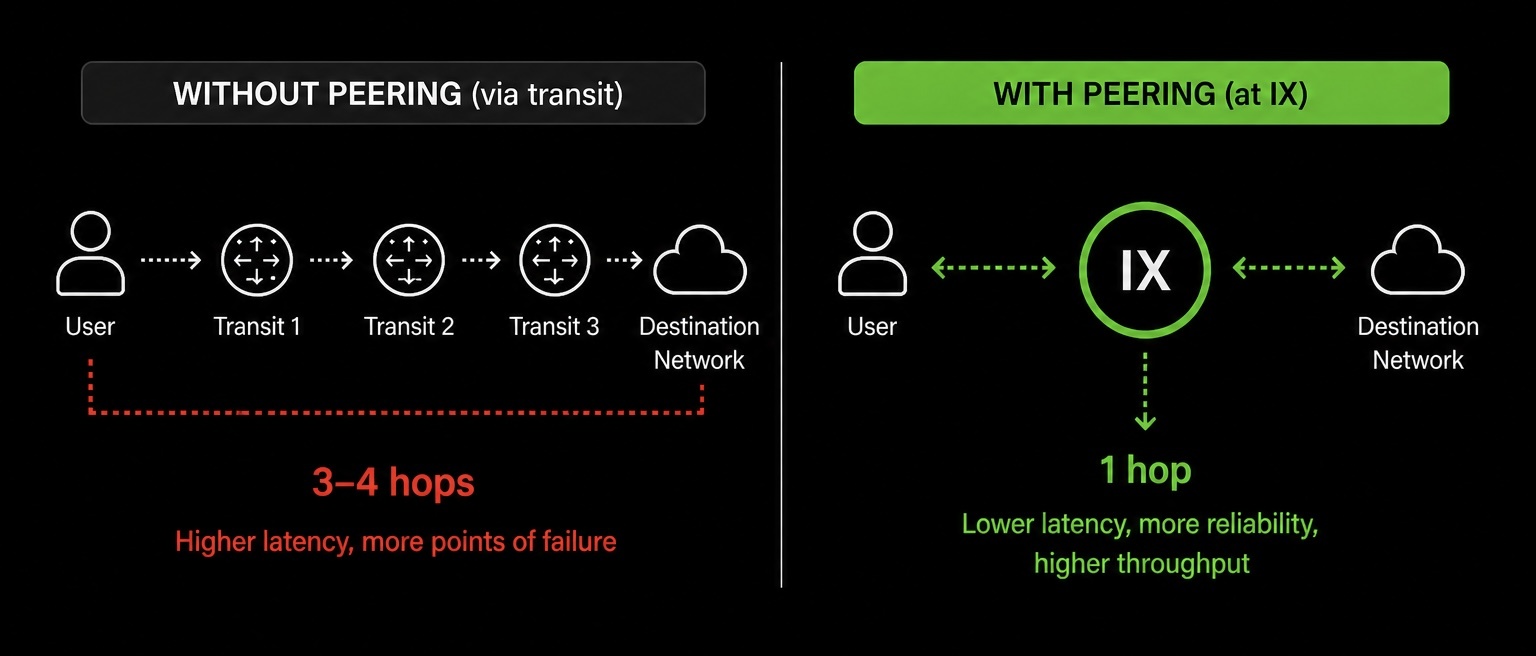
Помимо транзитных провайдеров, CubePath напрямую взаимодействует с точками обмена интернет-трафиком (IXP) в каждом регионе, где мы работаем. IX — это физическое место, где сотни сетей напрямую обмениваются трафиком друг с другом, минуя посредников.

Когда две сети присутствуют на одном и том же IX-сервере, они могут напрямую взаимодействовать друг с другом. Это означает, что трафик между ними не должен проходить через транзитного провайдера, что исключает промежуточные узлы и уменьшает задержку. Вместо того чтобы ваш трафик шел от CubePath к транзитному провайдеру, затем к другому транзитному провайдеру и, наконец, к целевой сети, он идет от CubePath напрямую к месту назначения. Один переход вместо трех или четырех.


Мы отслеживаем каждую точку обмена интернет-трафиком (IX), поскольку цель проста: поддерживать максимально возможную взаимосвязь нашей сети и сократить количество переходов между CubePath и остальной частью интернета.

Почему это важно для задержки. Каждый промежуточный узел в сетевом пути добавляет задержку. Маршрутизатору необходимо получить пакет, определить маршрут и переслать его. Это занимает время, обычно доли миллисекунды, но оно суммируется на нескольких промежуточных узлах. Устанавливая прямой пиринг с крупными сетями, CDN, облачными провайдерами и наблюдая за интернет-провайдерами в точках обмена трафиком, мы исключаем эти промежуточные узлы из уравнения. В результате вы получаете заметно меньшую задержку для ваших пользователей.

Почему это важно для надежности. Меньшее количество переходов означает меньшее количество потенциальных проблем. Каждый маршрутизатор на пути является потенциальной точкой отказа или перегрузки. Прямое пиринговое соединение на IX полностью исключает эти промежуточные точки. Если мы соединены пирингом с интернет-провайдером пользователя на той же станции, трафик остается локальным для этого объекта. Никакого транзита на большие расстояния, никаких решений по маршрутизации от третьих лиц, никаких неожиданностей.

Почему это важно для пропускной способности. Пиринг IX обычно обеспечивает более высокую пропускную способность и меньшую стоимость, чем транзит. Когда значительная часть вашего трафика направляется в сети, с которыми вы напрямую взаимодействуете через пиринг, вы не конкурируете за пропускную способность на перегруженных каналах транзитного провайдера. Трафик проходит по выделенным пиринговым соединениям с пропускной способностью, которую мы контролируем и отслеживаем.

Чем больше сетей мы сотрудничаем, тем больше трафика проходит по прямым путям. А чем больше прямых путей проходит трафик, тем быстрее и надежнее ваши сервисы для конечных пользователей.

Anycast: Один IP-адрес, обслуживание осуществляется с ближайшей точки присутствия.
Anycast — это метод маршрутизации, при котором один и тот же IP-адрес объявляется одновременно из нескольких точек. Когда пользователь отправляет запрос на Anycast IP-адрес, маршрутизация BGP автоматически направляет его к ближайшей точке присутствия (PoP), объявляющей этот адрес. Пользователь не выбирает адрес самостоятельно. Сеть делает это автоматически на основе близости маршрутов.

CubePath использует технологию Anycast в нашей сети точек присутствия. Вот что это позволяет:
Географическое управление трафиком без уловок DNS. Традиционные подходы к направлению пользователей к ближайшему серверу основаны на GeoDNS, который преобразует одно и то же имя хоста в разные IP-адреса в зависимости от местоположения пользователя. Это работает, но обновление происходит медленно, данные неточны и зависят от соблюдения значений TTL DNS. Anycast обходит все эти сложности. Один IP-адрес объявляется каждым PoP, а сеть обрабатывает все остальное.

Мгновенное переключение между точками доступа. Если точка присутствия (PoP) выходит из строя, BGP отзывает маршрут Anycast из этой точки. Трафик автоматически перенаправляется на ближайшую точку присутствия в течение нескольких секунд. Нет задержек распространения DNS, нет ожидания TTL, нет ручного вмешательства. IP-адрес остается неизменным, перенаправление пользователя происходит незаметно.

Снижена задержка при первом подключении. Процесс установления TLS-соединения чувствителен к задержке. Для передачи данных требуется несколько циклов обмена данными между клиентом и сервером. Когда Anycast IP-адрес разрешается в ближайшую точку присутствия (PoP), эти циклы обмена данными становятся короче, и соединение устанавливается быстрее. Для HTTPS-сервисов это напрямую приводит к сокращению времени до получения первого байта.

Естественная устойчивость к DDoS-атакам. Anycast распределяет входящий трафик по всем точкам присутствия (PoP), объявляя адрес. Во время объемной DDoS-атаки трафик распределяется по нескольким точкам, а не достигает одной. Каждая точка присутствия поглощает часть атаки, что значительно затрудняет перегрузку какой-либо одной точки.

Как мы используем Anycast в CubePath
Хороший пример — наша DNS-инфраструктура. DNS-серверы CubePath объявляются через Anycast со всех наших точек присутствия (PoP). Когда ваш сервер отправляет DNS-запрос, он автоматически достигает ближайшего резолвера. Сервер в Испании запрашивает локальную точку присутствия. Сервер в Майами запрашивает ту же самую точку присутствия. Один и тот же IP-адрес, разное физическое местоположение, минимально возможная задержка. Если точка присутствия выходит из строя, DNS-запросы автоматически перенаправляются к следующей ближайшей точке присутствия без каких-либо изменений в конфигурации.

Мы также используем Anycast в качестве основы для наших CDN и сервисов защиты от DDoS-атак. Трафик от конечных пользователей сначала достигает ближайшей точки присутствия (PoP), где он может быть отфильтрован, кэширован или перенаправлен на исходный сервер по нашей частной магистральной сети. Такая архитектура означает, что как уровень безопасности, так и уровень доставки контента выигрывают от географического распределения без необходимости какой-либо настройки со стороны клиентов.

Как всё это взаимосвязано
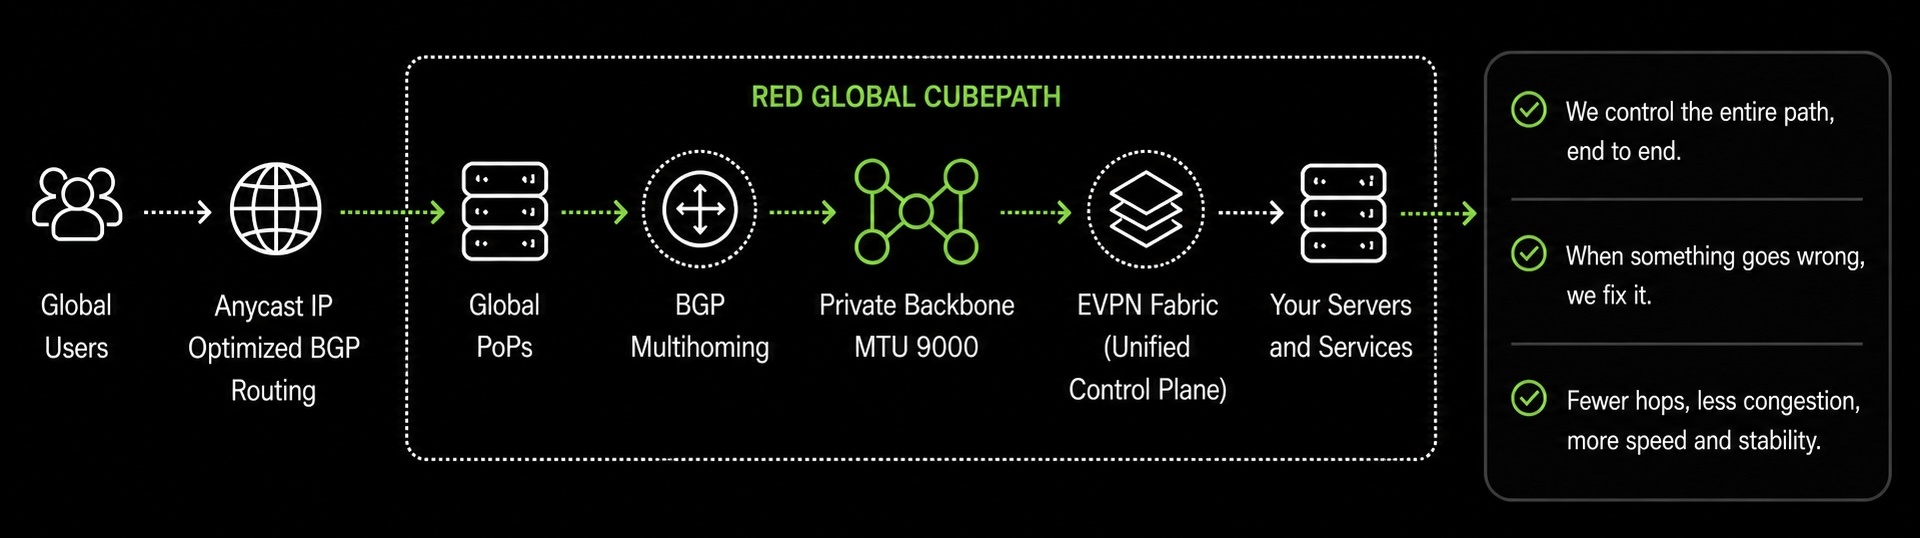

Наша глобальная сеть — это не набор разрозненных элементов. Точки присутствия (PoP), многоадресная маршрутизация BGP, Anycast и частная магистраль с MTU 9000 — всё это работает вместе как единая инфраструктура.

Благодаря технологии Anycast и оптимизированным маршрутам BGP трафик поступает через ближайшую точку присутствия (PoP). Он проходит по нашей частной магистральной сети до серверов, на которых работают ваши рабочие нагрузки, при этом MTU 9000 обеспечивает максимально эффективную внутреннюю передачу данных. В случае отказа какого-либо компонента, будь то транзитный провайдер, точка присутствия или сервер, сеть автоматически перенаправляет трафик на уровне BGP.

Внутри нашей сети используется технология EVPN (Ethernet VPN), та же самая, что и у крупных облачных провайдеров. EVPN использует BGP для определения местоположения каждого сервера и адреса в сети, поэтому трафик перенаправляется интеллектуально, а не распространяется повсюду, как в традиционных системах. Это позволяет нам беспрепятственно расширять частные сети между точками присутствия (PoP), обрабатывать многосайтовые соединения и масштабировать сеть по мере добавления новых серверов и местоположений без ухудшения качества сети. Тот же BGP, который отвечает за маршрутизацию в интернете, пиринг и Anycast, также управляет нашей внутренней сетью. Единая плоскость управления для всей сети.

Именно это отличает CubePath от провайдеров, арендующих сетевые мощности у кого-то другого. Мы контролируем весь путь, от первого пакета пользователя до сервера, обрабатывающего запрос. Когда что-то идет не так, мы не открываем заявку в службу поддержки. Мы исправляем проблему сами.

Для команд, работающих с API, чувствительными к задержкам, глобально распределенными приложениями, сервисами реального времени или любыми другими системами, где производительность сети напрямую влияет на пользовательский опыт, именно такая сеть необходима в вашей инфраструктуре.

Куда мы идём
Мы продолжаем расширять зону покрытия PoP и добавлять пиринговые соединения в каждом пункте. Большее количество PoP означает более короткие пути к большему числу пользователей. Большее количество пиринговых соединений означает меньшую зависимость от транзита и более качественную маршрутизацию к крупным сетям и интернет-провайдерам.

По мере развития CubePath Managed Kubernetes, кластеров GPU и остальной части нашей платформы, сеть остается ее основой. Быстрая, отказоустойчивая, глобально распределенная и полностью контролируемая нами.

Мы создали эту сеть, потому что считаем, что поставщики инфраструктуры должны владеть своей сетью, а не арендовать её. Всё, что мы предлагаем на CubePath, построено на этом фундаменте, и мы думаем, вы почувствуете разницу.

cubepath.com
my.cubepath.com/register
Почему мы создали глобальную сеть с MTU 9000 и что это дает


Когда мы начали проектировать сетевую инфраструктуру CubePath, у нас был выбор. Мы могли поступить так, как поступает большинство провайдеров: предоставить каждому региону свою собственную изолированную сеть со стандартным MTU 1500 и на этом остановиться. Это дешевле, проще, и, честно говоря, большинство клиентов не заметят разницы в первый же день.

Мы решили пойти другим путем. Мы инвестировали в создание глобальной частной сети с VLAN, охватывающей несколько регионов, и MTU 9000 (jumbo frames) по всем направлениям. Это стоило дороже. Это заняло больше времени. Но это открывает категорию архитектур, которые просто невозможны в стандартной сети, и мы считаем, что это важно.

В этом посте объясняется, почему мы сделали эти инвестиции и какие возможности это открывает для команд, разрабатывающих приложения на платформе CubePath.

Почему MTU 9000? Потому что 1500 байт на пакет — это узкое место.
Начнём с технической реальности. По умолчанию MTU в большинстве сетей составляет 1500 байт. Это стандарт, действующий с момента разработки Ethernet в 1980-х годах. Каждый пакет, отправляемый вашими серверами, содержит максимум 1500 байт фактических данных, плюс заголовки.

Для обычного веб-трафика это нормально. Но как только вы начинаете передавать серьезные объемы данных между серверами, эти небольшие пакеты становятся настоящим ограничивающим фактором.

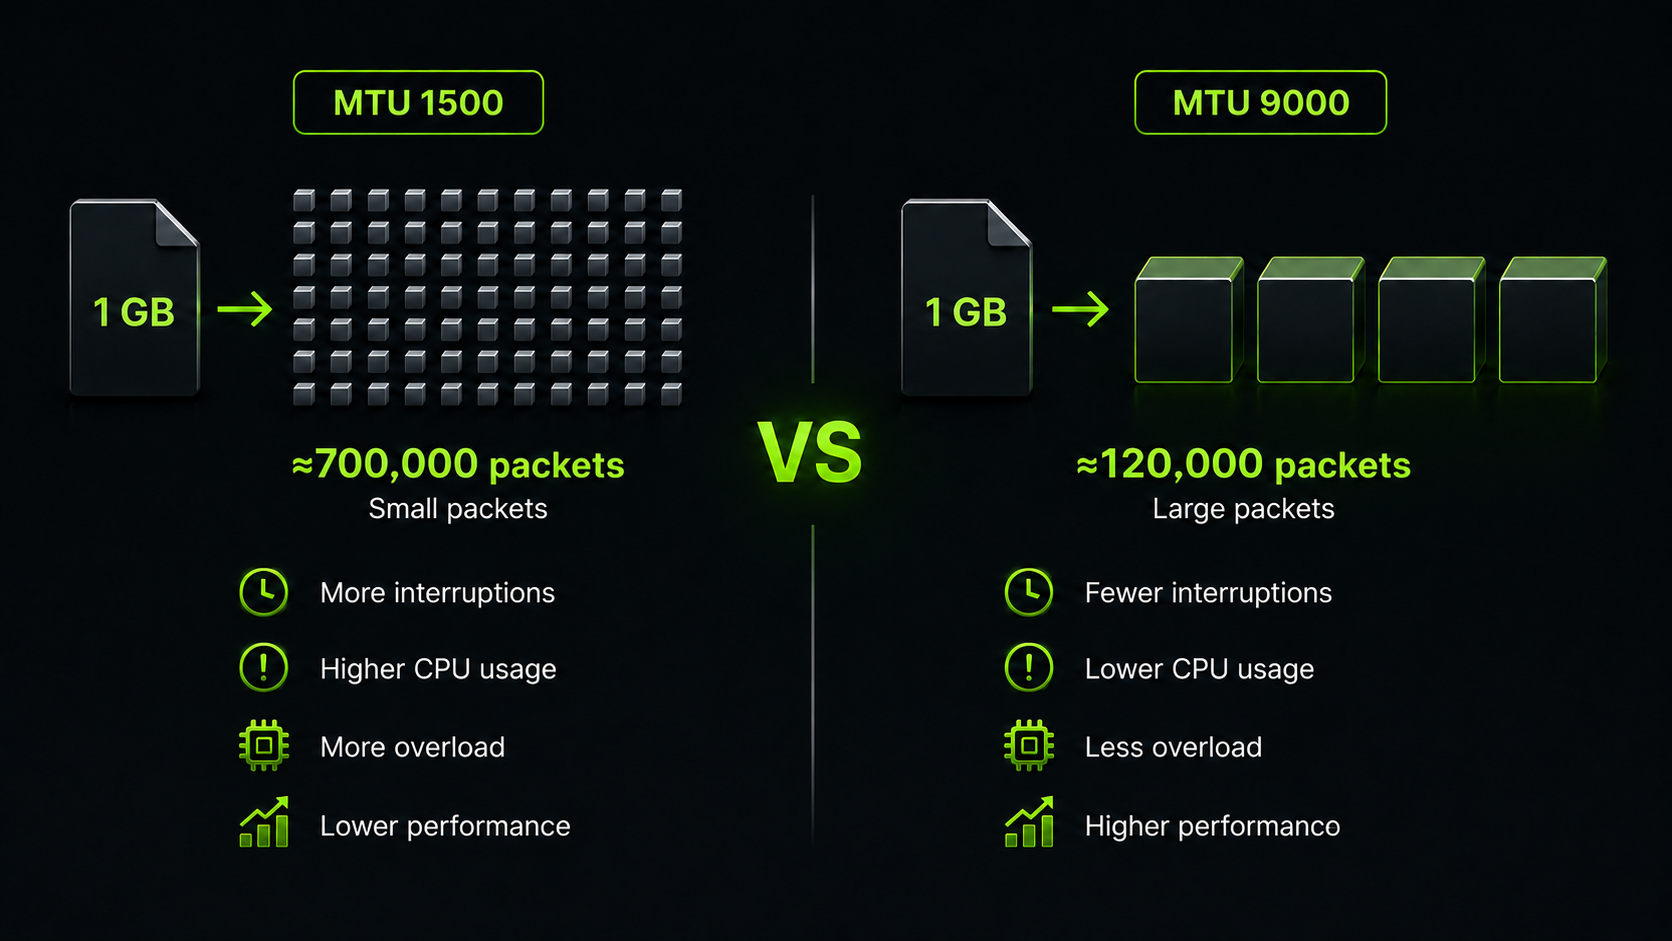
Возьмем, к примеру, резервную копию базы данных размером 1 ГБ. При MTU 1500 это примерно 700 000 пакетов, которые необходимо собрать, отправить, получить, проверить и подтвердить. Каждый из этих пакетов требует ресурсов процессора. Необходимо обрабатывать заголовки, вычислять контрольные суммы, обрабатывать прерывания. Умножьте это на сотни передач, происходящих каждый час в загруженной инфраструктуре, и вы увидите, что реальные вычислительные ресурсы расходуются на сетевые накладные расходы.

Теперь рассмотрим ту же передачу с MTU 9000. Каждый пакет содержит в 6 раз больше данных. Резервная копия объемом 1 ГБ сокращается примерно до 120 000 пакетов. Меньше нагрузки на ЦП, меньше прерываний, более высокая пропускная способность. В реальных тестах Jumbo-кадры улучшают производительность пакетной передачи на 15-30%. В рабочих нагрузках, постоянно перемещающих данные между узлами, таких как репликация баз данных, распределенное хранилище или трафик контейнеров «восток-запад», эта разница увеличивается в течение дня.


Мы проанализировали, что именно создают наши клиенты. Кластеры баз данных с потоковой репликацией. Распределенные хранилища с Ceph и GlusterFS. Кластеры Kubernetes с сотнями взаимодействующих друг с другом подов. Конвейеры обработки больших данных, перемещающие промежуточные результаты между узлами. Все это — рабочие нагрузки, где эффективность сети напрямую влияет на производительность и стоимость. Поэтому мы приняли решение: MTU 9000 повсюду, не как дополнительная опция, а как основа.

Почему многорегиональные VLAN? Потому что реальные архитектуры не размещаются в одном центре обработки данных.


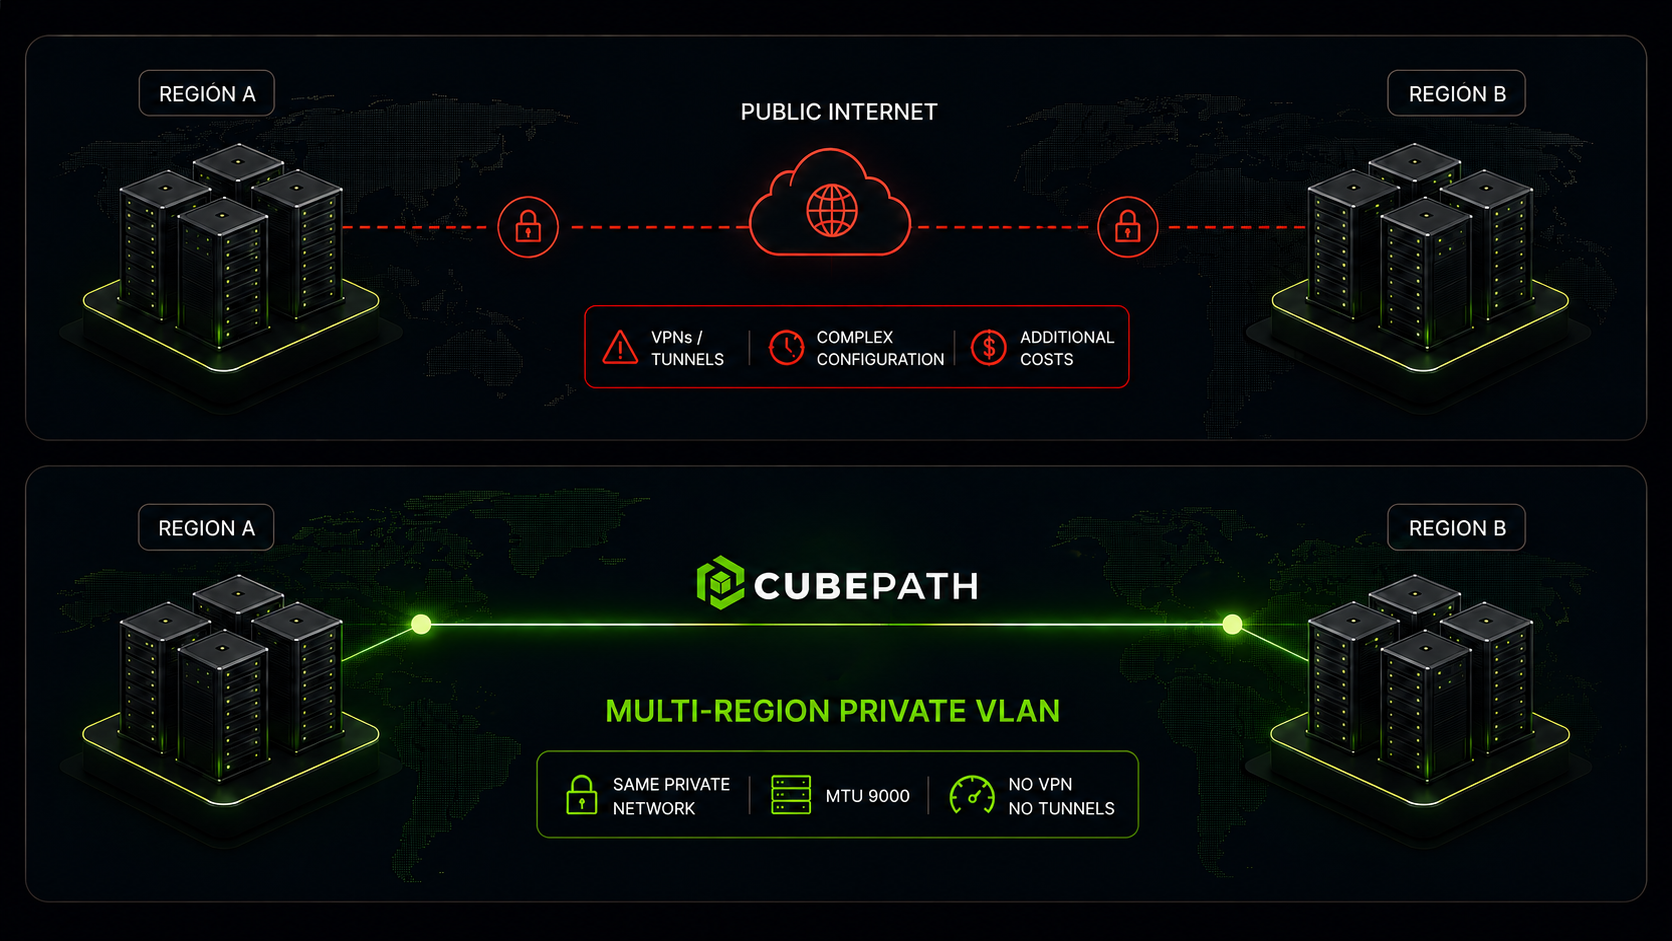
Большинство провайдеров предоставляют вам частную сеть в пределах одного региона. Ваши серверы в Испании могут обмениваться данными между собой через частную сеть, и ваши серверы в Амстердаме также могут обмениваться данными через частную сеть. Но если Испании нужно связаться с Амстердамом? Вам придется использовать общедоступный интернет, создавать VPN-туннели или платить за какие-либо услуги межсетевого взаимодействия.

Это создает трение, которое подталкивает команды к более простым (и более хрупким) архитектурам. Если соединение двух регионов само по себе является проектом, люди его избегают. Они запускают все в одном регионе и надеются, что ничего не пойдет не так. Или они создают недоработанные системы аварийного восстановления, которые никогда не тестировались, потому что настройка сетевого уровня оказалась слишком сложной.

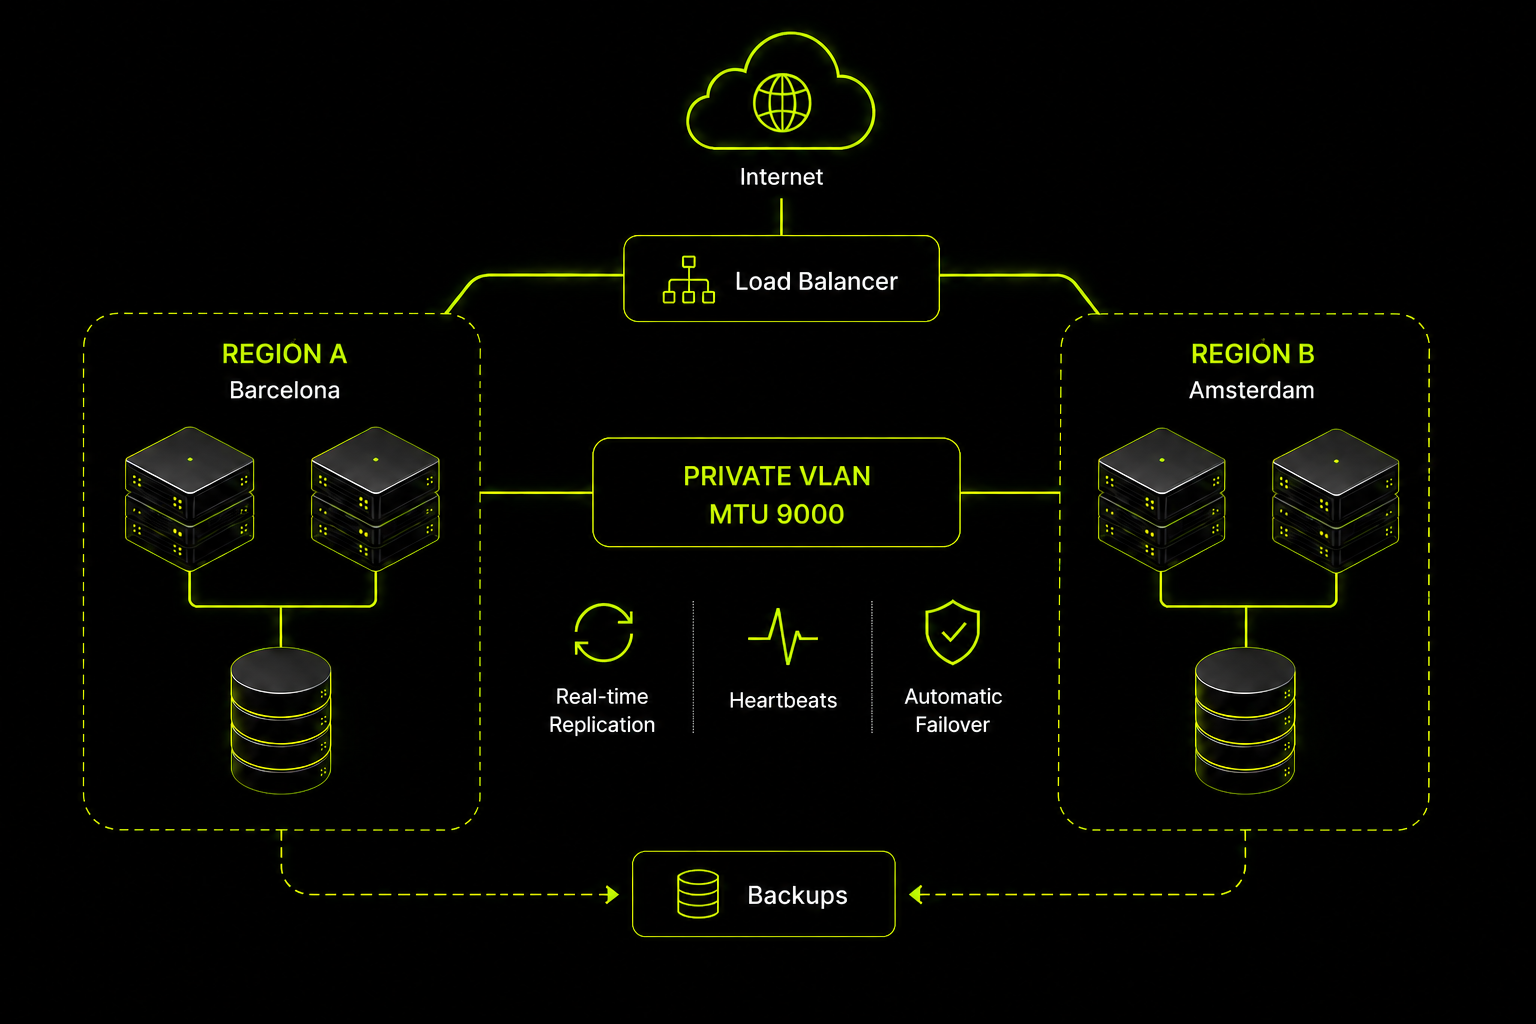
Мы хотели полностью устранить это препятствие. VLAN-сети CubePath охватывают разные регионы. Ваш сервер в Испании и ваш сервер в Амстердаме могут находиться в одной частной сети, как если бы они располагались в одной стойке. Никаких VPN, никаких туннелей, никакой специальной конфигурации. Просто серверы, которые видят друг друга с MTU 9000, через частную сеть, которая никогда не подключается к общедоступному интернету.

Это не просто функция для удобства. Она коренным образом меняет представление о том, какие архитектуры целесообразно строить.

Что делает возможной эта сеть
Вот что становится реальностью, когда ваша частная сеть быстрая, глобальная и имеет правильные параметры.


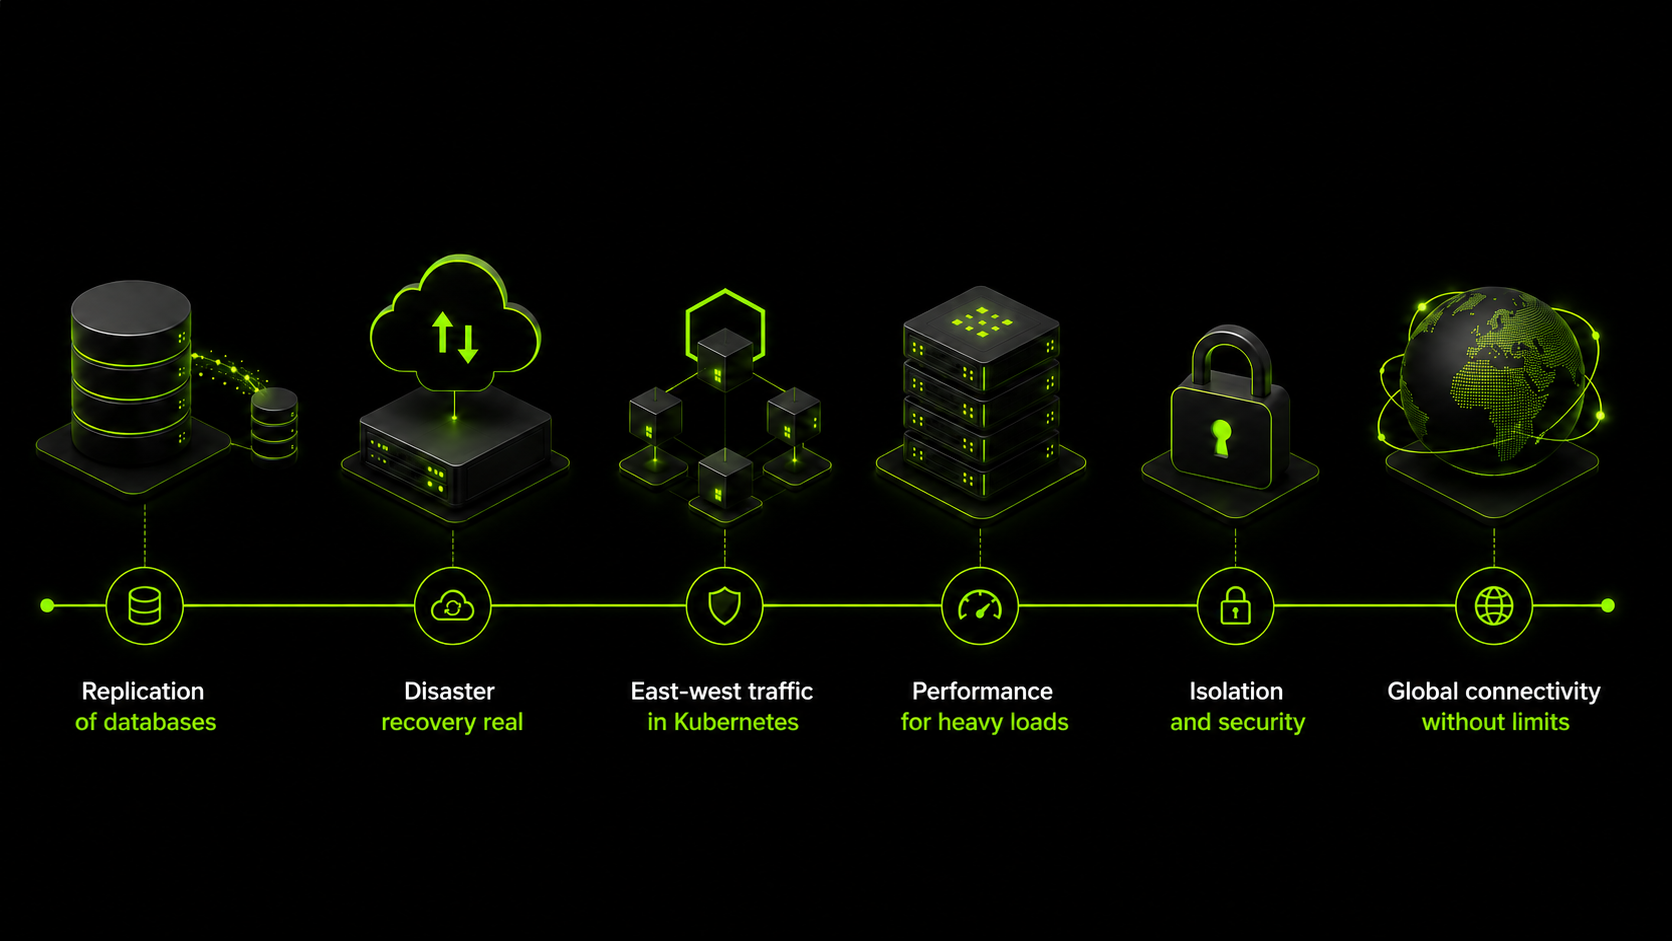
Репликация базы данных, которая действительно обеспечивает бесперебойную работу.
Репликация PostgreSQL в потоковом режиме, групповая репликация MySQL, репликационные наборы MongoDB. Все они зависят от передачи данных с основного сервера на одну или несколько реплик по сети. Чем быстрее и эффективнее сеть, тем меньше задержка репликации.

Благодаря MTU 9000 в частной сети между регионами, ваша реплика в другом центре обработки данных остается близкой к основной даже при высоких нагрузках на запись. Это означает, что ваши реплики для чтения предоставляют актуальные данные, ваша целевая точка переключения на резервный сервер действительно работоспособна, а восстановление на определенный момент времени не происходит с задержкой в ​​несколько секунд.

В стандартной сети с MTU 1500, подключенной к общедоступному интернету? Задержка репликации резко возрастает под нагрузкой, реплики отстают, и когда вам действительно нужно переключиться на резервный сервер, вы обнаруживаете, что ваш резервный сервер отстает от основного на несколько минут.

Восстановление после катастроф, которому вы действительно можете доверять
Восстановление после сбоев — это одна из тех вещей, о которых все говорят, что они у них есть, но мало кто действительно их тестировал. Основная причина этого — сложность сети. Если передача резервных копий в другой регион включает в себя настройку VPN-туннелей, конфигурирование шифрования, учет расходов на пропускную способность и надежду на то, что передача завершится до начала следующего окна резервного копирования, то команды просто… не делают это должным образом.

Когда ваши регионы подключены к одной и той же VLAN с MTU 9000, восстановление после сбоев становится намного проще. WAL-файлы передаются по частной сети в режиме реального времени. Ночные резервные копии передаются быстрее, поскольку Jumbo-кадры уменьшают накладные расходы. Стоимость сети равна нулю, поскольку частный трафик бесплатен. А поскольку это легко настроить, команды фактически тестируют свои процедуры восстановления, а не предполагают, что они работают.

Распределенное хранилище без узкого места в сети
Ceph, GlusterFS, NFS, iSCSI. Все эти протоколы хранения данных невероятно чувствительны к производительности сети. Скорость кластера хранения данных зависит только от скорости сети, соединяющей его узлы.

MTU 9000 уменьшает фрагментацию пакетов и позволяет передавать трафик хранилища со скоростью, близкой к скорости сетевого соединения. Если вы используете кластер Ceph на нескольких серверах, разница между MTU 1500 и MTU 9000 может означать разницу между приемлемой производительностью и постоянными узкими местами. Мы убедились в этом на собственном опыте у клиентов, использующих распределенные хранилища, и это одна из причин, по которой мы перешли на использование Jumbo Frames в сети в целом.

Кластеры высокой доступности, где переключение при отказе измеряется в секундах.
Кластеры с высокой доступностью зависят от быстрой и надежной связи между узлами. Сигналы активности должны поступать вовремя. Синхронизация состояния должна быть быстрой. При переключении на резервный сервер кластер должен обнаружить сбой и реорганизоваться за секунды, а не за минуты.

В CubePath обмен данными между узлами кластера происходит по частной сети. Сигналы активности между узлами Patroni, проверки Redis Sentinel, консенсус etcd в Kubernetes, проверки работоспособности HAProxy — всё это работает в быстрой, изолированной сети с MTU 9000. В результате обнаружение сбоев происходит быстрее, передача состояния при повышении уровня кластера происходит быстрее, и ваш кластер восстанавливается до того, как пользователи заметят какие-либо изменения.

В сочетании с балансировщиками нагрузки CubePath и плавающими IP-адресами вы получаете строительные блоки для архитектур высокой доступности, которые действительно работают в производственной среде. Не просто на бумаге, не просто в инструкциях по эксплуатации, которые никто не тестировал, а в реальных сценариях отказа, когда узел действительно выходит из строя в 3 часа ночи, и система справляется с этим самостоятельно.

Kubernetes с быстрой передачей трафика между Востоком и Западом.
Kubernetes генерирует огромный объем внутреннего сетевого трафика. Поды взаимодействуют друг с другом, сервисы разрешаются через DNS кластера, контроллеры входящего трафика маршрутизируют запросы к бэкэндам — все это трафик между узлами, идущий в направлении «восток-запад».

Когда трафик проходит по сети с MTU 9000, каждое взаимодействие между подами становится более эффективным. Боковые контейнеры сервисной сетки добавляют меньше накладных расходов. Большие объемы данных между микросервисами передаются быстрее. А если вы используете CNI, например Cilium или Calico, то производительность базовой сети напрямую влияет на скорость взаимодействия ваших подов.

Для управляемого Kubernetes от CubePath это означает, что кластерная сеть работает лучше сразу после установки. Для самостоятельного управления это означает, что вы используете сеть, которая не будет создавать проблем по мере роста кластера.

Конвейеры обработки больших данных, которые не зависают при перемешивании данных.
Если вы когда-либо работали с Hadoop, Spark или любой другой распределенной системой обработки данных, вы знаете, что на этапе перемешивания данных все замедляется. Узлы обмениваются промежуточными результатами друг с другом, и скорость этого обмена определяет скорость завершения вашей задачи.

MTU 9000 снижает накладные расходы на каждый пакет во время перемешивания данных, что означает более быструю передачу данных между узлами и более быстрое завершение заданий. Для команд, выполняющих обычные аналитические задачи или конвейеры ETL на нескольких серверах, это не просто незначительное улучшение. Это разница между конвейером, который завершается в течение установленного вами пакетного окна, и тем, который этого не делает.

Решение, лежащее в основе инвестиций


Создание этой сети было непростым делом. Стандарт MTU 9000 требует сквозной поддержки на каждом коммутаторе, маршрутизаторе и сетевой карте на пути следования. Многорегиональные VLAN требуют межсоединений между центрами обработки данных, чего большинство провайдеров избегают из-за стоимости и сложности. Было бы проще и дешевле использовать стандартные сетевые решения и сосредоточиться на других функциях.

Но мы постоянно приходили к одному и тому же выводу: сеть — это основа всего остального. У вас могут быть самые быстрые процессоры и самое большое количество NVMe-хранилищ в мире, но если ваши серверы не могут эффективно взаимодействовать, ваша архитектура достигнет предела своих возможностей.

Репликация баз данных, распределенное хранилище, кластеры высокой доступности, сетевое взаимодействие контейнеров, аварийное восстановление. Все это ограничено качеством сети между вашими серверами. Мы хотели, чтобы CubePath представлял собой инфраструктуру, в которой вы проектируете архитектуру, исходя из того, что лучше всего подходит для вашего приложения, а не исходя из возможностей сети вашего провайдера.

Именно поэтому мы построили её именно так. И именно поэтому мы продолжаем инвестировать в расширение этой сети, добавляя новые регионы и наращивая мощности.

Что дальше?
Мы продолжаем расширять нашу сеть, добавляя новые регионы и увеличивая пропускную способность существующих межсоединений. По мере роста CubePath Managed Kubernetes и запуска кластеров GPU, требования к внутренней сети только возрастают, и инвестиции в MTU 9000 и многорегиональные VLANы окупаются еще больше.

Если вы проектируете архитектуру, требующую быстрой внутренней сети, межрегиональной репликации или действительно высокой доступности, сеть CubePath создана именно для этого.

cubepath.com
my.cubepath.com/register
Объявляем о новой панели CubePath


Новая панель CubePath: почему мы отказались от WHMCS
Более 10 лет компания CubePath использовала WHMCS для управления заказами и выставлением счетов. Этот инструмент хорошо служил тысячам хостинговых компаний, и CubePath он тоже хорошо себя зарекомендовал на начальном этапе. Но по мере того, как платформа разрослась до более чем 500 серверов в Испании, Хьюстоне, Майами и Амстердаме в сети со скоростью 5 Тбит/с, ограничения стали невыносимыми.

WHMCS создан для традиционных реселлеров хостинга. CubePath требовалось мгновенное развертывание, публичный API, инструменты командной строки, поддержка Terraform и реальный контроль над сетью, безопасностью и инфраструктурой. Ничего из этого не поместилось в WHMCS.

Поэтому вместо того, чтобы подстраиваться под чужую систему, CubePath разработала собственную панель с нуля. В этой статье рассказывается о том, что делает новая панель и зачем она нужна.

Что изменилось и почему?
Раньше система работала так: WHMCS обрабатывала заказы и выставление счетов, а всё остальное было интегрировано с помощью пользовательских решений. Добавление нового продукта означало создание моста между WHMCS и фактической инфраструктурой. Каждая новая функция требовала обхода предположений WHMCS о том, как должен работать хостинг.

Новая панель управления ориентирована на API. Все продукты — VPS, физические серверы, балансировщики нагрузки, DNS, частные сети, CDN — работают через один и тот же API. Панель является клиентом этого API, как CubeCLI или конфигурация Terraform. Отдельной системы выставления счетов нет. Всё работает на одной платформе.

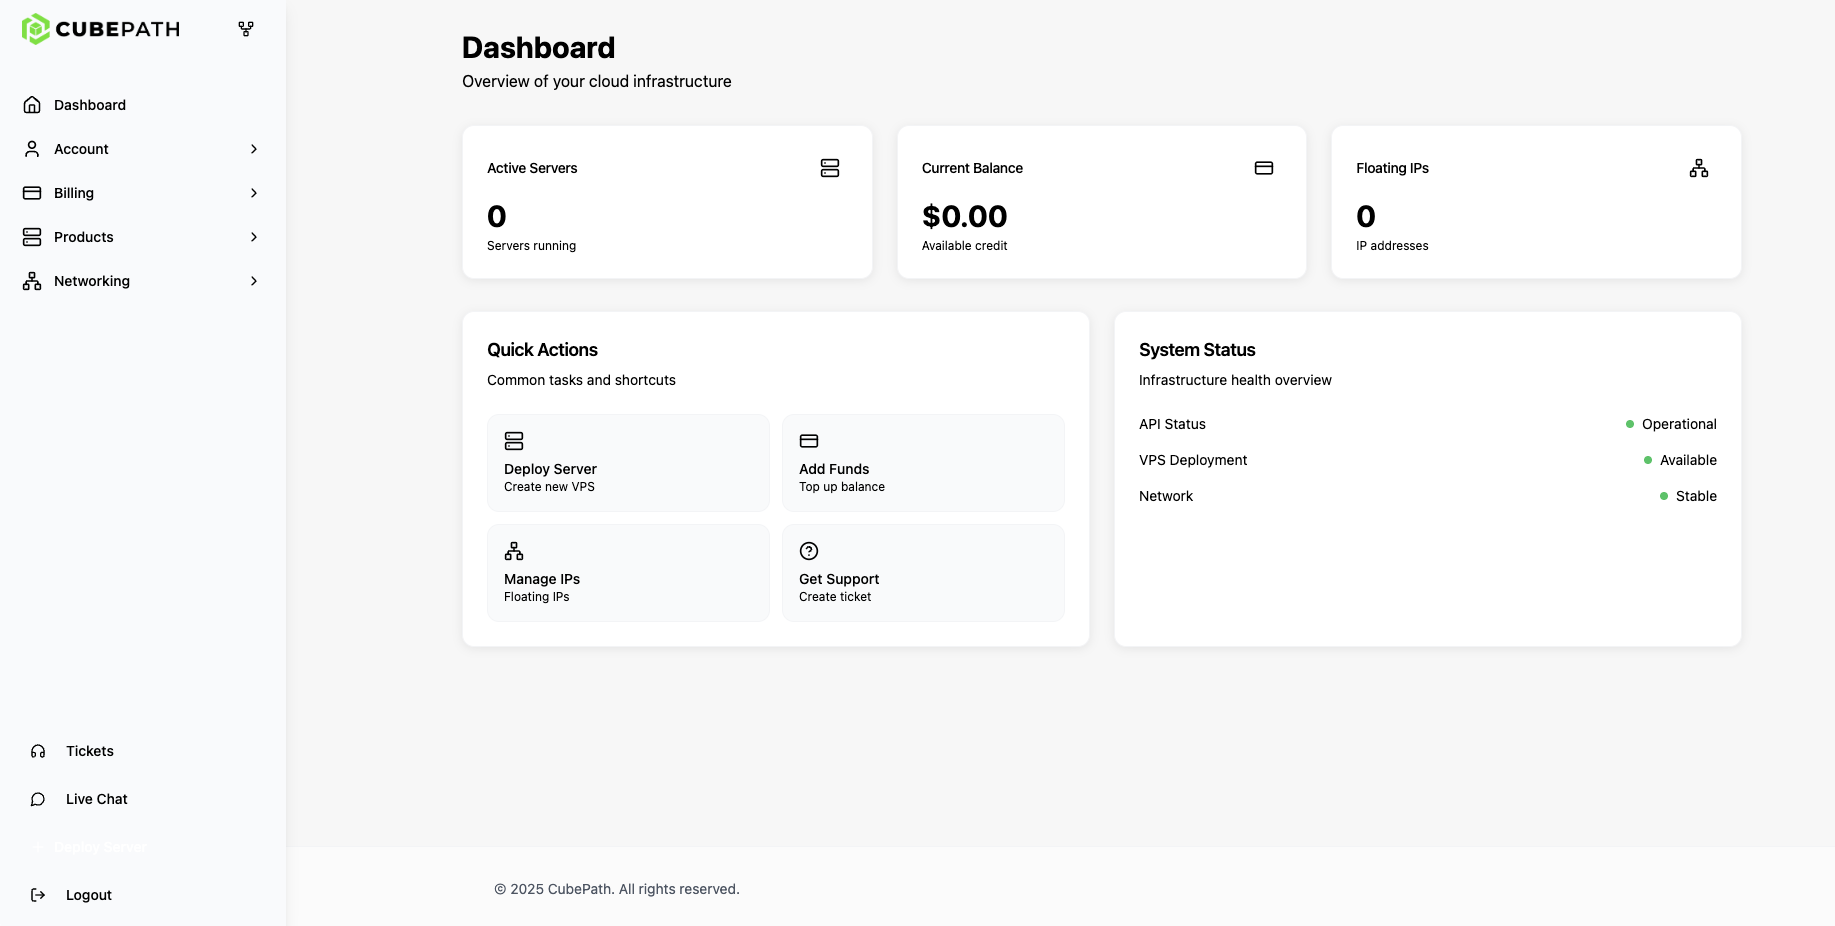
Панель

Панель управления разработана для быстрой и функциональной работы. Никаких лишних элементов, никаких рекламных баннеров внутри панели, никаких десятишаговых мастеров развертывания сервера. Интерфейс чистый, отзывчивый и создан для команд, которые ежедневно управляют инфраструктурой.

От участников дискуссии:
  • Разверните VPS за считанные секунды с почасовой оплатой от 0,007 доллара в час.
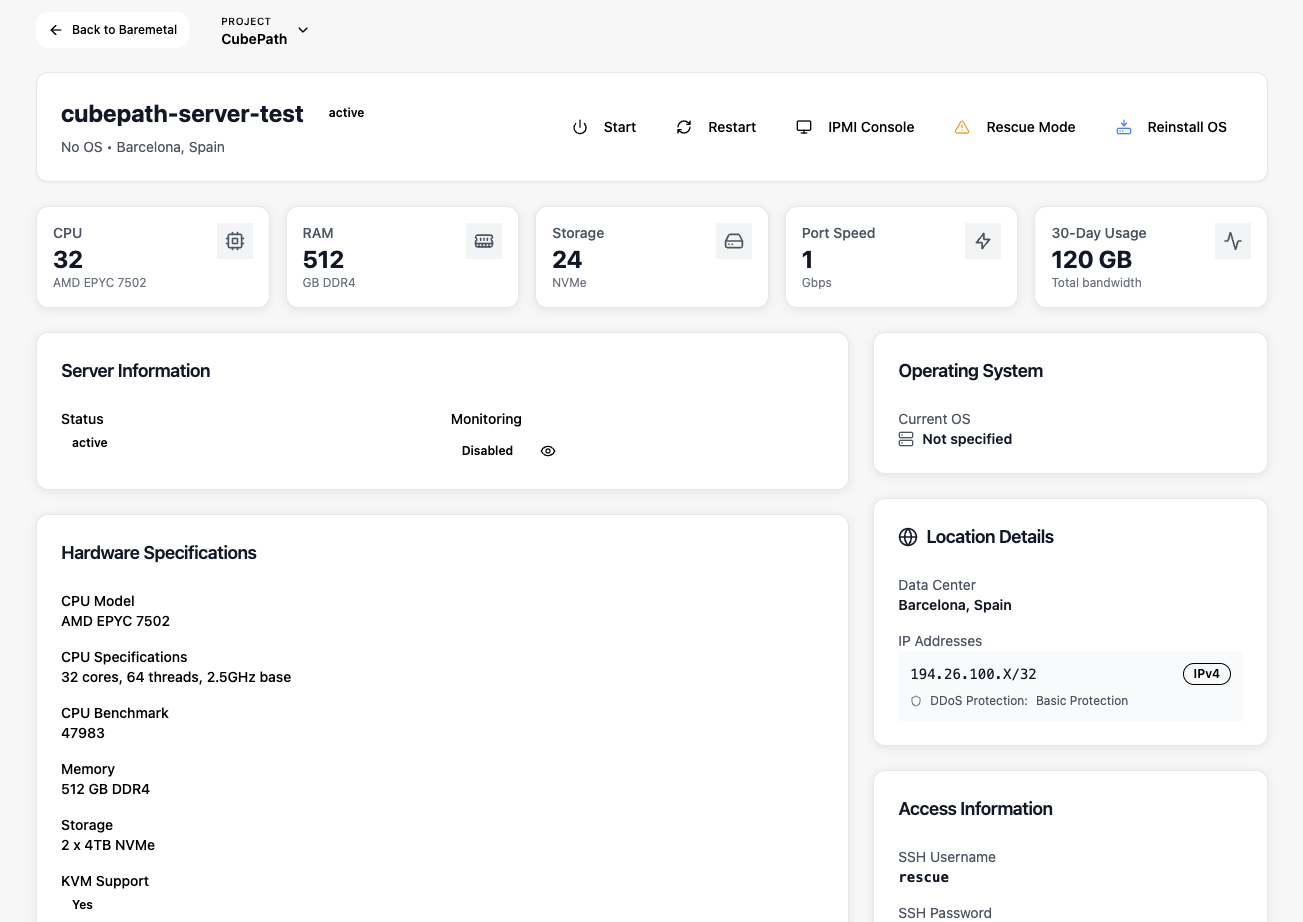
  • Управляйте физическими серверами, VPS, сетью и DNS из одного места.
  • Получите доступ ко всем функциям, не переключаясь между различными инструментами или поставщиками.

Управление всей инфраструктурой в одном месте.
Независимо от того, работает ли рабочая нагрузка на физическом сервере или на VPS, панель управления позволяет управлять обоими вариантами из единого интерфейса. Никаких внешних инструментов, никакого переключения контекста между провайдерами.


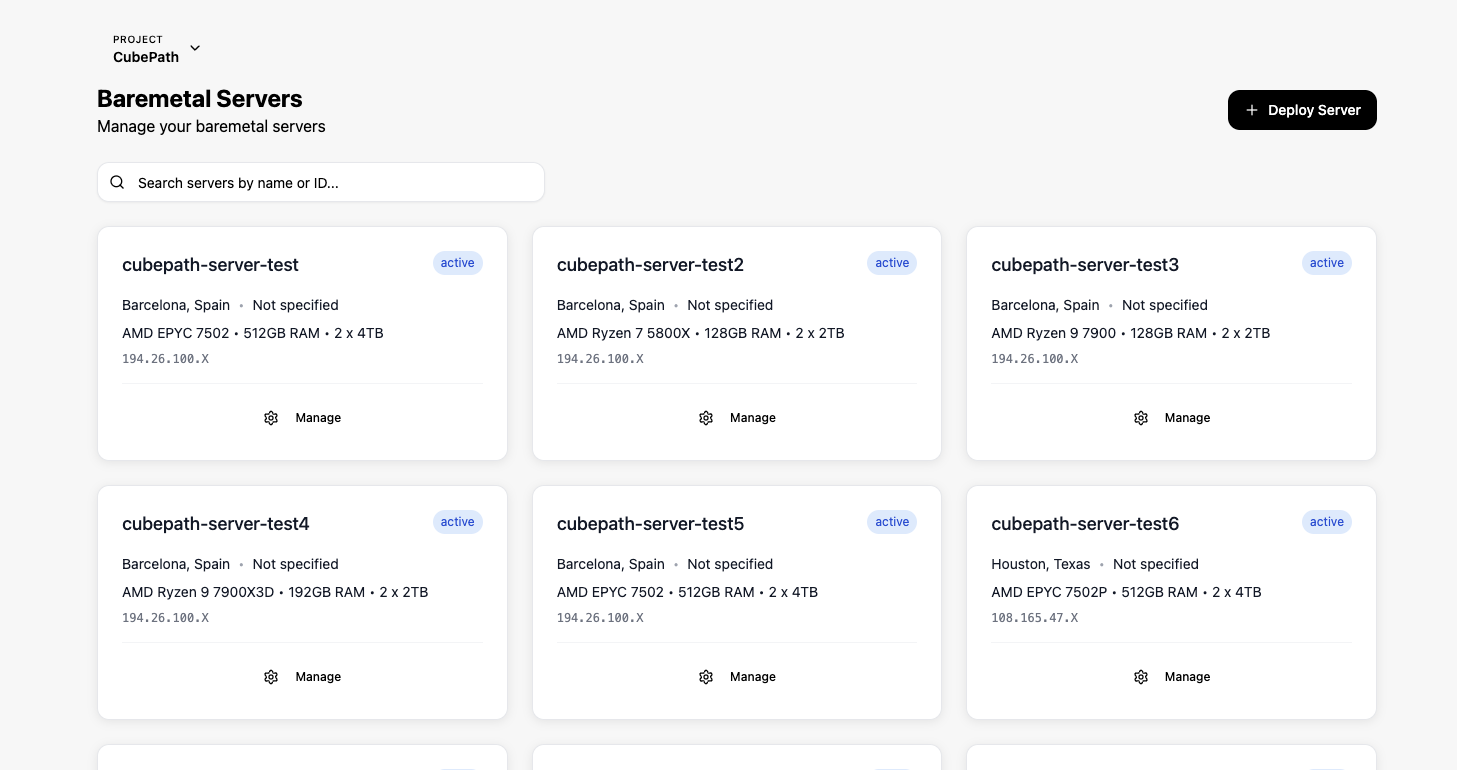
Всё организовано по проектам. Каждый проект объединяет свои серверы, сети и ресурсы. С любого сервера:
  • Просмотрите все активные серверы с указанием их характеристик, местоположения и назначенных IP-адресов.
  • Переустановите операционную систему на VPS и физическом сервере одним щелчком мыши.
  • Получите доступ к консоли IPMI для серверов без операционной системы.
  • Включайте, выключайте или перезапускайте любой сервер удаленно.
  • Управление частными сетями, плавающими IP-адресами и правилами брандмауэра.


Безопасность и защита от DDoS-атак
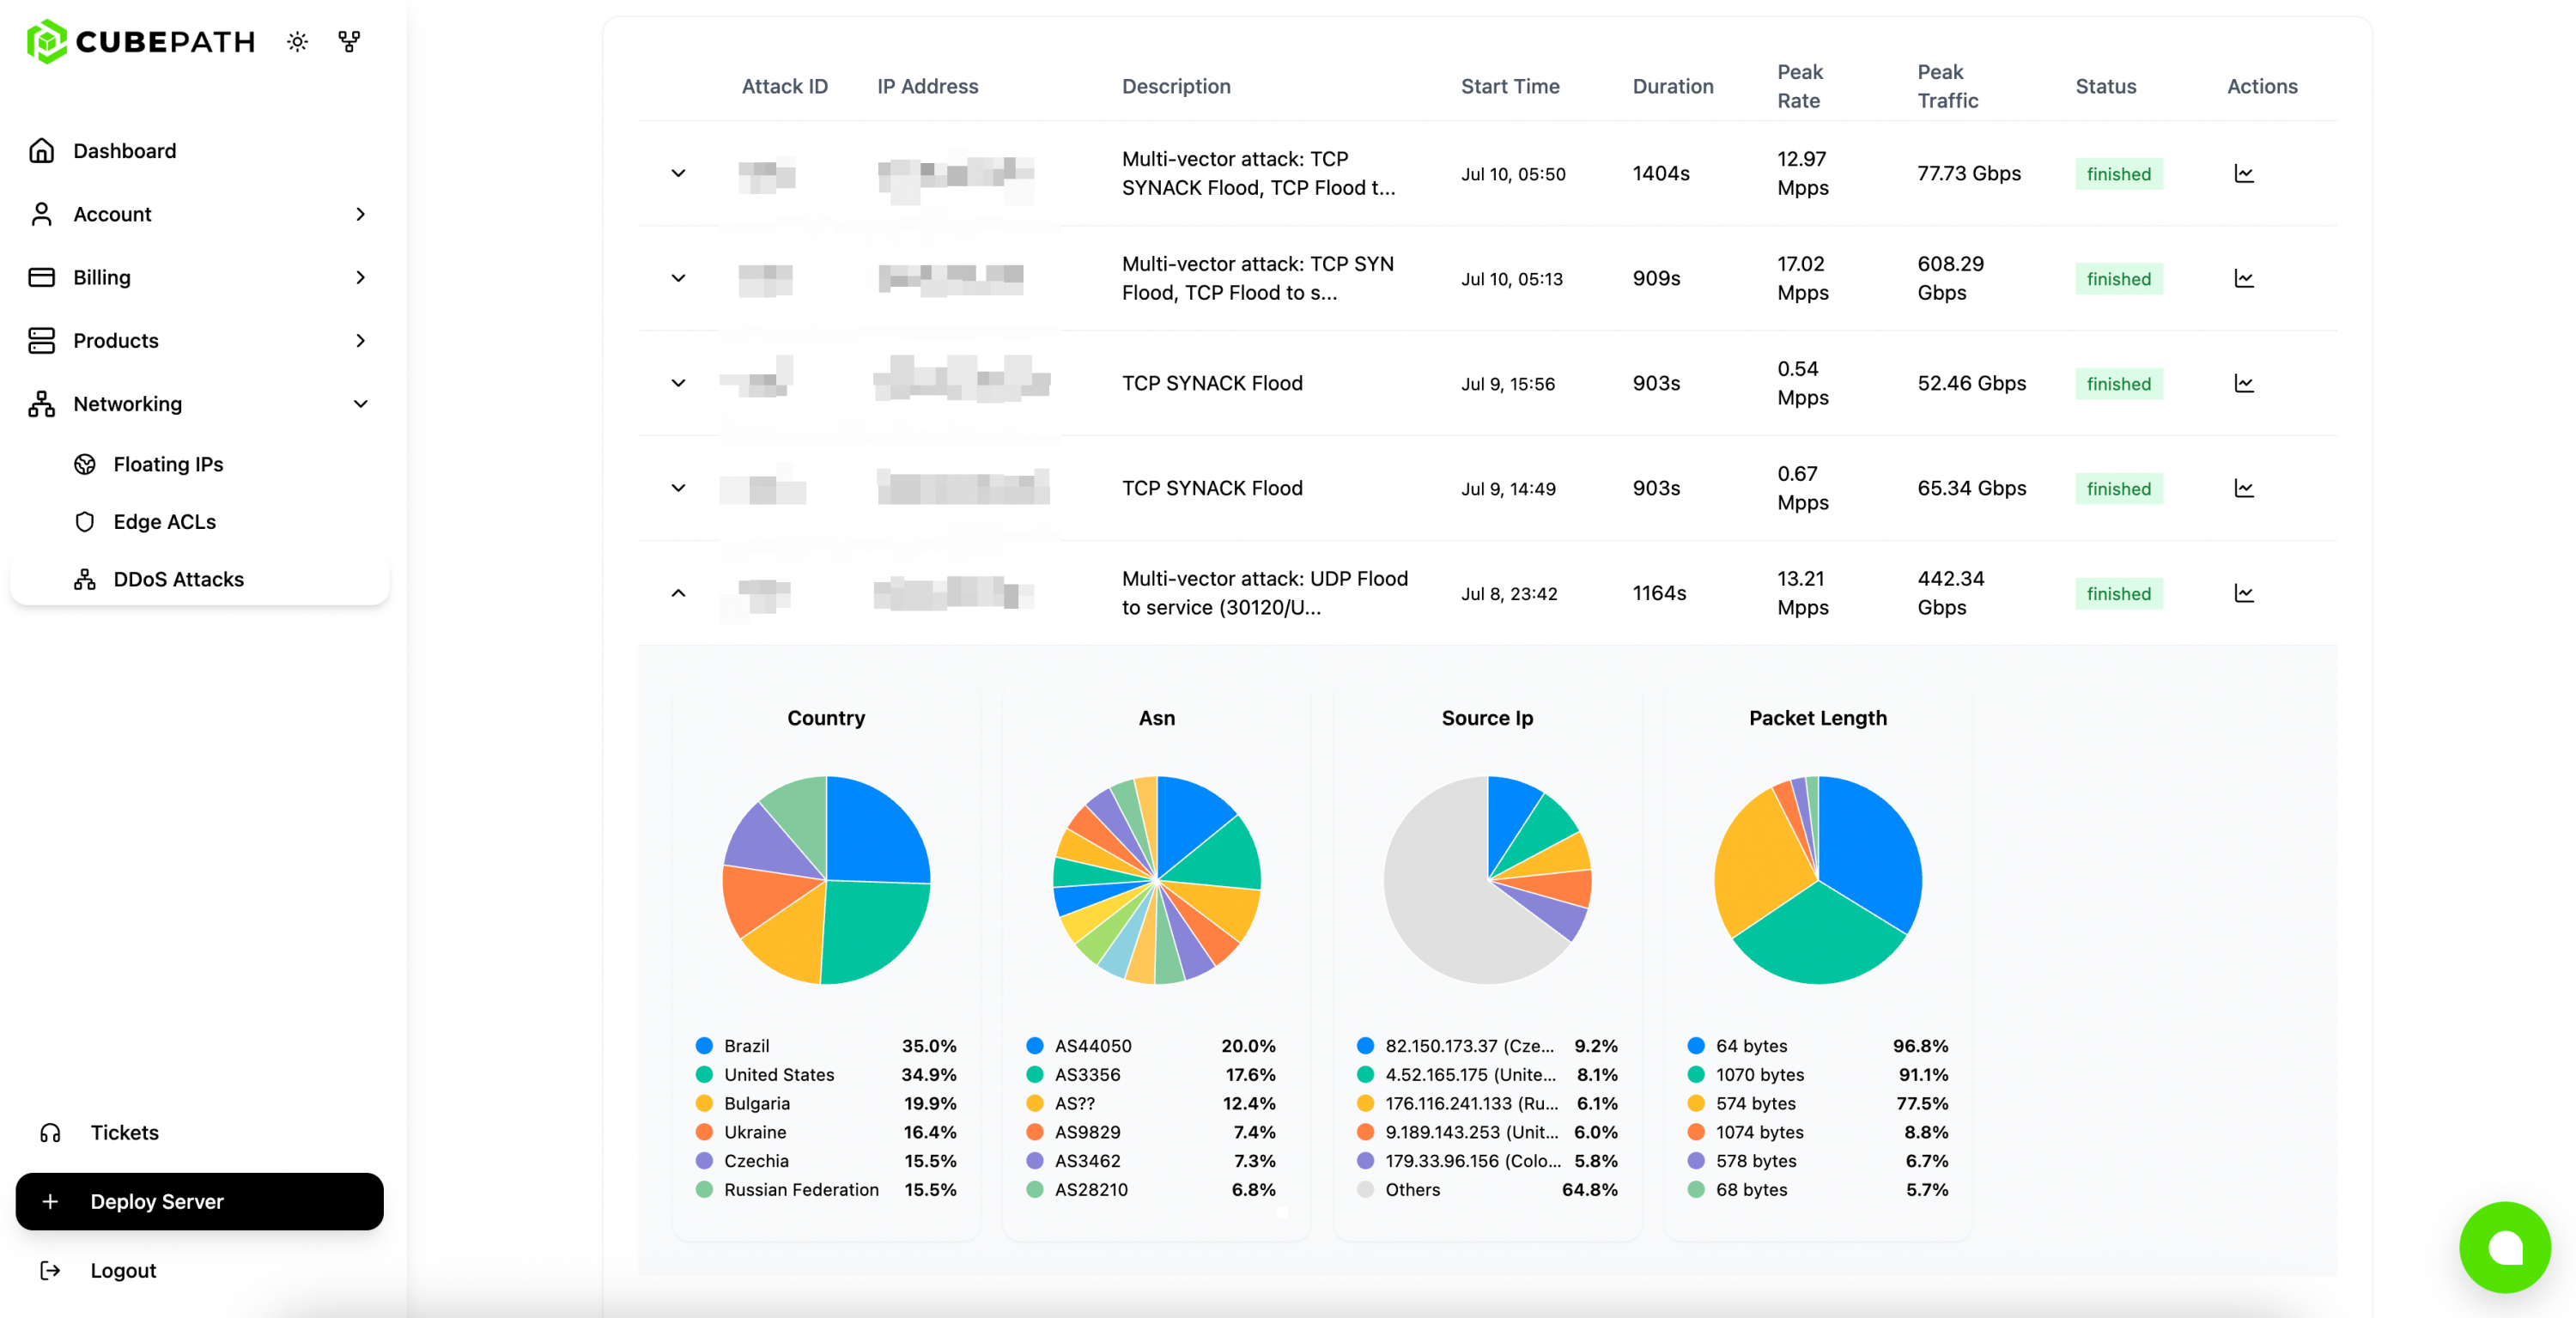
Защита от DDoS-атак в CubePath встроена в сеть и активна для каждого сервиса. Панель управления позволяет отслеживать работу системы защиты:

Списки контроля доступа (ACL) на периферии сети. Управляйте входящим трафиком к серверам из панели. Разрешайте или блокируйте определенные IP-адреса, порты и протоколы, не изменяя iptables или nftables на самом сервере. Правила применяются на сетевом уровне до того, как трафик достигнет экземпляра.

Метрики атак. Вы можете точно увидеть, когда произошли атаки, насколько они были масштабными, откуда они исходили и как были нейтрализованы. Эти данные доступны для каждого сервера, что обеспечивает четкое представление об угрозах для каждой службы.


CubeCLI и API
Панель предназначена для визуального управления, но все её функции также доступны программно.

API CubePath. Полностью документированный REST API доступен по адресу api.cubepath.com/docs. Каждому действию на панели соответствует конечная точка API. Создавайте пользовательские интеграции, автоматизируйте предоставление ресурсов или интегрируйте CubePath в существующие рабочие процессы.

CubeCLI. Официальный инструмент командной строки для управления инфраструктурой CubePath из терминала. Проект с открытым исходным кодом, доступен на GitHub по адресу github.com/CubePathInc/cubecli
  • cubecli vps create
  • cubecli vps list
  • cubecli baremetal deploy
  • cubecli lb create
  • cubecli network create

Провайдер Terraform. Определяйте инфраструктуру CubePath как код, версионируйте ее в Git и применяйте изменения с помощью стандартных рабочих процессов Terraform.

Для команд, автоматизирующих свою инфраструктуру, панель управления используется для мониторинга и отладки. API, CLI и Terraform используются для сборки и развертывания приложений.

Доступно сейчас
Новая панель управления доступна по адресу my.cubepath.com. Существующие клиенты были автоматически перенесены.

Что доступно с первого дня:
  • Полное управление VPS и физическими серверами.
  • Почасовая оплата для всех VPS-серверов.
  • Документированный REST API и CubeCLI
  • Частные сети, плавающие IP-адреса, DNS, балансировщики нагрузки
  • Списки контроля доступа на периферии сети и метрики DDoS-атак
  • Торговая площадка с развертыванием приложений в один клик.
  • Облачные оповещения с уведомлениями в Slack и по электронной почте.
cubepath.com
my.cubepath.com/register