Меня зовут Рене, я сетевой инженер в FirstVDS.
В прошлой статье я рассказывал, как мы переезжали из euNetworks в QupraDC и почему даже маленькую площадку полезно строить как нормальную фабрику, а не как одну большую коробку на всё.
Сначала я не планировал писать отдельную статью про второй переезд. Со стороны всё выглядело слишком похоже: снова Amsterdam, снова EVPN/VXLAN-фабрика, снова временная связность между дата-центрами и постепенный перенос серверов. Казалось, что получится пересказ той же истории другими названиями площадок.
Но повод был уже другим. В мае–июле 2026 года в Qupra DC2 произошла серия отказов системы охлаждения: оборудование уходило в аппаратную защиту от перегрева, а локация получала многочасовую недоступность. Аномальная жара стала триггером, но не единственной причиной нашего переезда: единичный сбой превратился в целый каскад проблем, которые вскрыли инженерные и эксплуатационные просчёты площадки. После этого ждать гарантий или доработок со стороны дата-центра мы не считали надёжным планом. Решение было простым и неприятным: надо переезжать в другой ДЦ. После оценки доступных вариантов, сроков, рисков и возможности сохранить текущую сетевую модель мы выбрали NorthC — в текущих условиях новая площадка полностью отвечала нашим требованиям к надёжности, инженерии и эксплуатации.
Задача была не просто перевезти железо из одной стойки в другую. Нужно было сохранить текущие IP-адреса, не заставлять клиентов менять DNS-настройки и выполнить миграцию с минимальным воздействием на сервисы. Внутренний дедлайн тоже был жёстким: успеть до начала горячего для нас эксплуатационного сезона (нового учебного года). Чем дольше мы оставались на площадке с незакрытым риском охлаждения, тем выше была вероятность получить не контролируемую миграцию, а ещё один инцидент.
Именно в процессе подготовки стало понятно, что это всё-таки отдельная история. В первом переезде у нас не было такого набора ограничений: временный Leaf упёрся в 48 портов, постоянный Leaf пришлось освобождать через перекоммутацию оставшихся серверов, Spine нельзя было просто выключить и увезти, а прямую Leaf-to-Leaf связность после переезда мы решили оставить как аварийный путь.
Ниже — не повтор статьи про euNetworks → QupraDC, а разбор второго переезда: как мы готовили NorthC, как использовали подменный leaf3, как пережили нехватку портов, как перевезли spine1 без потери EVPN-сигнализации и почему временная перемычка между Leaf в итоге стала частью аварийного сценария.
Исходное состояние и план переезда
Перед новым переездом площадка уже была построена как EVPN/VXLAN-фабрика. У нас были Leaf-коммутаторы, Spine, routed host networking для гипервизоров, BGP-анонсы VM-префиксов и внешний транзит, разнесённый по Leaf.
То есть мы уже не начинали с нуля. Это была не временная сеть, которую нужно было сначала переделать, а рабочая фабрика, которую надо было физически перенести из одного дата-центра в другой.
Базовая идея осталась прежней:
- поставить новый Leaf в NorthC;
- временно включить его в существующую фабрику;
- постепенно переносить серверы;
- сохранить клиентскую адресацию;
- не останавливать сервис;
- после завершения миграции вернуть временное оборудование поставщику.
Перед началом переезда сперва нужно было подготовить площадку на стороне поставщика. Это важная часть, потому что без неё вся красивая миграционная схема осталась бы только схемой. Мы запросили:
- подменное железо на время миграции — L3-коммутатор класса Leaf с 48 портами доступа и 6 портами QSFP28, тот самый будущий leaf3;
- два L2 40G-канала между QupraDC и NorthC;
- два L3 100G-канала в Интернет для внешней связности уже из нового дата-центра;
- management-подключение для управления подменным коммутатором;
- отдельные management-подключения для постоянных коммутаторов после их физического переезда в NorthC.
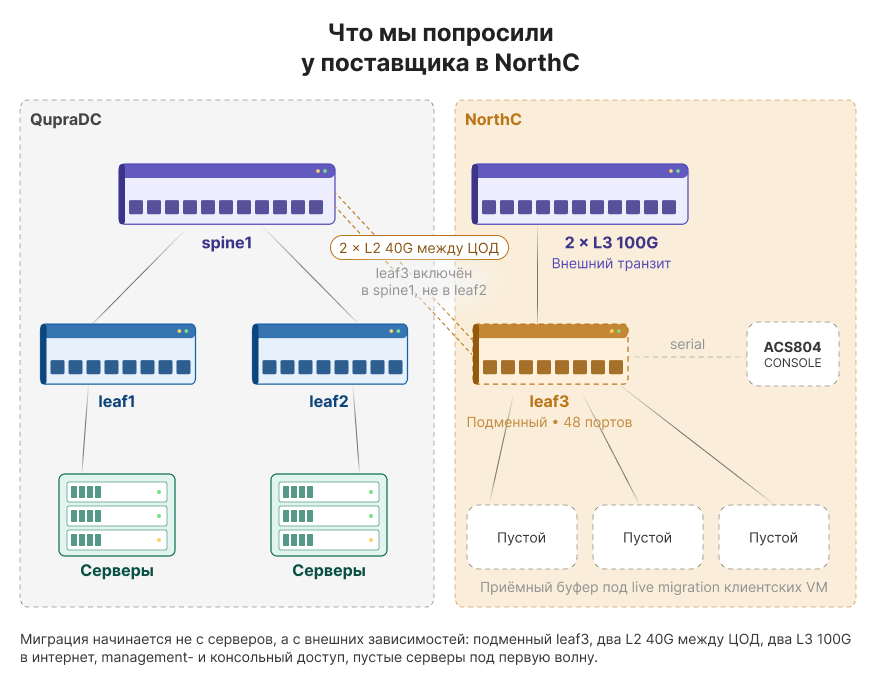
Здесь важно не перепутать назначение каналов. L2 40G между дата-центрами был нужен не для растягивания клиентских VLAN и не для построения большого L2-домена между площадками. Это был временный транспорт, поверх которого мы могли поднять свою IP-связность и включить новый Leaf в существующую фабрику. А два L3 100G-канала в Интернет были нужны для того, чтобы новая площадка получила внешнюю связность до завершения всего физического переезда.
Только после того как поставщик реализовал эти условия, мы начали саму миграцию. В таких работах нельзя сначала перевезти железо, а потом внезапно выяснить, что нет out-of-band управления, не готовы междатацентровые каналы или внешняя связность в новом ЦОД существует только на схеме.
После выполнения требований поставщиком я попросил смонтировать в NorthC несколько новых пустых серверов под живую миграцию клиентских виртуальных машин. Это был приёмный буфер для первой волны: туда можно было переносить VM до того, как в новый дата-центр физически переедет основная масса существующих гипервизоров.
Отдельная бытовая, но важная деталь — первичная настройка подменного коммутатора. Leaf3 приехал без нашей конфигурации, а значит, его сначала нужно было как-то настроить до появления нормального management-доступа через продакшен-сеть. Для этого я использовал наш старый Vertiv Avocent ACS804, который мы заранее сняли из QupraDC. Консольный сервер в таких работах — не роскошь, а страховка от ситуации, когда коробка стоит в другой стране с пустым конфигом, OOBM ещё не настроен, а единственный способ поговорить с ней — serial console.
Задача leaf3 была простой: стать временным Leaf в новой локации и дать нам возможность начать перенос серверов до того, как туда переедет всё основное сетевое оборудование.
Первая волна: leaf3 в NorthC и миграция до упора в порты
Leaf3 физически установили в NorthC и временно включили в существующую фабрику. С точки зрения сети он стал ещё одним Leaf-коммутатором, только расположенным в новом дата-центре.
Как и в прошлой миграции, нам была важна не магия конкретного канала между площадками, а его свойства: нормальная IP-связность underlay, достаточный MTU, стабильность и возможность использовать канал как временный транспорт для overlay. Временная связность нужна была для того, чтобы Leaf в новой локации мог стать участником существующей IP-фабрики.
После включения leaf3 мы начали переносить серверы в NorthC партиями. Модель подключения гипервизоров не менялась: серверы по-прежнему работали в routed-модели, VM-префиксы продолжали анонсироваться через BGP, а достижимость внутри фабрики обеспечивалась через EVPN/VXLAN.
Но быстро проявилось ограничение, которого в первой миграции не было в таком виде: портовая ёмкость.
На временном Leaf было 48 портов доступа. При нашей схеме подключения один такой коммутатор физически не мог принять всю площадку целиком. Портовая ёмкость закончилась раньше, чем закончились серверы.
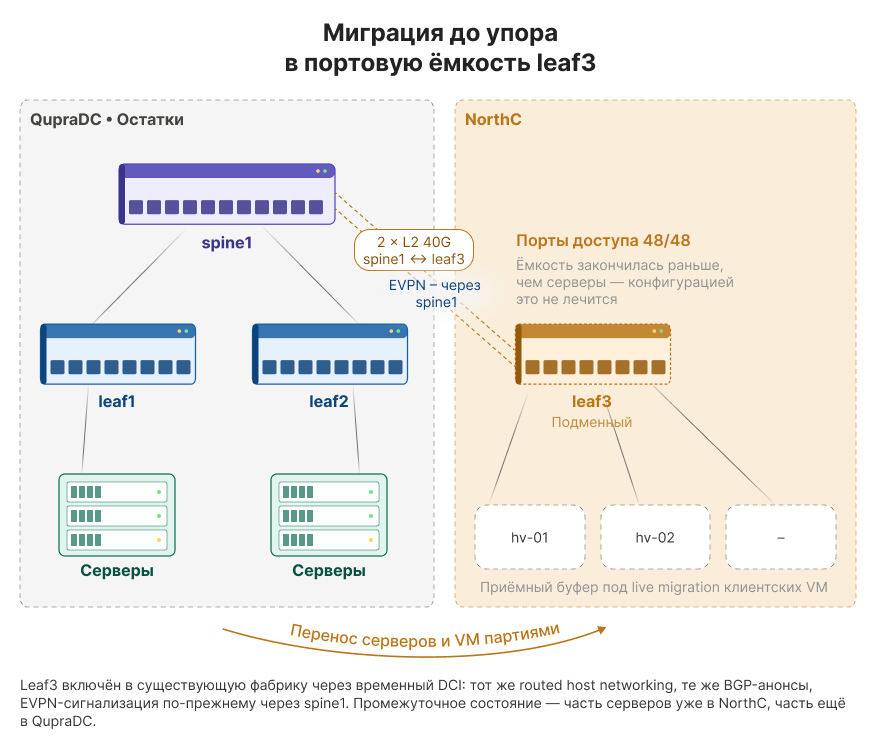
Поэтому мы мигрировали до тех пор, пока на leaf3 не закончились свободные порты. Это было нормальное промежуточное состояние: часть серверов уже работала в NorthC через leaf3, часть оставалась в QupraDC на старых Leaf-коммутаторах, а фабрика продолжала жить как единая система.
В таких миграциях важно не пытаться прыгнуть дальше, чем позволяет физика или бюджет. Если портов не хватает и их нельзя «донастроить» конфигурацией — нужно менять план коммутации.
Освобождаем leaf1 и продолжаем переезд
Чтобы продолжить перенос, нам нужно было получить ещё один Leaf в NorthC. Покупать новый постоянный коммутатор под эту задачу не хотелось, а leaf3 был временным и должен был вернуться поставщику. Поэтому мы пошли другим путём: освободили один из действующих Leaf-коммутаторов.
На тот момент часть серверов ещё оставалась в QupraDC. Мы перекоммутировали оставшиеся подключения так, чтобы освободить leaf1: все порты серверов, которые ещё оставались в старой локации, временно собрали на leaf2. Leaf2 продолжал работать в QupraDC и держал оставшуюся часть нагрузки. Это стало возможным за счёт того, что часть серверов с leaf1 и leaf2 уже переехала в NorthC на leaf3, освободив достаточное количество портов на leaf2, чтобы принять оставшуюся нагрузку.
Это не было целевым отказоустойчивым состоянием. Но для короткого этапа миграции такая схема была приемлема: мы понимали, зачем её делаем, какие у неё ограничения и когда должны из неё выйти.
После освобождения leaf1 мы физически перевезли его в NorthC и включили в фабрику уже в новой локации. В NorthC у нас появились два Leaf-коммутатора: временный leaf3 и постоянный leaf1. Это дало дополнительную портовую ёмкость и позволило завершить перенос оставшейся серверной нагрузки.
В итоге серверная нагрузка переехала в NorthC, но оставалась следующая важная проблема: как перевезти Spine.
Самая неприятная часть: как перевезти Spine и не порвать overlay
Если Leaf-коммутаторы уже находятся в NorthC, а Spine всё ещё остаётся в QupraDC, фабрика продолжает работать за счёт временной междатацентровой связности. Но Spine нельзя просто выключить и перевезти, если Leaf-коммутаторы в новой локации используют его как точку обмена маршрутной и EVPN-информацией.
Проблема была в следующем: если выключить spine1 без подготовки, leaf1 и leaf3 потеряют через него маршруты друг друга. А это уже риск для overlay-сервисов и для клиентского трафика.
Нам нужно было сделать так, чтобы Leaf-коммутаторы в NorthC продолжали видеть loopback-адреса друг друга и обмениваться EVPN-информацией даже в момент, когда spine1 физически выключен и едет из одного дата-центра в другой.
Решение получилось простым и достаточно красивым: мы соединили leaf1 и leaf3 напрямую 100G DAC-кабелем.
Но одного физического кабеля оказалось недостаточно. Нужно было временно построить маленький underlay между этими двумя Leaf-коммутаторами и дать overlay нормальную достижимость.
Для underlay между leaf1 и leaf3 мы использовали ISIS (протокол маршрутизации). Его задача была не заменить всю фабрику, а решить конкретную временную задачу: просигнализировать loopback-адреса Leaf-коммутаторов и обеспечить IP-достижимость, поверх которой можно продолжить работу overlay.
После этого между Leaf-коммутаторами была настроена BGP-сигнализация для EVPN. Иными словами, мы дали leaf1 и leaf3 возможность обмениваться EVPN-информацией напрямую, минуя spine1 на время его физического переезда.
С точки зрения логики это был временный обходной путь:
- физически leaf1 и leaf3 соединены прямым 100G DAC;
- underlay-достижимость loopback-адресов обеспечивается через ISIS;
- overlay продолжает работать через EVPN;
- Leaf-коммутаторы видят необходимые префиксы друг друга;
- spine1 можно выключить и перевезти без потери клиентского сервиса.
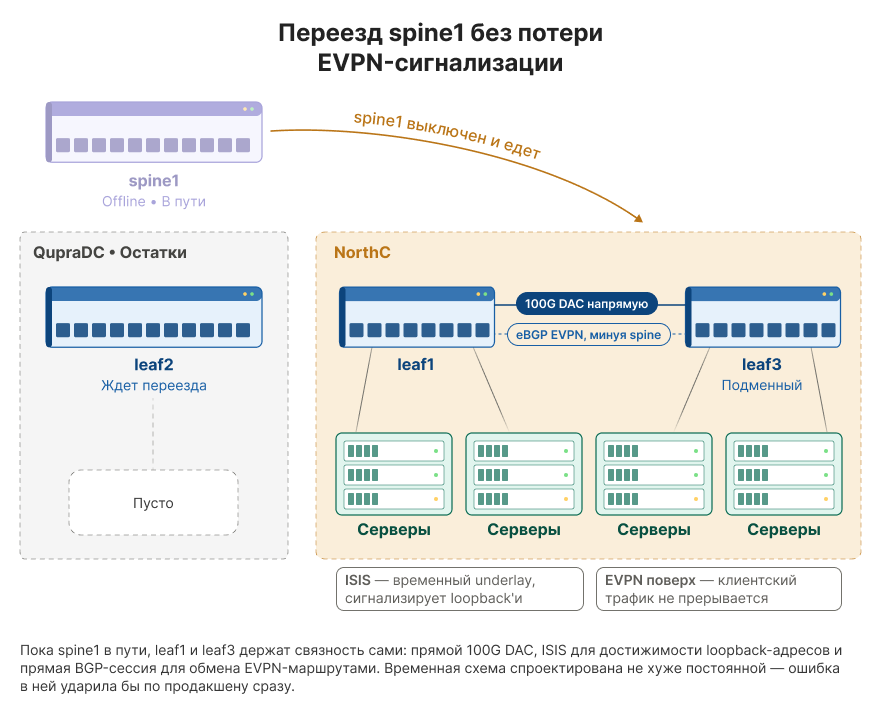
Это как раз тот случай, когда временная схема должна быть спроектирована не хуже постоянной. Она нужна на короткое время, но ошибка в ней может ударить по продакшену сразу.
После проверки прямой связности, ISIS-соседства, loopback reachability и EVPN-обмена мы перевезли spine1 в NorthC. Клиентский трафик при этом не пострадал: Leaf-коммутаторы на новой площадке продолжили видеть друг друга через временную прямую связку.
После переезда Spine мы решили не убирать саму идею прямой Leaf-to-Leaf связности полностью. Временная перемычка показала себя полезной как аварийный сценарий на случай проблем с единственным Spine, поэтому в целевой схеме между постоянными Leaf-коммутаторами мы оставили прямой 100G DAC-линк.
Но оставлять его как равноправный рабочий путь не хотелось. В нормальном состоянии overlay-сигнализация должна идти через Spine, а прямой линк между Leaf должен оставаться резервным вариантом, не превращаясь в скрытую альтернативную магистраль. Поэтому мы сделали два предохранителя: один на уровне overlay, второй на уровне underlay.
На уровне overlay на каждом Leaf в экспортной политике мы добавили трёхкратный AS-PATH prepend с собственной AS — искусственно увеличив длину AS-PATH. EVPN-маршруты, полученные через прямую Leaf-to-Leaf BGP-сессию, становятся менее предпочтительными по AS-PATH. Пока BGP-сигнализация overlay нормально работает через spine1, маршруты через прямую Leaf-to-Leaf сессию не выбираются как основные.
На уровне underlay мы тоже не хотели, чтобы прямой линк случайно стал приоритетным путём при исправном Spine. Поэтому ISIS на этой перемычке был настроен как локальный L1 с выставленным route preference 171. То есть такой underlay-путь заведомо менее предпочтителен, чем любой путь через eBGP в основной фабрике.
В результате прямой 100G DAC между Leaf не нагружает обычный трафик при исправном spine1. Он вступает в работу только тогда, когда ломается основной путь: пропадает нормальная BGP-сигнализация overlay через Spine и вместе с ней основной underlay-путь до loopback-адресов. Получается не постоянный обход Spine, а аварийная страховка от его отказа.
Возвращаем временный Leaf поставщику
После переезда spine1 в NorthC у нас в новой локации оказалось больше сетевого оборудования, чем нужно для целевого состояния. Временный leaf3 выполнил свою задачу: он дал нам возможность начать миграцию, пережить нехватку портов и сохранить управляемость переезда. Но по условиям проекта его нужно было вернуть поставщику.
Leaf3 нельзя было оставлять по принципу «пусть пока постоит». Основная проблема была не только в том, что в схеме оставался временный коммутатор и связанный с ним технический долг. Более критичным фактором были операционные расходы: временное железо быстро превращается в постоянный OPEX и начинает ежемесячно увеличивать стоимость эксплуатации, хотя в целевой архитектуре оно уже не требуется.
Поэтому возврат leaf3 поставщику был не формальностью, а полноценным этапом миграции. К этому моменту в NorthC уже можно было собрать целевую схему на постоянных Leaf-коммутаторах, поэтому мы начали обратную перекоммутацию: переносили серверные подключения с leaf3 на leaf1 и leaf2.
Как мы перекоммутировали серверные линк-и без остановки VM
Отдельно стоит рассказать, как именно мы переключали серверы с временного leaf3 на постоянные leaf1 и leaf2. Со стороны это выглядит как простая физическая перекоммутация: был линк в leaf3, стал линк в leaf1 или leaf2. Но если сделать это грубо, можно получить потери трафика или неочевидную асимметрию маршрутизации.
Мы делали переключение шагающим способом. Сначала административно гасили нужный интерфейс на leaf3. После этого для сервера линк переходил в состояние down, а связанный с ним next-hop исчезал из RIB/FIB. Для исходящего трафика это было ключевым моментом: сервер больше не пытался отправлять пакеты через уже выключенный путь, а оставшийся живой next-hop продолжал использоваться как рабочий путь в ECMP-группе.
После этого физический линк можно было переносить на новый Leaf. Когда порт поднимался уже на leaf1 или leaf2, появлялась новая связность, маршруты возвращались в таблицу, и сервер снова получал несколько рабочих путей. Затем мы переходили к следующему линку. То есть мы не выдёргивали всё сразу, а последовательно убирали из работы один путь, дожидались корректного пересчёта forwarding-состояния и только потом двигались дальше.
С входящим трафиком логика была похожей, но работала через BGP-сигнализацию. Достижимость клиентских виртуальных машин была анонсирована через BGP и два route reflector. Когда один из путей становился недоступен, соответствующая сигнализация пропадала, и путь к пересылке уходил на оставшийся живой next-hop. Поскольку порты гасились непосредственно на коммутаторе, событие link down доходило до сетевого стека сразу, без ожидания долгих таймаутов. После этого обновлялись RIB/FIB, и фабрика переставала использовать нерабочий путь.
В результате физическая перекоммутация серверов не требовала остановки клиентских VM. Мы не переносили риск на уровень виртуальных машин, а управляли им на уровне линков, next-hop'ов и BGP-сигнализации. Каждый шаг был маленьким: погасили один порт, убедились, что трафик ушёл на живой путь, перенесли линк, проверили восстановление связности и только после этого переходили к следующему.
После перекоммутации серверов на leaf1 и leaf2 мы вывели leaf3 из фабрики, проверили, что на нём не осталось клиентской и сервисной нагрузки, и вернули коммутатор поставщику.
В целевом состоянии площадка в NorthC снова осталась на постоянной архитектуре:
- серверы подключены к leaf1 и leaf2;
- spine1 находится в новой локации;
- временный leaf3 выведен из эксплуатации;
- между постоянными Leaf оставлена прямая 100G-связность как резервный путь для EVPN и underlay-достижимости;
- клиентская адресация сохранена;
- overlay/underlay-модель не менялась;
- миграция выполнена без остановки сервиса.
Что получилось в итоге
Этот переезд был похож на предыдущий только на верхнем уровне: добавить Leaf в новой локации, перенести серверы, перевезти старое оборудование, разобрать временные связи. На практике он оказался интереснее из-за портовой ёмкости и необходимости аккуратно перевезти Spine.
Главное отличие было в том, что нам пришлось мигрировать не просто «из старого ЦОД в новый», а через несколько вынужденных состояний:
- Сначала запросить у поставщика подменный Leaf, два L2 40G-канала между дата-центрами, два L3 100G-канала в Интернет и management-доступ.
- Дождаться готовности этой базовой инфраструктуры.
- Смонтировать несколько пустых серверов под живую миграцию клиентских VM.
- Поднять первичный доступ к подменному Leaf через консольный сервер.
- Затем включить leaf3 как подменный Leaf в NorthC.
- Потом провести миграцию до исчерпания его 48 портов.
- Затем освободить leaf1 за счёт временной концентрации оставшейся нагрузки на leaf2.
- Далее перенести перенос leaf1 в NorthC и завершить серверную миграцию.
- Пробросить прямой 100G DAC между leaf1 и leaf3, ISIS как временный underlay между Leaf-коммутаторами, организовать EVPN-соседство между ними без участия spine1.
- Выполнить физический переезд spine1.
- Шагающая перекоммутация серверных линков с leaf3 на leaf1 и leaf2 через управляемый link down;
- Вернуть leaf3 поставщику.
На бумаге такая последовательность выглядит длинной. В эксплуатации именно это и спасает: каждое состояние можно проверить, отмониторить и откатить или задержаться в нём, если что-то пошло не так.
Мы снова сделали переезд дистанционно из России, используя удалённые руки в дата-центре. Для такой работы критично, чтобы сеть была управляемой фабрикой с понятными ролями устройств, понятной маршрутизацией, понятной телеметрией и доступом к оборудованию вне основной продакшен-сети.
Практические выводы
1.
Миграция начинается не с перетыкания серверов, а с подготовки внешних зависимостей. Резервные коммутаторы, междатацентровые каналы, внешняя связность, management-доступ, консольный доступ и пустые серверы под live migration должны быть готовы до начала работ, иначе контролируемый переезд быстро превращается в импровизацию.
2.
Временный Leaf — нормальный инструмент миграции, если заранее понимать, когда и как он будет выведен из схемы. Временное оборудование не должно незаметно становиться частью постоянной архитектуры.
2.
Портовая ёмкость — это не мелочь. Если у каждого сервера несколько физических подключений, один 48-портовый Leaf очень быстро перестаёт быть достаточным для переезда всей площадки. План миграции должен учитывать не только BGP, EVPN и MTU, но и банальное количество физических портов.
4.
Освобождение постоянного оборудования может быть частью плана. Мы не покупали ещё одну коробку только потому, что временный leaf3 упёрся в 48 портов. Вместо этого мы временно сконцентрировали остаток нагрузки на leaf2, освободили leaf1, перевезли его и продолжили миграцию.
5.
Spine нельзя считать просто «транспортной коробкой», которую можно выключить в любой момент. Если через него Leaf-коммутаторы получают EVPN-информацию друг о друге, его переезд нужно готовить отдельно. В нашем случае прямой 100G DAC между Leaf, ISIS для underlay и EVPN-сигнализация поверх него позволили перевезти spine1 без удара по клиентскому трафику.
6.
Временную аварийную связность иногда имеет смысл оставить, но только если она не становится основным путём. Прямой 100G DAC между Leaf мы оставили как страховку от проблем с единственным Spine, но сделали его менее предпочтительным сразу на двух слоях. В overlay — через eBGP AS-PATH prepend. В underlay — через ISIS с L1 preference 171. В штатном режиме сигнализация и трафик идут через Spine; прямой Leaf-to-Leaf линк нужен только тогда, когда основной путь через Spine перестаёт работать.
7.
Хорошая миграция — это не героическое ночное переключение, а цепочка скучных проверяемых шагов. Чем скучнее каждый отдельный шаг, тем выше шанс, что весь переезд пройдёт без аварии.
Итог простой: IP-фабрика снова позволила нам переехать без остановки сервиса. В первый раз она помогла превратить вынужденный переезд в улучшение архитектуры. Во второй — позволила пережить нехватку портов, временный подменный Leaf и физический переезд Spine, не меняя базовую сетевую модель и не заставляя клиентов участвовать в наших приключениях.
Автор статьи: Рене, сетевой инженер FirstVDS
firstvds.ru