+118.76
Рейтинг

Виталий Никсенкин

Почему мы создали собственную глобальную сеть с использованием BGP Multihoming и Anycast


Большинство хостинг-провайдеров используют один и тот же приём. Они арендуют мощности у более крупной сети, размещают за ней серверы и называют это своей инфраструктурой. Это работает, пока не перестанет работать. Когда у вышестоящего сервера возникают проблемы с маршрутизацией, у вас тоже возникают проблемы с маршрутизацией. Когда их пиринговые соединения перегружаются, это чувствуют ваши клиенты. Вы совершенно не контролируете путь трафика к вашим серверам.
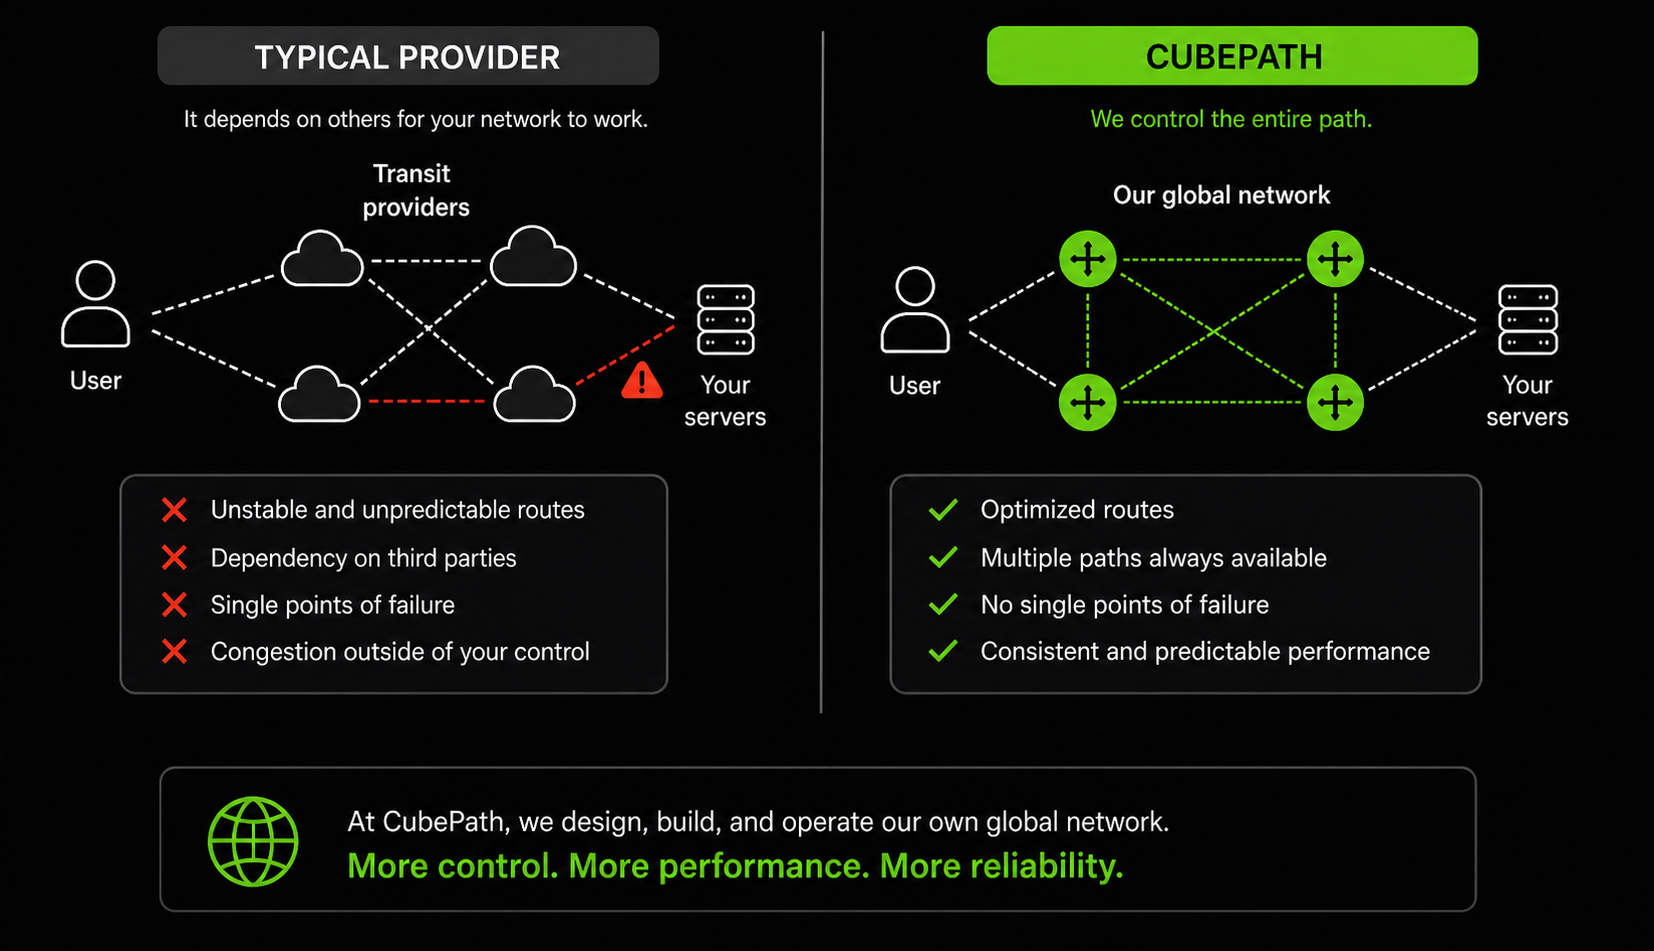


Мы с самого начала решили, что CubePath будет владеть собственной сетью, а не перепродавать чужую. Мы создали глобальную магистраль с точками присутствия в Майами, Хьюстоне, Вирджинии и Испании, используя протокол BGP multihoming с несколькими транзитными провайдерами и возможностью объявлять маршруты через Anycast с любой из наших точек присутствия.

В этом посте объясняется, почему мы сделали эти инвестиции и что это значит для всего, что вы запускаете на CubePath.

Наша сеть: точки присутствия, магистральная сеть и почему местоположение имеет значение.
Компания CubePath управляет точками присутствия в стратегически важных местах по всей Северной и Южной Америке и Европе:
  • Майами для Латинской Америки и Карибского бассейна
  • Хьюстон — центральная часть США и Мексика.
  • Вирджиния используется для перелетов через восточное побережье США и трансатлантических рейсов.
  • Испания для Южной Европы, Средиземноморья и Северной Африки
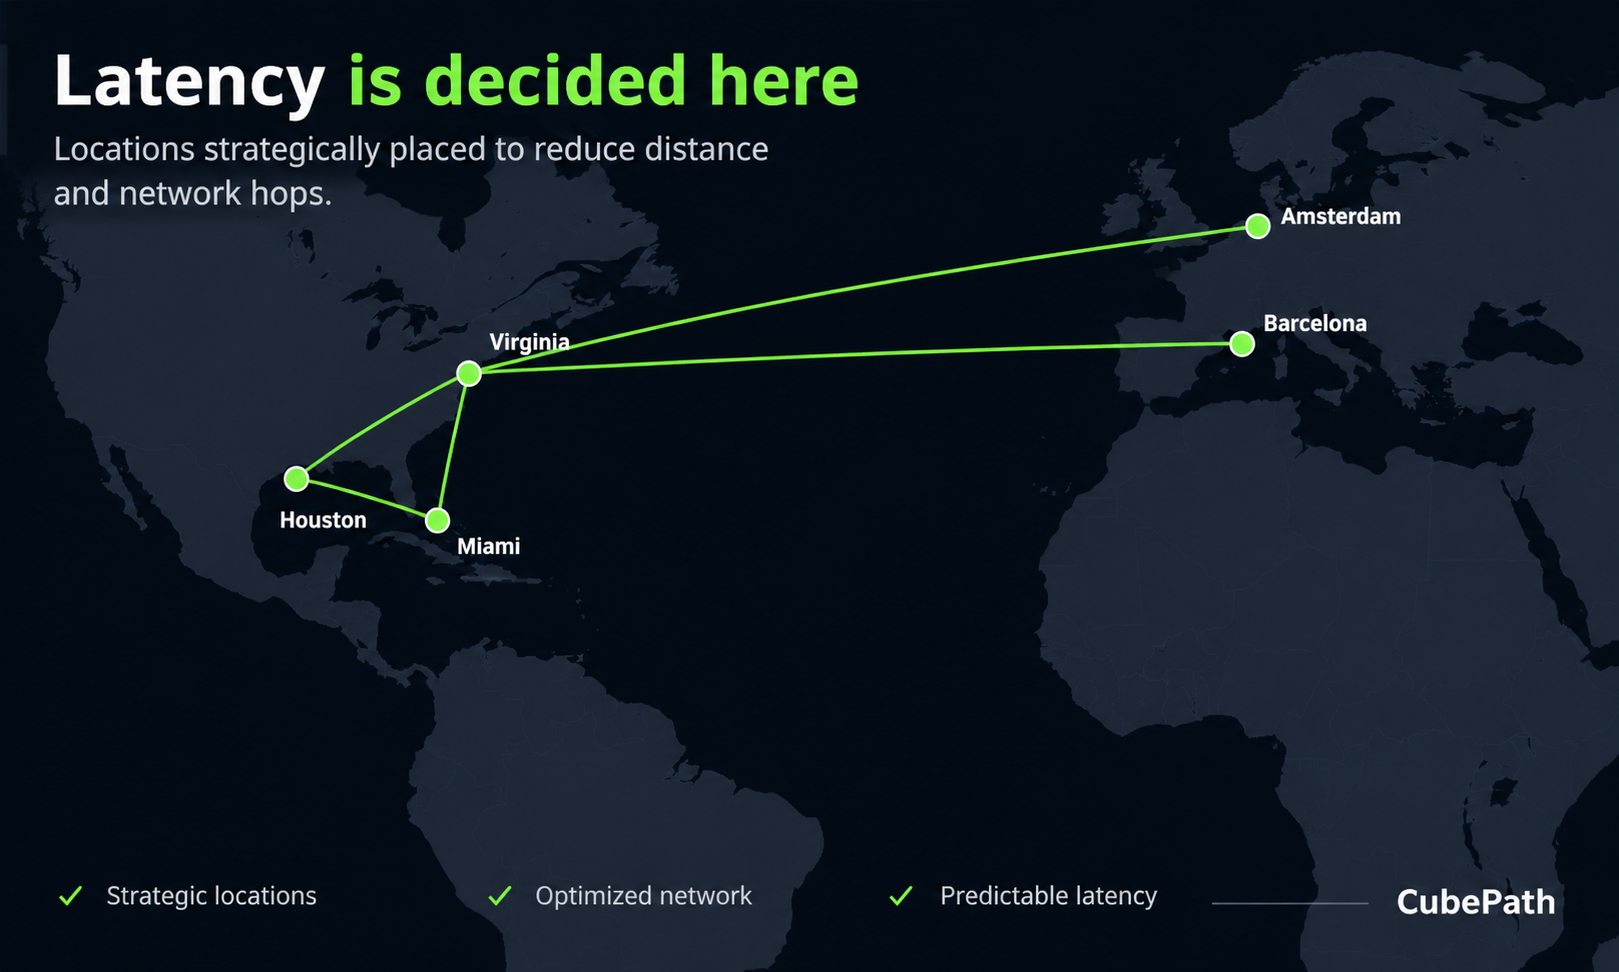


Каждый PoP — это не просто сервер в центре обработки данных. Это полноценная сетевая структура со своими собственными маршрутизаторами, транзитными соединениями и пирингом. Все PoP соединены между собой нашей частной магистральной сетью, поэтому трафик между точками остается в нашей сети, а не проходит через общедоступный интернет.

Почему физическое расположение точек присутствия имеет значение? Потому что так устроены законы физики. Свет в оптоволокне распространяется быстро, но расстояние всё равно увеличивается. Пользователю в Буэнос-Айресе, подключающемуся к серверу в Вирджинии, приходится преодолевать более 8000 км оптоволокна. Тот же пользователь, подключающийся через нашу точку присутствия в Майами, значительно сокращает это расстояние. Умножьте это на каждый запрос, каждый вызов API, каждую загрузку страницы, и разница в пользовательском опыте станет очевидной.

Но наличие точек присутствия в нужных местах — это только половина дела. Другая половина — это то, как трафик будет направляться к ним.

Многоканальное подключение BGP: несколько путей, отсутствие единых точек отказа.

BGP (Border Gateway Protocol) — это протокол, с помощью которого интернет определяет, по какому пути будет проходить трафик из точки А в точку Б. Каждая сеть в интернете объявляет свои маршруты через BGP, и маршрутизаторы по всему миру используют эти объявления для определения оптимального пути.

Большинство небольших и средних провайдеров используют простую конфигурацию BGP: один или два транзитных провайдера. Трафик поступает по тому пути, который предлагают эти провайдеры, и всё. Если у провайдера возникают проблемы, то и у вашего трафика возникают проблемы.

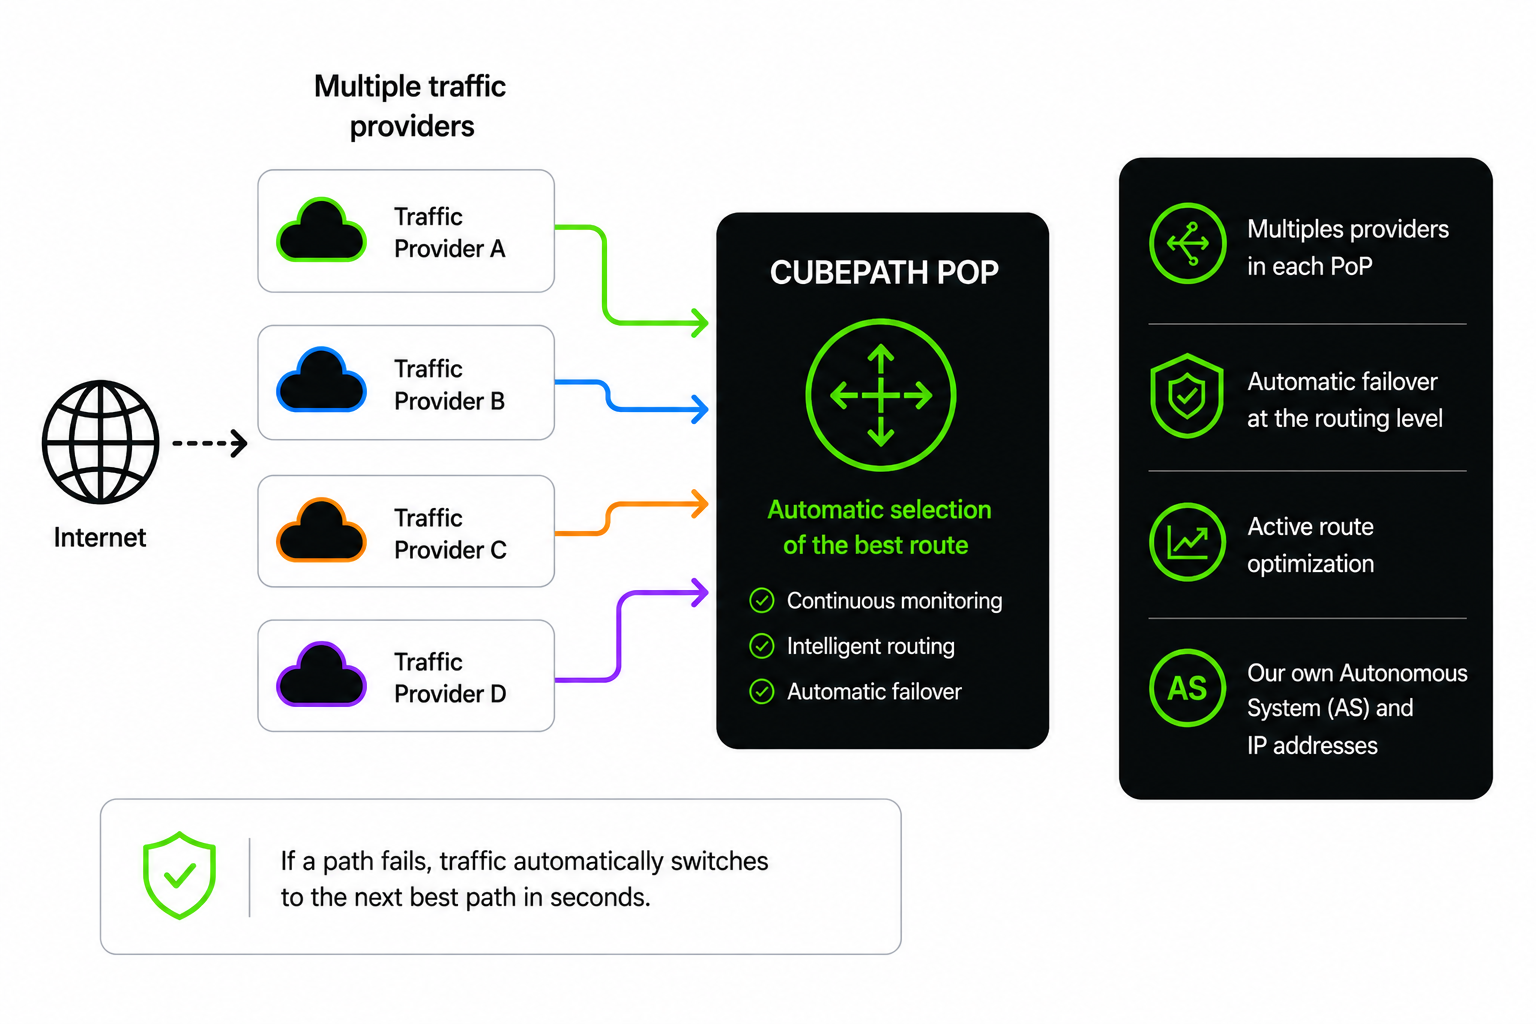
CubePath использует протокол BGP multihoming для всех наших точек присутствия (PoP). Это означает:

В каждом пункте подключения находится несколько транзитных провайдеров. Мы не зависим ни от одного вышестоящего провайдера. Каждая точка присутствия имеет соединения с несколькими транзитными провайдерами, поэтому всегда существует более одного пути для трафика к нам. Если у одного из провайдеров возникает утечка маршрута, проблема с перегрузкой или он полностью выходит из строя, трафик автоматически перенаправляется на следующий оптимальный путь.

Активная оптимизация маршрутов. Многоканальное подключение BGP — это не просто резервирование. Благодаря нескольким вышестоящим провайдерам мы можем влиять на то, по каким путям будет проходить трафик. Мы оптимизируем наши объявления BGP таким образом, чтобы трафик из разных регионов поступал через провайдера и по пути, обеспечивающему наименьшую задержку. Пользователь в Сан-Паулу получает доступ к нам по другому пути, чем пользователь в Лондоне, и оба получают наилучший доступный маршрут.

Наша собственная автономная система. CubePath использует собственный номер автономной системы и IP-пространство. Именно это делает возможной настоящую многоканальную маршрутизацию. Мы не заимствуем чужое адресное пространство и не зависим от решений маршрутизации других компаний. Мы объявляем свои собственные префиксы своим собственным вышестоящим узлам и контролируем, как мир видит нашу сеть.

Автоматическое переключение на резервный канал на уровне маршрутизации. При возникновении проблем у транзитного провайдера происходит автоматическая конвергенция BGP. Трафик перенаправляется по альтернативным маршрутам без какого-либо ручного вмешательства и без отключения ваших сервисов. Это не переключение на резервный канал на уровне приложений, занимающее минуты, а перемаршрутизация на уровне сети, происходящая за секунды.

Почему большинство поставщиков услуг этого не делают
Многоадресная маршрутизация по протоколу BGP требует значительных инвестиций. Вам потребуется собственный номер автономной системы, собственные IP-адреса, выделенные региональным интернет-регистратором, контракты с несколькими транзитными провайдерами в каждом местоположении, а также сетевые инженеры, разбирающиеся в политике BGP и оптимизации маршрутов. Большинство провайдеров обходят это стороной, поскольку единый восходящий канал проще и дешевле. Компромисс заключается в том, что их клиенты зависят от качества и надежности сети этого единственного провайдера.

Мы считаем, что такой компромисс неприемлем для производственной инфраструктуры. Если вы запускаете важные сервисы, сеть, передающая ваш трафик, должна быть отказоустойчивой по своей конструкции, а не по воле случая.

Взаимодействие с интернет-биржами: меньше переходов, более высокая скорость передачи данных.
Помимо транзитных провайдеров, CubePath напрямую взаимодействует с точками обмена интернет-трафиком (IXP) в каждом регионе, где мы работаем. IX — это физическое место, где сотни сетей напрямую обмениваются трафиком друг с другом, минуя посредников.

Когда две сети присутствуют на одном и том же IX-сервере, они могут напрямую взаимодействовать друг с другом. Это означает, что трафик между ними не должен проходить через транзитного провайдера, что исключает промежуточные узлы и уменьшает задержку. Вместо того чтобы ваш трафик шел от CubePath к транзитному провайдеру, затем к другому транзитному провайдеру и, наконец, к целевой сети, он идет от CubePath напрямую к месту назначения. Один переход вместо трех или четырех.
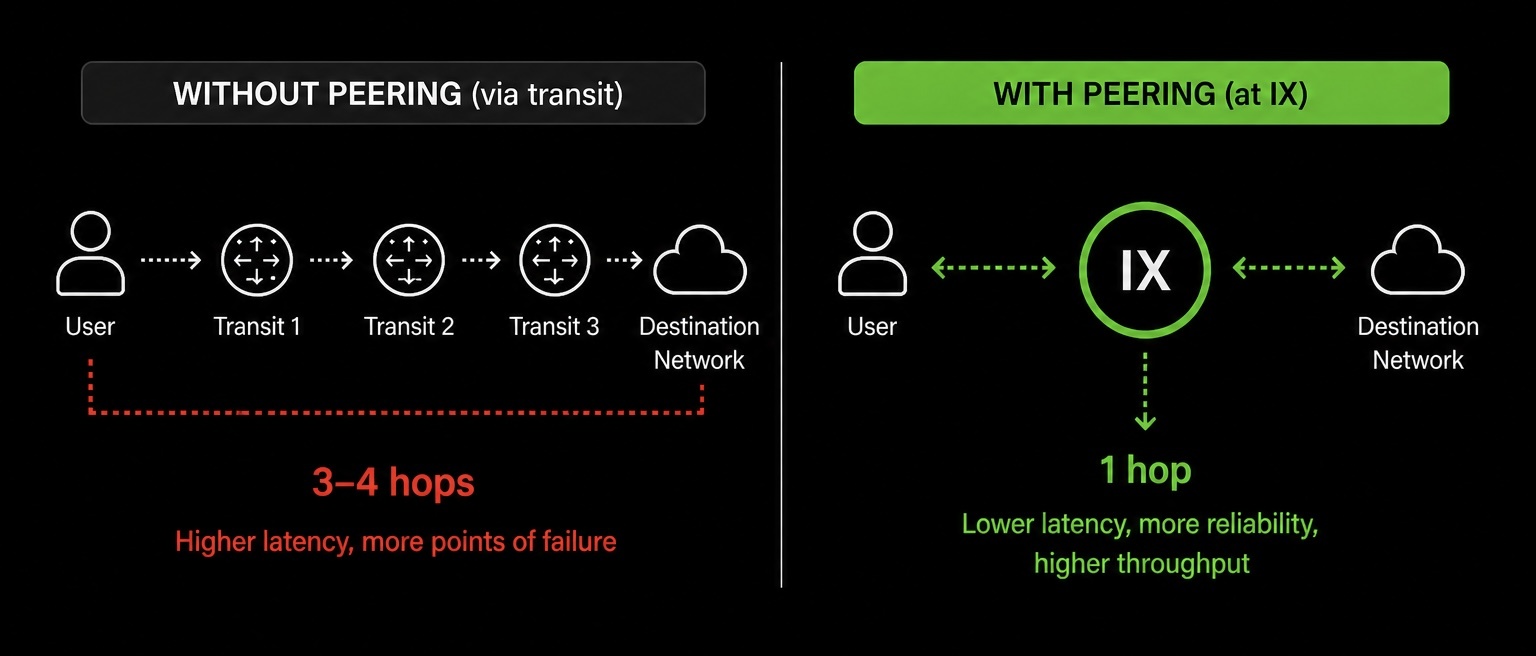


Мы отслеживаем каждую точку обмена интернет-трафиком (IX), поскольку цель проста: поддерживать максимально возможную взаимосвязь нашей сети и сократить количество переходов между CubePath и остальной частью интернета.

Почему это важно для задержки. Каждый промежуточный узел в сетевом пути добавляет задержку. Маршрутизатору необходимо получить пакет, определить маршрут и переслать его. Это занимает время, обычно доли миллисекунды, но оно суммируется на нескольких промежуточных узлах. Устанавливая прямой пиринг с крупными сетями, CDN, облачными провайдерами и наблюдая за интернет-провайдерами в точках обмена трафиком, мы исключаем эти промежуточные узлы из уравнения. В результате вы получаете заметно меньшую задержку для ваших пользователей.

Почему это важно для надежности. Меньшее количество переходов означает меньшее количество потенциальных проблем. Каждый маршрутизатор на пути является потенциальной точкой отказа или перегрузки. Прямое пиринговое соединение на IX полностью исключает эти промежуточные точки. Если мы соединены пирингом с интернет-провайдером пользователя на той же станции, трафик остается локальным для этого объекта. Никакого транзита на большие расстояния, никаких решений по маршрутизации от третьих лиц, никаких неожиданностей.

Почему это важно для пропускной способности. Пиринг IX обычно обеспечивает более высокую пропускную способность и меньшую стоимость, чем транзит. Когда значительная часть вашего трафика направляется в сети, с которыми вы напрямую взаимодействуете через пиринг, вы не конкурируете за пропускную способность на перегруженных каналах транзитного провайдера. Трафик проходит по выделенным пиринговым соединениям с пропускной способностью, которую мы контролируем и отслеживаем.

Чем больше сетей мы сотрудничаем, тем больше трафика проходит по прямым путям. А чем больше прямых путей проходит трафик, тем быстрее и надежнее ваши сервисы для конечных пользователей.

Anycast: Один IP-адрес, обслуживание осуществляется с ближайшей точки присутствия.
Anycast — это метод маршрутизации, при котором один и тот же IP-адрес объявляется одновременно из нескольких точек. Когда пользователь отправляет запрос на Anycast IP-адрес, маршрутизация BGP автоматически направляет его к ближайшей точке присутствия (PoP), объявляющей этот адрес. Пользователь не выбирает адрес самостоятельно. Сеть делает это автоматически на основе близости маршрутов.

CubePath использует технологию Anycast в нашей сети точек присутствия. Вот что это позволяет:
Географическое управление трафиком без уловок DNS. Традиционные подходы к направлению пользователей к ближайшему серверу основаны на GeoDNS, который преобразует одно и то же имя хоста в разные IP-адреса в зависимости от местоположения пользователя. Это работает, но обновление происходит медленно, данные неточны и зависят от соблюдения значений TTL DNS. Anycast обходит все эти сложности. Один IP-адрес объявляется каждым PoP, а сеть обрабатывает все остальное.

Мгновенное переключение между точками доступа. Если точка присутствия (PoP) выходит из строя, BGP отзывает маршрут Anycast из этой точки. Трафик автоматически перенаправляется на ближайшую точку присутствия в течение нескольких секунд. Нет задержек распространения DNS, нет ожидания TTL, нет ручного вмешательства. IP-адрес остается неизменным, перенаправление пользователя происходит незаметно.

Снижена задержка при первом подключении. Процесс установления TLS-соединения чувствителен к задержке. Для передачи данных требуется несколько циклов обмена данными между клиентом и сервером. Когда Anycast IP-адрес разрешается в ближайшую точку присутствия (PoP), эти циклы обмена данными становятся короче, и соединение устанавливается быстрее. Для HTTPS-сервисов это напрямую приводит к сокращению времени до получения первого байта.

Естественная устойчивость к DDoS-атакам. Anycast распределяет входящий трафик по всем точкам присутствия (PoP), объявляя адрес. Во время объемной DDoS-атаки трафик распределяется по нескольким точкам, а не достигает одной. Каждая точка присутствия поглощает часть атаки, что значительно затрудняет перегрузку какой-либо одной точки.

Как мы используем Anycast в CubePath
Хороший пример — наша DNS-инфраструктура. DNS-серверы CubePath объявляются через Anycast со всех наших точек присутствия (PoP). Когда ваш сервер отправляет DNS-запрос, он автоматически достигает ближайшего резолвера. Сервер в Испании запрашивает локальную точку присутствия. Сервер в Майами запрашивает ту же самую точку присутствия. Один и тот же IP-адрес, разное физическое местоположение, минимально возможная задержка. Если точка присутствия выходит из строя, DNS-запросы автоматически перенаправляются к следующей ближайшей точке присутствия без каких-либо изменений в конфигурации.

Мы также используем Anycast в качестве основы для наших CDN и сервисов защиты от DDoS-атак. Трафик от конечных пользователей сначала достигает ближайшей точки присутствия (PoP), где он может быть отфильтрован, кэширован или перенаправлен на исходный сервер по нашей частной магистральной сети. Такая архитектура означает, что как уровень безопасности, так и уровень доставки контента выигрывают от географического распределения без необходимости какой-либо настройки со стороны клиентов.

Как всё это взаимосвязано
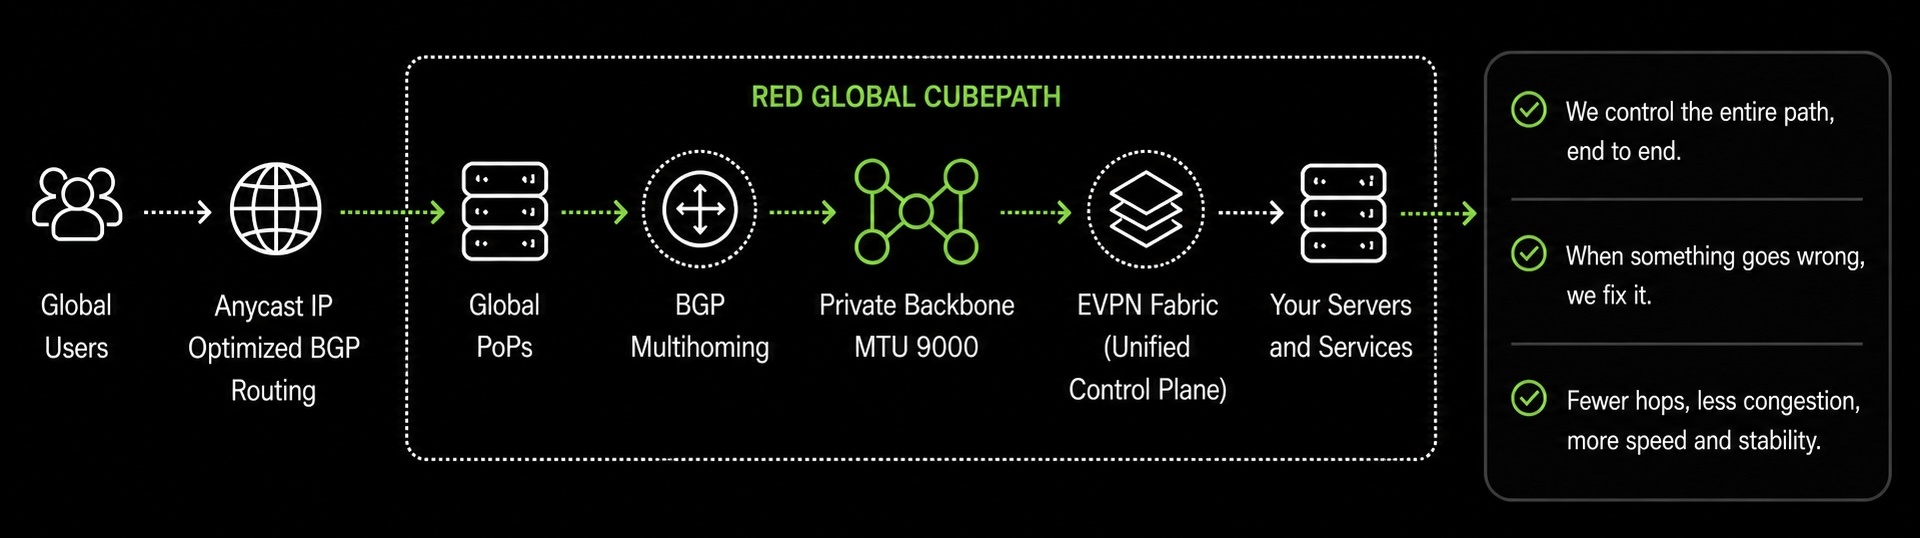

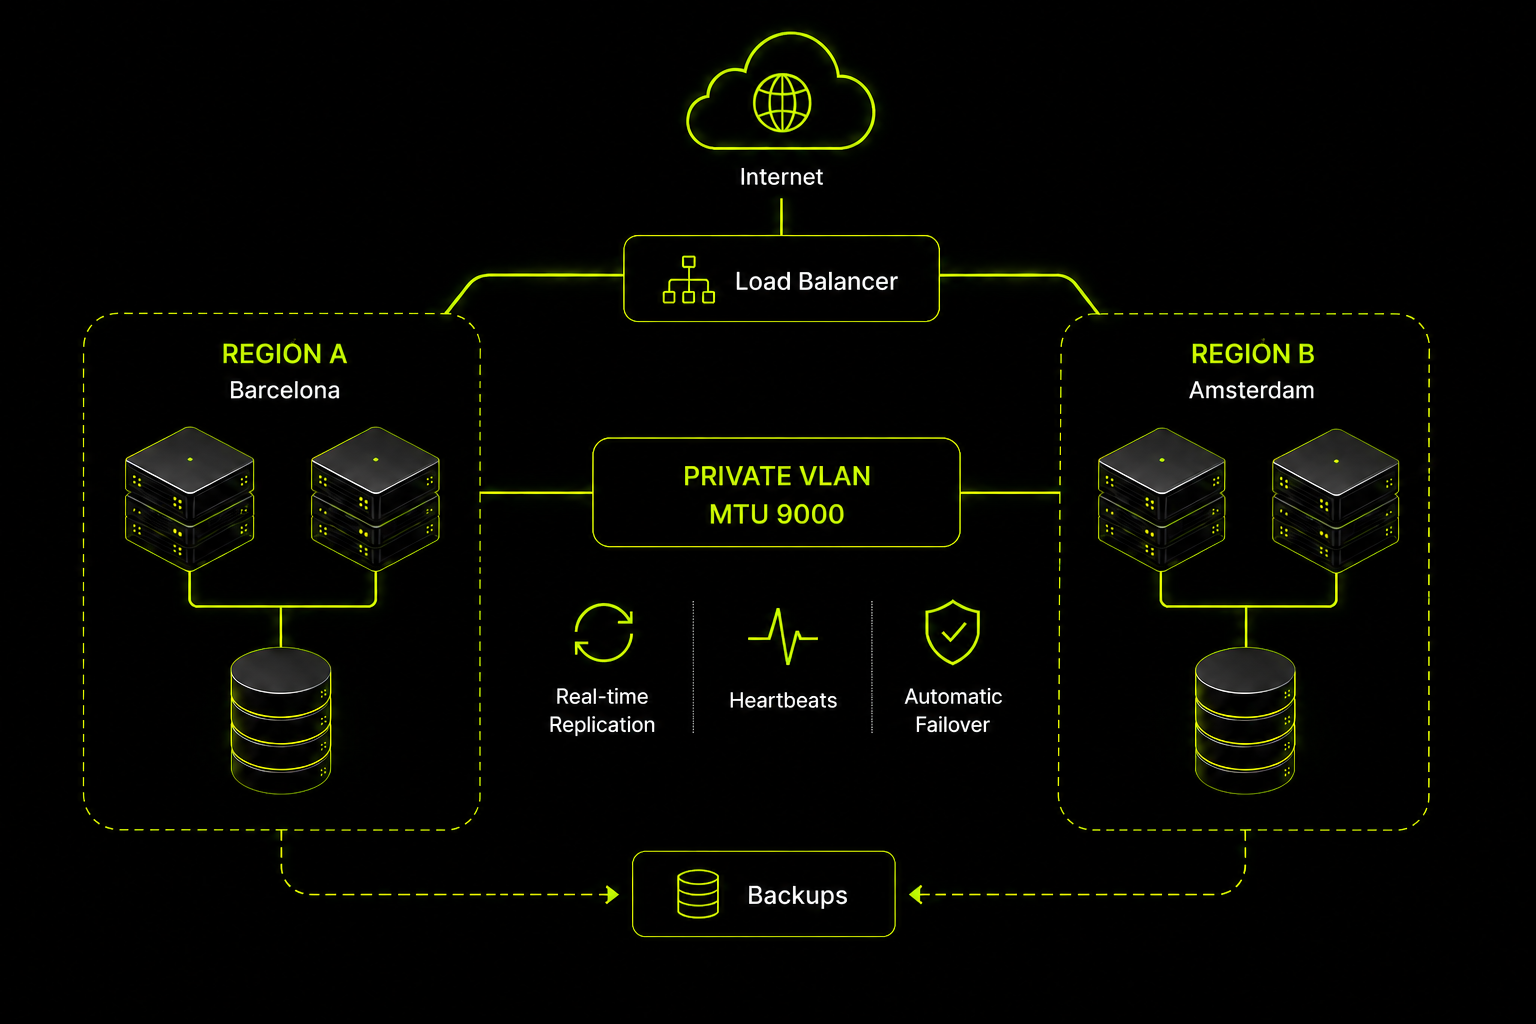
Наша глобальная сеть — это не набор разрозненных элементов. Точки присутствия (PoP), многоадресная маршрутизация BGP, Anycast и частная магистраль с MTU 9000 — всё это работает вместе как единая инфраструктура.

Благодаря технологии Anycast и оптимизированным маршрутам BGP трафик поступает через ближайшую точку присутствия (PoP). Он проходит по нашей частной магистральной сети до серверов, на которых работают ваши рабочие нагрузки, при этом MTU 9000 обеспечивает максимально эффективную внутреннюю передачу данных. В случае отказа какого-либо компонента, будь то транзитный провайдер, точка присутствия или сервер, сеть автоматически перенаправляет трафик на уровне BGP.

Внутри нашей сети используется технология EVPN (Ethernet VPN), та же самая, что и у крупных облачных провайдеров. EVPN использует BGP для определения местоположения каждого сервера и адреса в сети, поэтому трафик перенаправляется интеллектуально, а не распространяется повсюду, как в традиционных системах. Это позволяет нам беспрепятственно расширять частные сети между точками присутствия (PoP), обрабатывать многосайтовые соединения и масштабировать сеть по мере добавления новых серверов и местоположений без ухудшения качества сети. Тот же BGP, который отвечает за маршрутизацию в интернете, пиринг и Anycast, также управляет нашей внутренней сетью. Единая плоскость управления для всей сети.

Именно это отличает CubePath от провайдеров, арендующих сетевые мощности у кого-то другого. Мы контролируем весь путь, от первого пакета пользователя до сервера, обрабатывающего запрос. Когда что-то идет не так, мы не открываем заявку в службу поддержки. Мы исправляем проблему сами.

Для команд, работающих с API, чувствительными к задержкам, глобально распределенными приложениями, сервисами реального времени или любыми другими системами, где производительность сети напрямую влияет на пользовательский опыт, именно такая сеть необходима в вашей инфраструктуре.

Куда мы идём
Мы продолжаем расширять зону покрытия PoP и добавлять пиринговые соединения в каждом пункте. Большее количество PoP означает более короткие пути к большему числу пользователей. Большее количество пиринговых соединений означает меньшую зависимость от транзита и более качественную маршрутизацию к крупным сетям и интернет-провайдерам.

По мере развития CubePath Managed Kubernetes, кластеров GPU и остальной части нашей платформы, сеть остается ее основой. Быстрая, отказоустойчивая, глобально распределенная и полностью контролируемая нами.

Мы создали эту сеть, потому что считаем, что поставщики инфраструктуры должны владеть своей сетью, а не арендовать её. Всё, что мы предлагаем на CubePath, построено на этом фундаменте, и мы думаем, вы почувствуете разницу.

cubepath.com
my.cubepath.com/register
Почему мы создали глобальную сеть с MTU 9000 и что это дает


Когда мы начали проектировать сетевую инфраструктуру CubePath, у нас был выбор. Мы могли поступить так, как поступает большинство провайдеров: предоставить каждому региону свою собственную изолированную сеть со стандартным MTU 1500 и на этом остановиться. Это дешевле, проще, и, честно говоря, большинство клиентов не заметят разницы в первый же день.

Мы решили пойти другим путем. Мы инвестировали в создание глобальной частной сети с VLAN, охватывающей несколько регионов, и MTU 9000 (jumbo frames) по всем направлениям. Это стоило дороже. Это заняло больше времени. Но это открывает категорию архитектур, которые просто невозможны в стандартной сети, и мы считаем, что это важно.

В этом посте объясняется, почему мы сделали эти инвестиции и какие возможности это открывает для команд, разрабатывающих приложения на платформе CubePath.

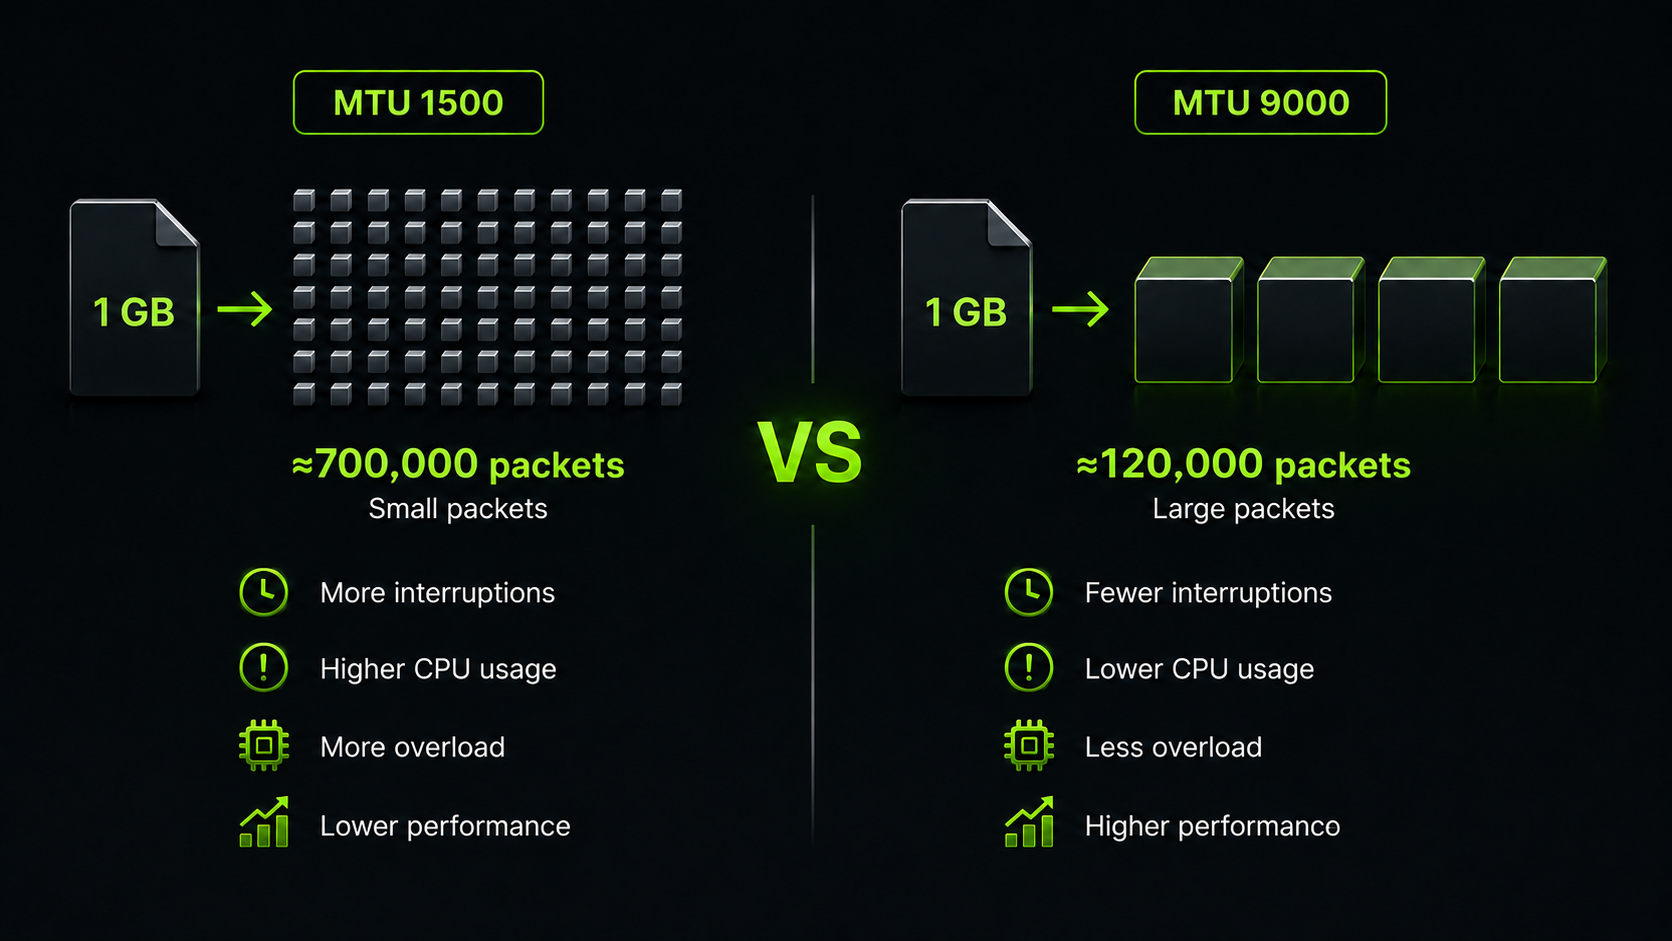
Почему MTU 9000? Потому что 1500 байт на пакет — это узкое место.
Начнём с технической реальности. По умолчанию MTU в большинстве сетей составляет 1500 байт. Это стандарт, действующий с момента разработки Ethernet в 1980-х годах. Каждый пакет, отправляемый вашими серверами, содержит максимум 1500 байт фактических данных, плюс заголовки.

Для обычного веб-трафика это нормально. Но как только вы начинаете передавать серьезные объемы данных между серверами, эти небольшие пакеты становятся настоящим ограничивающим фактором.

Возьмем, к примеру, резервную копию базы данных размером 1 ГБ. При MTU 1500 это примерно 700 000 пакетов, которые необходимо собрать, отправить, получить, проверить и подтвердить. Каждый из этих пакетов требует ресурсов процессора. Необходимо обрабатывать заголовки, вычислять контрольные суммы, обрабатывать прерывания. Умножьте это на сотни передач, происходящих каждый час в загруженной инфраструктуре, и вы увидите, что реальные вычислительные ресурсы расходуются на сетевые накладные расходы.

Теперь рассмотрим ту же передачу с MTU 9000. Каждый пакет содержит в 6 раз больше данных. Резервная копия объемом 1 ГБ сокращается примерно до 120 000 пакетов. Меньше нагрузки на ЦП, меньше прерываний, более высокая пропускная способность. В реальных тестах Jumbo-кадры улучшают производительность пакетной передачи на 15-30%. В рабочих нагрузках, постоянно перемещающих данные между узлами, таких как репликация баз данных, распределенное хранилище или трафик контейнеров «восток-запад», эта разница увеличивается в течение дня.


Мы проанализировали, что именно создают наши клиенты. Кластеры баз данных с потоковой репликацией. Распределенные хранилища с Ceph и GlusterFS. Кластеры Kubernetes с сотнями взаимодействующих друг с другом подов. Конвейеры обработки больших данных, перемещающие промежуточные результаты между узлами. Все это — рабочие нагрузки, где эффективность сети напрямую влияет на производительность и стоимость. Поэтому мы приняли решение: MTU 9000 повсюду, не как дополнительная опция, а как основа.

Почему многорегиональные VLAN? Потому что реальные архитектуры не размещаются в одном центре обработки данных.


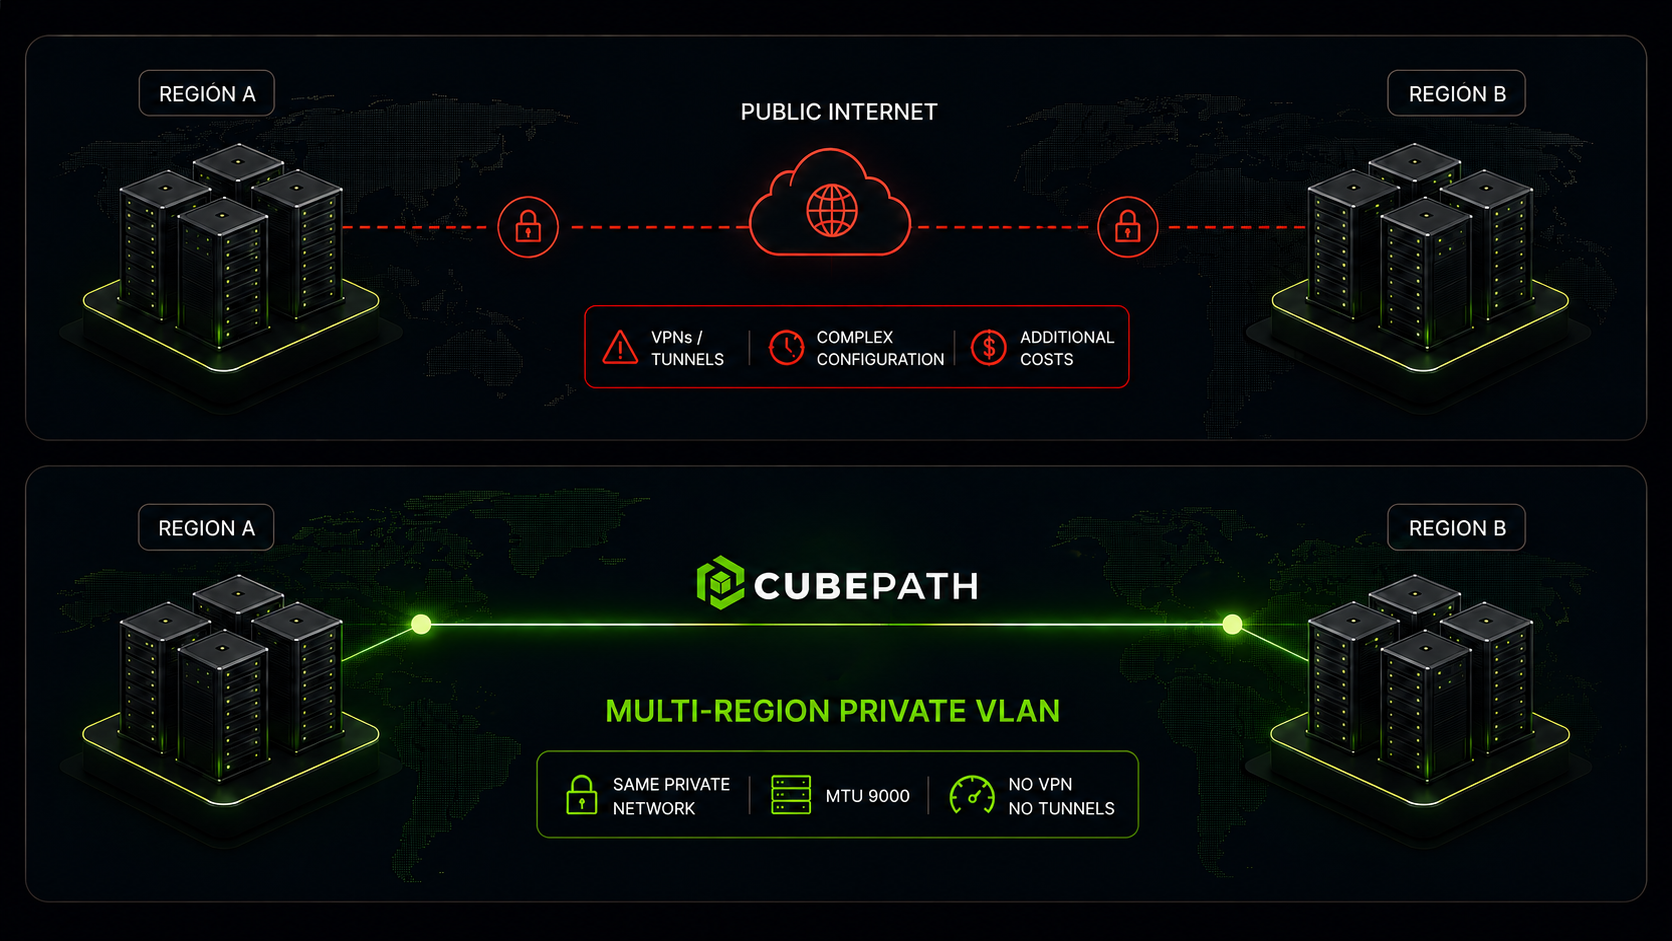
Большинство провайдеров предоставляют вам частную сеть в пределах одного региона. Ваши серверы в Испании могут обмениваться данными между собой через частную сеть, и ваши серверы в Амстердаме также могут обмениваться данными через частную сеть. Но если Испании нужно связаться с Амстердамом? Вам придется использовать общедоступный интернет, создавать VPN-туннели или платить за какие-либо услуги межсетевого взаимодействия.

Это создает трение, которое подталкивает команды к более простым (и более хрупким) архитектурам. Если соединение двух регионов само по себе является проектом, люди его избегают. Они запускают все в одном регионе и надеются, что ничего не пойдет не так. Или они создают недоработанные системы аварийного восстановления, которые никогда не тестировались, потому что настройка сетевого уровня оказалась слишком сложной.

Мы хотели полностью устранить это препятствие. VLAN-сети CubePath охватывают разные регионы. Ваш сервер в Испании и ваш сервер в Амстердаме могут находиться в одной частной сети, как если бы они располагались в одной стойке. Никаких VPN, никаких туннелей, никакой специальной конфигурации. Просто серверы, которые видят друг друга с MTU 9000, через частную сеть, которая никогда не подключается к общедоступному интернету.

Это не просто функция для удобства. Она коренным образом меняет представление о том, какие архитектуры целесообразно строить.

Что делает возможной эта сеть
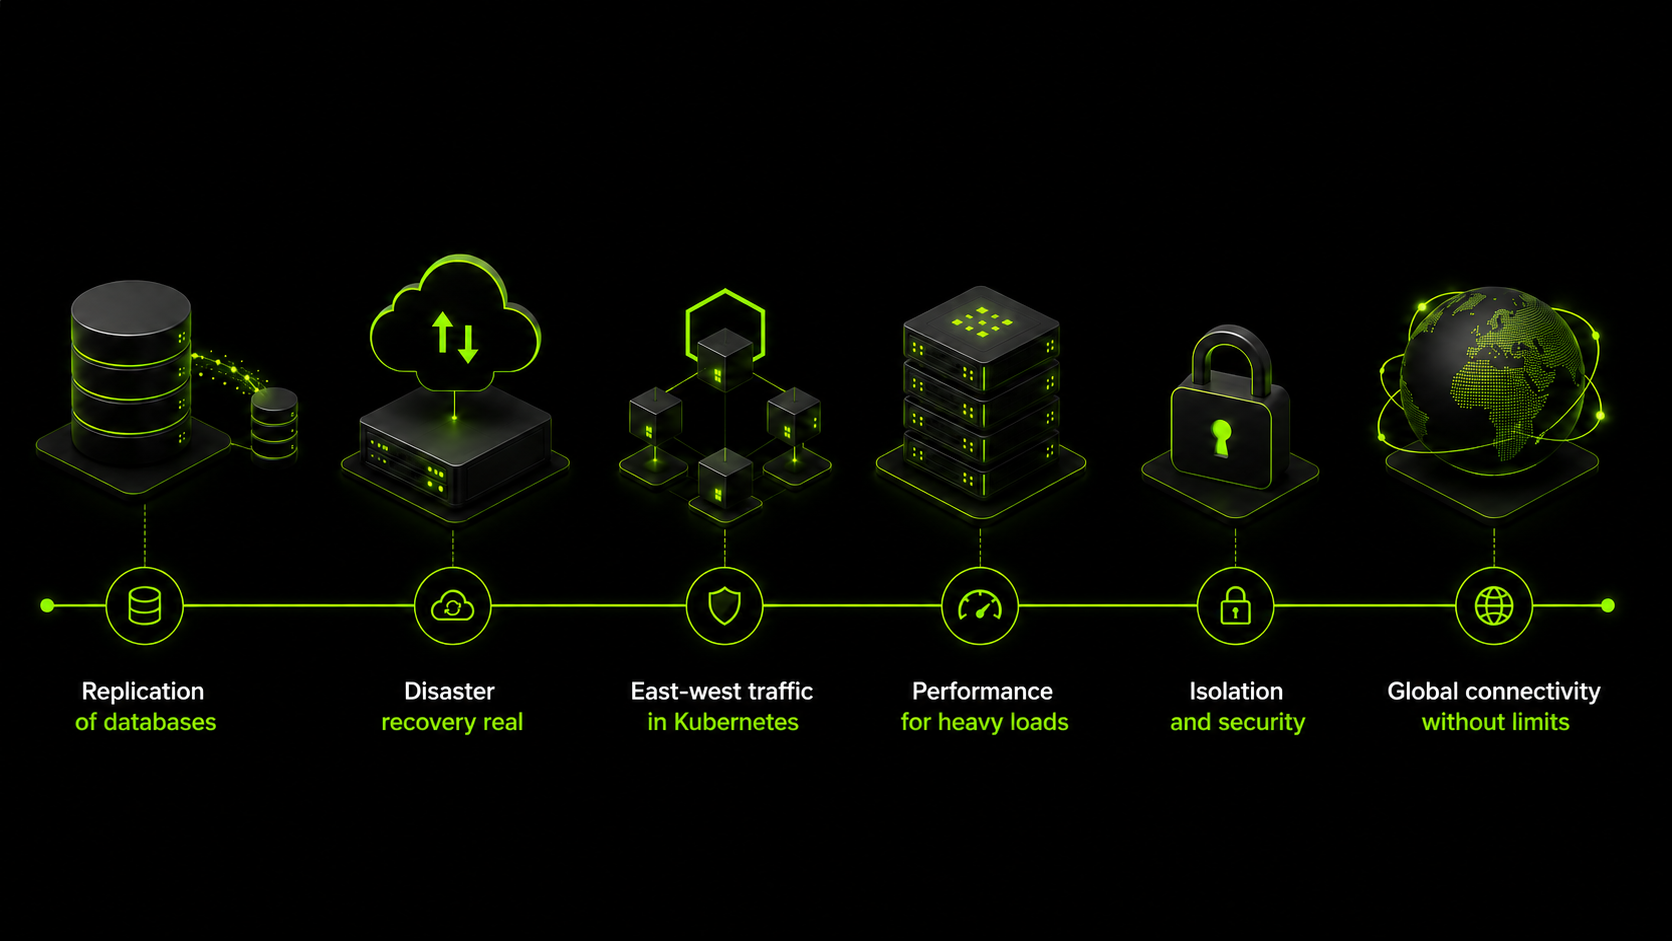
Вот что становится реальностью, когда ваша частная сеть быстрая, глобальная и имеет правильные параметры.


Репликация базы данных, которая действительно обеспечивает бесперебойную работу.
Репликация PostgreSQL в потоковом режиме, групповая репликация MySQL, репликационные наборы MongoDB. Все они зависят от передачи данных с основного сервера на одну или несколько реплик по сети. Чем быстрее и эффективнее сеть, тем меньше задержка репликации.

Благодаря MTU 9000 в частной сети между регионами, ваша реплика в другом центре обработки данных остается близкой к основной даже при высоких нагрузках на запись. Это означает, что ваши реплики для чтения предоставляют актуальные данные, ваша целевая точка переключения на резервный сервер действительно работоспособна, а восстановление на определенный момент времени не происходит с задержкой в ​​несколько секунд.

В стандартной сети с MTU 1500, подключенной к общедоступному интернету? Задержка репликации резко возрастает под нагрузкой, реплики отстают, и когда вам действительно нужно переключиться на резервный сервер, вы обнаруживаете, что ваш резервный сервер отстает от основного на несколько минут.

Восстановление после катастроф, которому вы действительно можете доверять
Восстановление после сбоев — это одна из тех вещей, о которых все говорят, что они у них есть, но мало кто действительно их тестировал. Основная причина этого — сложность сети. Если передача резервных копий в другой регион включает в себя настройку VPN-туннелей, конфигурирование шифрования, учет расходов на пропускную способность и надежду на то, что передача завершится до начала следующего окна резервного копирования, то команды просто… не делают это должным образом.

Когда ваши регионы подключены к одной и той же VLAN с MTU 9000, восстановление после сбоев становится намного проще. WAL-файлы передаются по частной сети в режиме реального времени. Ночные резервные копии передаются быстрее, поскольку Jumbo-кадры уменьшают накладные расходы. Стоимость сети равна нулю, поскольку частный трафик бесплатен. А поскольку это легко настроить, команды фактически тестируют свои процедуры восстановления, а не предполагают, что они работают.

Распределенное хранилище без узкого места в сети
Ceph, GlusterFS, NFS, iSCSI. Все эти протоколы хранения данных невероятно чувствительны к производительности сети. Скорость кластера хранения данных зависит только от скорости сети, соединяющей его узлы.

MTU 9000 уменьшает фрагментацию пакетов и позволяет передавать трафик хранилища со скоростью, близкой к скорости сетевого соединения. Если вы используете кластер Ceph на нескольких серверах, разница между MTU 1500 и MTU 9000 может означать разницу между приемлемой производительностью и постоянными узкими местами. Мы убедились в этом на собственном опыте у клиентов, использующих распределенные хранилища, и это одна из причин, по которой мы перешли на использование Jumbo Frames в сети в целом.

Кластеры высокой доступности, где переключение при отказе измеряется в секундах.
Кластеры с высокой доступностью зависят от быстрой и надежной связи между узлами. Сигналы активности должны поступать вовремя. Синхронизация состояния должна быть быстрой. При переключении на резервный сервер кластер должен обнаружить сбой и реорганизоваться за секунды, а не за минуты.

В CubePath обмен данными между узлами кластера происходит по частной сети. Сигналы активности между узлами Patroni, проверки Redis Sentinel, консенсус etcd в Kubernetes, проверки работоспособности HAProxy — всё это работает в быстрой, изолированной сети с MTU 9000. В результате обнаружение сбоев происходит быстрее, передача состояния при повышении уровня кластера происходит быстрее, и ваш кластер восстанавливается до того, как пользователи заметят какие-либо изменения.

В сочетании с балансировщиками нагрузки CubePath и плавающими IP-адресами вы получаете строительные блоки для архитектур высокой доступности, которые действительно работают в производственной среде. Не просто на бумаге, не просто в инструкциях по эксплуатации, которые никто не тестировал, а в реальных сценариях отказа, когда узел действительно выходит из строя в 3 часа ночи, и система справляется с этим самостоятельно.

Kubernetes с быстрой передачей трафика между Востоком и Западом.
Kubernetes генерирует огромный объем внутреннего сетевого трафика. Поды взаимодействуют друг с другом, сервисы разрешаются через DNS кластера, контроллеры входящего трафика маршрутизируют запросы к бэкэндам — все это трафик между узлами, идущий в направлении «восток-запад».

Когда трафик проходит по сети с MTU 9000, каждое взаимодействие между подами становится более эффективным. Боковые контейнеры сервисной сетки добавляют меньше накладных расходов. Большие объемы данных между микросервисами передаются быстрее. А если вы используете CNI, например Cilium или Calico, то производительность базовой сети напрямую влияет на скорость взаимодействия ваших подов.

Для управляемого Kubernetes от CubePath это означает, что кластерная сеть работает лучше сразу после установки. Для самостоятельного управления это означает, что вы используете сеть, которая не будет создавать проблем по мере роста кластера.

Конвейеры обработки больших данных, которые не зависают при перемешивании данных.
Если вы когда-либо работали с Hadoop, Spark или любой другой распределенной системой обработки данных, вы знаете, что на этапе перемешивания данных все замедляется. Узлы обмениваются промежуточными результатами друг с другом, и скорость этого обмена определяет скорость завершения вашей задачи.

MTU 9000 снижает накладные расходы на каждый пакет во время перемешивания данных, что означает более быструю передачу данных между узлами и более быстрое завершение заданий. Для команд, выполняющих обычные аналитические задачи или конвейеры ETL на нескольких серверах, это не просто незначительное улучшение. Это разница между конвейером, который завершается в течение установленного вами пакетного окна, и тем, который этого не делает.

Решение, лежащее в основе инвестиций


Создание этой сети было непростым делом. Стандарт MTU 9000 требует сквозной поддержки на каждом коммутаторе, маршрутизаторе и сетевой карте на пути следования. Многорегиональные VLAN требуют межсоединений между центрами обработки данных, чего большинство провайдеров избегают из-за стоимости и сложности. Было бы проще и дешевле использовать стандартные сетевые решения и сосредоточиться на других функциях.

Но мы постоянно приходили к одному и тому же выводу: сеть — это основа всего остального. У вас могут быть самые быстрые процессоры и самое большое количество NVMe-хранилищ в мире, но если ваши серверы не могут эффективно взаимодействовать, ваша архитектура достигнет предела своих возможностей.

Репликация баз данных, распределенное хранилище, кластеры высокой доступности, сетевое взаимодействие контейнеров, аварийное восстановление. Все это ограничено качеством сети между вашими серверами. Мы хотели, чтобы CubePath представлял собой инфраструктуру, в которой вы проектируете архитектуру, исходя из того, что лучше всего подходит для вашего приложения, а не исходя из возможностей сети вашего провайдера.

Именно поэтому мы построили её именно так. И именно поэтому мы продолжаем инвестировать в расширение этой сети, добавляя новые регионы и наращивая мощности.

Что дальше?
Мы продолжаем расширять нашу сеть, добавляя новые регионы и увеличивая пропускную способность существующих межсоединений. По мере роста CubePath Managed Kubernetes и запуска кластеров GPU, требования к внутренней сети только возрастают, и инвестиции в MTU 9000 и многорегиональные VLANы окупаются еще больше.

Если вы проектируете архитектуру, требующую быстрой внутренней сети, межрегиональной репликации или действительно высокой доступности, сеть CubePath создана именно для этого.

cubepath.com
my.cubepath.com/register
Присоединяйтесь к закрытому альфа-тесту нового продукта


Мы создаем новое продуктовое решение is*hosting Workspaces. Платформу с 100+ самых популярных self-hosted приложений для работы и экспериментов.

Вы сможете установить любое из них в 1 клик на наших серверах.

Но нам нужна ваша помощь. Перед официальным запуском мы хотим получить обратную связь от реальных пользователей — от вас.

Если вы:
  • Используете наши сервисы больше года
  • Работаете с инструментами аналитики и хотите держать данные у себя
  • Запускаете автоматизации на своём сервере
  • AI-креатор, которому нужен быстрый доступ к инструментам
  • Строите техническую инфраструктуру: от баз данных до мониторинга
  • Просто хотите попробовать трендовые приложения в 1 клик
  • Устали настраивать всё вручную

Условия:
  • Вы получаете месяц закрытого доступа к is*hosting Workspaces
  • Изучаете приложения, пробуете, экспериментируете
  • Делитесь обратной связью: что работает, что нет, чего не хватает (заполните простую форму после теста)
Взаимная выгода:
  • Мы получаем реальный опыт от людей, которым доверяем, чтобы сделать продукт лучше
  • Вы получаете участие в создании нового продукта + бесплатный период с is*hosting Workspaces после запуска + секретный бонус
Сроки:
  • Приём заявок открыт, регистрация закроется в конце августа — начале сентября
  • Отбор и тестирование — в сентябре 2026
  • Количество мест ограничено
Если хотите присоединиться, заполните короткую форму и мы вам напишем docs.google.com/forms/d/e/1FAIpQLSeGbd-accDm1ZwAniw3fQkPnATV8gVpJo1O28FUJeXgfr_J1g/viewform?usp=dialog

У нас отличные новости: теперь можно легко поменять IP-адрес вашего сервера


Друзья, привет! Мы знаем, как иногда бывает нужно быстро сменить IP-адрес на сервере.

Причины у всех разные: у кого-то адрес случайно попал в какой-нибудь глупый бан, кому-то нужно переехать на другую подсеть для тестов, а кому-то просто хочется красивый или конкретный номер.

Раньше для этого приходилось писать в поддержку, ждать ответа и тратить время.
Теперь мы полностью автоматизировали этот процесс.
Всё можно сделать самостоятельно в личном кабинете буквально за пару кликов! Причём вы можете не просто получить случайный адрес, а сами выбрать нужную подсеть или даже конкретный айпишник из списка.

Как это работает (всё очень просто):
  • 1. Зайдите на страницу вашей услуги (сервера).
  • 2. Найдите строчку с вашим текущим IP-адресом и нажмите на значок стрелочек прямо рядом с ним.
  • 3. В появившемся меню выберите нужную подсеть или кликните на конкретный IP, который вам понравился.
  • 4. Нажмите кнопку «Сменить IP» — и всё готово, адрес обновится автоматически!

На каких условиях это работает:
  • Мы дарим вам 5 бесплатных замен. При этом система выдаст вам случайный адрес из той подсети, которую вы выберете сами.
  • Если вы потратите эти 5 бесплатных попыток, то каждая последующая замена случайного адреса будет стоить всего 100 рублей.
  • Если вы не хотите полагаться на случай и желаете сами выбрать конкретный IP-адрес из списка, это тоже стоит 100 рублей (на этот вариант бесплатный лимит не распространяется).

Мы очень надеемся, что это обновление сделает вашу работу с серверами еще удобнее и приятнее. Если вдруг что-то пойдет не так или появятся вопросы — мы всегда на связи!

С уважением,
Команда 4vps.su

Объявляем о новой панели CubePath


Новая панель CubePath: почему мы отказались от WHMCS
Более 10 лет компания CubePath использовала WHMCS для управления заказами и выставлением счетов. Этот инструмент хорошо служил тысячам хостинговых компаний, и CubePath он тоже хорошо себя зарекомендовал на начальном этапе. Но по мере того, как платформа разрослась до более чем 500 серверов в Испании, Хьюстоне, Майами и Амстердаме в сети со скоростью 5 Тбит/с, ограничения стали невыносимыми.

WHMCS создан для традиционных реселлеров хостинга. CubePath требовалось мгновенное развертывание, публичный API, инструменты командной строки, поддержка Terraform и реальный контроль над сетью, безопасностью и инфраструктурой. Ничего из этого не поместилось в WHMCS.

Поэтому вместо того, чтобы подстраиваться под чужую систему, CubePath разработала собственную панель с нуля. В этой статье рассказывается о том, что делает новая панель и зачем она нужна.

Что изменилось и почему?
Раньше система работала так: WHMCS обрабатывала заказы и выставление счетов, а всё остальное было интегрировано с помощью пользовательских решений. Добавление нового продукта означало создание моста между WHMCS и фактической инфраструктурой. Каждая новая функция требовала обхода предположений WHMCS о том, как должен работать хостинг.

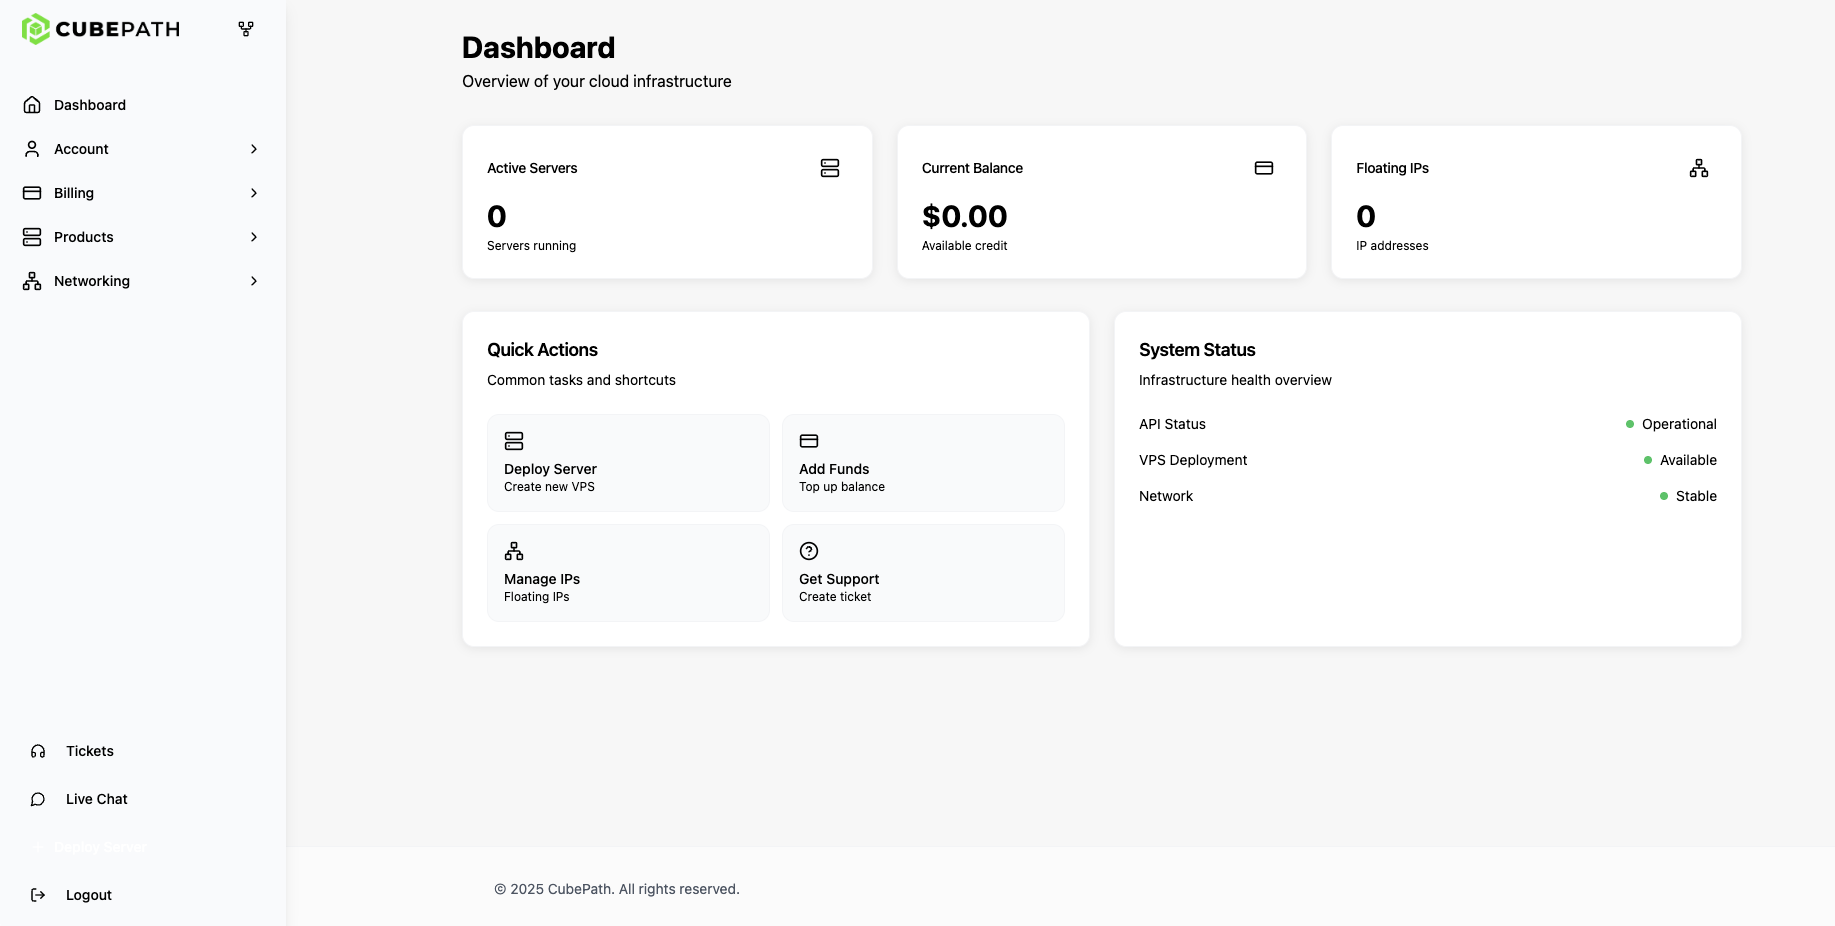
Новая панель управления ориентирована на API. Все продукты — VPS, физические серверы, балансировщики нагрузки, DNS, частные сети, CDN — работают через один и тот же API. Панель является клиентом этого API, как CubeCLI или конфигурация Terraform. Отдельной системы выставления счетов нет. Всё работает на одной платформе.

Панель

Панель управления разработана для быстрой и функциональной работы. Никаких лишних элементов, никаких рекламных баннеров внутри панели, никаких десятишаговых мастеров развертывания сервера. Интерфейс чистый, отзывчивый и создан для команд, которые ежедневно управляют инфраструктурой.

От участников дискуссии:
  • Разверните VPS за считанные секунды с почасовой оплатой от 0,007 доллара в час.
  • Управляйте физическими серверами, VPS, сетью и DNS из одного места.
  • Получите доступ ко всем функциям, не переключаясь между различными инструментами или поставщиками.

Управление всей инфраструктурой в одном месте.
Независимо от того, работает ли рабочая нагрузка на физическом сервере или на VPS, панель управления позволяет управлять обоими вариантами из единого интерфейса. Никаких внешних инструментов, никакого переключения контекста между провайдерами.


Всё организовано по проектам. Каждый проект объединяет свои серверы, сети и ресурсы. С любого сервера:
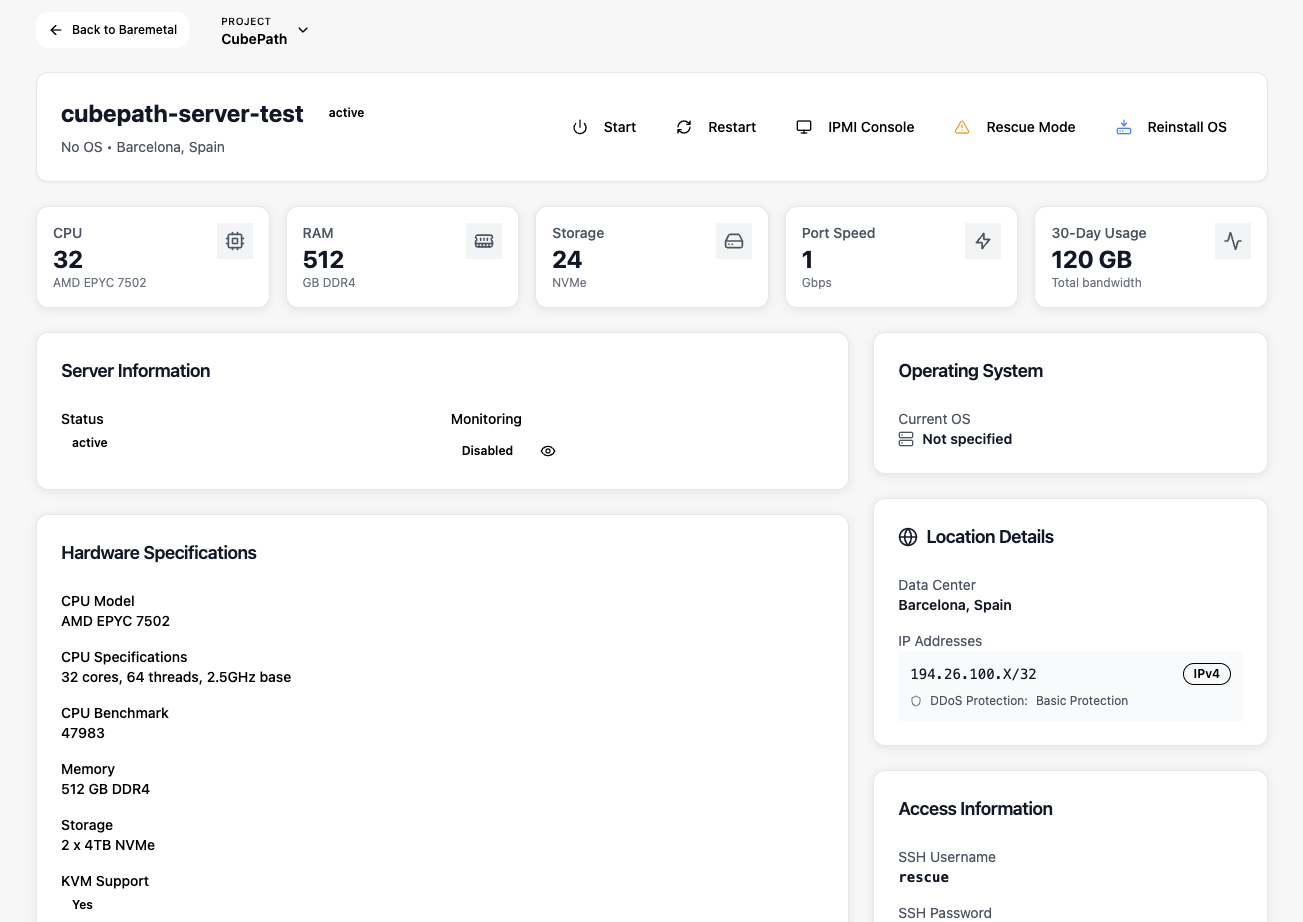
  • Просмотрите все активные серверы с указанием их характеристик, местоположения и назначенных IP-адресов.
  • Переустановите операционную систему на VPS и физическом сервере одним щелчком мыши.
  • Получите доступ к консоли IPMI для серверов без операционной системы.
  • Включайте, выключайте или перезапускайте любой сервер удаленно.
  • Управление частными сетями, плавающими IP-адресами и правилами брандмауэра.


Безопасность и защита от DDoS-атак
Защита от DDoS-атак в CubePath встроена в сеть и активна для каждого сервиса. Панель управления позволяет отслеживать работу системы защиты:

Списки контроля доступа (ACL) на периферии сети. Управляйте входящим трафиком к серверам из панели. Разрешайте или блокируйте определенные IP-адреса, порты и протоколы, не изменяя iptables или nftables на самом сервере. Правила применяются на сетевом уровне до того, как трафик достигнет экземпляра.

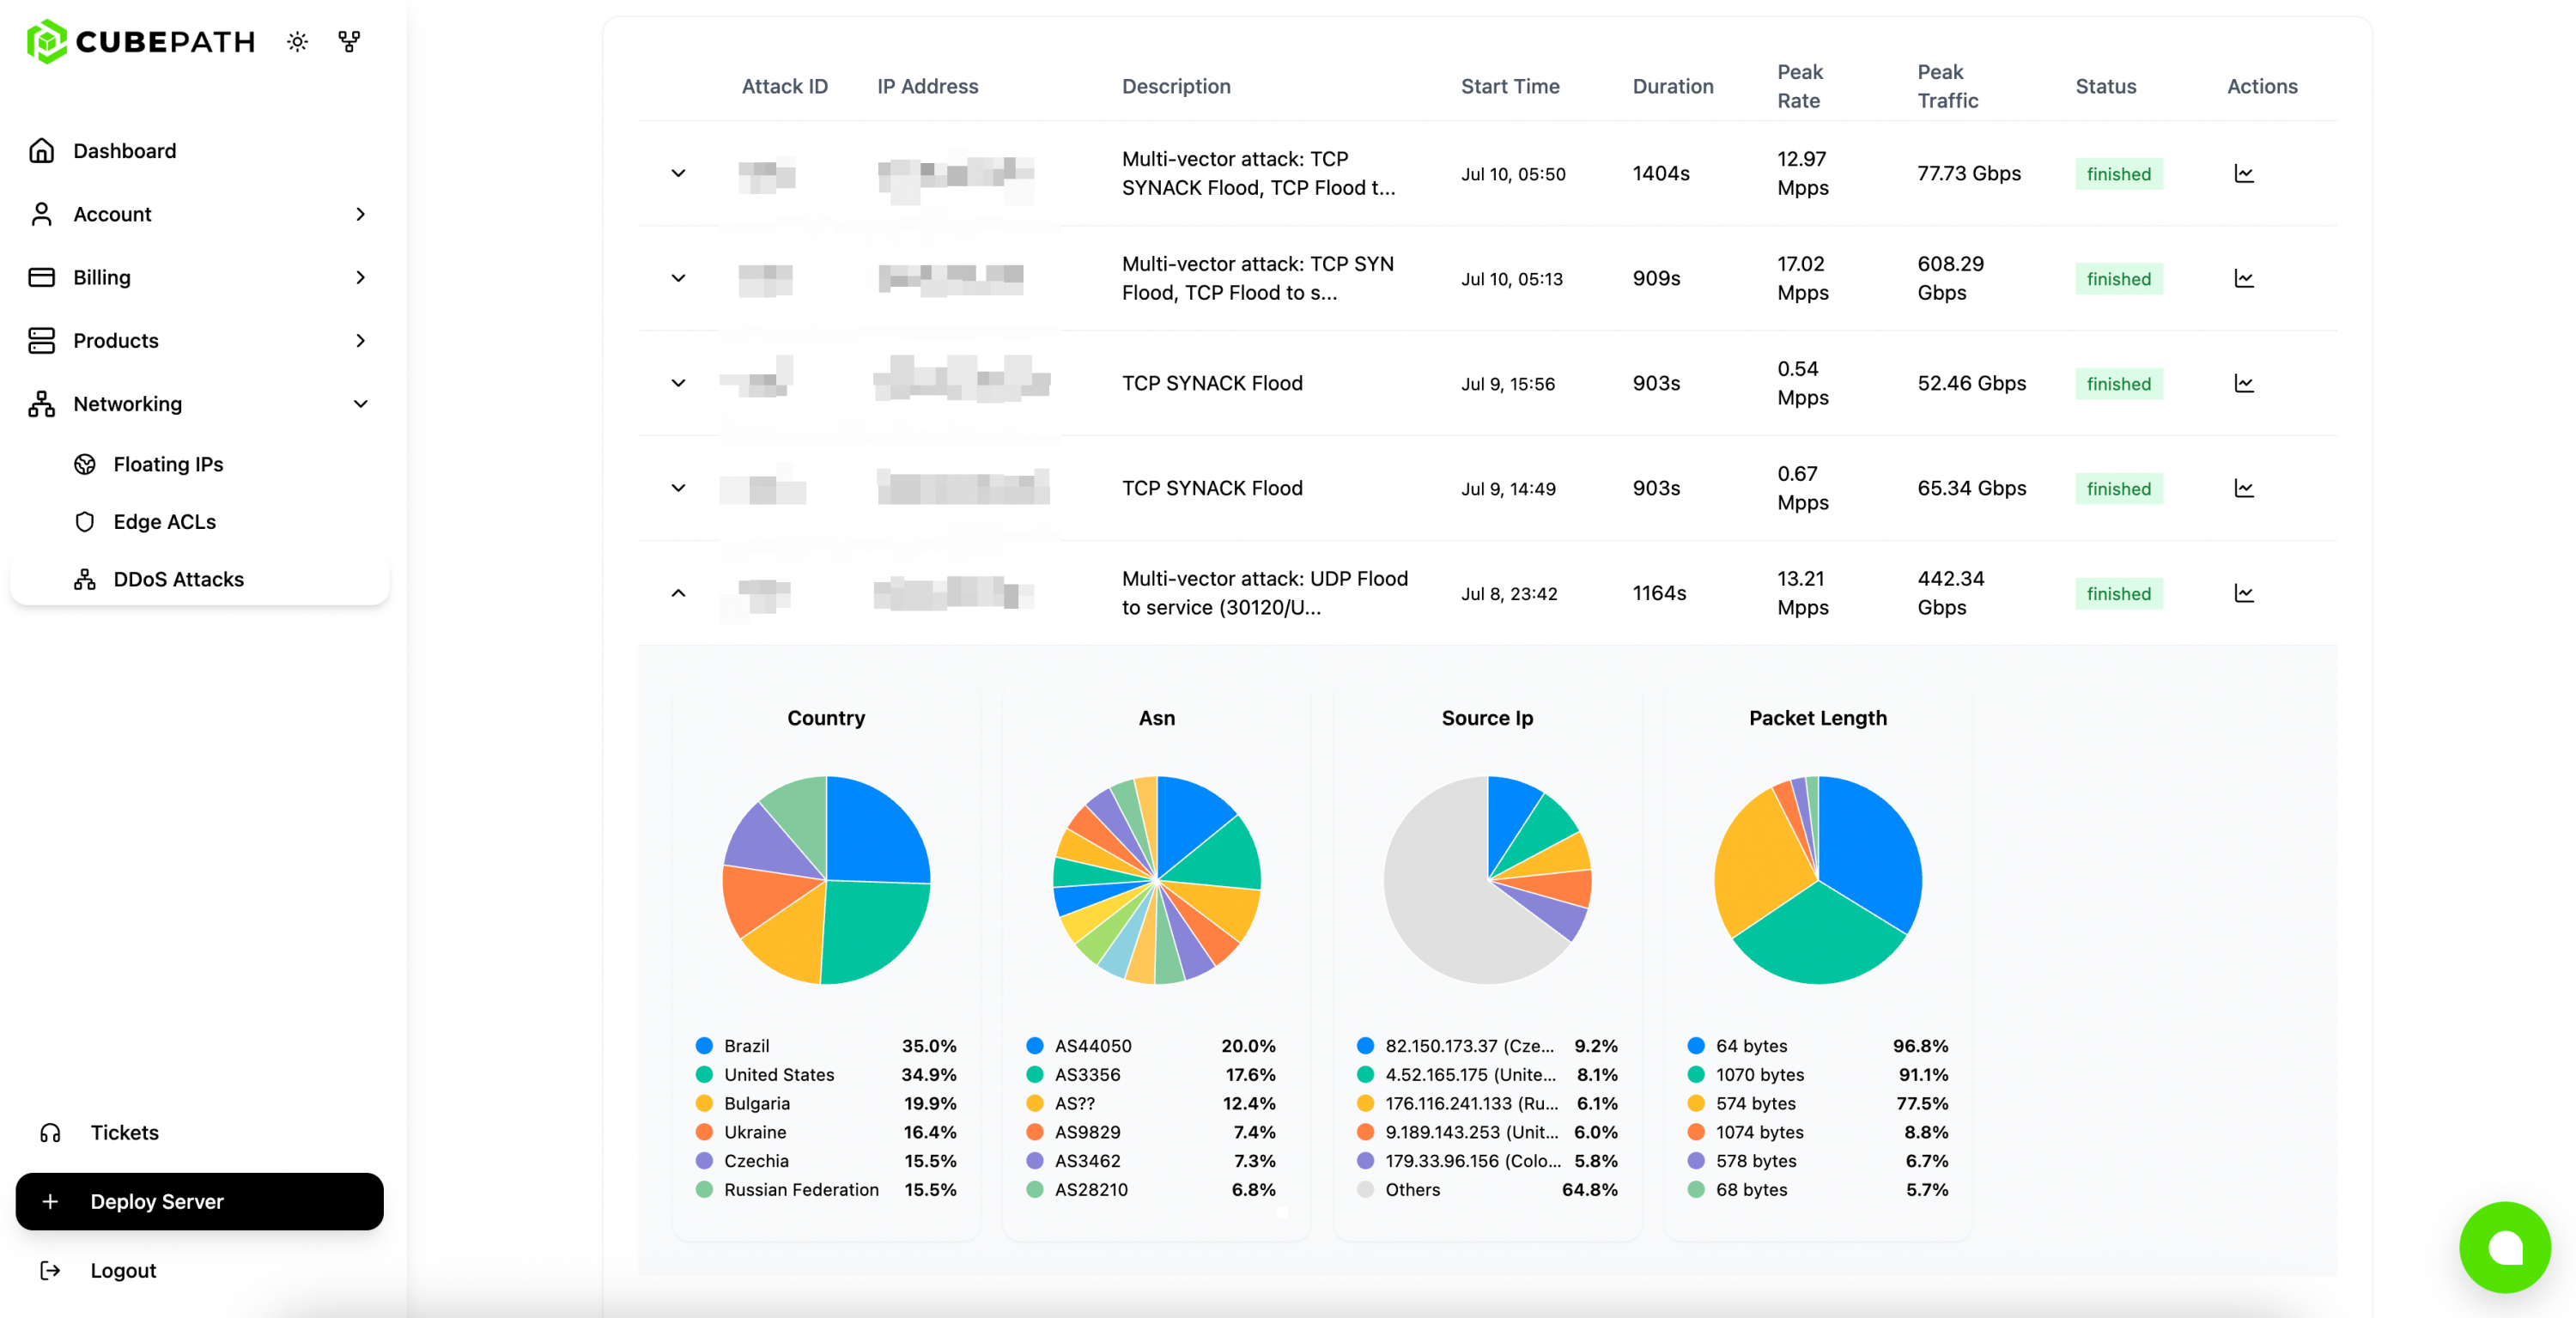
Метрики атак. Вы можете точно увидеть, когда произошли атаки, насколько они были масштабными, откуда они исходили и как были нейтрализованы. Эти данные доступны для каждого сервера, что обеспечивает четкое представление об угрозах для каждой службы.


CubeCLI и API
Панель предназначена для визуального управления, но все её функции также доступны программно.

API CubePath. Полностью документированный REST API доступен по адресу api.cubepath.com/docs. Каждому действию на панели соответствует конечная точка API. Создавайте пользовательские интеграции, автоматизируйте предоставление ресурсов или интегрируйте CubePath в существующие рабочие процессы.

CubeCLI. Официальный инструмент командной строки для управления инфраструктурой CubePath из терминала. Проект с открытым исходным кодом, доступен на GitHub по адресу github.com/CubePathInc/cubecli
  • cubecli vps create
  • cubecli vps list
  • cubecli baremetal deploy
  • cubecli lb create
  • cubecli network create

Провайдер Terraform. Определяйте инфраструктуру CubePath как код, версионируйте ее в Git и применяйте изменения с помощью стандартных рабочих процессов Terraform.

Для команд, автоматизирующих свою инфраструктуру, панель управления используется для мониторинга и отладки. API, CLI и Terraform используются для сборки и развертывания приложений.

Доступно сейчас
Новая панель управления доступна по адресу my.cubepath.com. Существующие клиенты были автоматически перенесены.

Что доступно с первого дня:
  • Полное управление VPS и физическими серверами.
  • Почасовая оплата для всех VPS-серверов.
  • Документированный REST API и CubeCLI
  • Частные сети, плавающие IP-адреса, DNS, балансировщики нагрузки
  • Списки контроля доступа на периферии сети и метрики DDoS-атак
  • Торговая площадка с развертыванием приложений в один клик.
  • Облачные оповещения с уведомлениями в Slack и по электронной почте.
cubepath.com
my.cubepath.com/register
dCAPTCHA: капча DDoS-Guard для защиты вашего сайта от спама


dCAPTCHA — новая самостоятельная услуга, которая не требует подключения защиты сайта или других услуг. В ее основе лежит механизм «невидимой» проверки браузера собственной разработки, который используется и в защите от DDoS.

Большинству легитимных пользователей будет достаточно один раз кликнуть на виджет и дождаться проверки браузера, чтобы не проходить ручную проверку с вводом символов — благодаря этому, dCAPTCHA минимально влияет на конверсию.

История проекта
Более 3 лет мы развиваем собственную капчу как часть системы противодействия DDoS. Это надежный инструмент, который мы контролируем и развиваем сами, чтобы не зависеть от сторонних сервисов. Все это время капча DDoS-Guard работает как последний этап проверки запроса.

Появление новой капчи не прошло незамеченным: компании под нашей защитой неоднократно просили использовать это решение в формах на своих сайтах. Видя интерес к новой капче со стороны сообщества, мы решили развивать ее не только как внутренний продукт, но и как отдельную услугу для защиты от спама.

Весь накопленный опыт мы воплотили в самостоятельный продукт dCAPTCHA, который вы можете уже сегодня подключить бесплатно.

Преимущества dCAPTCHA
Защита от ботов и спама не должна становиться преградой для ваших клиентов или непредсказуемой статьей расходов. Мы спроектировали dCAPTCHA так, чтобы объединить надежную фильтрацию трафика, комфорт для реальных посетителей и максимально честную финансовую модель.

Оплата только за успешные прохождения
В отличие от многих других капч, dCAPTCHA тарифицируется только по успешным прохождениям. Вы не платите за спам, поэтому отражение даже крупных атак ботов не увеличивает стоимость услуги.

Упрощенная проверка
Разрабатывая защиту, мы постоянно совершенствуем механизмы оценки пользователя по параметрам его запроса и браузера. Такой же механизм используется в dCAPTCHA для «невидимой» проверки. После первого клика на виджет dCAPTCHA система проводит автоматическую проверку — если пользователь признан легитимным, ему не придется решать капчу вручную.

Бесплатный тариф
На текущий момент на тарифе Базовый предоставляется до 100 000 прохождений в месяц бесплатно. С учетом того, что dCAPTCHA не учитывает проваленные проверки, такого количества прохождений вполне хватит для защиты всех форм небольшого сайта.

Для бесплатного тарифа предусмотрена гибкая и честная тарификация — вы сами выбираете действие при превышении лимита:
  • Если выбрано действие Пропускать все, dCAPTCHA автоматически пропустит все запросы сверх лимита без проверки, не блокируя форму для пользователей. При таком подключении dCAPTCHA для вас будет полностью бесплатной
  • Если выбрано действие Тарифицировать, dCAPTCHA продолжит проверять запросы сверх лимита, а в конце месяца будет выставлен счет за перерасход
  • Сейчас dCAPTCHA на стадии бета: мы развиваем услугу и добавляем функции, а лимиты увеличены для удобства тестирования

Роль dCAPTCHA в защите сайта
Зачем нужна dCAPTCHA, если уже есть защита сайта от DDoS? Защита от DDoS определяет и предотвращает нелегитимную нагрузку на сервер. Бот, который совершает несколько запросов раз в полчаса, не является угрозой для сервера, но может вредить бизнесу. dCAPTCHA решает проблему спамных запросов — проверяет легитимность конкретного посетителя перед выполнением целевого действия.

Примеры атак, от которых защищает dCAPTCHA
  • Спам в формы сайта. Вместо настоящих заявок и сообщений от пользователей бизнес получает поддельные заявки, тратит время и ресурсы на их обработку, упускает реальных клиентов. dCAPTCHA легко интегрируется прямо в HTML-форму и не дает ботам отправлять заявки.
  • Спам сообщениями. Если сайт дает посетителям писать сообщения или публиковать записи, злоумышленники могут воспользоваться этим — публиковать несогласованную рекламу или просто попытаться «обвалить» площадку тысячами сообщений. dCAPTCHA перед отправкой сообщения не позволит злоумышленникам автоматизировать отправку спама.
  • Атаки на бизнес-логику. При целенаправленной атаке на сайт боты могут автоматически выполнять действия, которые нагружают бизнес-логику приложения. Например, атакуя интернет-магазин, боты могут добавлять максимальное возможное количество товаров в корзину, чтобы нагрузить сервер и базы данных. dCAPTCHA можно использовать не только в формах, но и для защиты от любых других действий на сайте.

Как подключить
Подключить dCAPTCHA можно двумя способами — оформить заказ на сайте или добавить услугу в личном кабинете, если вы уже используете услуги DDoS-Guard.

На сайте. Перейдите на страницу dCAPTCHA, выберите тариф и оформите заказ.

В личном кабинете.
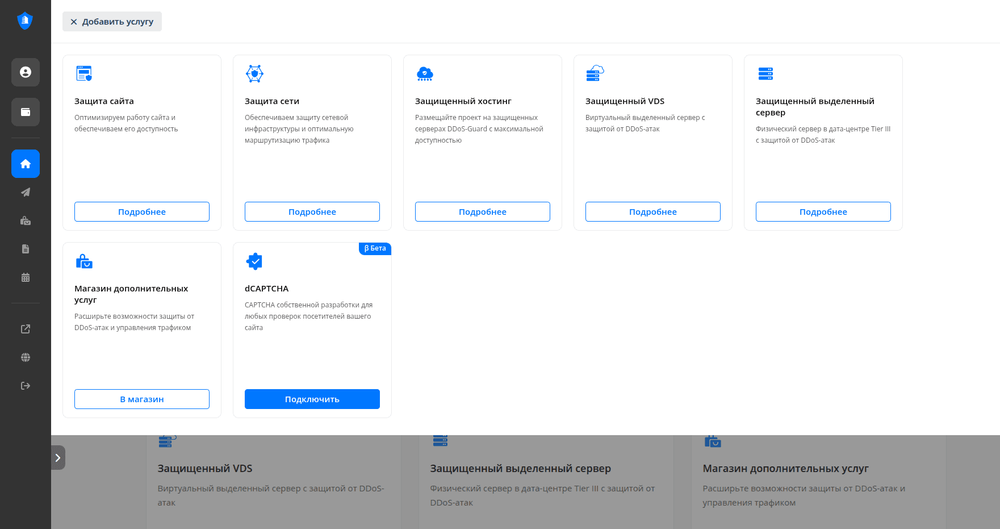
  • В левом верхнем углу нажмите + Добавить услугу
  • Выберите dCAPTCHA и нажмите Подключить
  • Выберите тариф и завершите оформление заказа


Настройка и интеграция
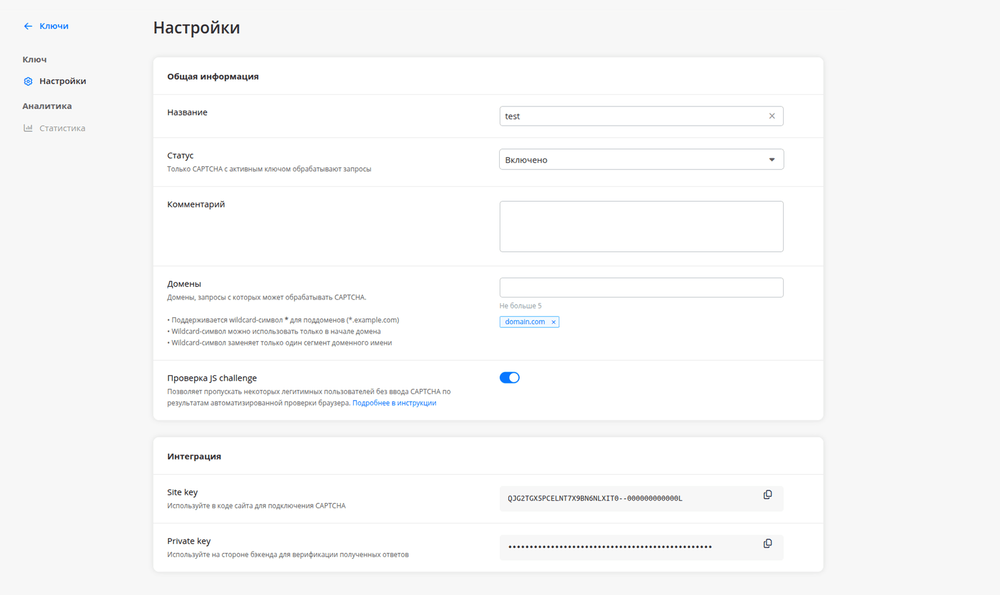
После оформления создайте ключ dCAPTCHA и встройте виджет в формы. Подробнее о подключении dCAPTCHA на сайт читайте в инструкции по интеграции.


ddos-guard.ru

Большая неделя для поставки МВт (много МВт)

Не менее 17 новых сотрудников присоединяются к нашим командам!
3 техника по дата-центрам, 6 электриков с дипломом Bac Pro MELEC, 2 промышленных электрика, 1 прораба, два ассистента по управлению, 1 архитектор, специализирующийся на BIM, 1 специалист по исследованиям в области CVC, 1 специалист по исследованиям в области электричества


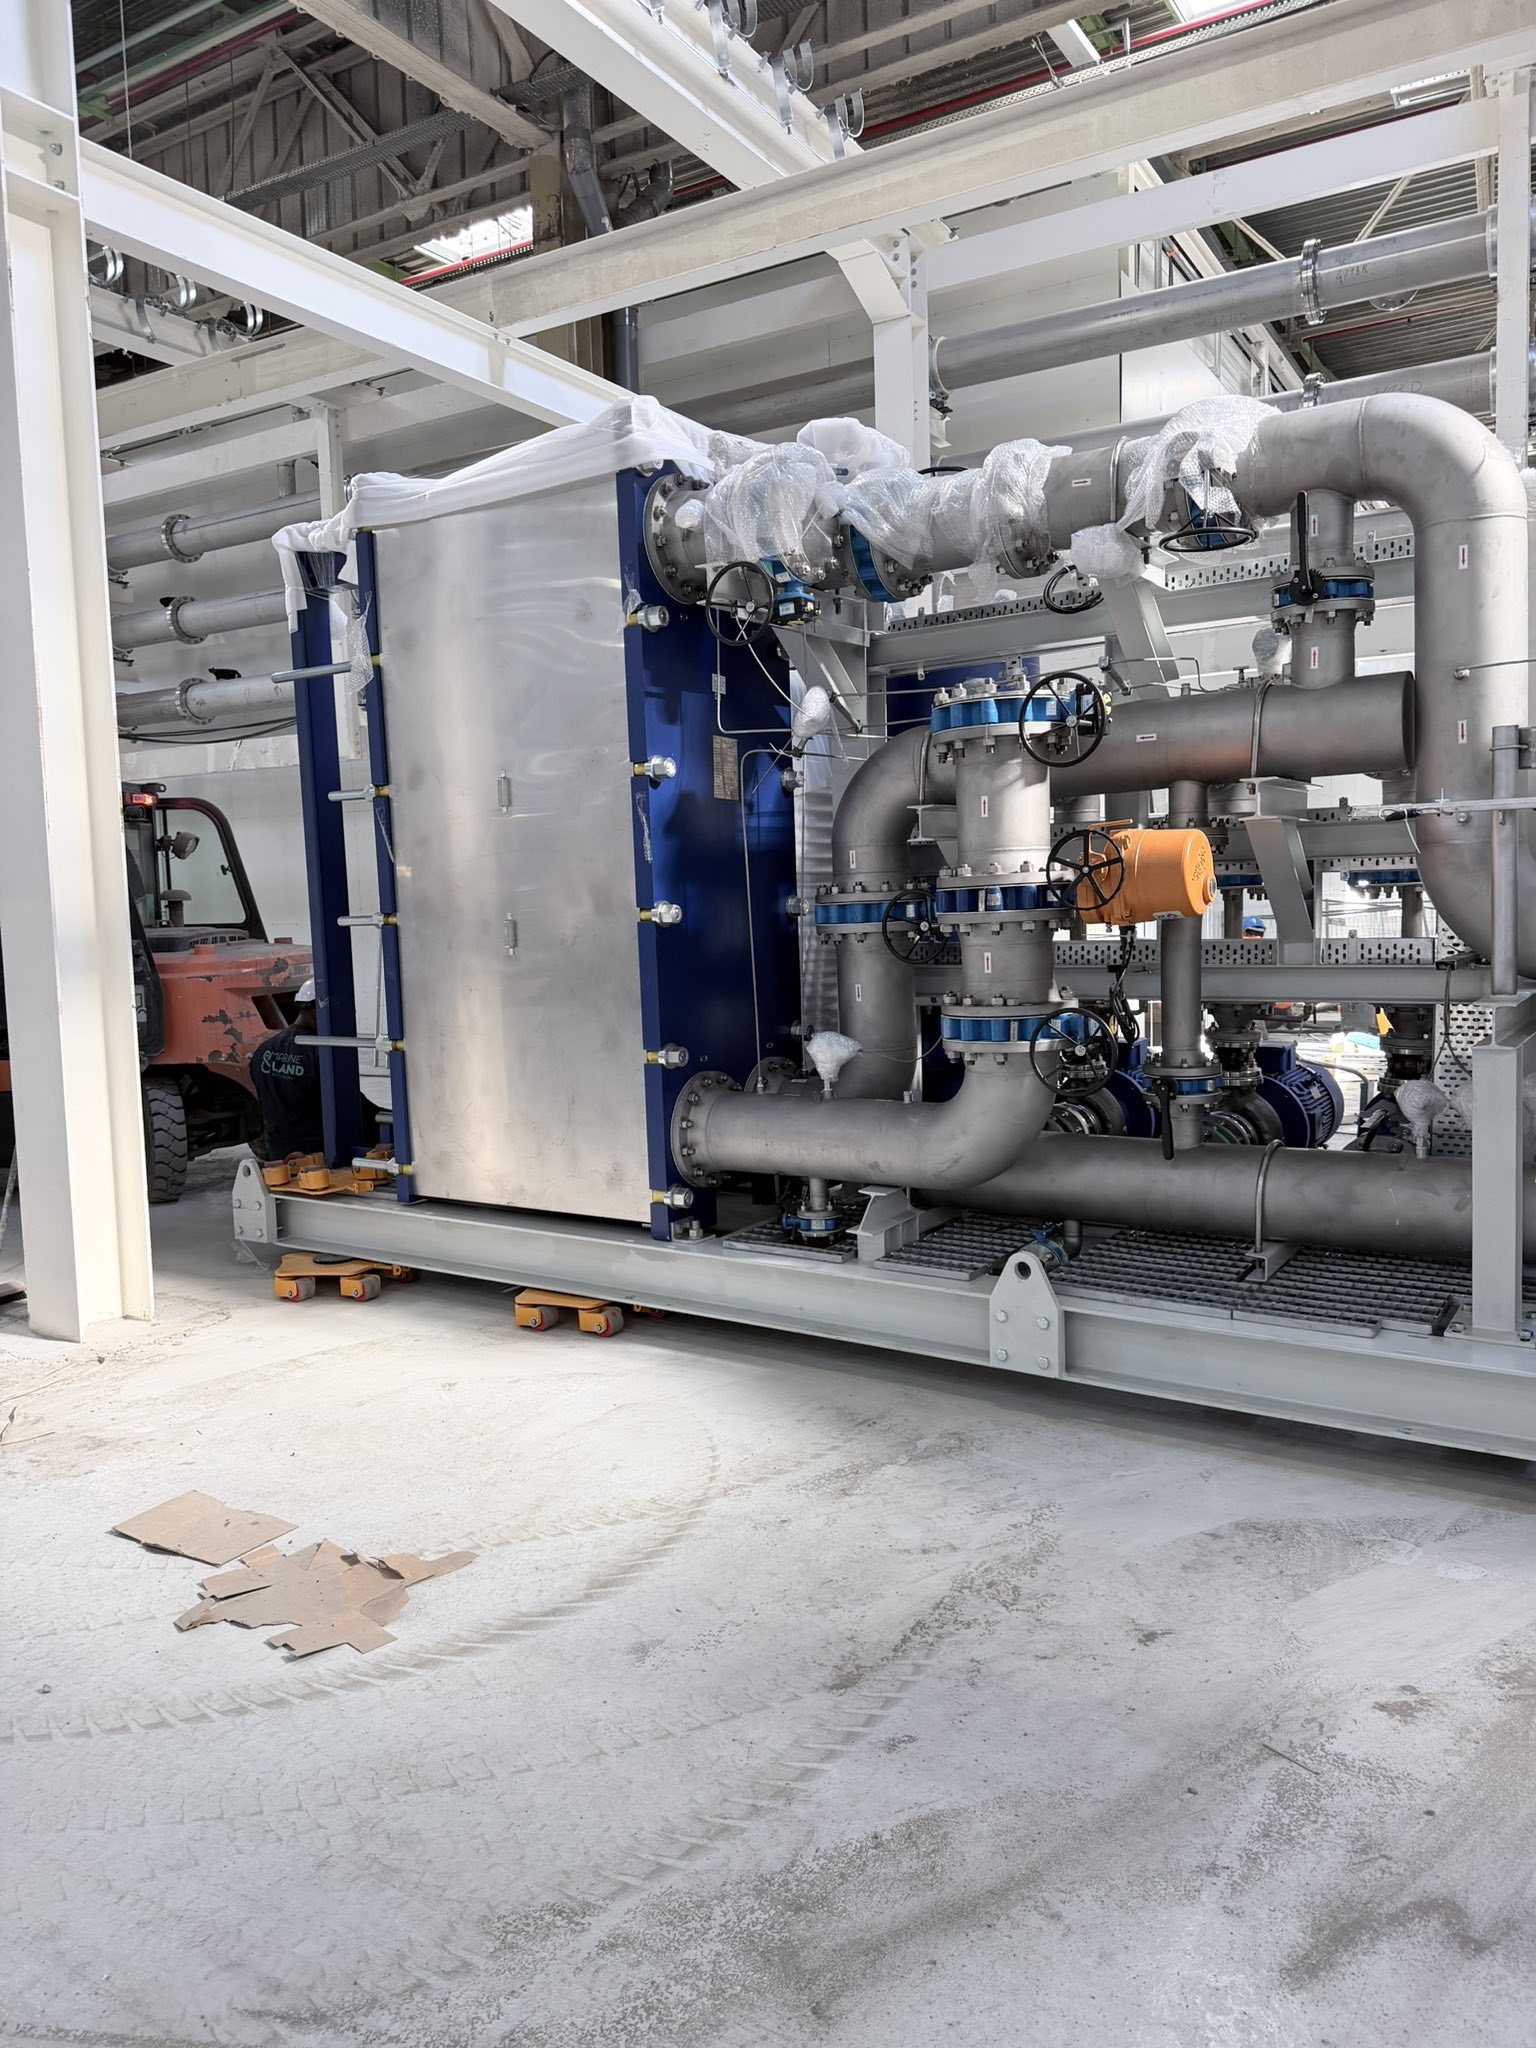
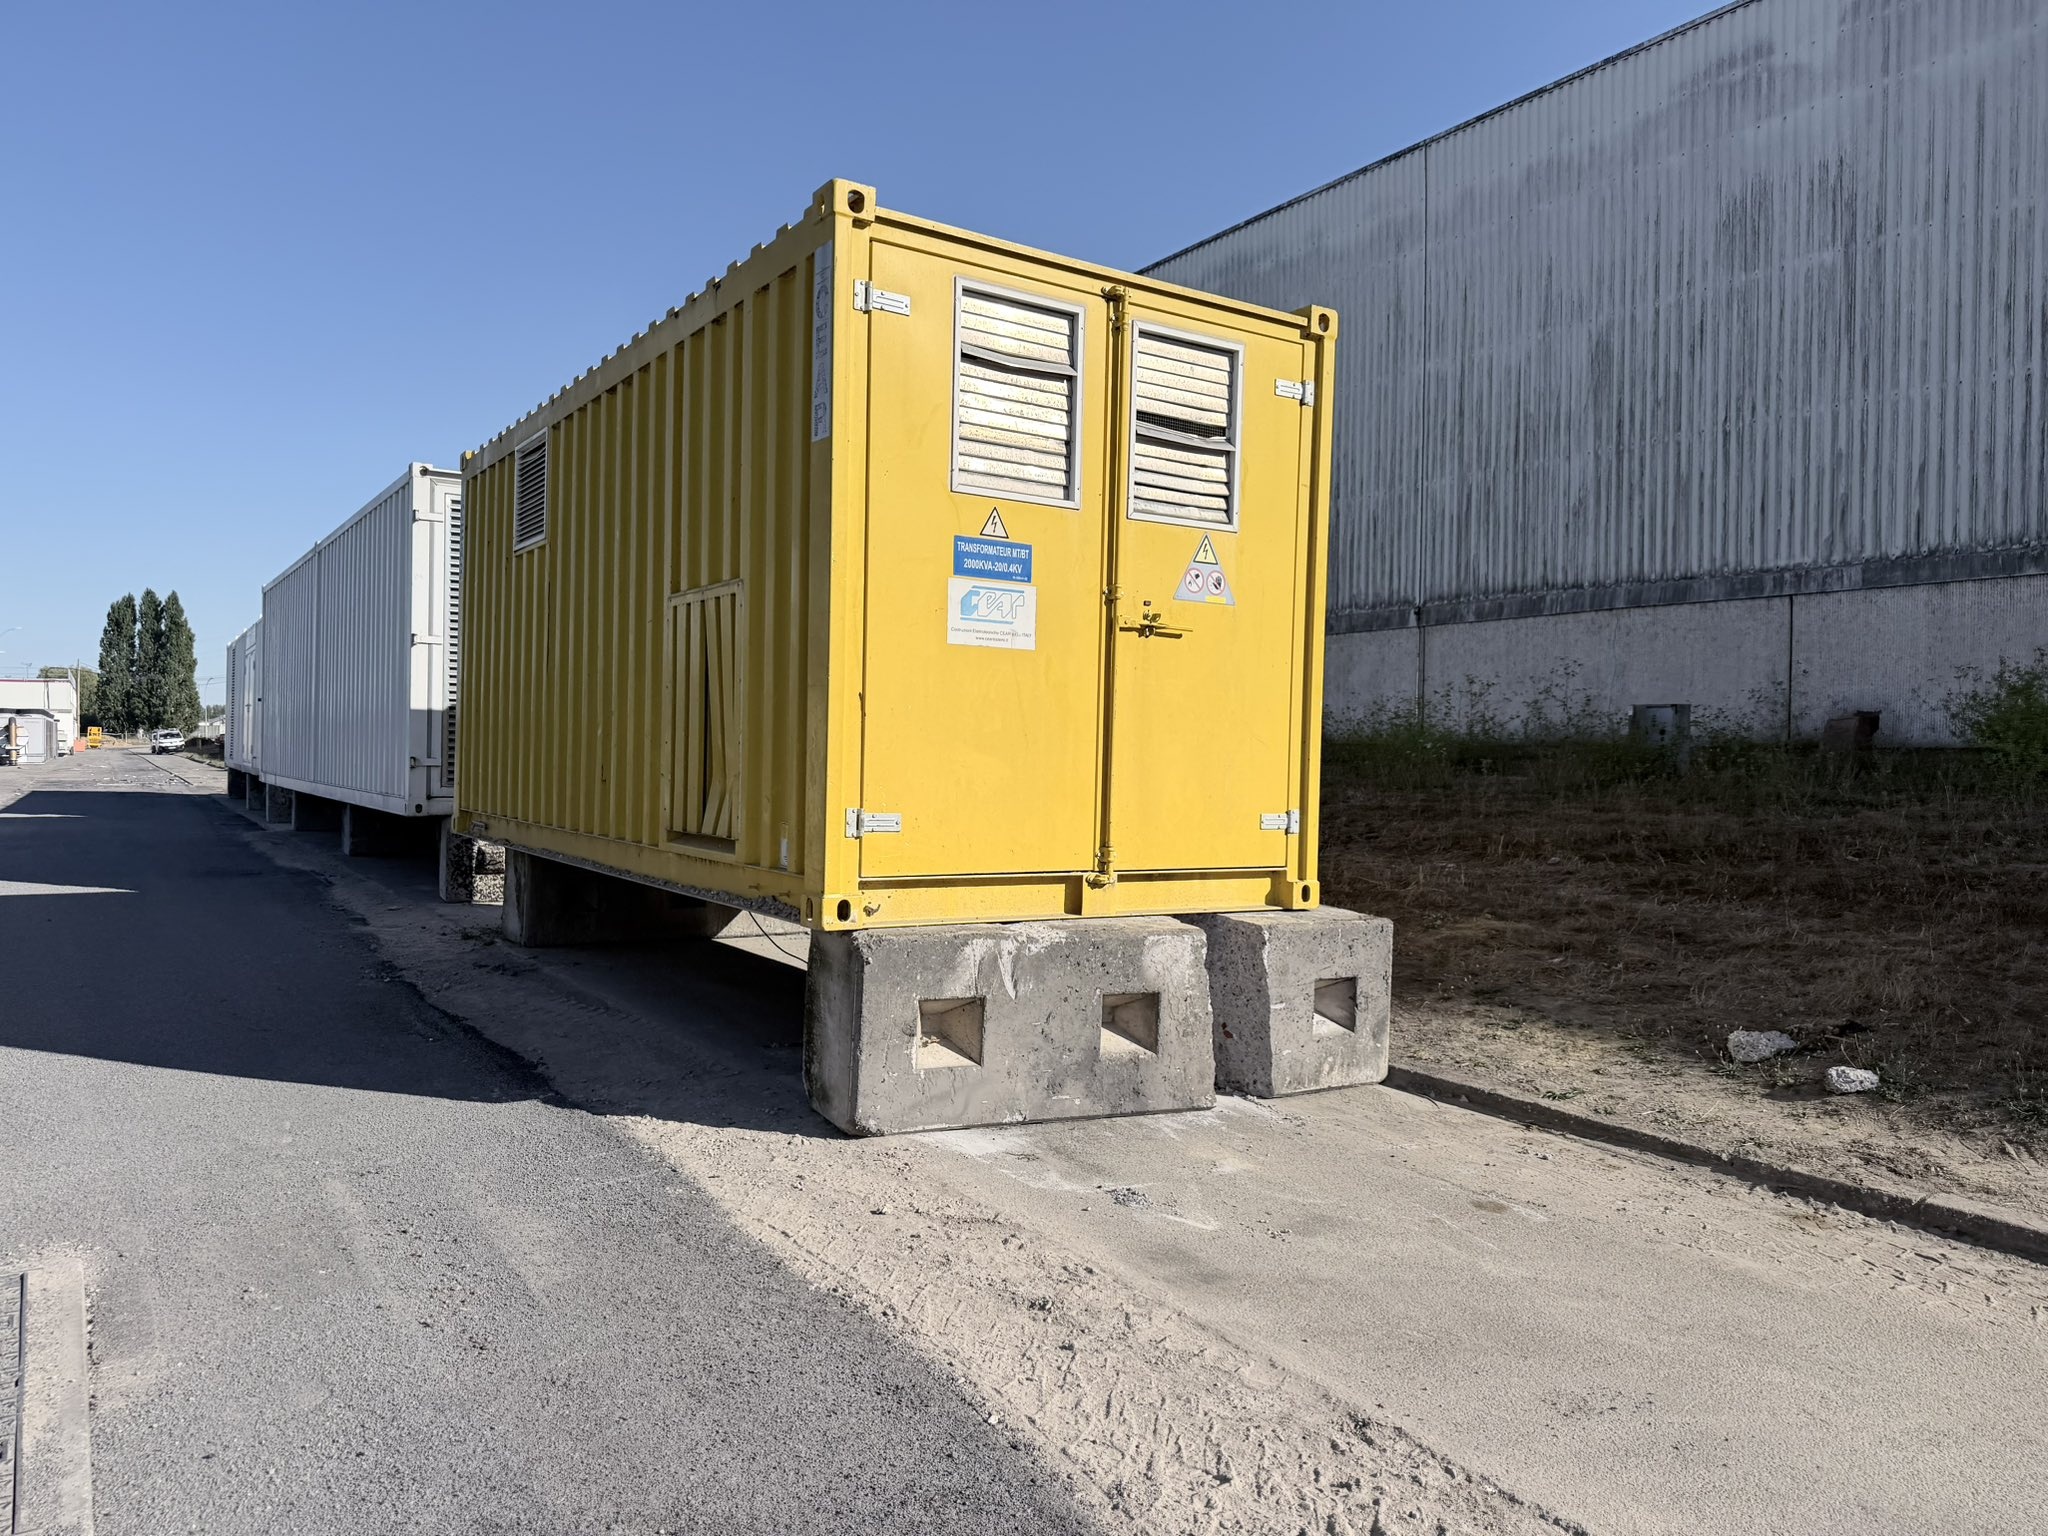
Предоставление и подключение контейнеров HTA, дизель-генераторных установок, прокладка кабелей


Возвращение к основам


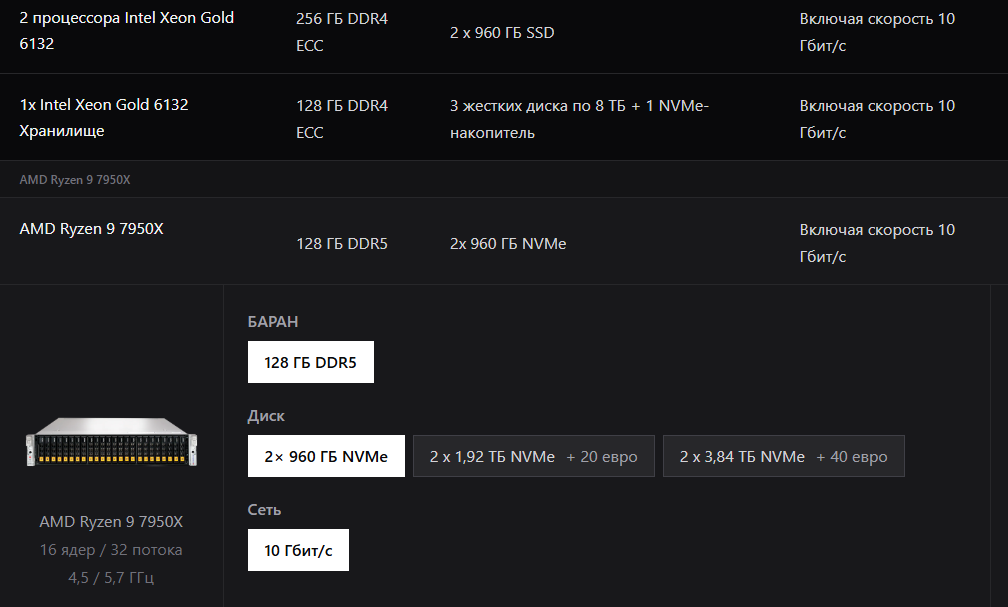
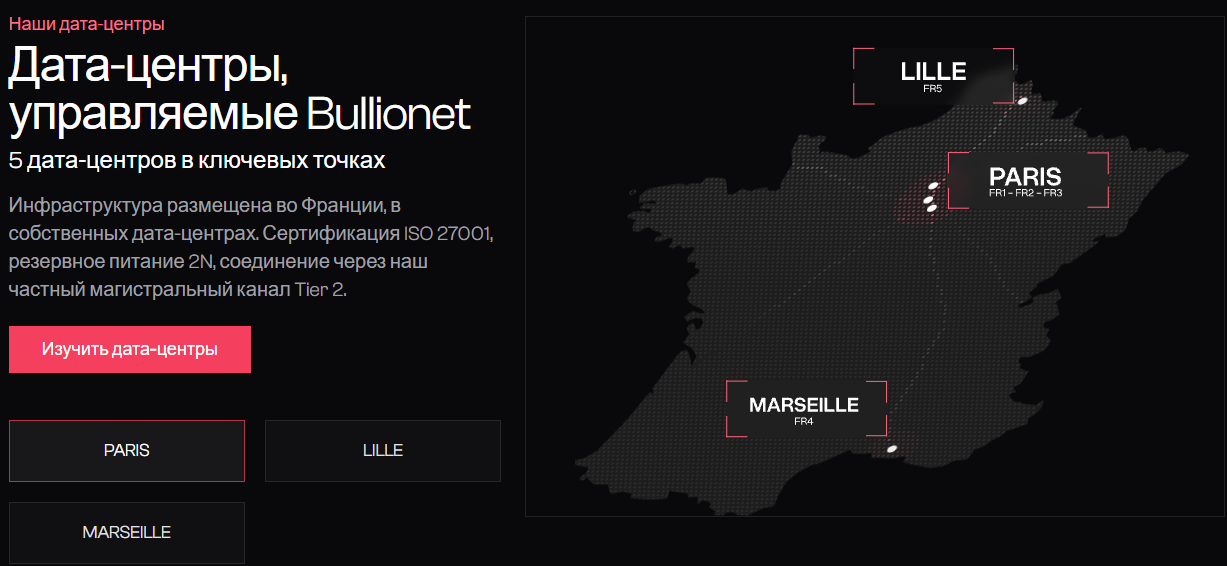
Мы воспользовались повышением цен у наших (крупных) конкурентов, чтобы запустить бренд, связанный с нашей услугой выделенных серверов: bullionet.com/fr Почти 200 серверов уже арендованы! Размещено на наших площадках в Велизи (PAR3) и скоро в Марселе и Лилле.

bullionet.com
bullionet.com/ru
bullionet.com/de
bullionet.com/fr


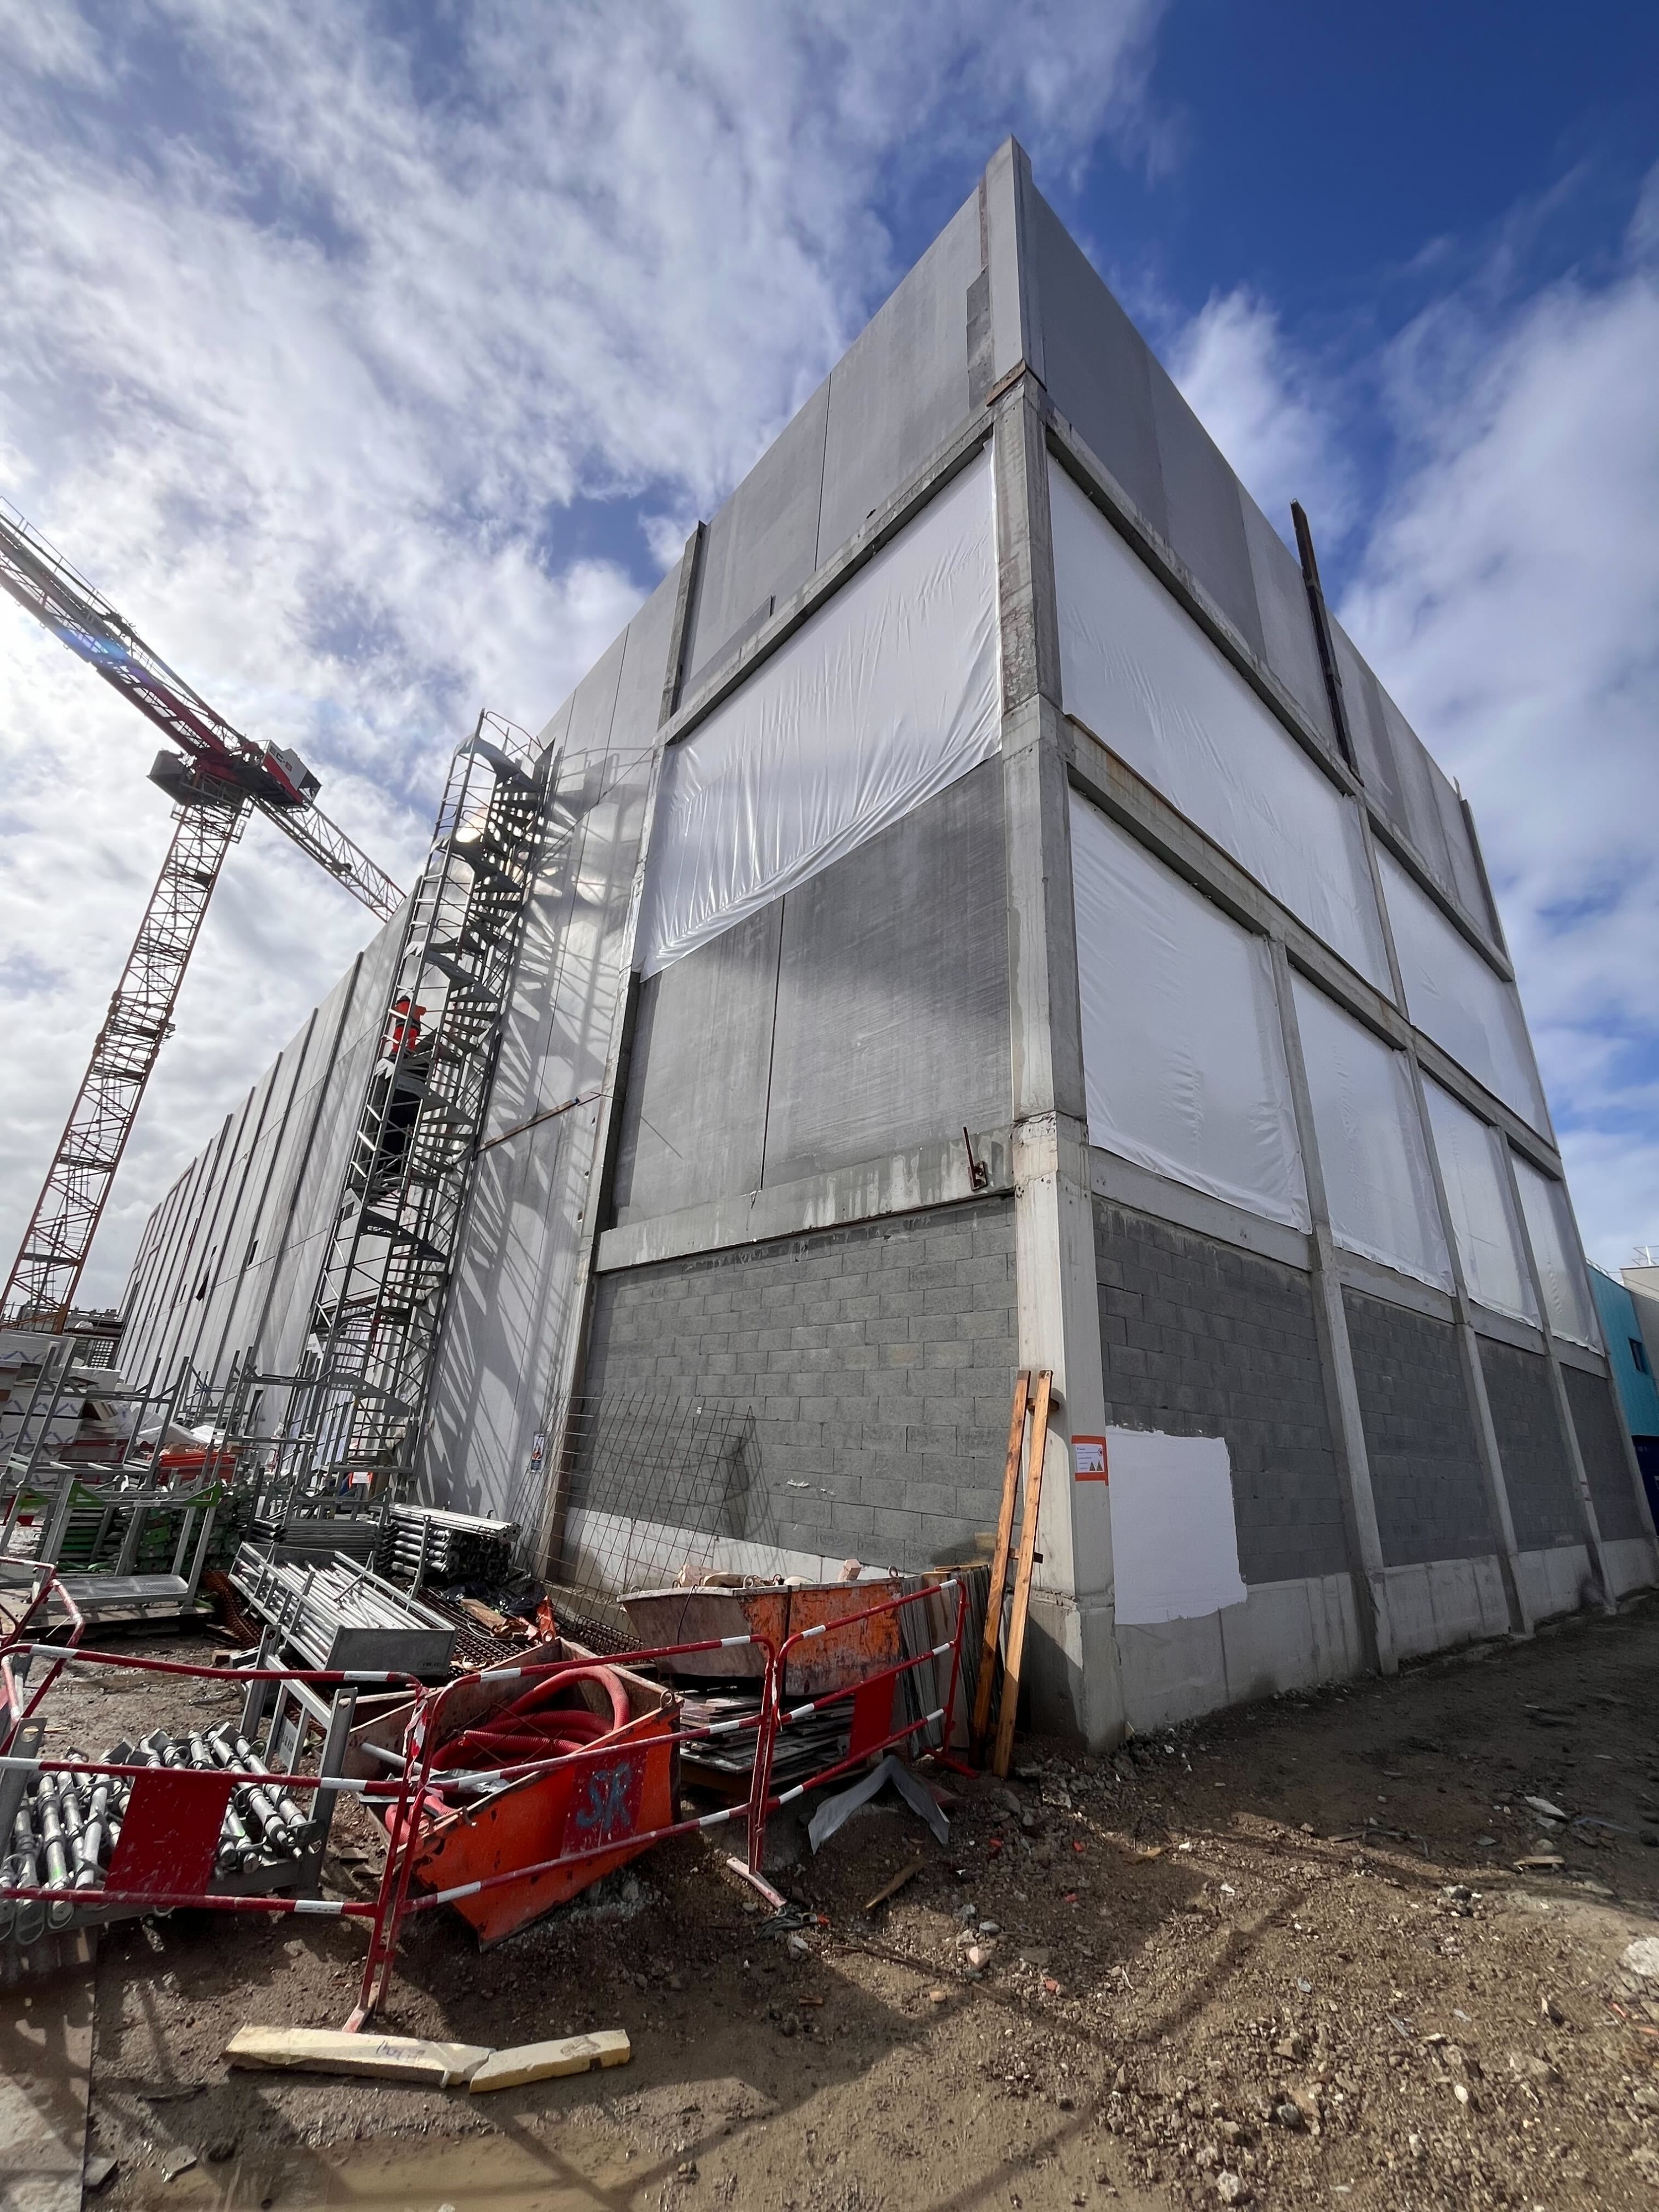
Расширение на 7,1 МВт для DC3 в Витри-сюр-Сен

Расширение на 7,1 МВт для DC3 в Витри-сюр-Сен, нашего исторического флагманского дата-центра. Первый в длинной серии, основанный на совершенно новом концепте, придуманном 2 года назад с моими командами, изначально DLC, высокой плотности и масштабируемый по требованию.


Что выбрать для сервера, EPYC или Ryzen?


Клиенты хостинга условно делятся на две группы. Одни приходят с готовым техническим заданием, знают, какой процессор им нужен и почему. Другие только начинают свой путь и смотрят на витрину с легким недоумением. У второй группы часто возникает один и тот же вопрос. Почему две конфигурации с похожей оперативной памятью, дисками и сетью отличаются по цене примерно на 5000 рублей в месяц, и единственное видимое различие там — процессор.

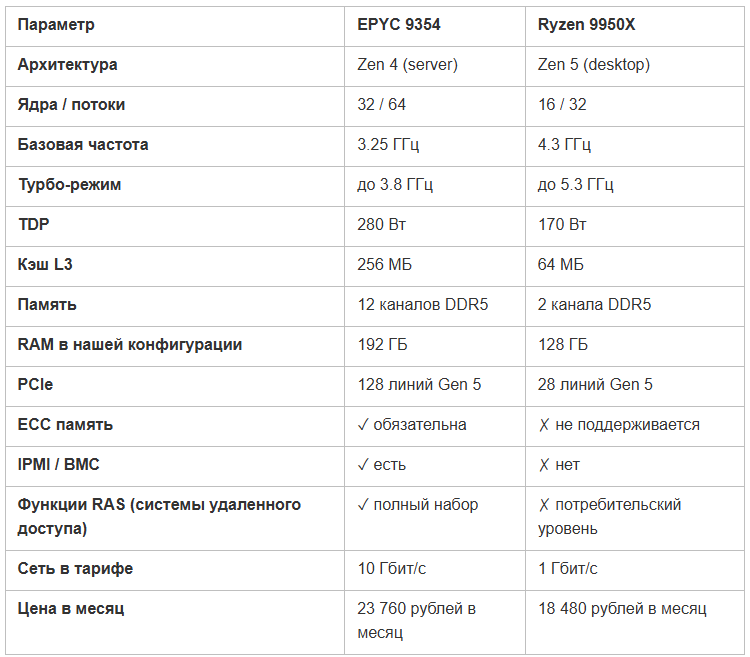
Например, рассмотрим пример из нашей линейки. Ryzen 9950X с его 16 ядрами, частотой до 5,7 ГГц по спецификации производителя и TDP 170 Вт обойдётся в 18 480 рублей в месяц (221 760 рублей в год). Рядом расположился EPYC 9354 с 32 ядрами, частотой до 3,8 ГГц и TDP 280 Вт за 23 760 рублей в месяц (285 120 рублей в год). У первого частота выше почти в полтора раза, а цена при этом ниже. У второго вдвое больше ядер и серверная архитектура. По одной лишь таблице характеристик невозможно сказать, какой из них «быстрее», т. к. ответ зависит от задач, которые на нем будут выполнять.

Нам стало интересно посмотреть на это не в формате «теоретически EPYC лучше для серверов, потому что он серверный». Хотелось получить цифры с обеих машин в идентичных условиях. Мы прогнали обе ноды через одинаковый набор из 25 тестов. Туда вошли синтетика на центральный процессор, OpenSSL, STREAM по памяти, fio по дискам, pgbench, Redis, nginx, multi-tenant сценарий с десятью параллельными нагрузками и 30-минутный термальный стресс. Дальше по разделам разберем, где Ryzen реально впереди, где он проигрывает, и в каких случаях разница в 5 с лишним тысяч рублей в месяц окупается.

Конфигурация тестовых машин
Перед тем как переходить к результатам тестирования, нужно зафиксировать, что именно сравнивается. Два сервера разной архитектуры, и почти все различия в дальнейших тестах объясняются именно тем, что записано в таблице ниже.


По первым двум строкам уже понятно, что мы увидим в тестах. Микроархитектура Zen 5 у Ryzen 9950X новее, IPC и частоты выше, поэтому в однопоточных задачах он впереди. В многопоточных всё решает количество ядер, а тут их 32 против 16. Там, где нагрузка упирается в память, играют роль 12 каналов DDR5 против 2.

Дисковая подсистема в сравнении не участвует. На двух стендах стояли накопители NVMe разной ёмкости и поколений, поэтому результаты fio между машинами некорректны. Все цифры в статье относятся к процессору и памяти.

На стенде с Ryzen 9950X одновременная многопоточность (SMT, Simultaneous Multithreading) недоступна на уровне платформы. Контроллер процессора возвращает статус not supported, и процессор работает в режиме 16 потоков на 16 ядрах. Это не временная настройка для тестов, а штатная конфигурация, в которой сервер передаётся клиенту. Условия обслуживания запрещают любые изменения в BIOS, поэтому ситуация для всех арендаторов будет одинаковой. У EPYC многопоточность включена, что даёт 64 потока на 32 ядрах. Этот момент важно держать в голове при чтении многопоточных тестов ниже, поскольку цифры Ryzen в них отражают именно ту производительность, которую получит реальный клиент, а не теоретический потолок процессора в лабораторных условиях.

Где Ryzen быстрее и почему
В сравнении двух процессоров есть сценарии, где Ryzen 9950X показывает результат лучше. Посмотрим, на каких именно тестах это произошло и насколько эти цифры переносятся на реальную нагрузку в продуктовой среде.

Однопоточная производительность
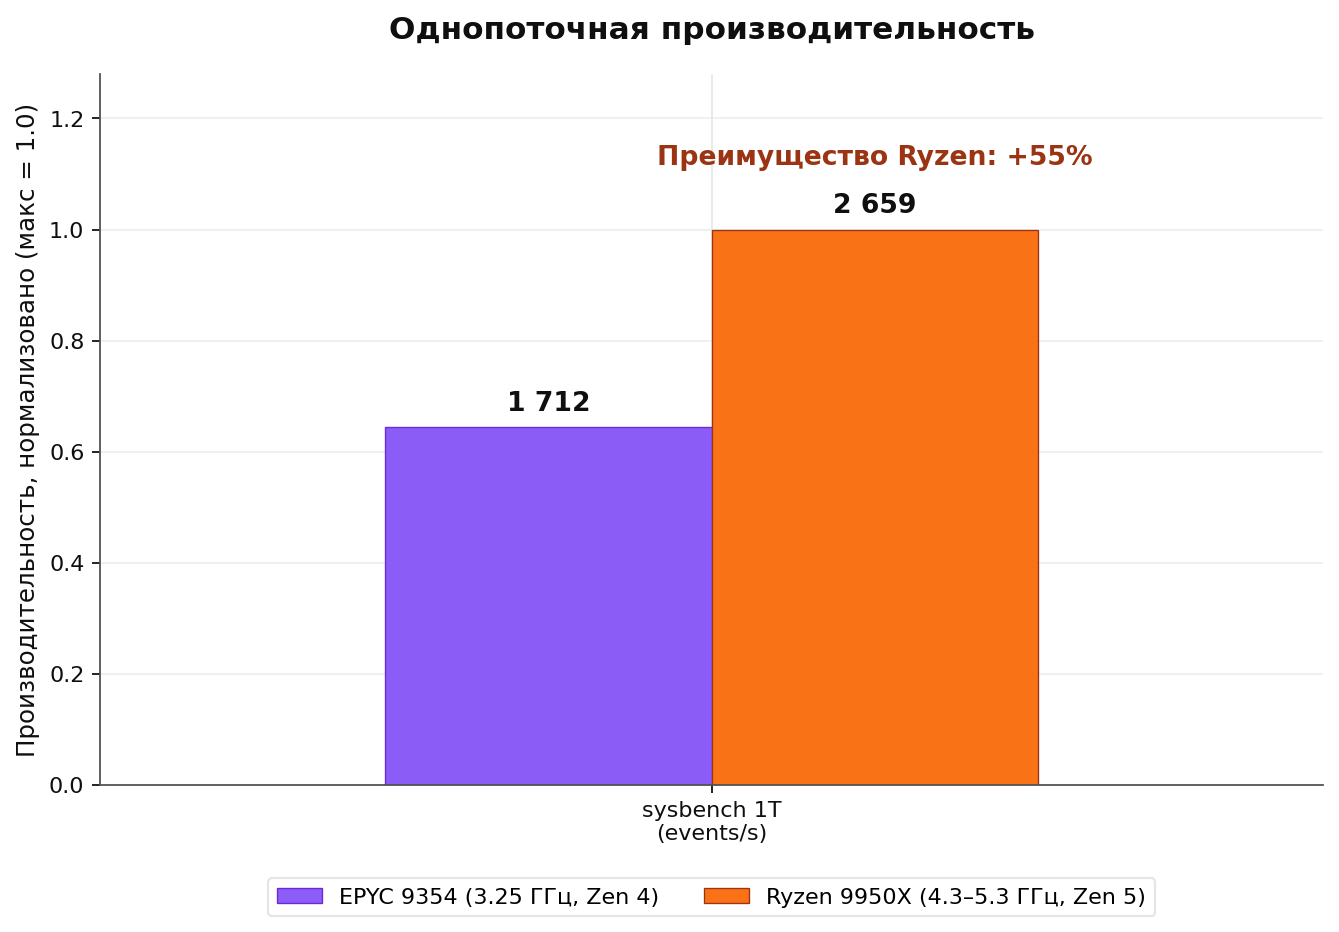
Тест Sysbench в один поток показывает, насколько быстро одно ядро успевает прокрутить заданный набор операций. Ничего постороннего в работу не вмешивается, нет ни конкуренции за память, ни блокировок.


Разрыв Ryzen относительно EPYC составляет около 55%. Объясняется он сочетанием двух факторов: частоты и поколения архитектуры. У Ryzen 9950X базовая частота 4,3 ГГц, тогда как у EPYC она 3,25 ГГц. К этому добавляется архитектура Zen 5 с заметно подросшим количеством инструкций, выполняемых за такт (IPC), относительно Zen 4.

Понять, где эта разница имеет значение на практике, несложно. Она даёт о себе знать в любой задаче, где узким местом становится один поток. Самый частый случай — это Node.js до того момента, как процессы разведены через кластер. Сюда же относятся скрипты на командной оболочке Bash, обработка данных на языке программирования Python без распараллеливания, а также компиляция небольших модулей, где параллелизм просто негде взять. На подобных сценариях разница в 55% будет хорошо ощущаться.

nginx и Redis, потолок процессора без сетевых ограничений
Приведённые ниже цифры требуют небольшого предварительного пояснения. Они показывают теоретический максимум процессора при идеальных условиях, без участия физической сети, и в реальной эксплуатации картина будет совсем другой. Подробно про это ниже, но сразу зафиксируем рамку, чтобы абсолютные значения никого не вводили в заблуждение.


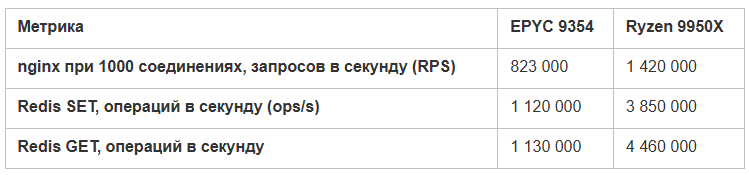
Разрыв в пользу Ryzen на веб-сервере nginx составил около 72%, на операции записи Redis SET почти в три раза, а на операции чтения Redis GET почти в четыре. Выглядит внушительно. Тут стоит остановиться и проговорить, что именно эти цифры измеряют, а что нет.

Оба теста проводились по петле обратной связи (loopback, адрес 127.0.0.1), т. е. клиент и сервер живут на одном хосте, а пакет не уходит в сетевой стек дальше виртуального интерфейса. Таким образом измеряется верхний потолок самого приложения и процессора, насколько быстро nginx или хранилище данных Redis способны принять и отдать ответ при полном отсутствии сетевых задержек.

В реальной нагрузке картина выглядит иначе. В продуктовой среде Redis и nginx обслуживают клиентов по сети, что накладывает физические ограничения. В нашем тарифе Ryzen 9950X идёт с сетью 1 гигабит в секунду, а у EPYC 9354 в той же позиции стоит сеть 10 гигабит. Если перевести в более привычные единицы, 1 гигабит в секунду даёт около 125 мегабайт пропускной способности в секунду, и из этого еще нужно вычесть накладные расходы на заголовки протокола передачи данных (TCP), заголовки протокола передачи гипертекста (HTTP) и сам запрос. Фактический потолок окажется где-то в 2–3 раза ниже теоретического.

Размер ответа в этом сценарии становится определяющим. На крошечных ответах в 100 байт Ryzen может приблизиться к loopback-цифре, поскольку сеть в 1 Гбит/с такие запросы пропускает в большом количестве. На типичных ответах HTTP размером 1–10 килобайт потолок по сети будет в районе 12–125 тысяч запросов в секунду, и здесь Ryzen упрётся в сеть задолго до того, как упрётся в процессор. У EPYC сетевой потолок выше в десять раз.

Это вовсе не означает, что loopback-цифры бесполезны. Они показывают реальную производительность центрального процессора (CPU) на этой задаче, и если завтра поставить ту же машину в сеть 10 Гбит/с, потолок самого процессора останется прежним. Просто эти цифры отвечают на вопрос «сколько способен выжать процессор», а не на вопрос «сколько запросов реально дойдёт до клиентов».

Картина складывается следующая. Однопоточные задачи и тесты без сетевого упора — это действительно сильная сторона Ryzen, и тут он быстрее по вполне объяснимым причинам. Дальше в статье речь пойдёт о сценариях, где картина меняется. Это многопоточная нагрузка, упор в память и длительная работа под высокой температурой.

Где EPYC показывает себя лучше
В предыдущем разделе мы разобрали сценарии, в которых Ryzen 9950X выходит вперёд. Теперь же перейдём к тестам, где картина выглядит иначе. Перед тем как переходить к цифрам, стоит напомнить одну важную деталь конфигурации. На стенде с Ryzen одновременная многопоточность (SMT) недоступна на уровне платформы, и центральный процессор (CPU) видит 16 потоков на 16 ядрах вместо потенциальных 32. У EPYC многопоточность включена, что даёт 64 потока на 32 ядрах. На некоторые из тестов ниже это влияет напрямую, и цифры Ryzen в них отражают реальный результат для конечного клиента, а не лабораторный максимум.

Пропускная способность памяти, тест STREAM
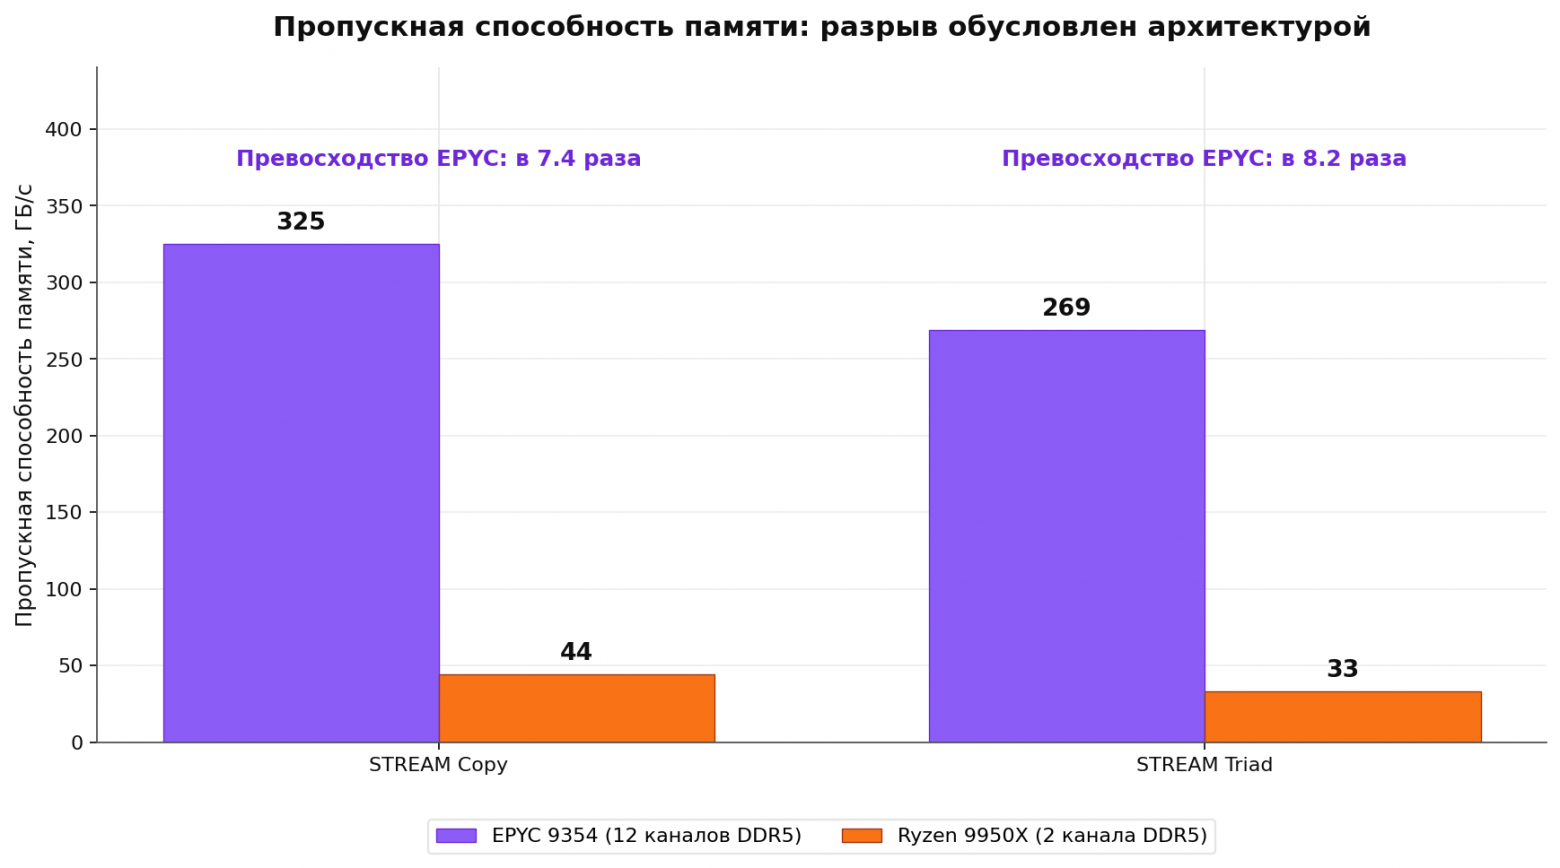
Это самый показательный по разрыву тест из всей подборки. STREAM измеряет, насколько быстро процессор и подсистема памяти умеют перекачивать данные. Это не синтетика ради синтетики, она напрямую коррелирует с производительностью всего, что упирается в оперативную память.


Разрыв здесь составляет примерно 7–8 раз. Причина кроется не в настройке или прошивке, а в самой архитектуре. У EPYC 9354 предусмотрено 12 каналов памяти DDR5, тогда как у Ryzen 9950X их всего 2. Получается шесть каналов друг против друга, каждый со своей шиной. Подобное соотношение не оптимизируется ни драйверами, ни ядром, поскольку это плата с разводкой под двенадцать слотов оперативной памяти против платы с разводкой под четыре слота. Многопоточность здесь ни при чём, ведь в STREAM упор идёт не в потоки, а в пропускную способность.

На практике это означает следующее. Любая нагрузка, в которой данные не помещаются в кэш и постоянно ходят между ядрами и памятью, на EPYC будет работать заметно быстрее. К типичным примерам относятся базы данных, работающие в оперативной памяти (in-memory), такие как Redis при большом объёме данных и Memcached, а также аналитические запросы по большому объёму данных, вывод моделей машинного обучения (inference) на процессоре и любые приложения, оптимизированные под архитектуру памяти с неравномерным доступом (NUMA).

В разделе про nginx и Redis на петле обратной связи мы видели обратную картину, там Ryzen был впереди в несколько раз. Никакого противоречия здесь нет, просто речь идёт о двух разных режимах работы. Redis в loopback-тестах гоняет короткие операции на маленьких ключах, всё помещается в кэш процессора, и частота оказывается важнее пропускной способности. Как только объем данных вырастает за пределы кэша третьего уровня (L3), а это 256 МБ у EPYC против 64 МБ у Ryzen, или нагрузка становится по-настоящему параллельной, узким местом становится память, и расстановка сил меняется.

Многопоточная нагрузка на процессор
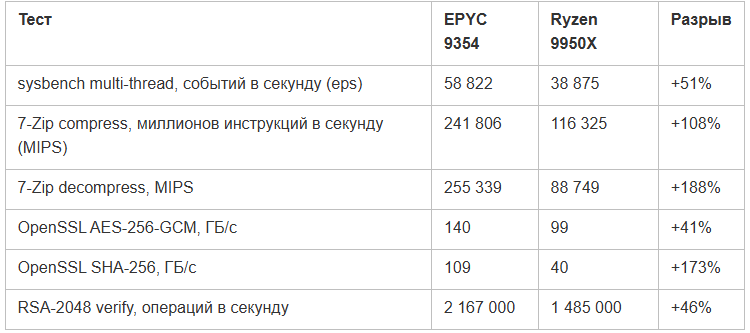
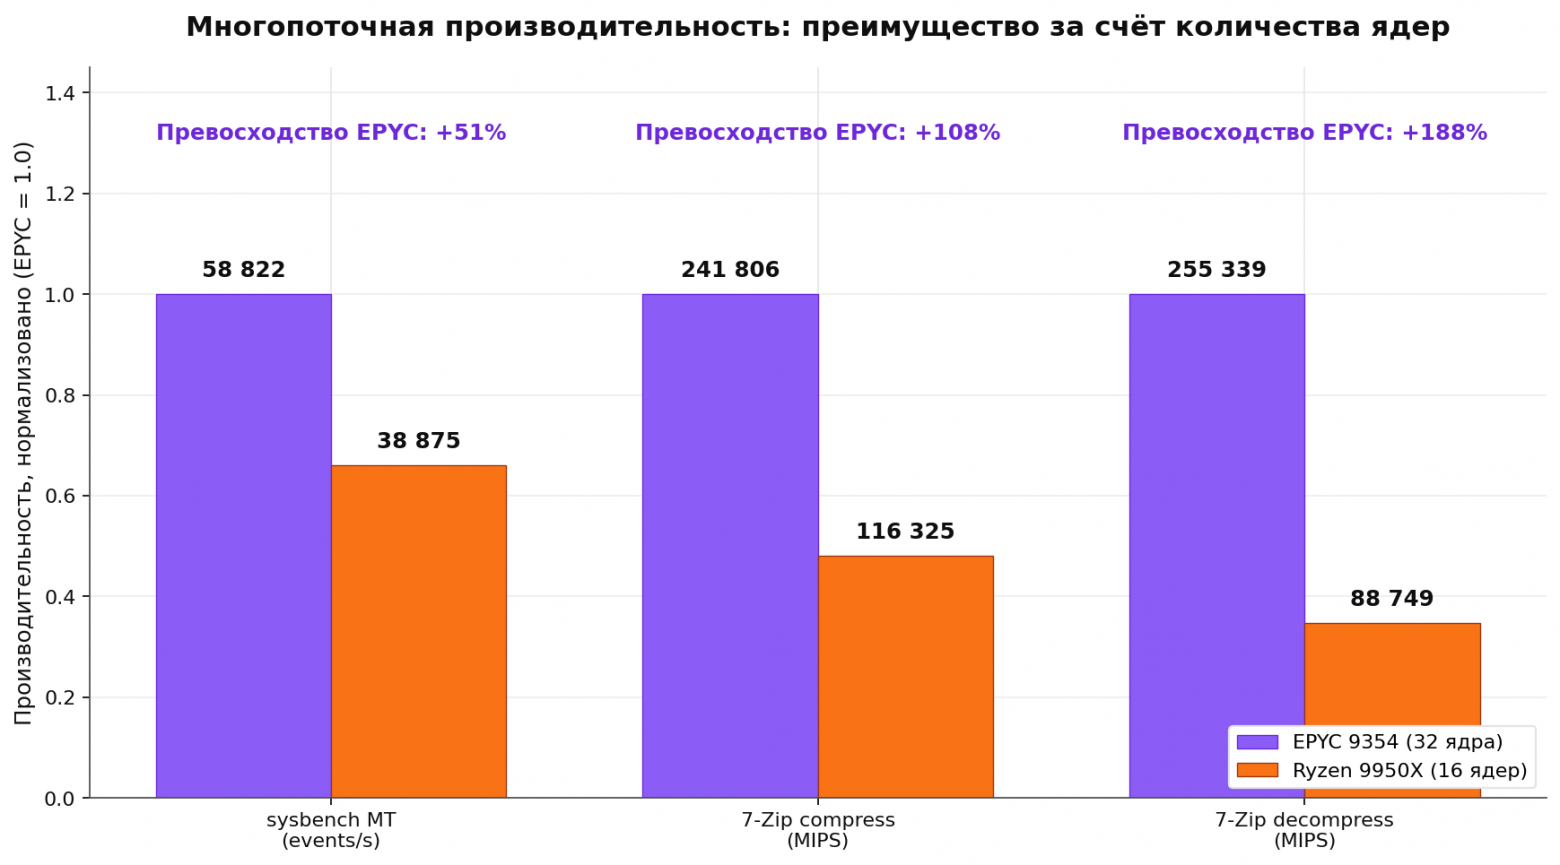
Здесь ситуация ожидаемая. Когда задача параллелится по ядрам, 32 ядра EPYC дают преимущество над 16 ядрами Ryzen.


Здесь самое время вернуться к разговору про одновременную многопоточность (SMT). Эти тесты как раз из тех, на которые её отсутствие влияет напрямую. Поскольку на стенде с Ryzen многопоточность недоступна на уровне платформы, цифры в таблице отражают именно тот результат, который получит арендатор сервера. Никакого «теоретического потолка с включённым SMT» в реальной эксплуатации не будет, поскольку условия обслуживания запрещают вмешиваться в настройки прошивки. Поэтому разрыв с EPYC, который виден в таблице выше, это не методологическая поправка, а та самая разница, с которой клиенту предстоит работать. EPYC выходит вперёд в многопоточных нагрузках за счёт удвоенного количества физических ядер и за счёт того, что использует свою многопоточность в полной мере.

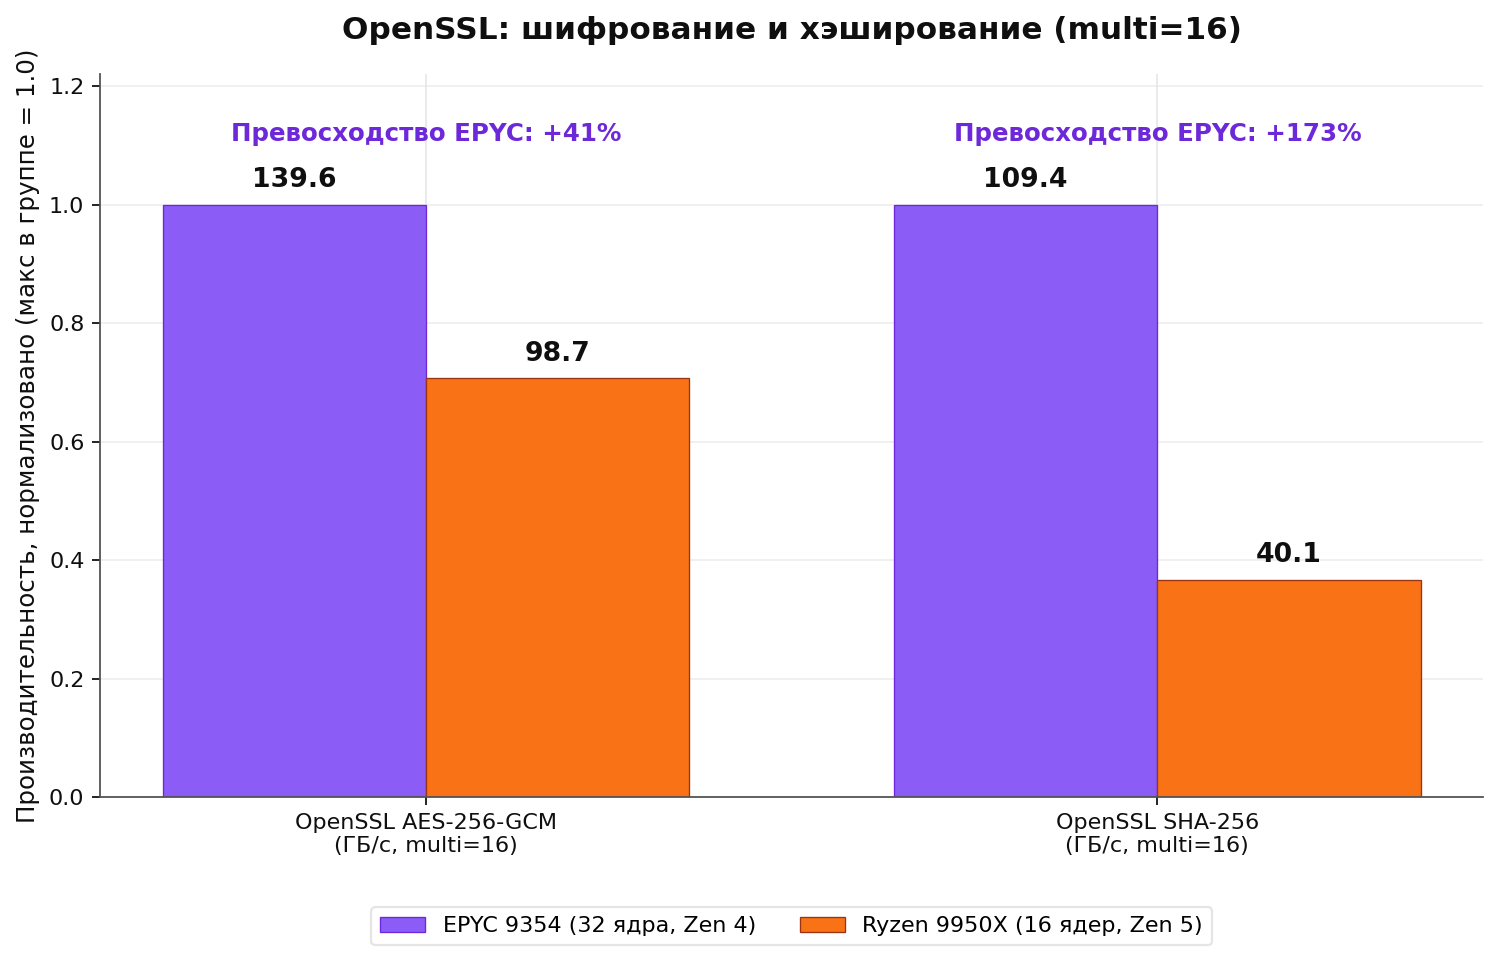
Отдельно стоит остановиться на тесте OpenSSL SHA-256, где EPYC опережает Ryzen на 173%. Эта цифра аномально велика даже с учётом разницы 32 ядер против 16. Причина кроется в специализированных аппаратных инструкциях SHA-NI. У EPYC их вдвое больше просто за счёт количества ядер, и каждая такая инструкция считает блок SHA-256 за один такт. Получается, что на хэшировании разница в ядрах транслируется в производительность почти линейно. На алгоритме AES-GCM похожая инструкция AES-NI тоже присутствует на обоих процессорах, но там разрыв скромнее (+41%), поскольку упор смещен в сторону частоты.


Понять, где это имеет значение, несложно. На веб-серверах с большим количеством рукопожатий по протоколу защищённой передачи данных (TLS) основная нагрузка приходится именно на хэш-функции и асимметричное шифрование при установке соединения. На задачах архивирования и распаковки, при компиляции больших проектов, а также на любых фоновых задачах, которые распараллеливаются по ядрам, разница между двумя процессорами вырастает в полтора-три раза.

PostgreSQL под параллельной нагрузкой
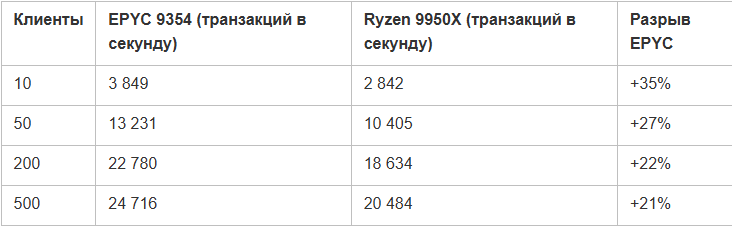
Этот тест кажется мне наиболее интересным с точки зрения того, что обычно крутится на арендованных серверах. Запускали мы инструмент pgbench с нагрузкой, подобной TPC-B (стандартный синтетический бенчмарк для операций оперативной обработки транзакций, OLTP), с масштабным коэффициентом 100. Измеряли количество транзакций в секунду (TPS) при разном числе одновременных клиентов.


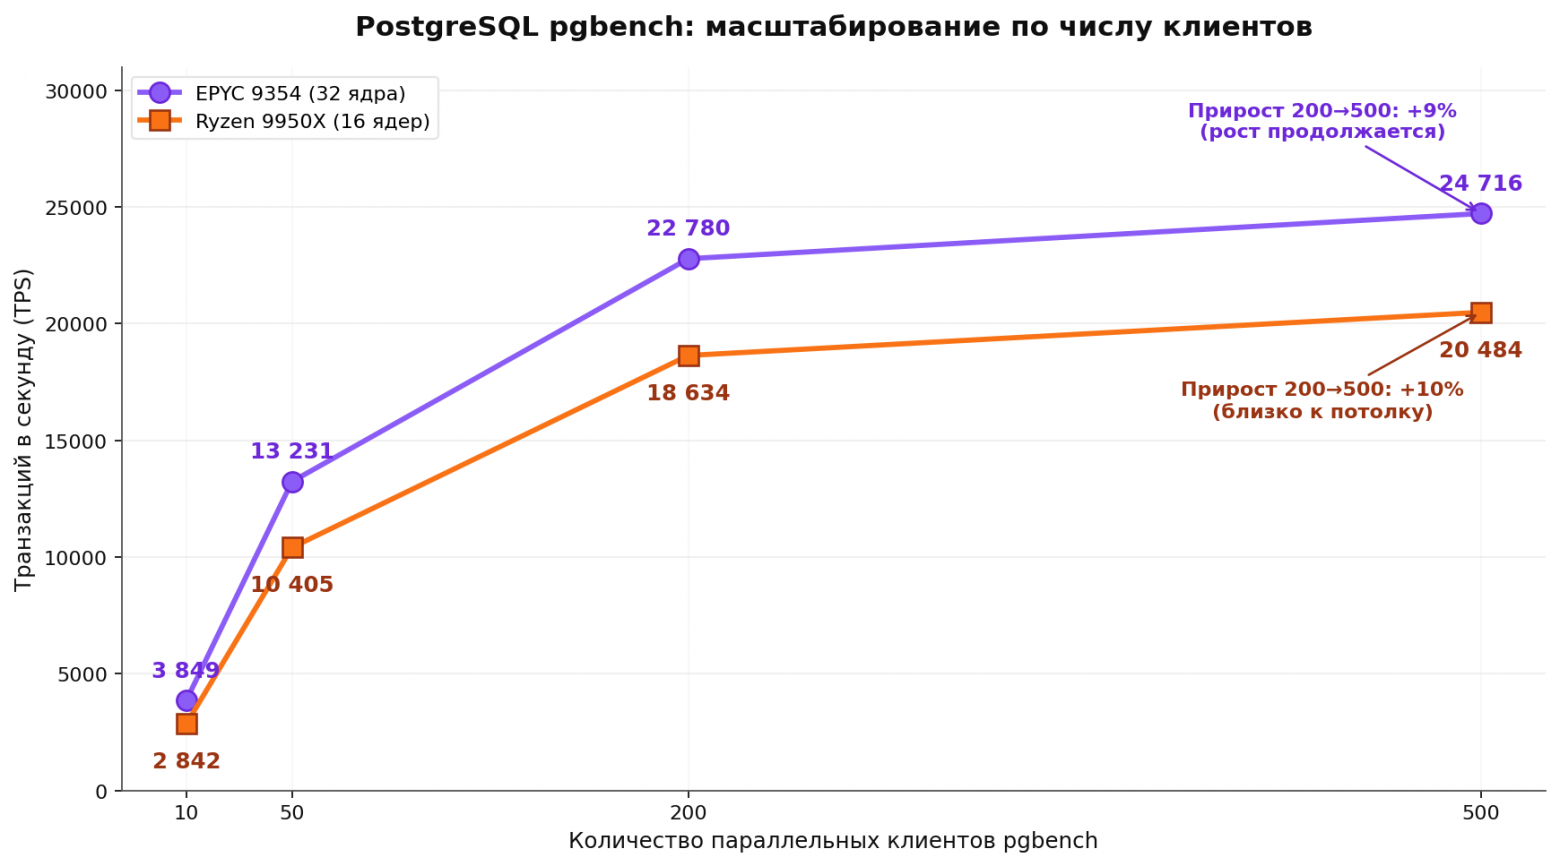
На небольшом числе клиентов разница составляет около 30%, и она вполне объяснима разницей в частотах и объёме кэша. Куда интереснее посмотреть на то, как ведут себя кривые при росте нагрузки. На промежутке от 200 до 500 клиентов EPYC даёт прирост с 22 780 до 24 716 транзакций в секунду, и его кривая всё ещё идёт вверх. Ryzen за тот же промежуток вырос с 18 634 до 20 484 транзакций в секунду, однако каждый следующий шаг даётся ему всё тяжелее, и кривая визуально начинает выходить на плато.

Здесь стоит быть осторожным с выводами. У нас всего четыре точки, и любые рассуждения о том, как поведёт себя нагрузка на 1000 клиентах, остаются в области предположений. Если экстраполировать тренд, Ryzen упрётся в потолок раньше, чем EPYC, и разрыв на больших количествах подключений будет расти, но это всего лишь предположение, а не измерение. Чтобы проверить его, нужен прогон на 1000 и 2000 клиентов, и пока такого замера нет, цифры в таблице выше остаются всем, что у нас есть.

Стоит ещё раз вспомнить про одновременную многопоточность (SMT). На инструменте pgbench, особенно при большом числе клиентов, многопоточность вносит ощутимый вклад, поскольку каждое соединение системы управления базами данных PostgreSQL живёт в своём процессе, и физических ядер на всех попросту не хватает. На стенде с Ryzen многопоточность недоступна на уровне платформы, поэтому цифры при 200 и 500 клиентах отражают именно то, что получит арендатор, без всяких теоретических поправок. Это и есть реальная картина для тарифа, а не лабораторный замер с условиями, до которых клиент дотянуться не сможет.

Несколько клиентов на одной машине
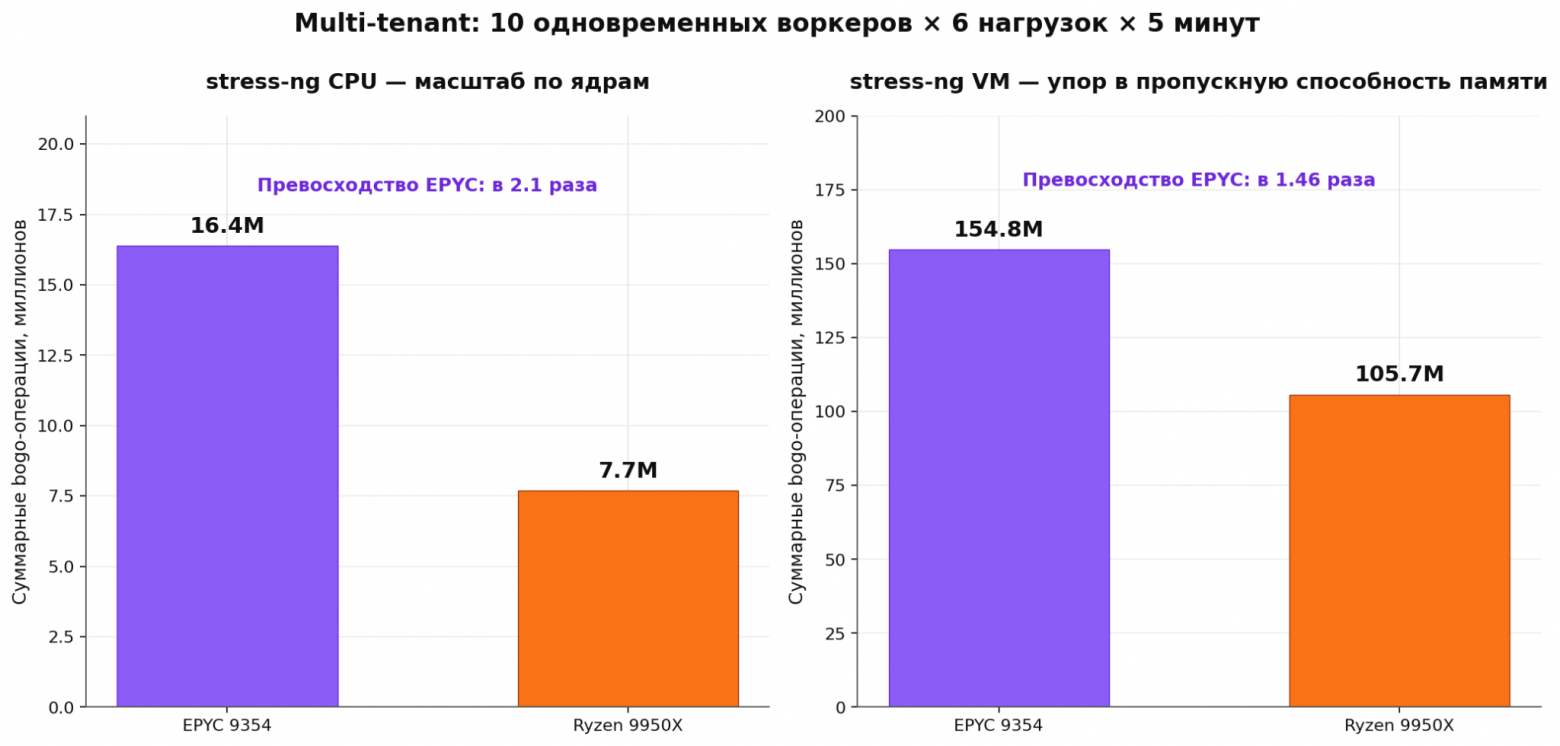
Этот сценарий для хостинга оказывается куда важнее многих синтетических тестов. На одной физической машине обычно живет не одно приложение, а несколько клиентов с разными нагрузками. Чтобы прикинуть, как процессор ведёт себя в подобной ситуации, мы запустили утилиту stress-ng в десять параллельных рабочих процессов (воркеров), у каждого из которых было по четыре нагружающих модуля на центральный процессор и два на оперативную память, а общая длительность теста составила пять минут.


Здесь видны сразу две вещи. На чисто процессорной нагрузке EPYC даёт ровно двукратный отрыв (×2,1), что точно соответствует двойному количеству ядер, и нагрузка масштабируется почти линейно. На модулях, которые гоняют оперативную память, картина выглядит иначе, отрыв составляет ×1,46. Узкое место смещается с процессора на пропускную способность памяти, и здесь уже двенадцать каналов DDR5 у EPYC играют большую роль, чем количество ядер.

Двукратный отрыв EPYC по процессорной метрике, как и в предыдущих тестах, отражает реальное соотношение для арендатора с учётом того, что многопоточность на Ryzen-стенде недоступна. Сама же форма картины, а именно линейное масштабирование на процессоре и упор в память на нагрузках с оперативной памятью, от настроек не зависит и определяется архитектурой.

Серверные функции, которых у Ryzen нет на уровне архитектуры
Речь дальше пойдёт не о производительности, а о наборе серверных функций, которых у Ryzen 9950X либо нет совсем, либо они присутствуют в урезанном виде. Об этом стоит сказать отдельно, поскольку в технической документации производителя такие различия часто скрываются за общими формулировками.

Память с коррекцией ошибок (ECC). Аббревиатура ECC расшифровывается как Error-Correcting Code и означает, что модули памяти умеют обнаруживать и исправлять одиночные битовые ошибки на лету. Ryzen 9950X ее формально поддерживает, но только в режиме UDIMM-ECC и только на тех платах, где производитель сделал соответствующую разводку. На большинстве потребительских материнских плат поддержки нет вовсе или она работает в усеченном режиме. У EPYC память с коррекцией обязательна, без неё процессор просто не запустится. Аппаратно обрабатываются как одиночные (SBE), так и двойные битовые ошибки (DBE). Что это значит на практике. Если в оперативной памяти случайно перевернется бит (а это случается, особенно при длительной работе и высокой плотности модулей), на EPYC ошибка будет либо исправлена прозрачно, либо залогирована. На Ryzen без ECC ошибка пройдёт незамеченной и может проявиться, например, как испорченные данные в базе.

Набор RAS-функций. Reliability, Availability, Serviceability, или функции надежности, доступности и обслуживаемости. На EPYC это около тридцати разных механизмов. Machine Check Architecture (MCA) с автоматическим восстановлением, platform security processor (PSP) для отдельной обработки уязвимостей, propagation бита «отравленных» данных через подсистему памяти, аппаратный вывод поврежденных страниц памяти из эксплуатации без участия операционной системы. На Ryzen большинство этих механизмов либо отсутствует, либо реализовано в потребительском объёме.

Удалённое управление (IPMI и BMC). На серверных платах под EPYC стоит отдельная микросхема BMC (Baseboard Management Controller), которая работает независимо от основного процессора и операционной системы. Через интерфейс IPMI (Intelligent Platform Management Interface) к ней можно подключиться по сети, увидеть процесс загрузки, перезагрузить машину, перепрошить BIOS, посмотреть температуру и состояние датчиков, даже когда основная система зависла или не загружается. На потребительских платах под Ryzen такой микросхемы нет. В случае зависания сервера у администратора остаётся вариант с физическим визитом в центр обработки данных.

Линии PCIe. У EPYC 9354 их 128 версии 5.0, у Ryzen 9950X — 28, причем примерно половина из этого числа уходит на чипсет и встроенную периферию. Для одного-двух NVMe-накопителей и одной сетевой карты Ryzen достаточно. Для конфигурации с RAID-массивом из четырёх и более NVMe, отдельной 100-гигабитной сетевой карты, плюс графическим ускорителем — линий просто не хватит, и встанет выбор, что подключить, а что нет.

Если суммировать, набор отличий выше делает EPYC более предсказуемым в эксплуатации. На стороне хостера это переводится в более раннее обнаружение проблем (через ECC, RAS-механизмы, удалённое управление) и в более широкие возможности по подключению периферии. На Ryzen многие из этих сценариев либо невозможны, либо требуют компромиссов.

Температурный режим под длительной нагрузкой
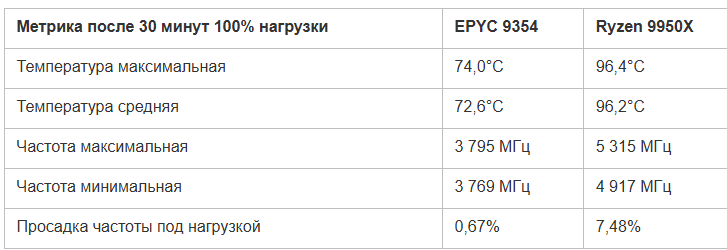
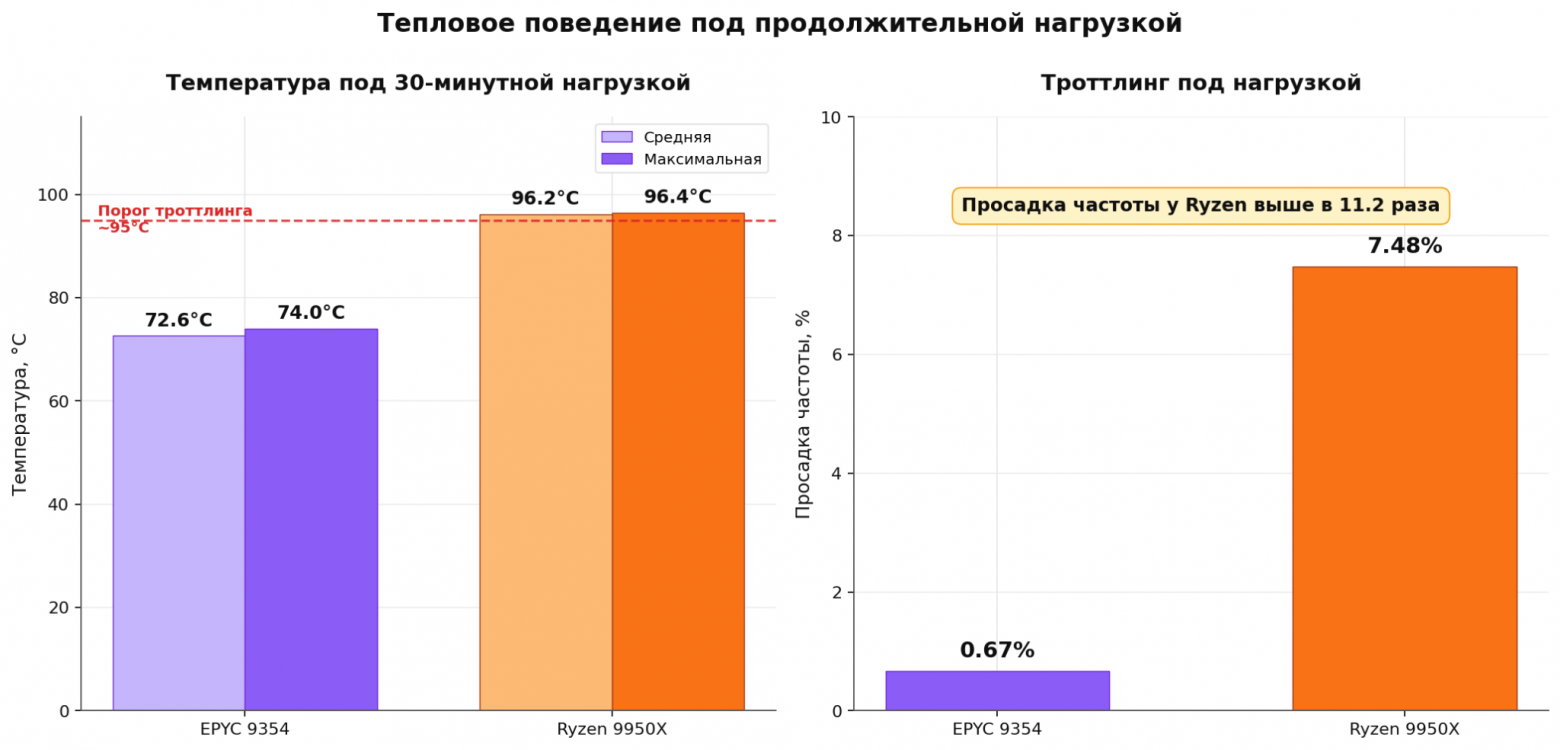
Один из менее очевидных результатов теста касается уже не производительности, а температурного поведения. Ryzen 9950X в стандартном серверном шасси без жидкостного охлаждения под продолжительной стопроцентной нагрузкой выходит на температуру 96°C.


Один из менее очевидных результатов теста касается уже не производительности, а температурного поведения. Ryzen 9950X в стандартном серверном шасси без жидкостного охлаждения под продолжительной стопроцентной нагрузкой выходит на температуру 96°C.

Сам по себе Ryzen 9950X спроектирован под настольный сценарий с массивным воздушным или жидкостным охлаждением, и в такой системе он способен длительное время держать частоты выше пяти гигагерц. Однако серверное шасси высотой 1U или 2U физически не вмещает большой кулер, и в нём используются вентиляторы ограниченных размеров с высокой частотой вращения. В этой конфигурации Ryzen упирается в свою предельную температуру перехода Tjmax, которая по технической документации составляет 95°C, и начинает снижать частоту, теряя около 7%.

EPYC 9354 спроектирован под тепловыделение (TDP) 280 Вт именно с расчётом на серверное охлаждение. В тех же условиях он держится в районе 72–74°C, что заметно ниже его предельной температуры, а просадка по частоте остаётся в пределах 1%.

За цифрами в таблице стоит несколько вполне ощутимых последствий. На сервере с Ryzen под продолжительной нагрузкой вентиляторы работают на максимальных оборотах, а это увеличивает их износ и шум. Заявленные в маркетинговых материалах частоты до 5,7 ГГц достижимы только в настольной системе, тогда как в серверной нагрузка стабилизируется на отметке порядка 4,9 ГГц. Производитель допускает работу процессора вплоть до Tjmax, и сам по себе режим в 96°C не является аварийным. Однако работа на постоянной близости к этой границе оставляет минимальный запас на пиковые нагрузки, колебания температуры в стойке и постепенное ухудшение теплоотвода по мере накопления пыли в радиаторах. В долгосрочной перспективе это означает более раннюю необходимость профилактики, чем у процессора, который штатно работает на 70–75°C.

Когда переплата за EPYC оправдана, а когда выгоднее Ryzen
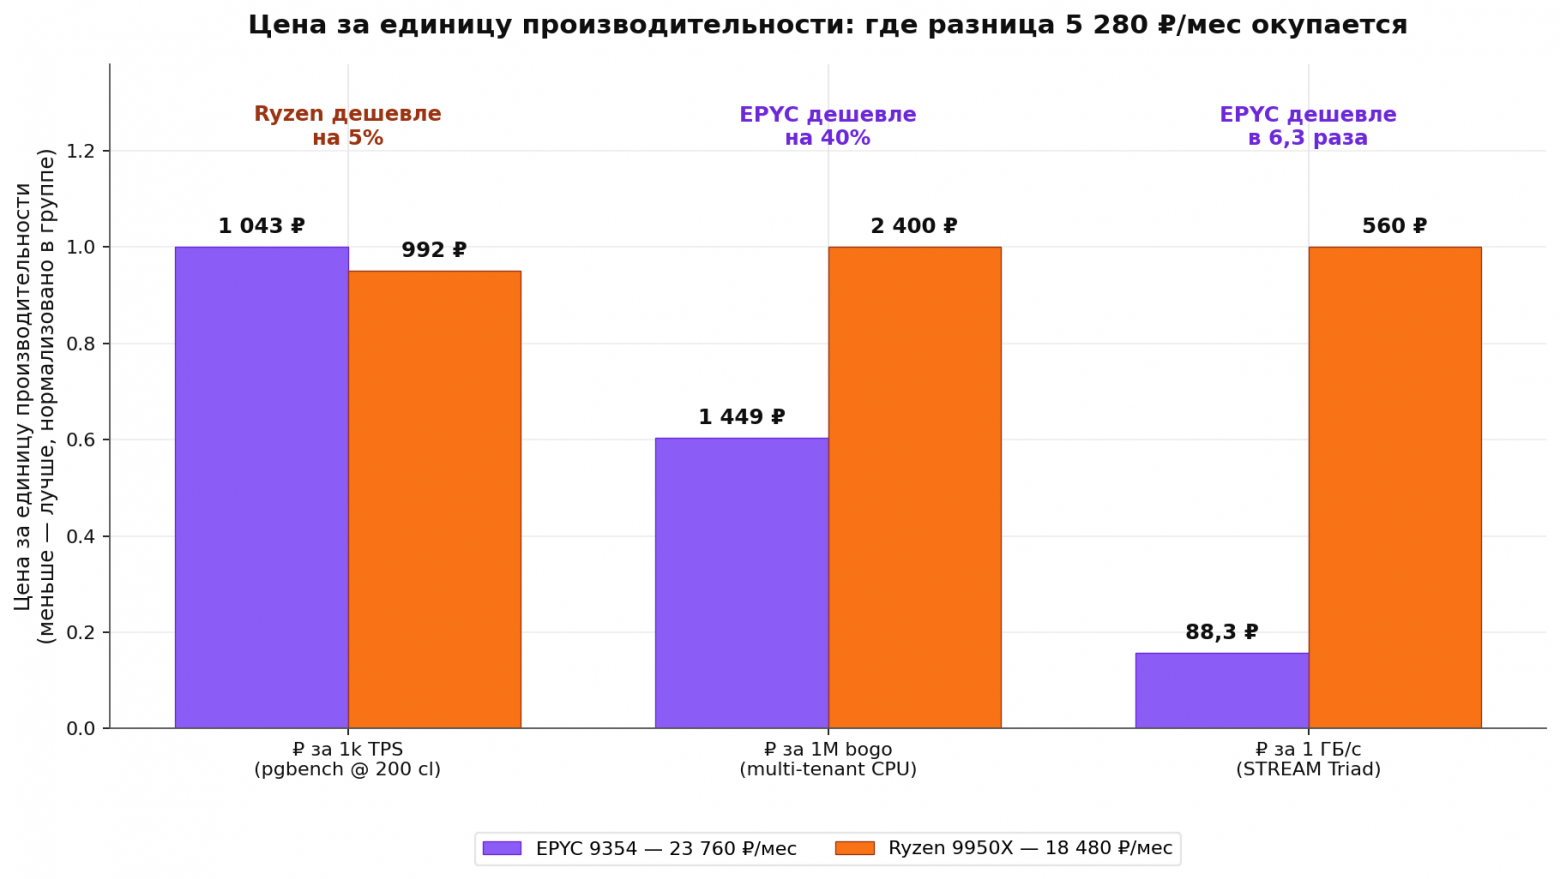
Точная разница в цене на момент заказа составляла в 5 280 рублей в месяц, и здесь возникает логичный вопрос, в каких сценариях эта разница оправдывается. Чтобы на него ответить, стоит посмотреть не на абсолютную цену сервера, а на стоимость в пересчете на единицу полезной нагрузки.


Картина складывается следующая. На лёгком веб-сервисе и серверной части (бэкенде) с небольшим числом одновременных подключений Ryzen остаётся выгоднее по соотношению цены и производительности. Как только нагрузка начинает упираться в пропускную способность памяти или в количество параллельных задач на одной машине, разница в 5280 рублей окупается эффективностью.

В пользу Ryzen 9950X работает целый ряд соображений. Сервер используется под одно приложение или сайт и не делится между клиентами. Нагрузка преимущественно однопоточная или с небольшим числом одновременных пользователей. Бюджет ограничен суммой около 20000 рублей в месяц. Данные не критичные, например, для тестовой среды или среды разработки, где отсутствие памяти с коррекцией ошибок (ECC) не играет роли. Сетевой канал в 1 гигабит в секунду полностью закрывает потребности.

В пользу EPYC 9354 говорят совсем другие соображения. База данных работает под нагрузкой от ста одновременных клиентов и выше. Один сервер делится между несколькими клиентами или контейнерами. На нём крутятся нагрузки, упирающиеся в память, такие как Redis, Memcached или вывод моделей машинного обучения. Есть требования к соответствию стандартам или повышенная чувствительность данных, когда память с коррекцией ошибок становится не опцией, а необходимостью. Нужно удалённое управление через интерфейс интеллектуального управления платформой (IPMI) на случай проблем с операционной системой. Сетевого канала в 1 гигабит в секунду недостаточно, и нужны 10 гигабит. Ожидается рост нагрузки, пользовательской базы или объёма базы данных.

Граница между этими сценариями довольно размытая, и в большинстве случаев решение остаётся на стороне того, кто лучше всех знает свою нагрузку.

Итог сравнения
Сравнение Ryzen 9950X и EPYC 9354 не сводится к одному числу или одной метрике. Расстановка сил во многом зависит от того, какая именно нагрузка крутится на сервере. Ryzen выигрывает в однопоточных тестах, в сценариях по петле обратной связи (loopback) и в задачах с небольшим числом одновременных соединений. EPYC же опережает соперника по пропускной способности памяти (разрыв в 7–8 раз), в многопоточной нагрузке и в работе под высокой температурой (просадка частоты меньше 1% против 7,5% у Ryzen), а также предлагает набор серверных функций, которых на потребительской платформе нет на уровне архитектуры.

Если посмотреть на главные находки в краткой форме:
  • Память. Разрыв в пропускной способности 7–8 раз, и причина кроется в двенадцати каналах DDR5 у EPYC против двух у Ryzen.
  • PostgreSQL. Кривая Ryzen визуально начинает выходить на плато к 500 клиентам, тогда как у EPYC ещё остаётся запас (с оговоркой про экстраполяцию).
  • Многопоточная нагрузка с несколькими клиентами. Разрыв составляет около двух раз по процессорной метрике, что соответствует двойному количеству ядер.
  • Температура. Ryzen в серверном шасси работает на пределе своей предельной температуры перехода (Tjmax) с просадкой частоты около 7,5%.
  • Серверные функции. Память с коррекцией ошибок (ECC), интерфейс интеллектуального управления платформой (IPMI) и механизмы надежности, доступности и обслуживаемости (RAS) на EPYC присутствуют как часть платформы, а на Ryzen они либо отсутствуют, либо ограничены.

Разница в чуть более 5000 рублей позволяет выбрать серверный процессор вместо потребительского, установленного в серверном корпусе. Вопрос окупаемости этой разницы зависит от того, насколько реальная нагрузка соответствует параметрам, которые были учтены при разработке серверного процессора.

hostkey.ru