+141.76
Рейтинг
alice2k
Виталий Никсенкин
VMmanager — в числе лидеров по масштабу внедрений по версии CNews
CNews Analytics опубликовал рейтинг «Топ-6 внедрений российских платформ виртуализации». Проект ISPsystem на базе VMmanager, реализованный в FirstVDS, занял второе место.
Проекты оценивали по трем критериям: количеству хостов, географии внедрения и доле покрытых рабочих процессов с учётом принадлежности заказчика к КИИ.
О кейсе: VMmanager внедрили в инфраструктуру FirstVDS с распределенной сетью ЦОД. Количество хостов — 1450. В результате удалось создать полностью автоматизированную среду, где VMmanager управляет пулом физических серверов.
После непростого октября для нас особенно ценно признание проекта, за которым стоят работа команды ISPsystem и опыт применения VMmanager в масштабной инфраструктуре партнера. Работаем дальше!
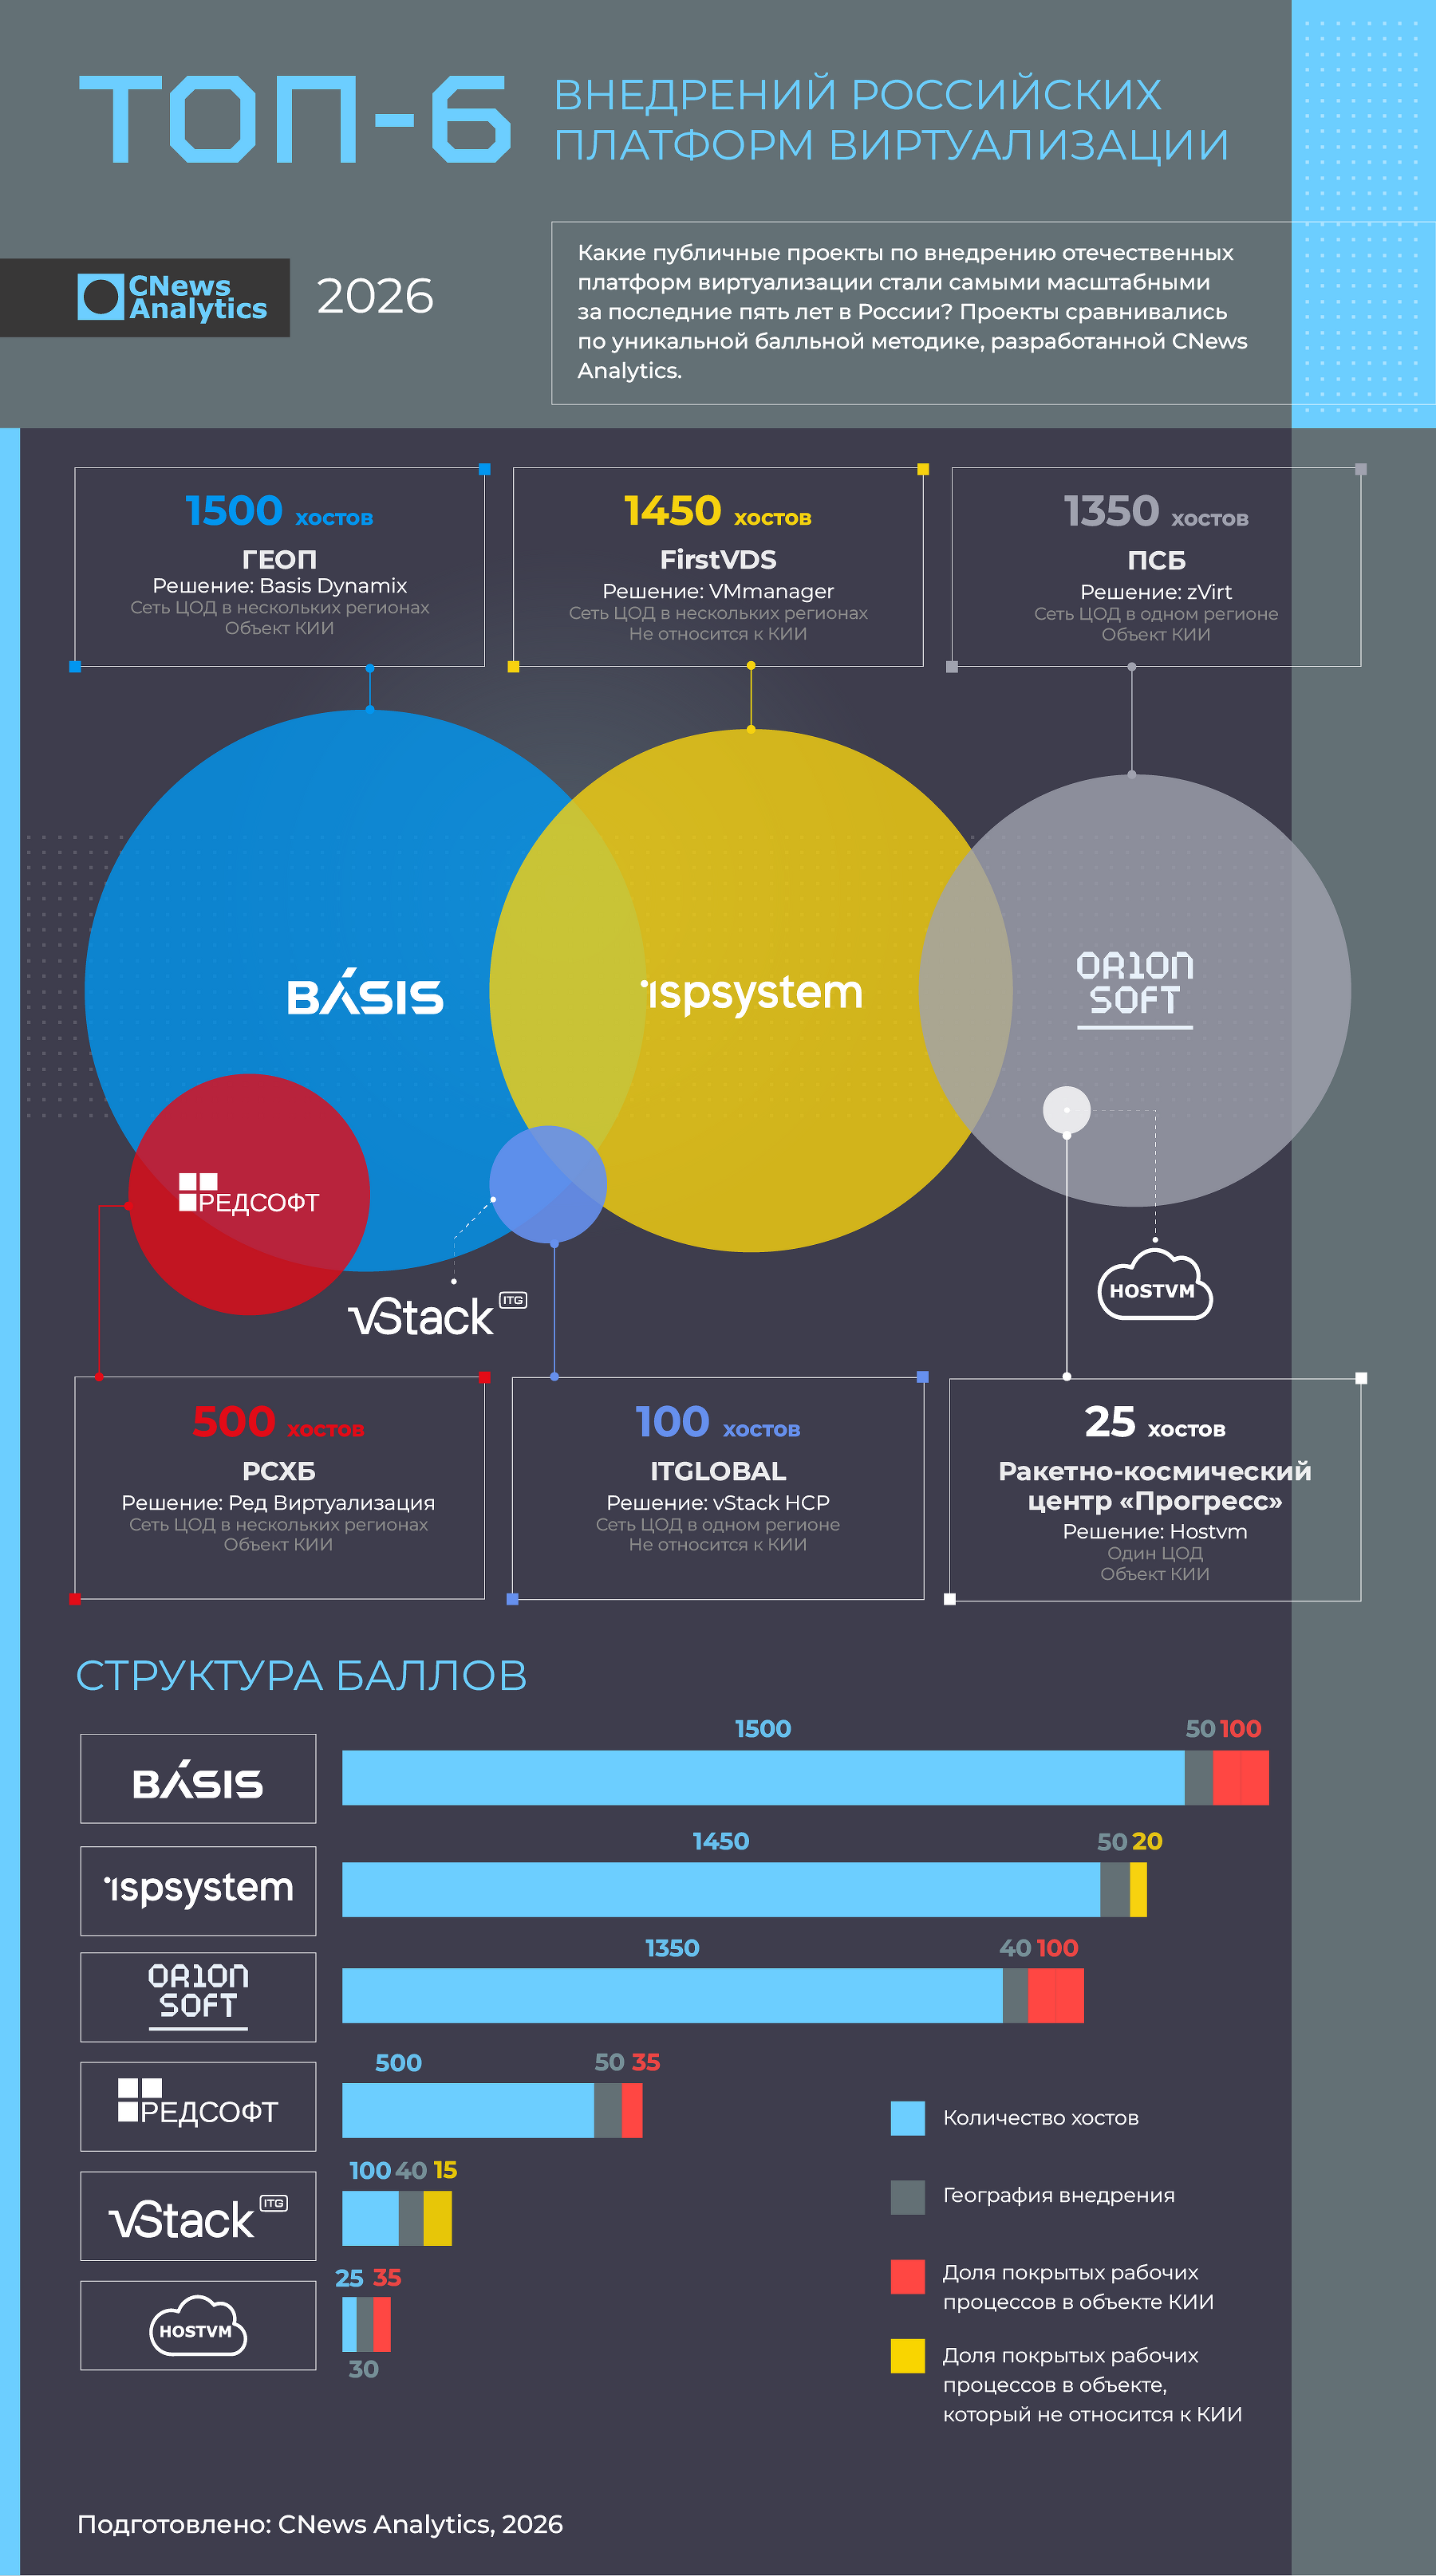
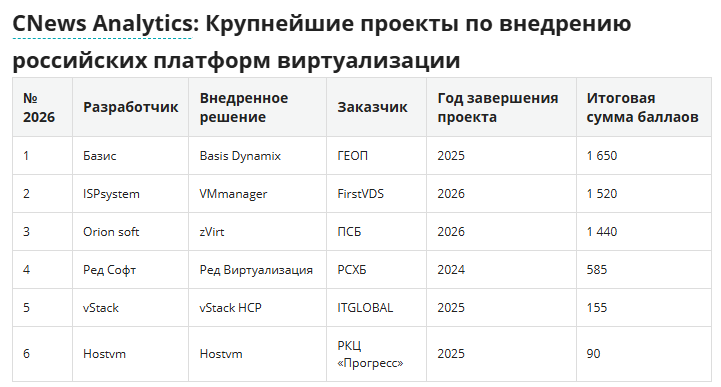
Проекты оценивали по трем критериям: количеству хостов, географии внедрения и доле покрытых рабочих процессов с учётом принадлежности заказчика к КИИ.
О кейсе: VMmanager внедрили в инфраструктуру FirstVDS с распределенной сетью ЦОД. Количество хостов — 1450. В результате удалось создать полностью автоматизированную среду, где VMmanager управляет пулом физических серверов.
После непростого октября для нас особенно ценно признание проекта, за которым стоят работа команды ISPsystem и опыт применения VMmanager в масштабной инфраструктуре партнера. Работаем дальше!
Атака на VMmanager 6 Hosting
В середине октября инфраструктура нескольких десятков хостинг-провайдеров, использующих VMmanager 6 Hosting, столкнулась со скоординированной атакой.
Команда ISPsystem оперативно отреагировала на инцидент и нейтрализовала атаку. Рассказываем, что произошло и как развивались события.
Коротко о произошедшем: инцидент затронул одну из сборок VMmanager 6 Hosting, применяемую хостинг-провайдерами для выдачи виртуальных машин в открытом контуре. Злоумышленники реализовали атаку за счет ранее неизвестной 0-day уязвимости, а особенность nginx пропускать такие запросы делала ее эксплуатацию возможной.
С первых часов атаки мы усилили техподдержку и организовали круглосуточное реагирование. Выпустили серию внеплановых обновлений, временно отключили удаленное управление и запуск внутренних скриптов. Эти меры помогли ограничить действия злоумышленников и не дать им закрепиться в системе.
Анализ показал, что атаку вели, активно используя ИИ-инструменты: алгоритмы динамически адаптировали тактику под особенности конкретных провайдеров.
К расследованию также подключились эксперты из «Лаборатории Касперского», предоставившие решения для сканирования и зачистки узлов провайдеров.
Для предотвращения подобных инцидентов мы продолжим выпускать обновления с усиленной защитой. Расследование продолжится, пока не убедимся, что в затронутых средах не осталось следов присутствия злоумышленников и бэкдоров.
Мы приносим извинения и благодарим всех, кто помогает в диагностике и проверке исправлений.
Подробный разбор и полную хронологию читайте на нашем сайте.
www.ispsystem.ru/news/post-mortem
Малый бизнес стал переходить на защищенную облачную инфраструктуру — исследование Рег.облака
В третьем квартале 2026 года число новых подключений к защищенному облаку 152-ФЗ выросло на 80% по сравнению с началом года, наиболее активными пользователями услуги стал российский малый бизнес.
Российский провайдер облачных и bare-metal решений Рег.облако зафиксировал на рынке облачных услуг тенденцию активного перехода малого бизнеса на защищенную инфраструктуру. Небольшие компании становятся его основным драйвером, по данным Рег.облака, 86% пользователей защищенного облака 152-ФЗ — малые компании. За последние три месяца число новых подключений выросло на 80% по сравнению с первым кварталом 2026 года, а общее количество пользователей аттестованного облака превысило 5,5 тыс. компаний.
www.reg.cloud/cloud/fz152
Кроме того, активный спрос на защищенную инфраструктуру вышел за пределы технологического сектора: 78% корпоративных заказчиков облачной инфраструктуры 152-ФЗ в Рег.облаке работают вне ИТ-сферы. Категорию ИТ-компаний занимает 22% пользователей, однако остальные 78% распределены между оптовой торговлей (10%), здравоохранением (6%), финансовыми организациями, розничной торговлей и научно-техническими компаниями (5%). Защищенное облако также используют предприятия промышленности, строительства, образования и логистики.
Динамика отражает структурный сдвиг, который фиксируется на фоне общего повышения внимания бизнеса к вопросам обработки персональных данных. По оценкам экспертов Рег.облака в 2026 году российские компании стали чаще оценивать не вероятность проверки как таковой, а потенциальные издержки, связанные с обработкой чувствительной информации. Такой подход меняет приоритеты: защита данных переходит из категории формального требования в категорию управления рисками. Для малого бизнеса это прямая необходимость искать решения, которые позволяют соответствовать регуляторным требованиям без создания собственной защищенной инфраструктуры.
Собственный защищенный контур требует капитальных затрат на оборудование, внедрение и сопровождение средств защиты, а для небольшого предприятия это зачастую высокая статья расходов. Аттестованное облако позволяет получить готовую инфраструктуру без лишних затрат и времени. При этом компании не уходят от стандартной инфраструктуры полностью: 37% действующих пользователей Рег.облака ранее использовали публичное облако провайдера, а 27% совмещают оба формата, распределяя системы с учетом чувствительности данных. Такая модель становится типовой для рынка — бизнес размещает персональные данные в защищенном сегменте, а остальные системы оставляют в публичном облаке.
«Малый бизнес сегодня считает не стоимость аренды облака, а стоимость ошибки. Одна утечка может стоить дороже, чем годовой оборот. Собственный защищенный контур — это оборудование, специалисты, время и ресурсы на аттестацию. Аттестованное облако провайдера позволяет получить ту же инфраструктуру быстро и за доступную стоимость», — комментирует Егор Сапун, руководитель направления сертификации инфраструктуры Рег.облака.
Напомним, что с 30 мая 2025 года в России действуют новые требования к обработке персональных данных. Аттестованная облачная инфраструктура позволяет компаниям соответствовать этим требованиям без создания собственного защищенного контура. В дополнение к защищенным серверам пользователи Рег.облака задействуют резервное копирование, публичные IP-адреса, снапшоты и управляемые базы данных. Защищенное облако Рег.облака аттестовано по первому уровню защищенности персональных данных (УЗ-1) согласно приказу № 21 ФСТЭК России. Провайдер также обладает лицензией ФСБ на работу с криптографическими средствами и сертификатами соответствия международным стандартам ISO/IEC.
Внедрение TPU Google в облачную инфраструктуру Oracle
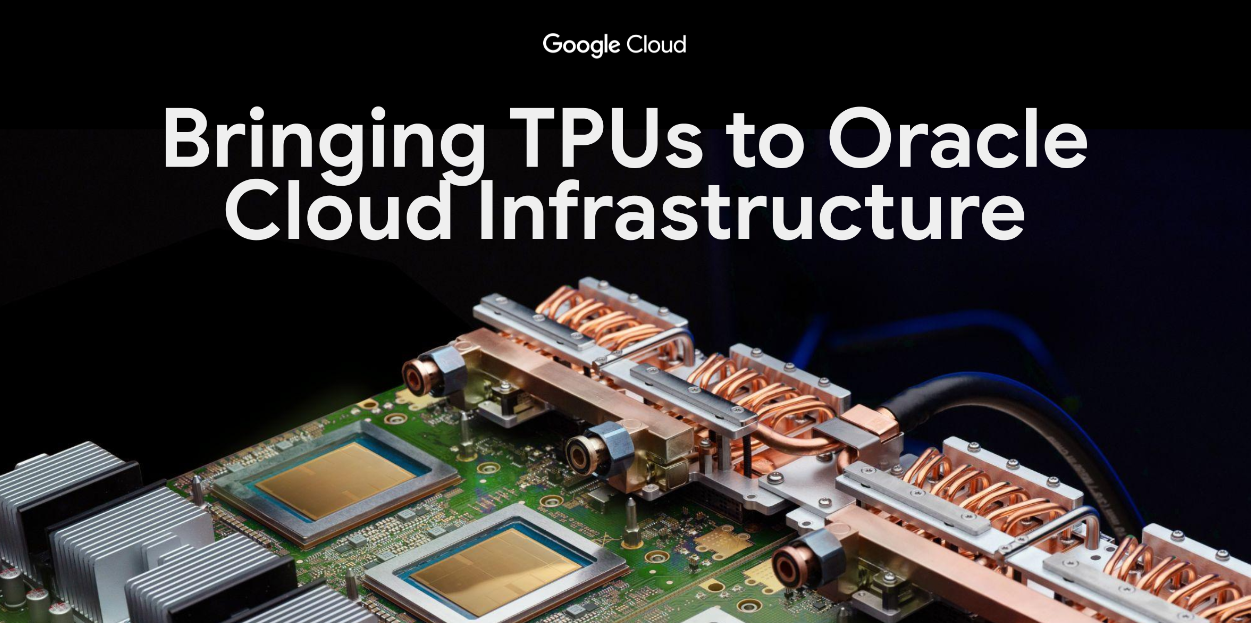
По мере масштабирования рабочих нагрузок ИИ во всех отраслях организациям необходимы вычислительные ресурсы, оптимизирующие пропускную способность, задержку и экономичность на протяжении всего жизненного цикла ИИ. Для удовлетворения этого спроса Oracle и Google Cloud объединяют усилия, чтобы предоставить процессоры Google Tensor Processing Units (TPU) для инфраструктуры Oracle Cloud Infrastructure (OCI), сделав OCI первым гипермасштабируемым провайдером за пределами Google, предлагающим TPU. Совместно мы начнем развертывание мощностей TPU на OCI начиная с 2027 календарного года.
TPU: Совместная разработка от кремниевой микросхемы до программного обеспечения.
Компания Google создала свой первый TPU более десяти лет назад, основываясь на четкой концепции продукта: совместная разработка специализированных микросхем с оптическими сетями, системами питания, жидкостным охлаждением и программным обеспечением компилятора обеспечивает прирост производительности на ватт и снижение общей стоимости владения, чего не могут достичь отдельные компоненты.
TPU v1 обеспечивал в 30 раз большую пропускную способность на ватт по сравнению с современными процессорами. Сегодня TPU используются для обучения и обслуживания Gemini в продуктах Google, насчитывающих миллиард пользователей, а TPU восьмого поколения обеспечивают до 12,6 PFLOPS нативных вычислений FP4 на чипе, что более чем в 100 раз превышает 92 TFLOPS у TPU v1 и в 2 раза повышает производительность на ватт по сравнению с предыдущим поколением. Однако одних только FLOPS недостаточно для определения экономической эффективности как обучения, так и вывода. Для обучения определяющим показателем является пропускная способность; процент времени, которое кластер тратит на продуктивные вычисления. Для вывода определяющими показателями являются задержка и стоимость на токен. TPU решают обе эти задачи за счет совместного проектирования на системном уровне.
Благодаря сочетанию внутрикристальной маршрутизации межсоединений (ICI) с оптической коммутацией каналов (OCS), плоскость управления обнаруживает аппаратные сбои или ухудшение качества связи и динамически перенаправляет оптические пути в обход неисправностей в режиме реального времени без перезапуска заданий, поддерживая пропускную способность более 97% на тысячах микросхем в крупномасштабных обучающих циклах и обеспечивая высокую доступность для обслуживания в производственной среде. Увеличенный объем SRAM на кристалле, большая емкость HBM и новая топология межсоединений малого диаметра, сокращающая количество сетевых переходов более чем на 50%, позволяют процессорам TPU последнего поколения обеспечивать до 80% лучшую производительность на доллар при обслуживании с низкой задержкой.
Эффективность аппаратного обеспечения приводит к ускорению разработки продукта, когда разработчики могут легко его внедрить. Наши недавние заявления на конференции PyTorch подтверждают наше стремление сделать программную экосистему Google TPU открытой и удобной для разработчиков средой для сообщества PyTorch. В частности, TorchTPU, наш собственный стек PyTorch для Google TPU, теперь доступен в качестве открытого исходного кода на GitHub. Теперь вы можете обучать, запускать и развертывать модели на TPU, используя уже используемые вами инструменты, включая vLLM, SGLang, llm-d, TorchTitan, Ray, TorchRec, Hugging Face, LiteRT.
Эта возможность переноса позволяет командам назначать каждую рабочую нагрузку акселератору, обеспечивающему наименьшую стоимость за токен или самое быстрое время обучения, без переписывания кода модели. А благодаря сегодняшнему объявлению, вскоре они смогут назначать эти рабочие нагрузки TPU в инфраструктуре Google Cloud или Oracle.
Расширение экосистемы инфраструктуры ИИ с помощью OCI
Даже несмотря на растущее внедрение TPU в Google Cloud, глобальный спрос на вычислительные ресурсы для ИИ превышает возможности любого отдельного облачного провайдера. Внедрение TPU в OCI предоставляет клиентам четыре существенных преимущества:
- Центры обработки данных, спроектированные для высокой плотности ИИ: системы TPU от Google разработаны для прямого жидкостного охлаждения в масштабе стоек, и центры обработки данных следующего поколения OCI созданы именно для этого профиля. Oracle предоставляет гибкие и надежные мощности, которые могут переключаться между обучением моделей на переднем крае вычислений и выводом результатов в производственной среде в зависимости от меняющегося спроса клиентов. Сочетание эффективности TPU с инновационными подходами Oracle к электропитанию и охлаждению помогает быстро и в глобальном масштабе вводить в эксплуатацию энергоэффективные вычислительные мощности для ИИ.
- Безопасная высокопроизводительная сеть с Oracle Acceleron: пока TPU передают трафик между чипами через ICI и OCS, Oracle Acceleron обеспечивает сетевую основу, соединяющую мощности TPU с остальной частью OCI. SmartNIC Acceleron с изоляцией арендаторов на аппаратном уровне, высокопроизводительной коммутационной матрицей и маршрутизацией пакетов с нулевым доверием обеспечивает передачу данных между базами данных Oracle, хранилищами и кластерами TPU с высокой пропускной способностью и низкой задержкой, не перегружая вычислительные ресурсы хостов и не ослабляя границы безопасности.
- Близость к корпоративным данным: базы данных Oracle часто являются основной системой учета для крупных организаций. Предложение TPU непосредственно в OCI позволяет организациям проводить тонкую настройку и вывод результатов рядом с существующими корпоративными данными без дорогостоящих межоблачных переносов.
- Возможность выбора различных архитектур: Предоставление TPU наряду с GPU в OCI дает командам гибкость в назначении оптимального ускорителя для каждого этапа рабочей нагрузки ИИ с учетом стоимости и производительности.
Благодаря интеграции вычислительных блоков Google TPU в облачную инфраструктуру Oracle, Google Cloud и Oracle открывают доступ к более чем десятилетнему опыту разработки специализированных систем искусственного интеллекта для более широкой экосистемы разработчиков. Когда у клиентов появляется больше вариантов специализированных вычислительных ресурсов в различных облачных средах, вся отрасль развивается быстрее и работает эффективнее. Мы с нетерпением ждём, что вы создадите.
Установите последнее обновление DNSmanager 6
Мы выпустили обновление для DNSmanager 6. Оно включает исправления безопасности, устранение ошибок и ряд улучшений архитектуры платформы. Рекомендуем незамедлительно применить его.
В текущих реалиях обновление не формальность, а необходимая мера для защиты вашей инфраструктуры. Вам требуется обновиться до актуальной версии:
DNSmanager 6 — v6.5.3.
Мы также призываем всегда поддерживать продукты в актуальном состоянии: регулярные обновления не только расширяют функциональность, но и закрывают известные уязвимости, а также повышают устойчивость и надежность систем.
Если у вас возникнут вопросы по установке или работе продукта, обратитесь в техническую поддержку. Мы поможем.
Благодарим за понимание!
В начале 2027 года мы выводим из эксплуатации наш дата-центр NLDW2 в Налдвейке

В начале 2027 года мы выводим из эксплуатации наш дата-центр NLDW2 в Налдвейке. Расположенные там же выделенные серверы будут отключены.
На данный момент предложение распространяется на серверы, перечисленные ниже: NLDW2.V1
Что мы вам предлагаем
Вы заменяете сервер NLDW2 на VPS на нашей новой платформе? Тогда вам больше не придется платить за старый сервер до 12 января 2027 года. Это даст вам время для миграции в удобное для вас время без двойных затрат.
Вы оплачиваете сам VPS. Мы рекомендуем стандартный вариант: 4 виртуальных процессора / 16 ГБ оперативной памяти / 320 ГБ дискового пространства. Это стоит 43,16 евро в месяц, включая 1 IP-адрес для доступа в интернет (без учета дополнительных IP-адресов).
Вот как это работает.
- Шаг 1: Зарегистрируйтесь для получения предложения до 15 декабря 2026 года, отправив письмо на support@worldstream.com
- Шаг 2: Создайте VPS на portal.worldstream.com
- Шаг 3: Сообщите нам, какой сервер NLDW2 он заменяет, в течение той же недели, когда вы создадите VPS. Вы также можете сделать это по адресу support@worldstream.com
- Шаг 4: Перенесите свои данные и сервисы со старого сервера на VPS.
Вы хотите создать VPS немедленно? Тогда вы можете отправить заявку на регистрацию и подключение в одном электронном письме.
Обратите внимание: без регистрации до 15 декабря или без подключения в течение той же недели предложение не распространяется на этот сервер. Оплата за ваш старый сервер будет продолжаться в обычном режиме.
Несколько серверов?
Предложение действует на один сервер. Вы подключаете каждый VPS к одному конкретному старому серверу. Таким образом, три старых сервера означают три VPS и три подключения. Вам нужен VPS другого размера? Отправьте запрос в чат, и мы обсудим возможности.
Что произойдет дальше?
13 января 2027 года мы автоматически закроем ваш старый сервер NLDW2. В этот день мы навсегда удалим сервер и все связанные с ним данные. Эта дата фиксирована и не может быть изменена. Поэтому убедитесь, что все ваши данные и сервисы находятся на VPS до 13 января.
Есть вопросы по поводу переключения, VPS или регистрации? Напишите нам по адресу support@worldstream.com Мы будем рады помочь.
Искренне Ваш,
Команда Worldstream
Ollama: как развернуть свою модель и подключить её к приложению
Когда приложение обращается к внешнему API LLM, часть инфраструктурных задач уже решена провайдером: он размещает модель, масштабирует вычисления и поддерживает endpoint. При локальном развертывании модели эти задачи приходится решать самостоятельно.
Здесь на помощь приходит Ollama — это сервис, который позволяет загружать и запускать совместимые модели, а также предоставляет интерфейсы для администрирования — CLI для базового взаимодействия, UI для общения в окне чата и HTTP API для интеграции. Ollama можно использовать на рабочей станции для проверки гипотезы, а затем развернуть на отдельном сервере, к которому обращаются приложения и внутренние пользователи. При этом опыт управления, конфигурации и взаимодействия с моделью будет идентичен.
В этой статье расскажем, как установить Ollama на Linux-сервере, запустить нейросеть и подключить модель к приложению. Но прежде чем переходить к настройке, разберёмся, в каких случаях вообще стоит запускать AI-модель самостоятельно на своём сервере.
1dedic.ru/blog/article/ollama-kak-razvernut-svoyu-model-i-podklyuchit-eyo-k-prilozheniyu
https://firstdedic.ru
Попробуйте новый CLO!
8 сентября мы открыли новую локацию CLO, и это не просто новые мощности или дополнительное оборудование. Мы фактически создали новое облако на современной программно-аппаратной платформе и разместили его в отдельной физической локации дата-центра IXcellerate.
Ваш существующий аккаунт уже перенесён в новую локацию. Ничего дополнительно переносить или настраивать не нужно — просто используйте новый адрес для авторизации: console.clo.ru
В новой локации мы полностью переработали технологическую основу CLO: обновили сетевую архитектуру, перешли на актуальные версии OpenStack и OpenSDN, переписали бэкенд, добавили поддержку DPDK и модернизировали подсистему хранения.
Что это даёт
Больше производительности и надёжности для ваших проектов:
- — Более высокая производительность сети и хранилища;
- — Более стабильная работа виртуальных машин и кластеров;
- — Меньше влияния «шумных соседей» на производительность ваших ресурсов;
- — Меньше ошибок и зависших операций;
- — Современная архитектура, рассчитанная на дальнейшее развитие платформы;
- — Обновлённый и более удобный личный кабинет.
Если у вас возникнут вопросы или понадобится помощь с запуском новых проектов, наша команда поддержки всегда готова помочь.
С уважением, команда CLO
https://console.clo.ru/sign/up/
Инцидент безопасности VMmanager 6: что произошло и что делать (20 окт 2026)
В октябре 2026 года злоумышленники атаковали сразу несколько российских хостинг-провайдеров через критическую уязвимость в VMmanager 6 — панели управления виртуализацией от компании ISPsystem (входит в «Группу Астра»). На этой панели работают VPS у нас и у многих других провайдеров. Мы тоже пострадали.
Ваши серверы продолжают работать. Ниже — что произошло, почему, что мы уже сделали и что нужно сделать вам.
Причина: уязвимость в продукте разработчика
Атака стала возможной из-за критической уязвимости в самом программном обеспечении VMmanager 6. Это не ошибка настройки у отдельного провайдера: одна и та же уязвимость была использована одновременно против многих хостинговых компаний.
О взломе через VMmanager 6 публично сообщили FirstVDS, ForestsNet Cloud, MHost, HSH Network и YaColo. Сам разработчик подтвердил инцидент: по словам представителя «Группы Астра», уязвимость была в одной из сборок VMmanager.
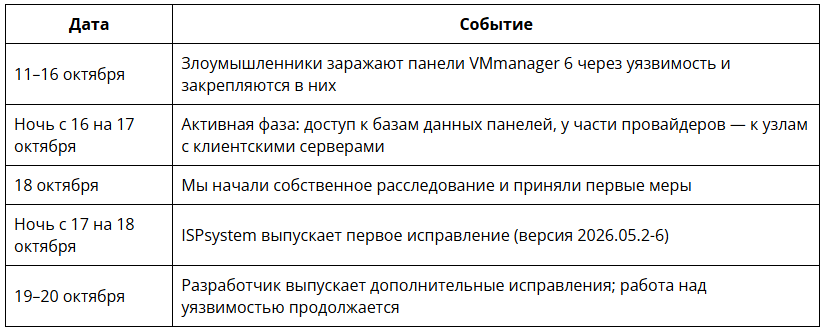
Чего до сих пор не сообщил разработчик
На момент публикации ISPsystem не предоставила провайдерам информации, достаточной для уверенного устранения уязвимости и проверки инфраструктуры. Не опубликованы:
- описание уязвимости и способ первоначального проникновения;
- идентификатор CVE и список затронутых версий;
- индикаторы компрометации (IoC): адреса серверов злоумышленников, имена файлов и процессов, признаки закрепления;
- подтверждение, что выпущенные исправления закрывают уязвимость полностью.
Мы направили разработчику запрос на полную техническую информацию и опубликуем её, как только получим. Мы считаем, что ответственность за уязвимость и за своевременное раскрытие сведений о ней лежит на разработчике продукта.
Что могло утечь
Злоумышленники получили доступ к базе данных панели. В ней хранились:
- список серверов и их IP-адреса;
- адреса электронной почты учётных записей панели;
- root-пароли, заданные через панель при заказе, переустановке или смене пароля;
- пароли VNC-консоли.
- SSH-ключи, authorized_keys, хеши паролей, менеджеры паролей, ключи GnuPG;
- учётные данные облаков и DevOps: AWS, Google Cloud, Azure, Kubernetes, Docker, Terraform, токены GitHub, GitLab и npm;
- файлы .env, docker-compose.yml, конфигурации приложений и баз данных;
- криптокошельки, seed-фразы, ключи API бирж;
- пароли и cookies браузеров, история командной оболочки;
- API-ключи сервисов ИИ, пароли резервных копий restic и Borg.
На наших узлах следов этой программы мы не нашли, но ввиду отсутствия информации от разработчика не можем полностью исключить её работу.
Что мы сделали
Не дожидаясь полной информации от разработчика, мы провели собственную проверку и закрыли известные нам пути доступа:
- Закрыли публичный доступ к панели управления сразу после обнаружения атаки.
- Нашли и заблокировали в обеих наших панелях посторонние учётные записи с правами администратора, созданные злоумышленниками для закрепления. Данные о них сохранены для расследования и переданы разработчику.
- Установили все исправления, выпущенные ISPsystem.
- Сменили всё, что хранилось на сервере панели: ключи доступа к узлам, служебные пароли интеграций с биллингом и поддержкой, ключи DNS и резервного копирования.
- Проверили узлы с клиентскими серверами: файлы, службы, процессы и журналы.
Какие данные не пострадали
По результатам нашего расследования, инцидент не затронул:
- резервные серверы;
- персональные данные в биллинге;
- платёжные реквизиты;
- любые сервисы, кроме пострадавшей платформы управления виртуализацией.
Что нужно сделать вам
Главный риск — что злоумышленники воспользуются украденными паролями и ключами. Сделайте это как можно скорее, даже если на сервере всё выглядит нормально.
- Криптокошельки — в первую очередь. Если на сервере хранились кошельки или seed-фразы, переведите средства на новые кошельки, созданные на другом, чистом устройстве.
- Смените root-пароль, если задавали его через панель и с тех пор не меняли.
- Перейдите на вход по SSH-ключу и отключите вход по паролю.
- Смените все секреты, хранившиеся на сервере: пароли пользователей и баз данных, SSH-ключи, API-ключи и токены, доступы к облакам, CI/CD, почте, платёжным системам и сервисам ИИ.
- Отзовите старые ключи, а не просто создайте новые: в облачных консолях, GitHub, GitLab, у платёжных провайдеров.
- Проверьте сервер: незнакомые пользователи, ключи в ~/.ssh/authorized_keys, задания cron, незнакомые процессы и службы systemd.
- Проверьте журналы входов на сервере и в сервисах, ключи от которых на нём лежали: нет ли входов с незнакомых адресов после 11 октября.
- Если на сервере были персональные данные ваших клиентов, проконсультируйтесь с юристом об обязанности уведомить Роскомнадзор.
- Если у вас есть серверы у других провайдеров, которые работают на VMmanager 6, выполните те же действия и там.
Если нужна помощь
Нашли на сервере что-то постороннее или не уверены? Напишите в поддержку — поможем разобраться и при необходимости переустановим сервер.
Приносим извинения за неудобства, включая время без доступа к панели. Мы будем обновлять эту статью по мере появления информации от разработчика и опубликуем подробный разбор после завершения расследования.